相关文章
553 篇高质量内容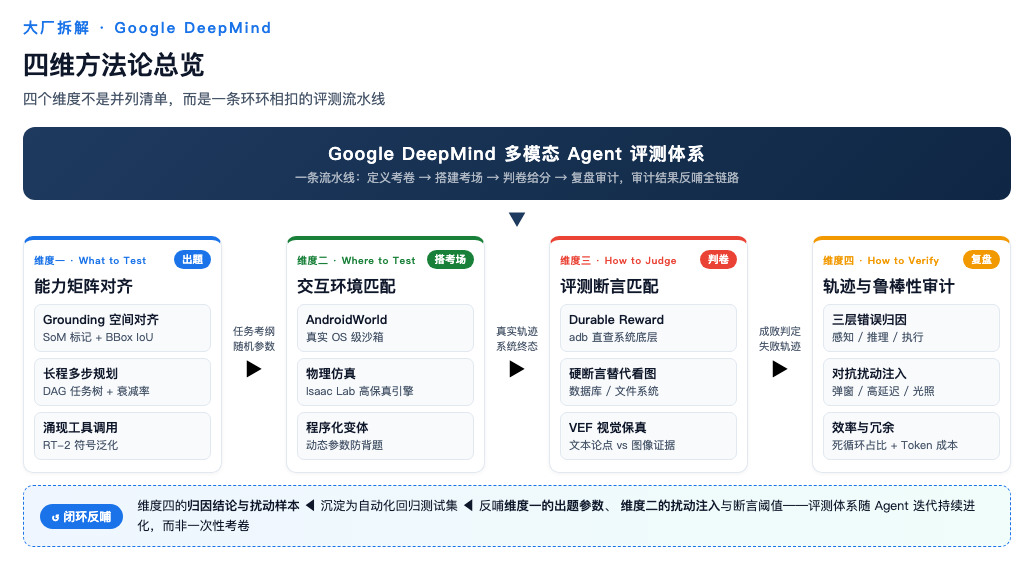
Google DeepMind 多模态 Agent 评测体系技术拆解
Google DeepMind 提出四维多模态 Agent 评测体系,强调高保真交互环境、空间对齐的几何化评估、长程规划的轨迹归因与系统级状态验证。该体系摒弃静态截图打分,转而通过硬断言检查数据库、文件系统等底层状态变化,并引入动态扰动、失败三层归因和任务树对齐等机制,直面真实落地中感知偏差、错误累积与环境不可控等工程瓶颈。
ASR 评测:语音输入时代,哪个模型最好用?
本文基于80条覆盖日常口语、中英混合、轻声耳语、噪声干扰、长语音等场景的实测录音,对比11种ASR模型在听写质量、关键信息识别、边界输入鲁棒性及使用体验四类维度的表现。结果显示:小米MiMo 2.5 ASR总体CER最低(4.01%),腾讯混元ASR 3.0与百炼Fun-ASR综合均衡;本地Qwen3-ASR 0.6B在数字和否定词识别上稳定但轻声识别弱;多模型在90秒长语音、静音控制上表现良好,但轻声与中英混合仍是共性短板。
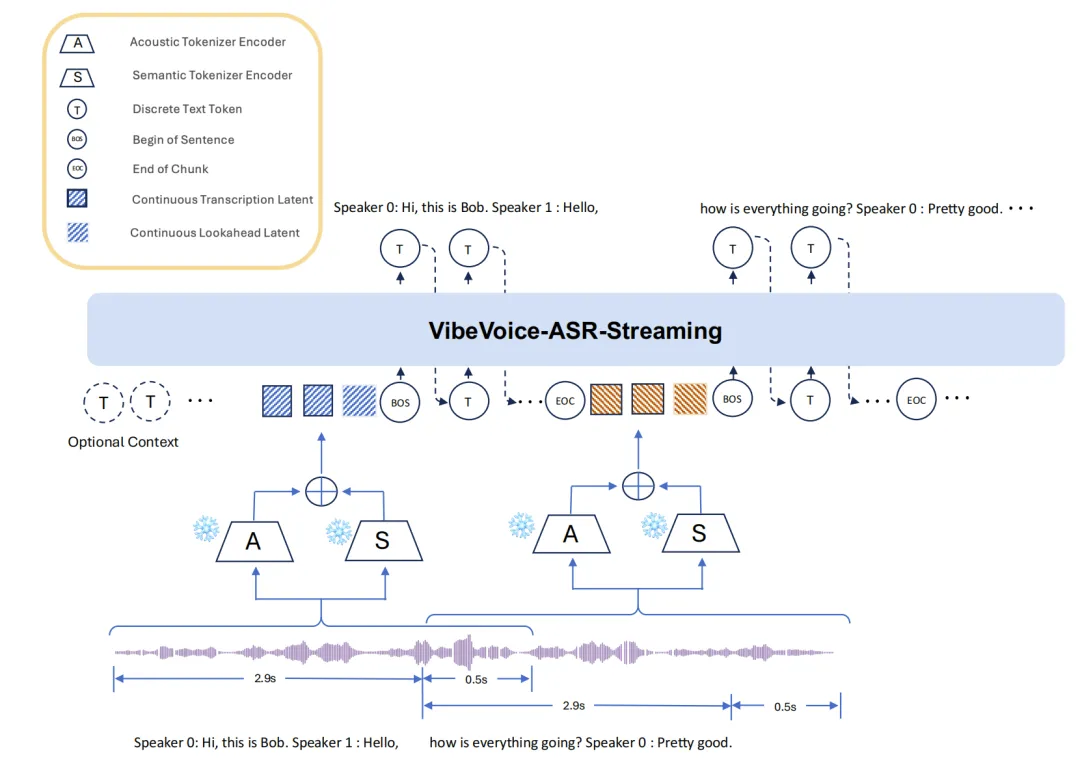
实时字幕只出字还不够,它还得知道谁在说
微软新发布的 VibeVoice-ASR-Streaming 实现端到端流式语音识别与说话人归属联合生成,延迟约2秒,支持10种语言。其核心价值在于实时场景中准确绑定语句与说话人,适用于会议纪要、客服质检和多人语音Agent。论文显示7B模型在说话人归属指标上12/13项达最优,但流式代价是WER/cpWER较非流式版本下降0.75–6.67点。
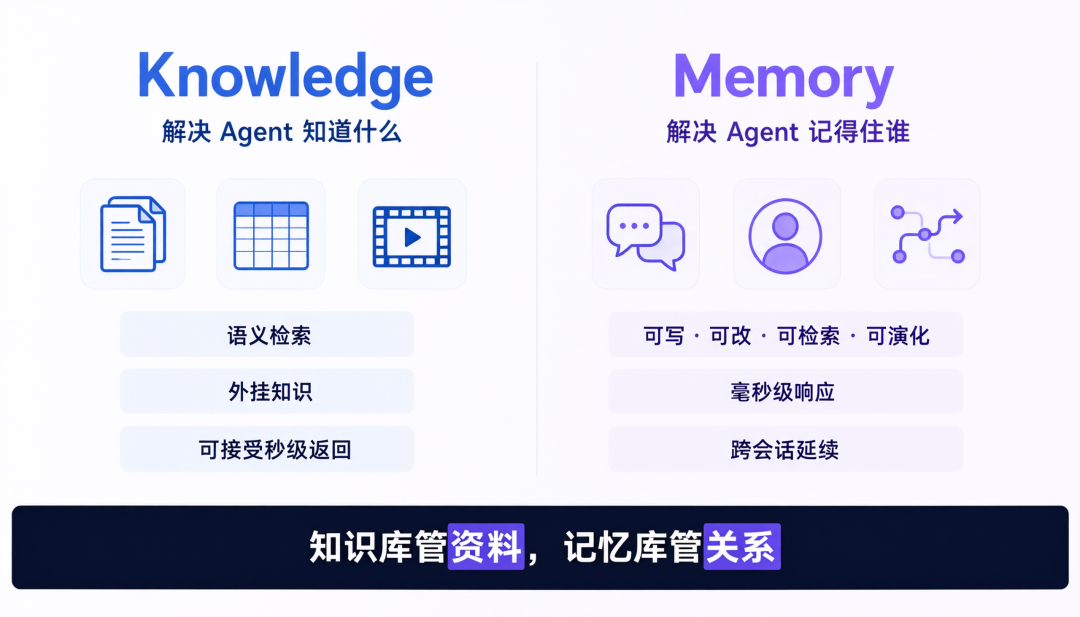
你的 Agent 记不住用户,多半是把"记忆"当成了"上下文"
本文指出当前多数 Agent 将记忆简单等同于上下文拼接或向量检索,导致信息过载、冲突难解、时效混乱。阿里云百炼提出区分知识库与记忆库,定义记忆为可写、可改、可检索、可演化的四维能力,并通过事实/画像/技能三类记忆结构、自动抽取与动态更新、多模态支持、白盒化配置及全链路可观测等设计实现工程级落地。
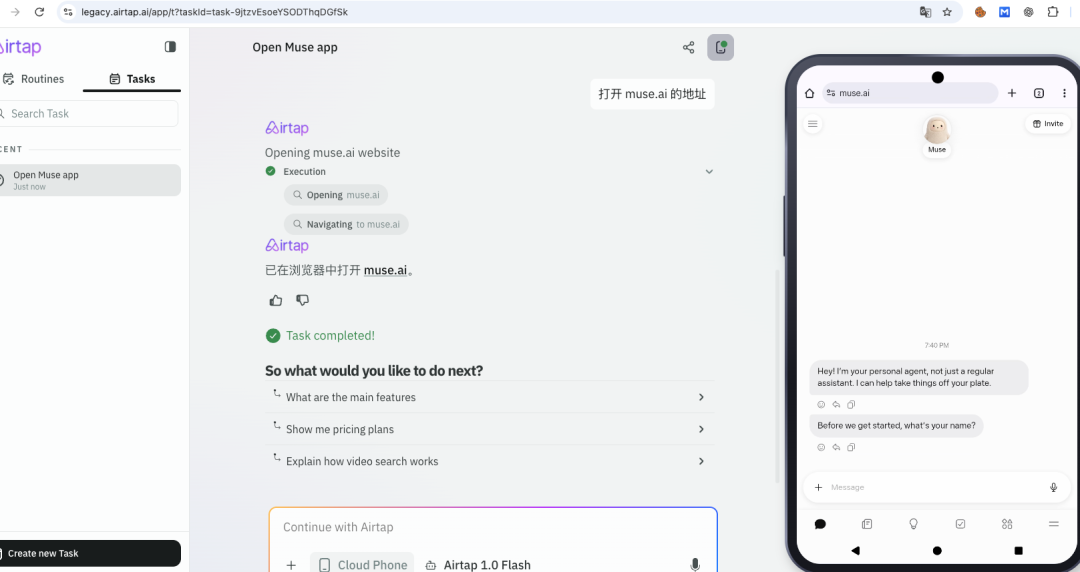
快速注册 Muse
本文介绍使用 Airtap 云手机绕过设备限制注册 Muse AI 智能体的方法,涵盖打开网站、注册兑换邀请码、用中文一句话生成分镜视频三步操作,并提示绑卡风险与优化提示词技巧。
fal发布FLUX 3 Max视频模型:宣称生成速度达Seedance 2.5的22倍,图像到视频质量并列第一
fal.ai联合Black Forest Labs推出FLUX 3 Max视频模型,10秒视频生成仅需12.45秒,速度较Seedance 2.5提升约22倍;Artificial Analysis榜单中以1138 Elo分与后者并列第一,但置信区间重叠,质量优势未达统计显著性。
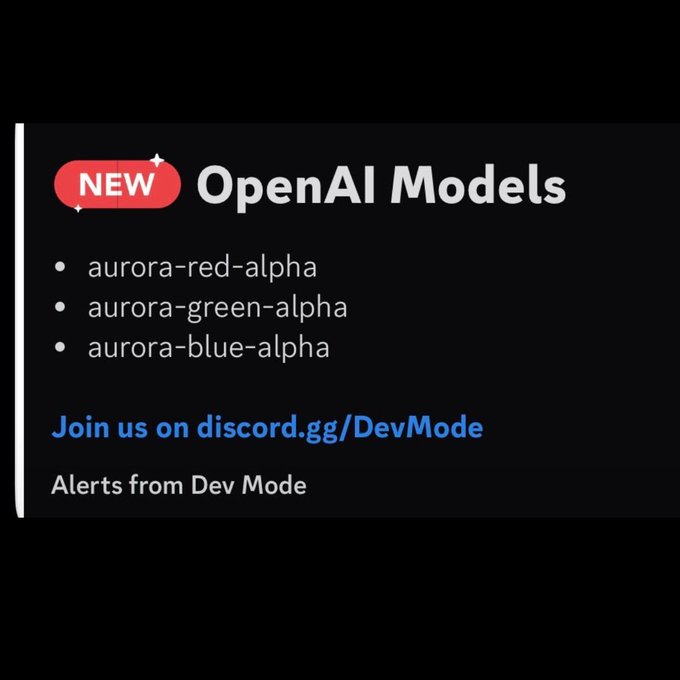
刚刚,OpenAI三大新模型深夜短暂上线!
OpenAI API后台曾短暂出现代号为「极光(Aurora)」的三个Alpha模型:aurora-red-alpha、aurora-green-alpha、aurora-blue-alpha,随后迅速撤回。实测发现它们并非代码或语言模型,而是图像生成模型,在Arena中以不同风格生成猫咪等图像,疑似OpenAI下一代图像生成底座Image-3或视觉多模态引擎底座。
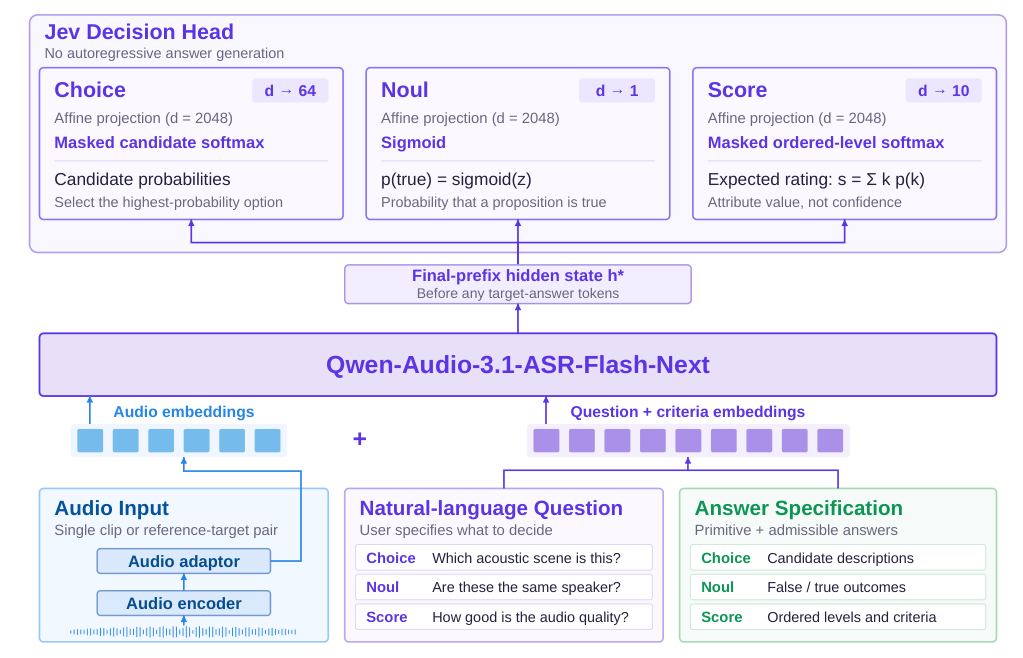
当 AI 开始评价声音:Qwen-Audio-Jev 带来的新启发
阿里巴巴团队发布的 Qwen-Audio-Jev 提出一种结构化音频决策范式,将传统生成式回答转为 CHOICE/NOUL/SCORE 三类直接输出,在 NISQA 数据集上语音质量预测与人工 MOS 评分的 Pearson 相关系数达 0.821。该模型不直接解决‘什么是好声音’,而是降低判断成本、明确评价标准,为汽车音响等场景的声音体验工程化提供新思路。
开源与端侧:英伟达新AI模型的战略逻辑
英伟达发布三款完全开源的Nemotron 3.5系列大模型,涵盖1200亿参数多模态旗舰版及两款轻量级对话模型,全部开放权重、数据集与训练配方,并上线Hugging Face。此举强化其开源生态战略,应对中国低成本高性能开源模型竞争,同时支撑GPU硬件生态与本地智能体部署。
Grok Bot设计师访谈:一段语音,怎样变成可操作的原型
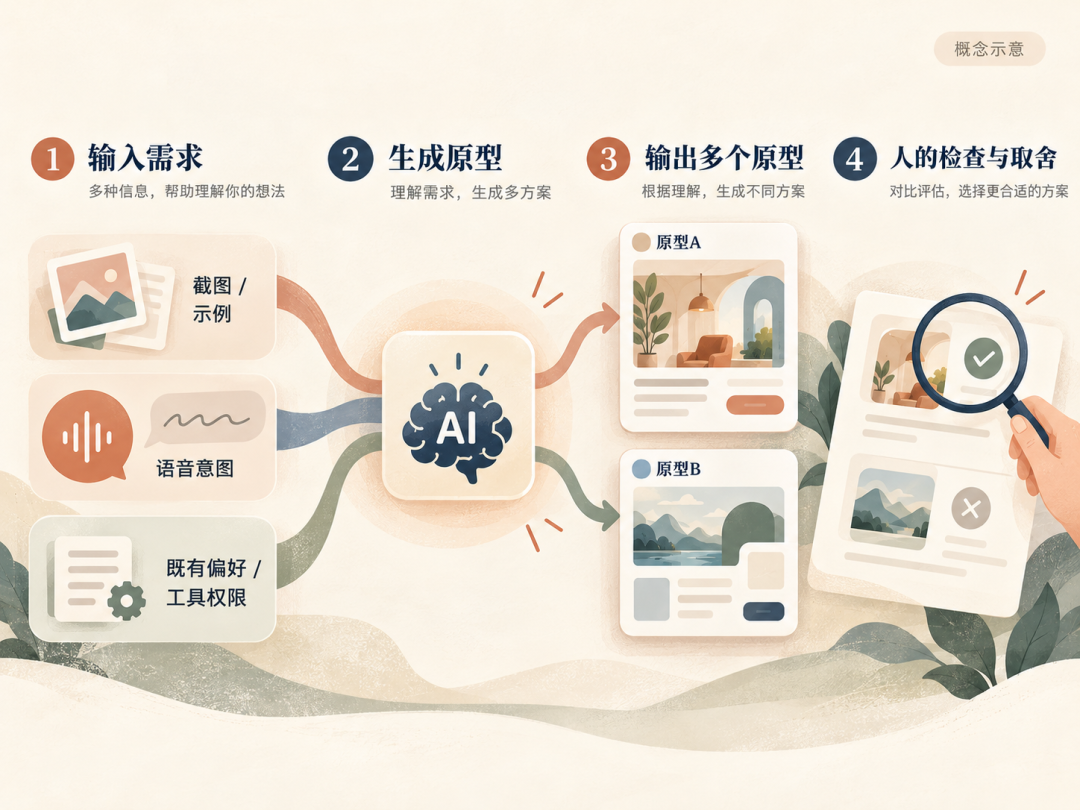
Grok Bot设计师John Bai通过截图、语音和已有设计规则,驱动AI助手完成图标排版与交互原型生成。关键依赖包括Figma MCP工具连接、预设工作习惯及可参照样例。语音本身不具魔力,真正支撑高效交办的是环境中的稳定结构与权限配置。
Meta发布Muse Spark Open:迄今最强美国开源权重大模型,支持双Mac桌面部署
Meta推出参数量8160亿的Muse Spark Open,称其为当前能力最强的美国开源权重模型,可在两台M5 Ultra Mac Studio上本地运行。该模型支持百万级上下文与多模态输入,但仅输出文本;商用许可设2000万美元收入门槛,下载需提交完整企业及个人身份信息。
一台围绕 Agent 来设计的手机长什么样|阶跃 STEPX Neo体验
阶跃终端发布首款大模型原生Agent手机STEPX Neo,搭载Step AOS操作系统与个人智能体Amoo,支持自然语言指令、长期记忆、跨应用执行与多模态搜索。用户可通过AI键、背屏、主屏滑动等多种方式唤起Agent,并利用Step Studio开发Skill与App。其技术架构强调「软硬模」协同、端云模型调度、双域六层三步记忆及H2A2A意图服务协议。
NVIDIA 推出开源多模态模型 Nemotron 3.5 Super VL 与本地智能体系列 Bolt
NVIDIA 发布开源多模态大模型 Nemotron 3.5 Super VL(120B 参数),支持跨 PDF、图表、表格与网页的视觉-语言理解,并推出面向本地部署的 Bolt 系列模型,强调企业可自主后训练、安全部署及工具调用能力。
谷歌EG 2模型+Milvus实测:最适合低成本本地部署的多模态embedding模型来了
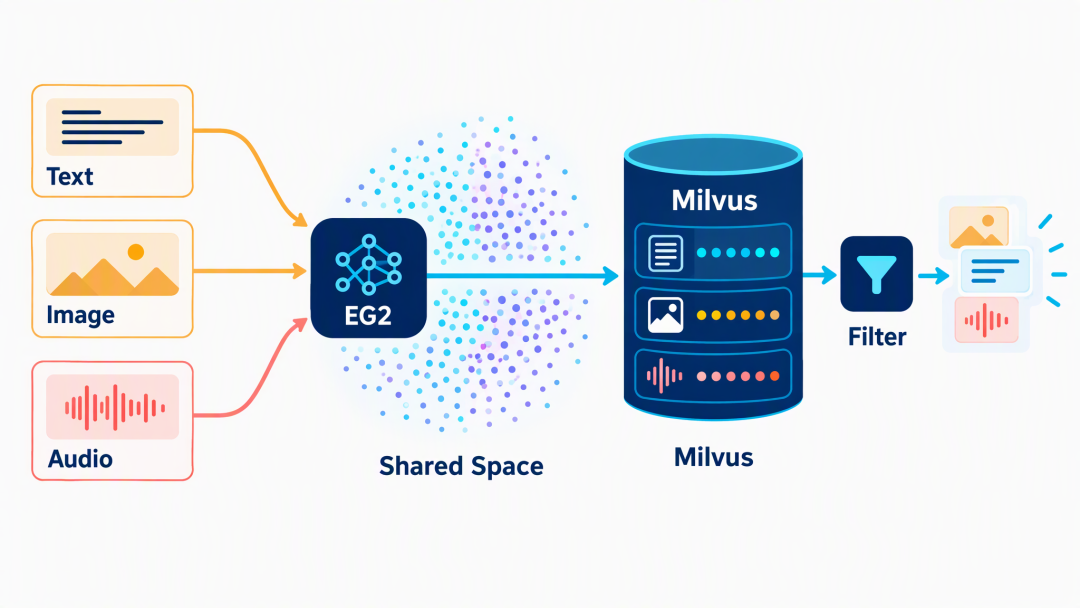
Google开源的EmbeddingGemma 2(EG2)以740M参数规模支持文本、图片、视频、音频统一编码,可按模态加载编码器并裁剪向量维度至256维或128维。本文通过Milvus实测其与Nomic、qwen3.7-text-embedding-flash、Qwen3-VL-Embedding的横向对比,在Flickr8k和ESC-50数据集上验证其文本/图文/音频检索能力及256维向量的精度-存储平衡点。
iPhone断网跑35B多模态!国产开源新模型,只占3G内存
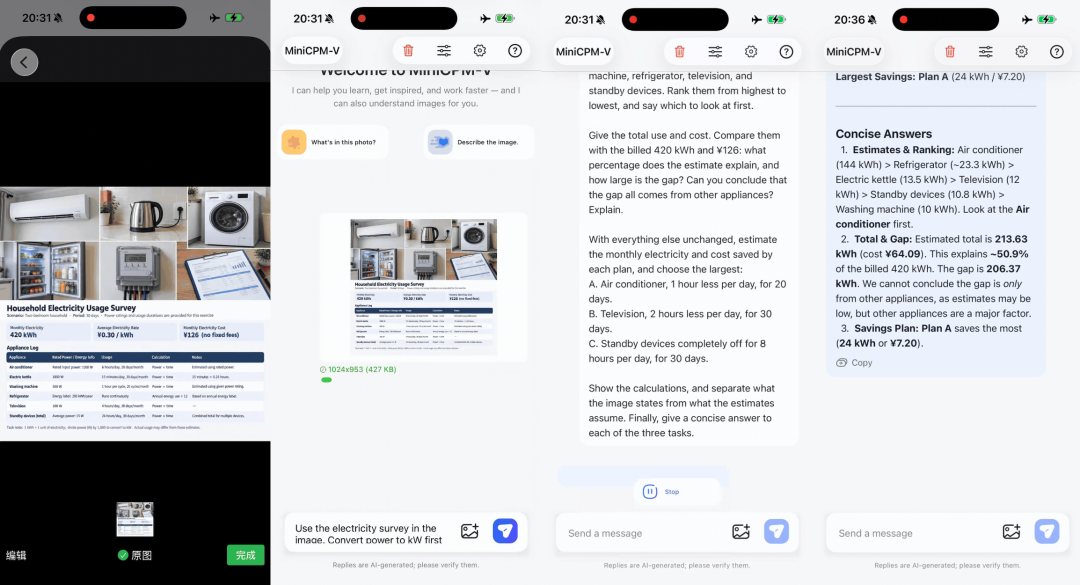
面壁智能与OpenBMB开源MiniCPM-V 4.7,含35B-A3B(MoE结构,仅激活3B)和1B两个版本,可在iPhone 17 Pro Max等端侧设备断网运行,解码速度超13 token/s,内存占用约3GB。模型在MMBench、OmniDocBench等基准测试中领先,支持iOS/安卓/鸿蒙及主流推理框架。
微信又上大分了!又偷偷更新了两个 AI 新功能,我赌你一个都没发现
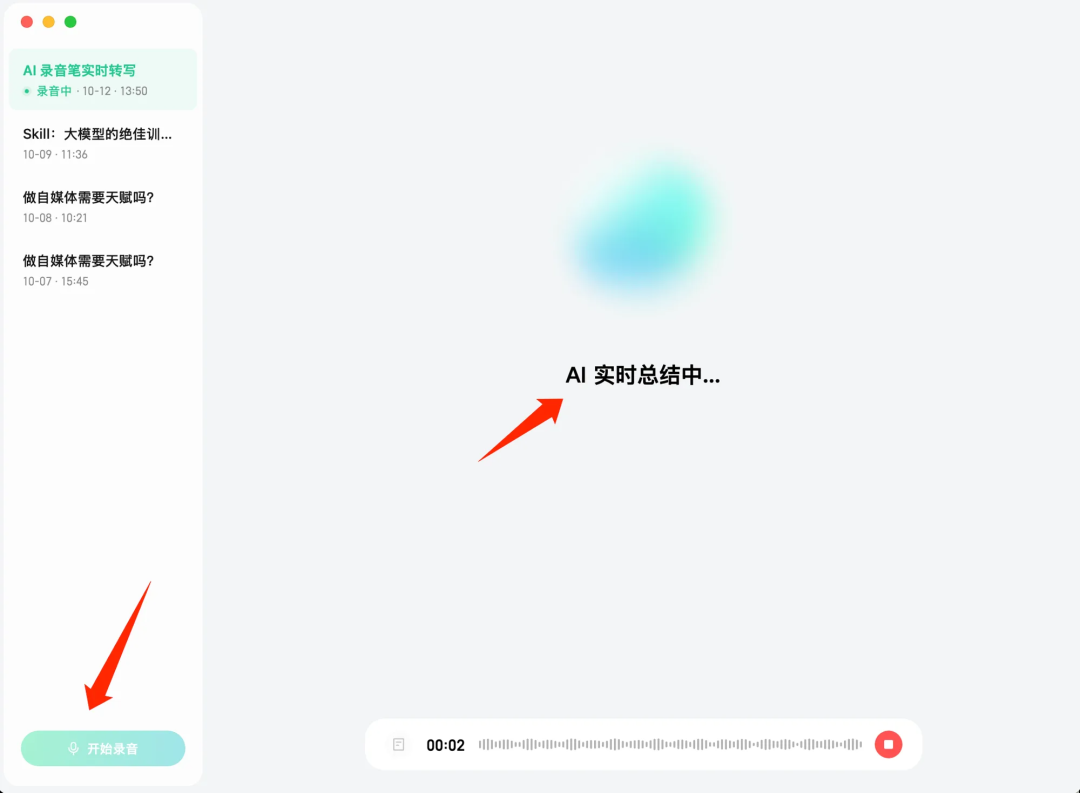
微信偷偷更新了两个实用AI新功能,大部分人都没发现,快来了解。 核心内容: 1. 微信输入法内置AI录音笔功能的特色与实用性讲解 2. 微信聊天内置AI P图功能的入口与便捷性优势 3. AI P图四大核心功能的具体作用介绍
0.6B起!Jev对手模型来了,开源多模态,登上全球测评榜一
vLLM Semantic Router开源Decision 3.0系列决策模型,参数规模覆盖0.6B至27B,支持文本、图片与视频输入,不生成长文本,仅输出结构化判断结果及置信度。在Jev Decision Index榜单中,旗舰模型d3文本与视觉分均位列第一,超越Jev与微软Decision-1。模型权重已开源,支持本地部署与边缘推理。
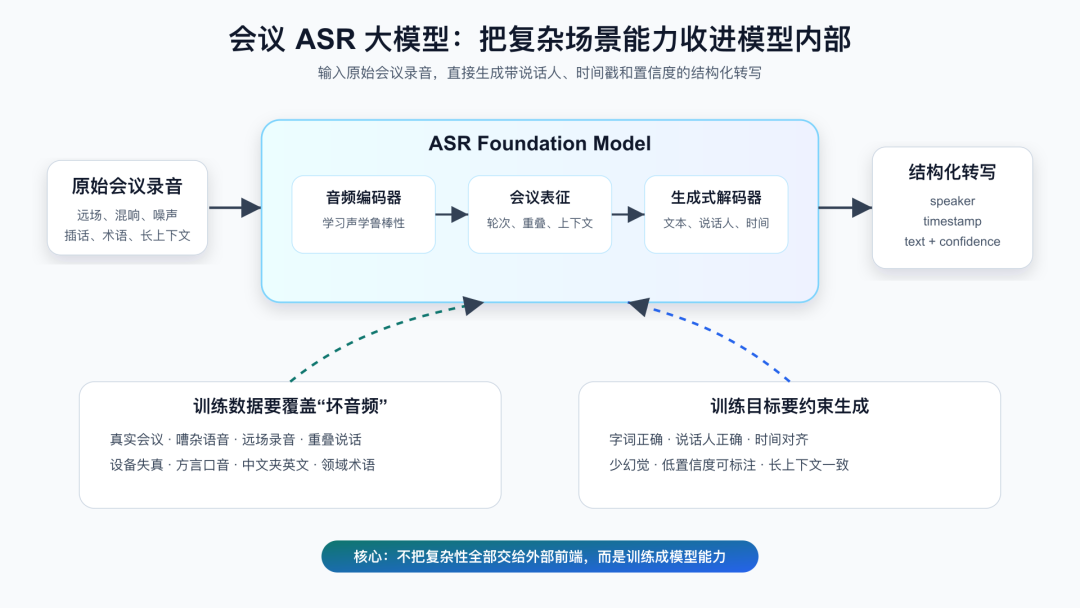
技术解读|会议 ASR 的下一站:让大模型自己学会听懂会议
本文探讨会议语音识别(ASR)的技术演进方向,指出传统模块化系统在真实会议场景中面临声学复杂性、多人重叠说话、专业术语混杂等挑战;提出ASR大模型应将声学鲁棒性、多说话人结构理解、长上下文一致性与输出克制等能力内生化,直接从原始音频生成带说话人归属与时间戳的结构化转写。
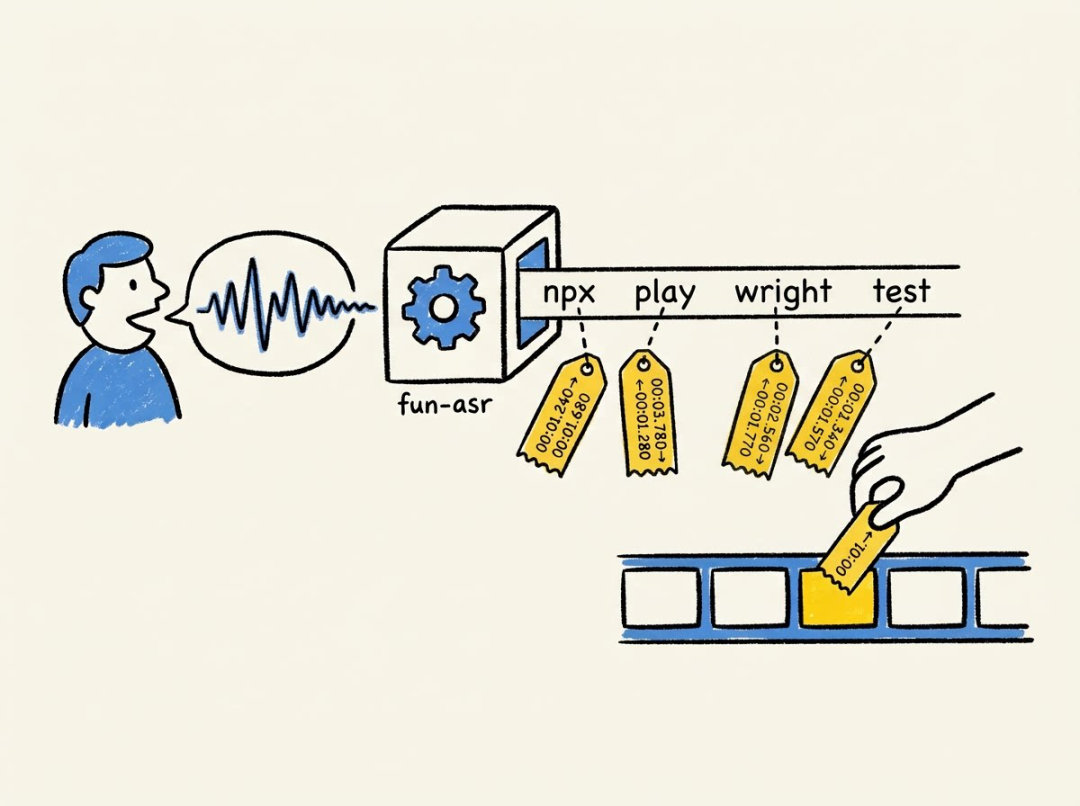
一个工具,十几分钟搞定:录屏字幕生成+错误字幕修正+多语言版本生成 | 开发者案例
阿里云百炼开发者 oil-oil 开源的 qwen-subtitle 工具,利用 ASR 语音识别与视觉理解模型协同纠错,解决录屏视频中专有名词(如 html2pptx→html to ppt)被误识别的问题;支持自动纠错、断句去水词、多语种字幕生成及配音合成,全流程由百炼 CLI 驱动,5 步约 15 分钟完成。
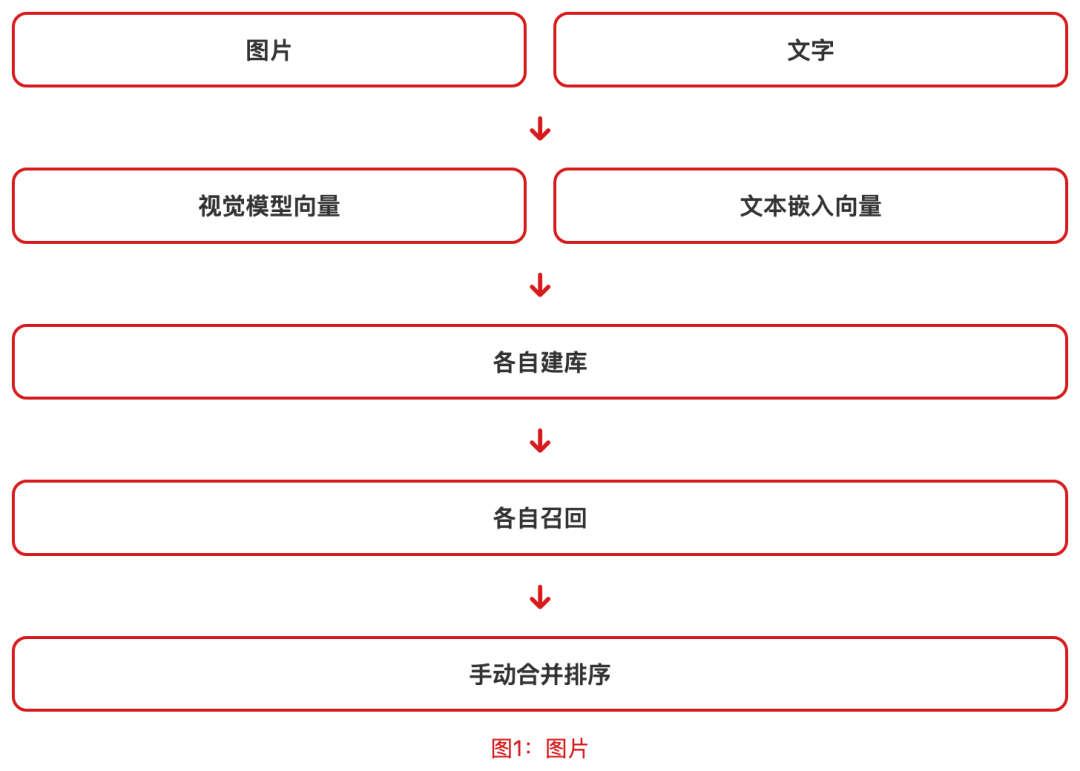
知识库里一半答案是图,检索却只认字:一个 740M 免费模型把盲区填上了——我们跑通给你看
Google DeepMind 于2026年10月6日发布开源多模态嵌入模型 EmbeddingGemma 2(740M 参数,Apache 2.0 许可),支持文本、代码、图像、视频、音频五种模态统一映射至同一向量空间。实测表明,该模型可使纯图答案(如报错弹窗截图、PPT流程图)进入检索候选集,解决企业知识库中图文资产割裂导致的检索盲区问题。