当 AI 开始评价声音:Qwen-Audio-Jev 带来的新启发
阿里巴巴团队发布的 Qwen-Audio-Jev 提出一种结构化音频决策范式,将传统生成式回答转为 CHOICE/NOUL/SCORE 三类直接输出,在 NISQA 数据集上语音质量预测与人工 MOS 评分的 Pearson 相关系数达 0.821。该模型不直接解决‘什么是好声音’,而是降低判断成本、明确评价标准,为汽车音响等场景的声音体验工程化提供新思路。
AI 声音评价的基础问题
想象这样一个场景:你坐在车里听音乐,觉得低音很有力量,但旁边的乘客却觉得有些轰头。如果你告诉 AI:“我希望低音更有弹性,但不要有压迫感。”AI 或许可以理解你的意图,通过调整 EQ 等参数改变声音。
但这里有一个更基础的问题:AI 怎么知道现在的低音好不好?又凭什么判断调整后的声音真的变好了?
实际上,这个问题不仅存在于音乐调音中。导航语音是否足够清晰?提示音是否刺耳?音乐音量是否合适?一套音响系统的低频表现究竟能打多少分?过去,这些问题主要依赖声学测量和人工主观评价。随着音频大模型的发展,我们开始有机会让 AI 参与声音的识别、判断,甚至主观质量预测。
最近,阿里巴巴团队发布的论文《Qwen-Audio-Jev: A Unified Interface for Audio Decisions》,提供了一个很有意思的新方向。它并没有直接回答“什么是好声音”,而是探索如何让 AI 更高效地作出声音判断。在特定实验条件下,其推理速度相较原始模型提高了约20倍。
Jev 名字背后的决策逻辑
Jev 这个名字,背后还有一段经济学故事。19世纪,英国经济学家威廉·斯坦利·杰文斯(William Stanley Jevons)提出了著名的“杰文斯悖论”。其核心观点是:当技术提高资源使用效率,总消耗量不一定下降,反而可能因为成本降低、需求扩大而增加。
2026年,TypeSafe AI 推出了一种专门面向高效结构化决策的 AI 模型,并将其命名为 Jev。其官方解释是:当智能决策的成本大幅下降,过去不值得使用 AI 的大量微小判断,也可能变得经济可行。
阿里巴巴团队借鉴这一决策接口思想,将其引入音频大模型,形成了 Qwen-Audio-Jev。这不禁让人联想:如果声音评价的成本大幅下降,未来我们是否可以让 AI 参与更多日常声音体验的判断?
从生成答案到结构化决策
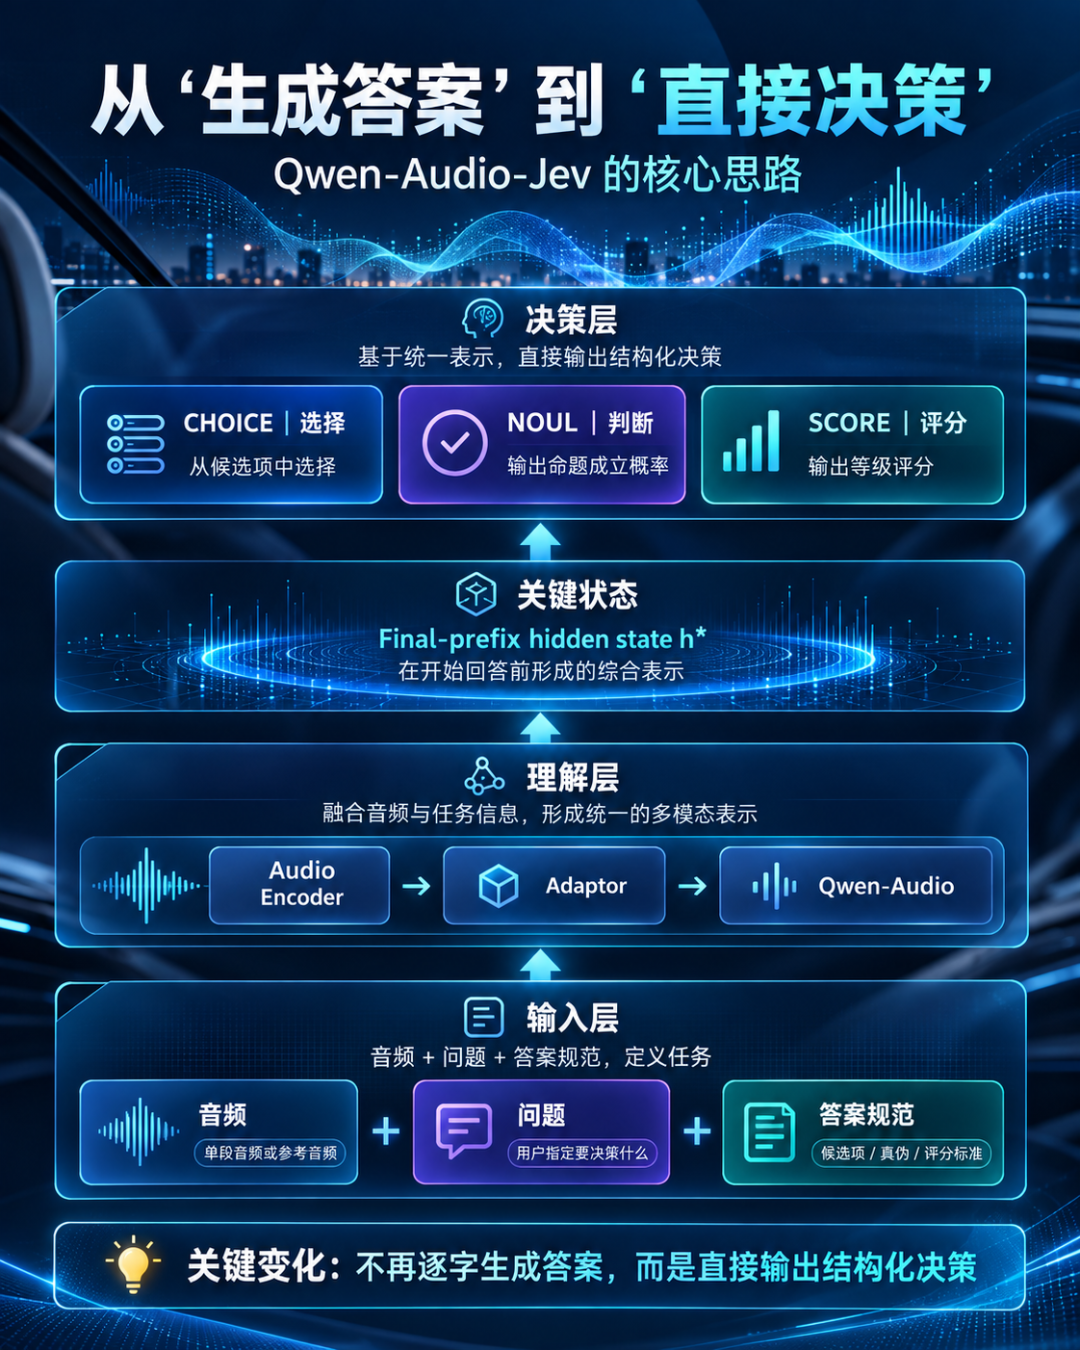
传统音频大模型通常采用生成式回答。例如,输入一段录音,询问“这段声音质量怎么样?”模型可能回答:“整体声音质量较好,但存在一定背景噪声,声音略显沉闷……”这种方式适合人与 AI 交流,但如果每天需要评价成千上万段声音,逐字生成答案既增加计算开销,也不方便软件直接使用。
Qwen-Audio-Jev 的核心思路:保留原有声音理解能力,改变最终输出答案的方式。
它在 Qwen-Audio 原有模型上增加专门的 Jev Decision Head(决策头),把音频判断统一为三种类型:
- CHOICE|选择:从多个候选项中作出选择,例如声音属于音乐、语音还是环境噪声。
- NOUL|二元判断:判断某个命题成立的概率,例如两段录音是否来自同一位说话者。
- SCORE|评分:按照预先规定的等级进行评分,例如预测一段语音的主观音质。
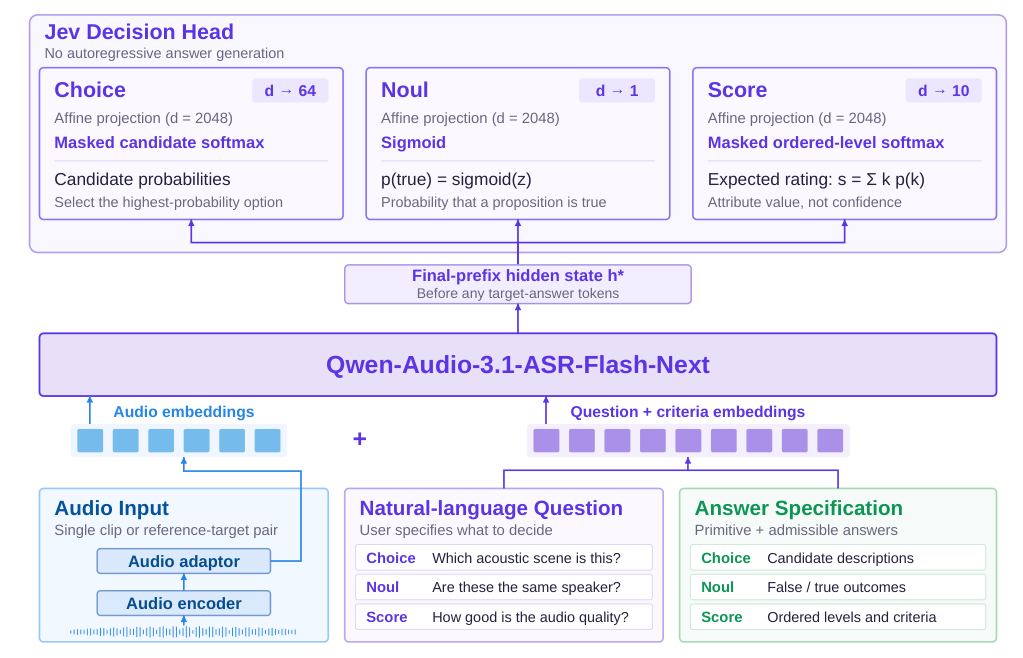
图中最关键的变化,是模型不再逐字生成答案,而是从已有的内部信息表示中,直接计算判断概率或评分结果。模型不仅接收音频和问题,还接收明确的答案规范(Answer Specification)。
也就是说,不仅要告诉 AI“评价什么”,还要定义“按照什么标准评价”。
当前能力边界与主观性挑战
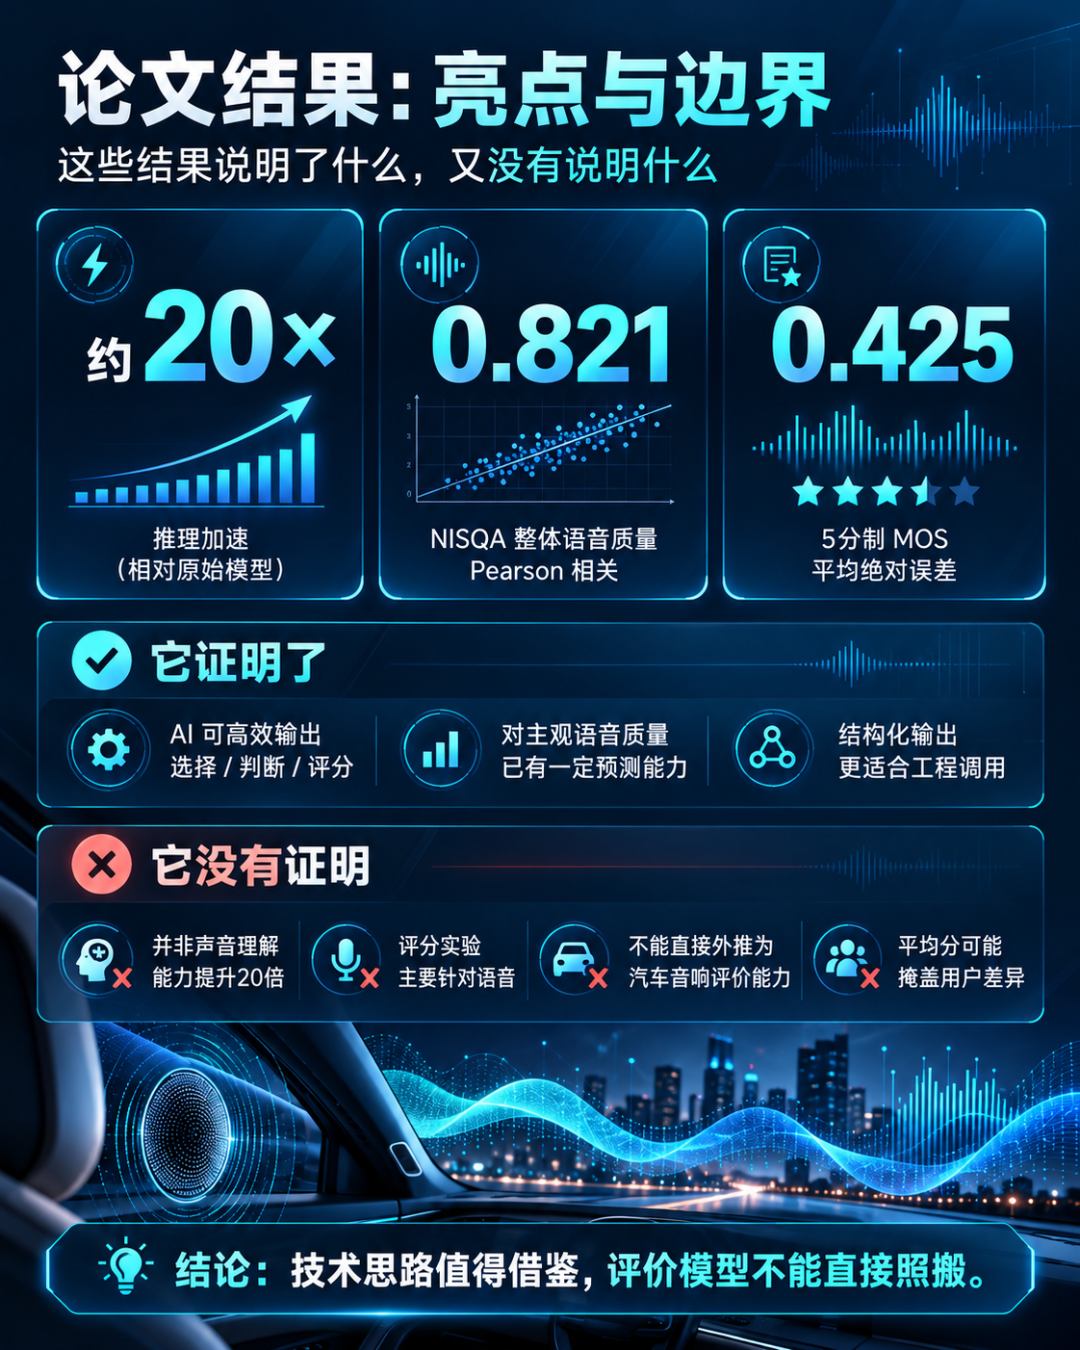
论文在18种评测配置上进行了验证,涉及声音分类、说话人验证、音频问答及语音质量评价等任务。其中,在 NISQA 数据集上,模型预测的整体语音质量与人工 MOS 评分的 Pearson 相关系数约为 0.821,5分制平均绝对误差约为 0.425分。这说明模型具备一定的主观语音质量预测能力。
能够输出一个分数,不代表真正理解了所有声音体验。
首先,论文中的主观质量评价主要针对语音,包括噪声、音色失真、语音不连续和响度等维度,并没有验证汽车音响的低频下潜、冲击力、声场包围感等体验。
其次,模型预测的可信程度,与训练数据、评价标准和目标用户的代表性密切相关。
还有一个容易被忽略的问题:平均分可能掩盖个体差异。同样一套低频调音,有人觉得很有力量,有人却觉得轰头。即使平均分达到4.5分,也不能代表每个人都满意。
这与此前关于个性化 EQ 的研究形成了呼应:声音评价不仅涉及质量,也涉及不同听音者的感知差异和个人偏好。
对汽车声音体验的潜在启发
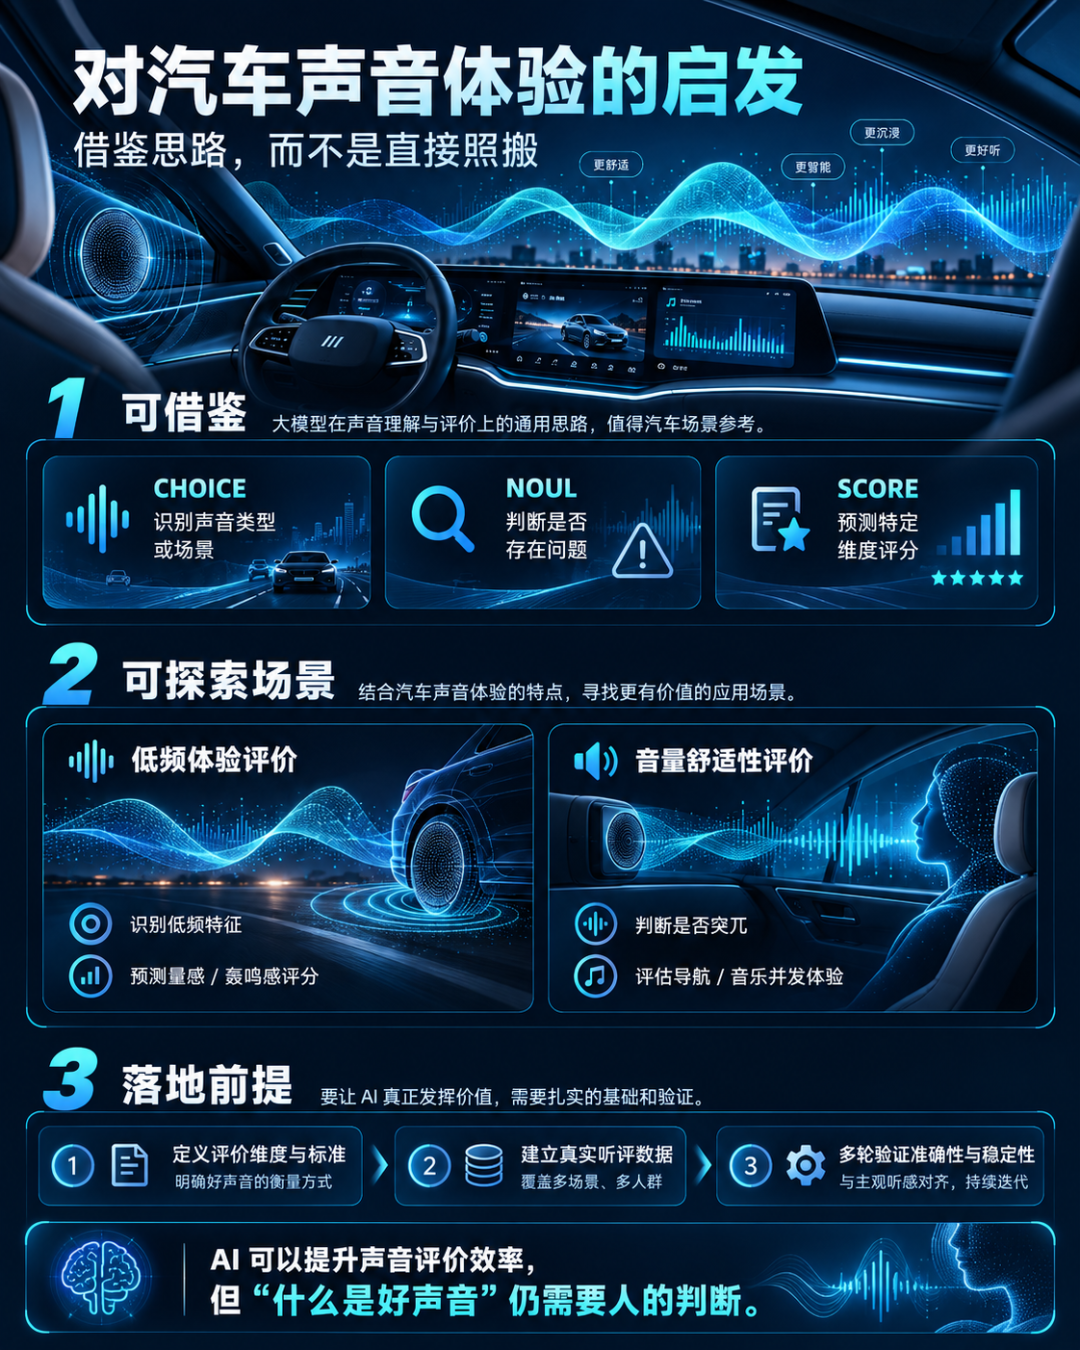
我首先想到两个应用场景。
第一个是音乐低频智能评价。
AI 可以尝试识别音乐的低频特征,判断低频是否突出,进一步预测低频的主观听感质量。
但必须区分:音乐本身的低频含量,与汽车音响最终重放出来的低频体验,是两件不同的事。低频是否有力量、是否轰鸣、是否给后排乘客带来压迫感,还取决于声学传递路径、扬声器系统和听音位置。
第二个是车内音量舒适性评价。
例如,导航语音出现时,音乐是否被压得过低?导航结束后,音量恢复是否突兀?不同声音同时出现时,是否干扰用户?
这些问题不能简单地通过声压级判断。客观声学测量能够提供物理依据,但最终的舒适性,还需要结合声音内容、环境噪声和人的听觉感知。
未来,我们或许可以把客观测量、AI 感知模型与用户主观评价结合起来,实现更智能的声音评价。不过,这些仍然是值得探索的应用方向,并非 Qwen-Audio-Jev 已经验证的能力。
比模型更重要的是评价标准
读完这篇论文,我最大的收获,并不是发现了一个可以直接用于汽车音响评价的新模型,而是看到了一种值得借鉴的思路:
将开放式的声音理解,转化为有明确标准、可以验证、能够被工程系统直接调用的决策。
当然,真正实现 AI 声音评价,还有许多工作要做。我们需要建立足够可靠的人类主观评价数据,验证模型在不同音乐、不同用户和不同听音场景下的准确性与稳定性。
更重要的是,我们首先要明确:什么是好的声音?如何描述声音体验?怎样定义评价标准?如何处理不同用户之间的偏好差异?
这些问题不会因为 AI 的出现而自动得到解决。相反,当 AI 作出判断的成本越来越低时,人类定义问题、建立标准和验证结果的能力,可能变得更加重要。
AI 或许能够让声音评价变得更高效,但评价什么、依据什么、最终服务于怎样的用户体验,仍然需要人的判断。
JOTO 企业落地观察
- 企业部署音频决策模型时,需优先构建与自身产品听感目标对齐的标注体系,而非直接复用通用语音质量数据集;否则模型输出的 SCORE 将难以映射到真实用户满意度。
- 这类系统在车载场景落地的关键取舍在于:是否将“用户偏好建模”作为决策链前置环节。若跳过此步,仅用统一标准打分,可能放大个体听感差异带来的体验断层。
- RAG 知识工程在此类任务中可承担“评价标准锚定”角色——将企业历史调音报告、用户投诉语义、声学指标阈值等结构化为可检索的决策依据,辅助模型理解“什么是本车型应有的低频表现”。
- AI 声音评价系统的安全治理重点不在模型鲁棒性,而在评价标准的可解释性与可审计性:当系统给出“音量舒适性得分3.2”时,必须能回溯至具体哪类声音组合、在哪类环境噪声下触发该判断。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们