相关文章
839 篇高质量内容
Magnitude号称比Ollama快2.2倍,64K长提示词下整段请求快1.3倍
Magnitude是一款新开源推理引擎,宣称在64K上下文、4比特量化、开启投机解码条件下,平均比Ollama快2倍以上:预填充(读提示词)快1.32倍,解码(写答案)快2.19倍。但实测提速高度依赖硬件(仅M1–M4 Mac及RTX 30+显卡)、模型(仅支持19个固定GGUF模型)、内存条件(模型须全载入GPU显存),且在冷启动、多GPU、老显卡或清单外模型等场景下不适用甚至更慢。
AWS 推出 SageMaker 训练会话:简化智能体工具调用与企业任务微调
AWS 在 SageMaker 中推出无服务器化训练会话功能,支持细粒度控制模型训练循环(如 GRPO),降低 GPU 基础设施运维负担;适用于工具调用型智能体定制,已落地医疗理赔分诊与知识图谱交互场景。
DGX Spark最全答疑:初次设置+日常使用,一篇全搞定
本文整理自NVIDIA官方开发者论坛《DGX Spark / GB10 FAQ》原帖,涵盖初次设置与日常使用共18个高频问题。内容包括SSID连接失败、本地网络通信配置、UMA架构下nvidia-smi不显示显存、BIOS密码重置限制、GPUDirect RDMA不支持原因、离线部署可行性等关键细节,所有解答均标注官方推荐处理方式。
一机三吃:AI工作站+创作机+游戏本 ,联想 YOGA Pro 15 RTX Spark 深度评测
联想 YOGA Pro 15 RTX Spark 售价 42999 元,配备 128GB 统一内存与最高可分配 96GB 显存,整机仅 1.75kg、16.7mm 厚。其 3DMark Steel Nomad 跑分仅 3010 分,性能对标桌面 RTX 5070,但胜在容量确定性:支持 27B~32B 模型本地加载、3 分 40 秒 LoRA 微调、ComfyUI 运行 Flux2.DEV(32B)不崩溃,并原生运行 Arm64 版 Blender、DaVinci Resolve、Photoshop 等专业软件。
DeepSeek 开源推理框架:走向真正普惠的未来
DeepSeek 全面开源其内部推理框架 DeepInfer 及配套编解码组件 deepseek-recipe,支持分布式推理、推测解码、SWA Bounded Replay 等能力,兼容英伟达与华为昇腾平台。此举旨在降低大规模模型推理的算力成本与能源消耗,推动大模型服务的私有化与公有云高效部署。
谷歌与Synaptics联合发布基于开源Coral技术的AI芯片,专攻可穿戴与工业边缘设备
谷歌与Synaptics推出Astra SR200系列AI处理器,集成开源Coral NPU、多核CPU及定制内存,支持Gemma等轻量模型本地运行,面向智能眼镜、工业摄像头等低功耗边缘场景。
刚刚,全球首个机器人大脑API开放!英伟达DreamZero团队创业,葛云皓任CTO
Dream Labs宣布上线Dream API——全球首个开放给公众的机器人大脑API,搭载模型Dream-1,支持零样本泛化至未见过的机器人本体,已在27种仿真机器人及多家厂商真机上验证。模型每小时3美元,配套微调服务与Robot Playground。团队源自英伟达GR00T,曾提出世界动作模型(WAM)。
128GB内存最低35999元!首批RTX Spark笔记本价格公布
NVIDIA RTX Spark N1X平台首批笔记本正式开售,涵盖微软Surface Laptop Ultra、华硕ProArt P14/P16、微星尊爵N16 FLIP AI+、联想Yoga Pro 15、戴尔XPS 16等机型。满血版支持最高128GB统一内存,FP4算力达1PFLOPS,可本地运行1200亿参数大模型。华硕ProArt P14以35999元成为128GB配置起售价最低机型。
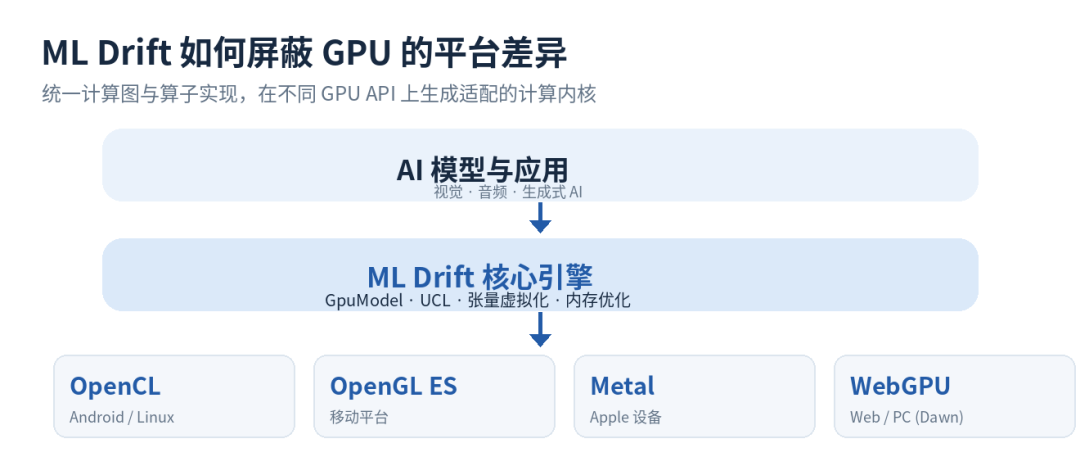
Google 开源 ML Drift:端侧 AI 推理,正在摆脱 GPU 碎片化
Google AI Edge 团队于 2026 年 10 月 8 日开源 ML Drift,一套面向端侧 AI 推理的 GPU 计算引擎。它通过张量虚拟化、统一计算语言(UCL)、五维张量支持及大模型阶段感知优化,抽象不同 GPU API(OpenCL、Metal、WebGPU 等)差异,已用于 Chrome、YouTube Shorts、Google Photos 等产品。其目标是降低端侧模型部署的硬件适配成本,推动推理基础设施统一化。
开源与端侧:英伟达新AI模型的战略逻辑
英伟达发布三款完全开源的Nemotron 3.5系列大模型,涵盖1200亿参数多模态旗舰版及两款轻量级对话模型,全部开放权重、数据集与训练配方,并上线Hugging Face。此举强化其开源生态战略,应对中国低成本高性能开源模型竞争,同时支撑GPU硬件生态与本地智能体部署。
GPU推理中60%算力浪费于重复计算上下文:NVMe闪存卸载KV缓存可提升利用率至95%
WEKA CTO指出,LLM多轮推理中GPU因KV缓存逐出频繁重算历史上下文,导致最高60%算力浪费;采用NVMe闪存卸载并共享KV缓存,可使单卡服务用户数达4–5倍,GPU利用率从30%跃升至95%。
一台围绕 Agent 来设计的手机长什么样|阶跃 STEPX Neo体验
阶跃终端发布首款大模型原生Agent手机STEPX Neo,搭载Step AOS操作系统与个人智能体Amoo,支持自然语言指令、长期记忆、跨应用执行与多模态搜索。用户可通过AI键、背屏、主屏滑动等多种方式唤起Agent,并利用Step Studio开发Skill与App。其技术架构强调「软硬模」协同、端云模型调度、双域六层三步记忆及H2A2A意图服务协议。
Ling-3.1-flash 正式开源:让真实业务需求更快变成可用成果
蚂蚁百灵正式开源 Ling-3.1-flash 模型,总参数约 560B,支持 1M 上下文。该模型在办公、医疗、软件研发等场景中可将分散需求推进为可用成果;在 Artificial Analysis 评测中智能指数达 41、输出速度约 210 Token/s;混合调用价格约 0.19 美元/百万 Token;本地部署权重从 534GB 降至 292GB,Hopper GPU 配置由 8 卡减至 4 卡。
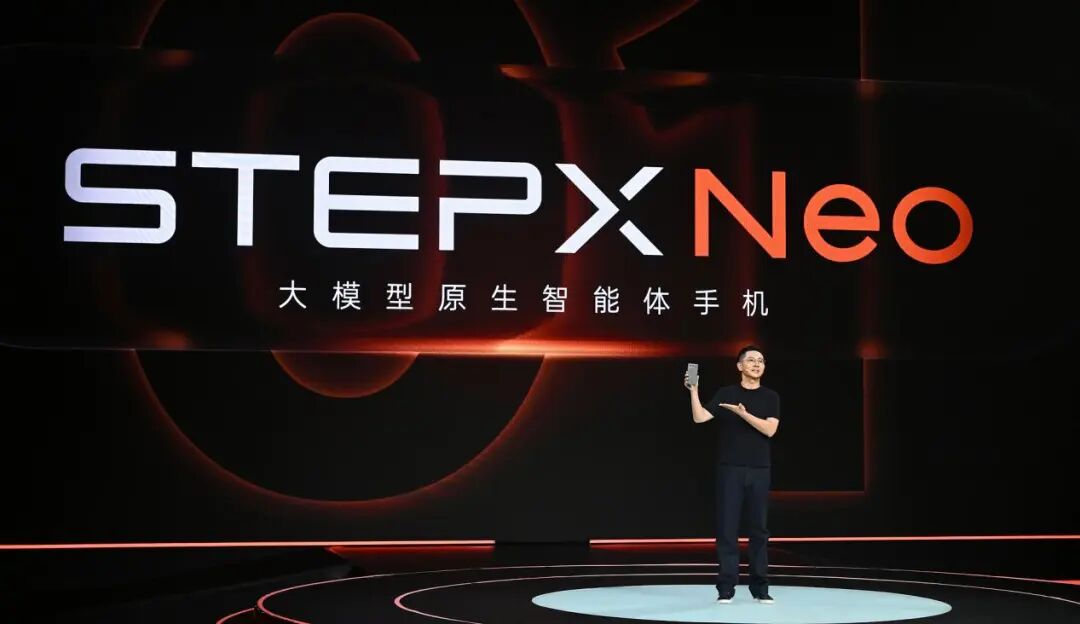
阶跃能把中国的AI手机做成吗?
10月13日,阶跃发布首款大模型原生智能体手机STEPX Neo,聚焦“手机硬件传感器+AI记忆”,强调个人全局记忆与意图理解能力,并调用大厂AI应用。文章分析其与WorkBuddy、携程等合作的逻辑,指出当前AI手机面临市场教育不足、AI应用中间层缺失、用户交互门槛高等挑战,强调AI Harness OS构建与场景化落地的关键性。
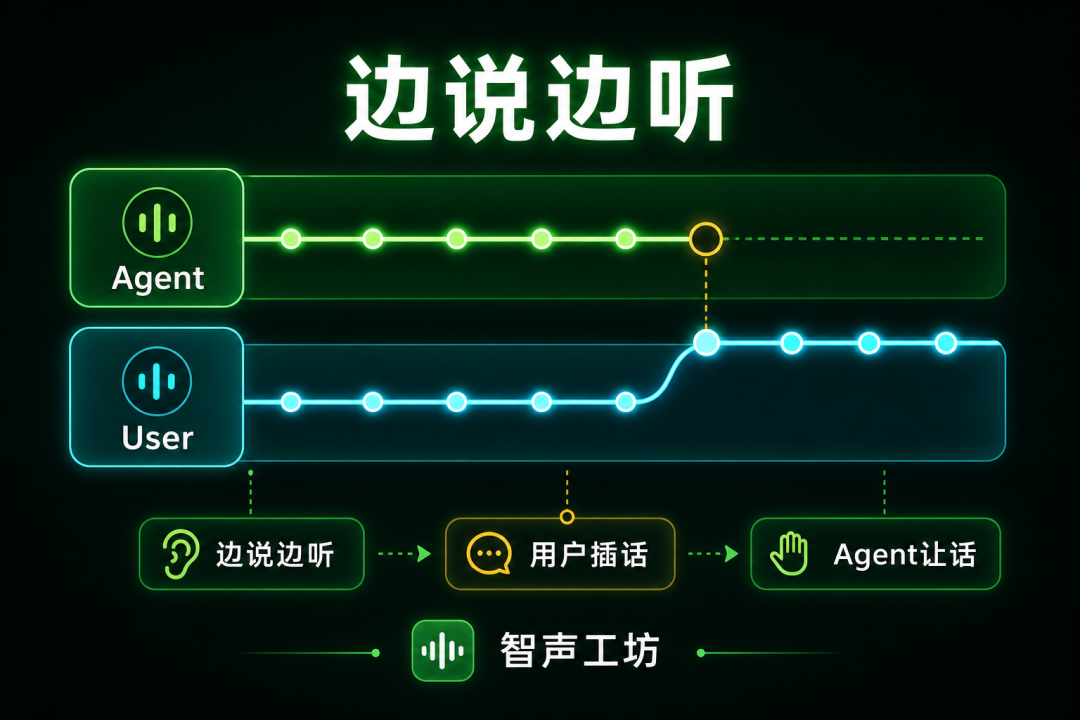
能被打断、会调工具,NVIDIA开源11B语音助手Agent
NVIDIA开源NemotronLabs VoiceChat 11B全双工语音Agent,支持实时插话中断、流式工具调用与等待话术生成。该模型采用端到端统一架构,非ASR-LLM-TTS串联流水线,在VoiceBench和Full-Duplex-Bench中均位列开源模型第二。官方明确列出多项已知限制,包括不支持backchannel识别、工具参数准确率仅44.2%、需80GB GPU显存等。
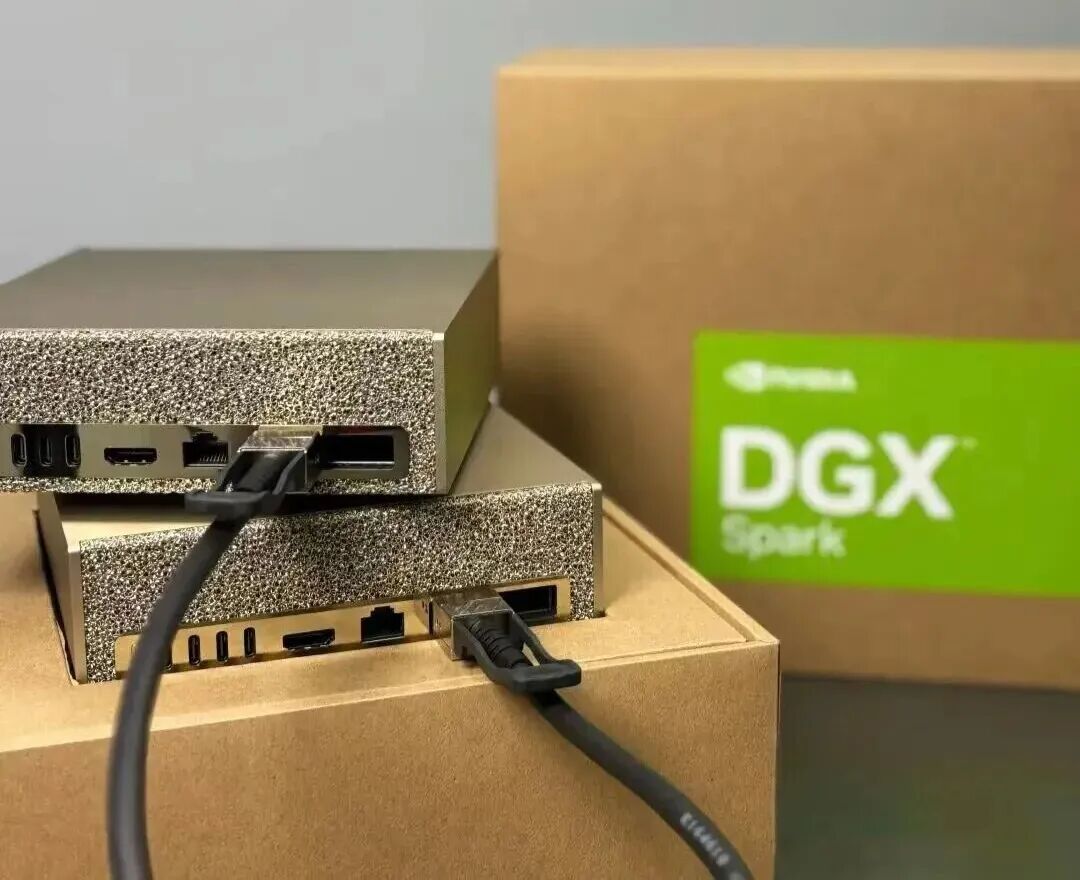
两台DGX Spark搭出一个DeepSeek:从开箱到跑通,一篇讲透
本文详细记录使用两台英伟达DGX Spark本地部署DeepSeek V4 Flash模型的完整流程,涵盖硬件选型依据、双机物理互联与网络配置、SSH免密集群搭建、vLLM推理引擎部署及性能调优要点,并列出QSFP接口Down、NCCL带宽不足、OOM和HuggingFace下载卡顿等常见问题的精准解决方案。
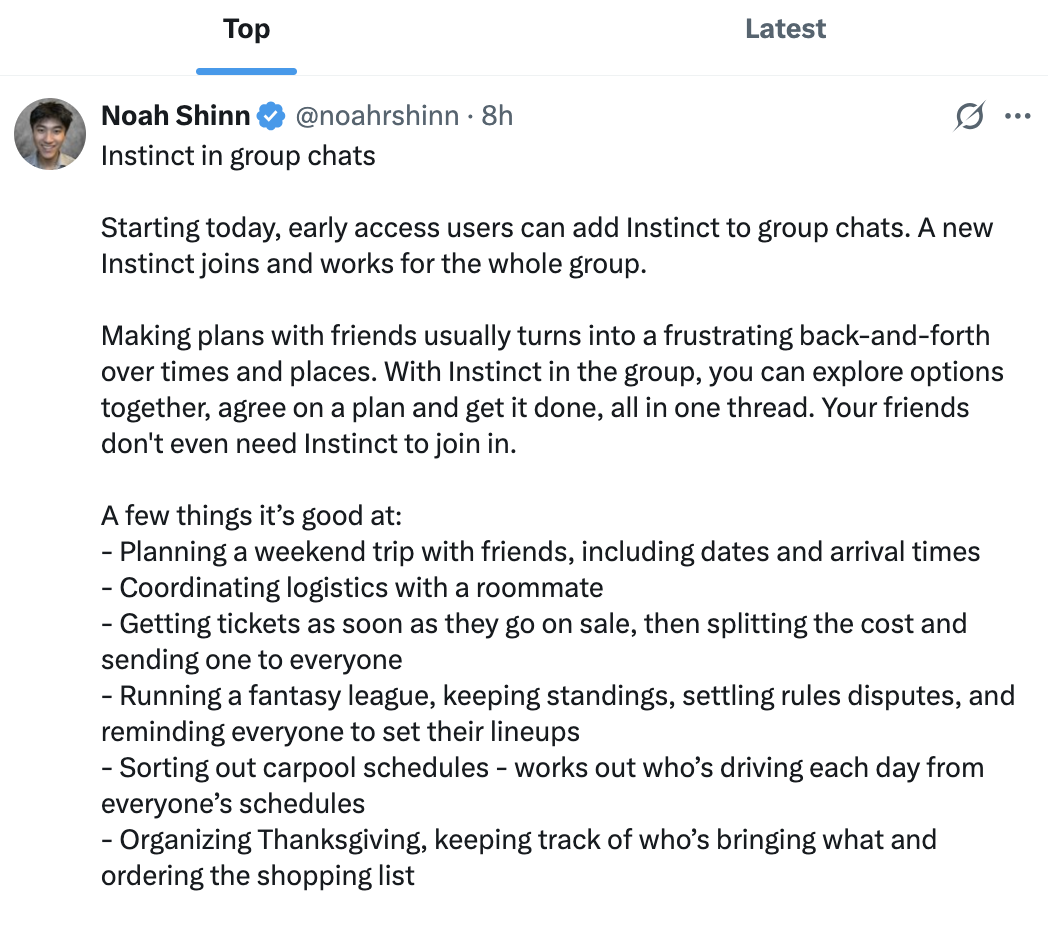
红杉资本押注的Instinct:刚推出群聊 AI Agent,这一招是巨大的增长飞轮
Instinct 是一家获红杉资本、Benchmark 和 Coatue 领投、估值100亿美元的初创公司,近期推出群聊 AI Agent。该 Agent 可加入微信群等群组,作为群组级 AI 助手,支持活动规划、费用分摊、抢票、拼车安排、聚会组织等协作任务,并采用严格隐私设计:群组 Agent 无法访问个人 Agent,新成员入群时个人 Agent 暂停消息。其群聊模式被视作缺算力阶段的关键增长引擎。
智能体元推理:Meta 提出的计算资源动态调度新范式
Meta 提出“智能体元推理”框架,通过分离控制器与工作者、构建持久化人工产物记忆与计算图,使AI智能体能在单次运行中自主评估进展、探索替代路径并高效分配算力。在ProgramBench等四项基准上全面超越直接控制基线。
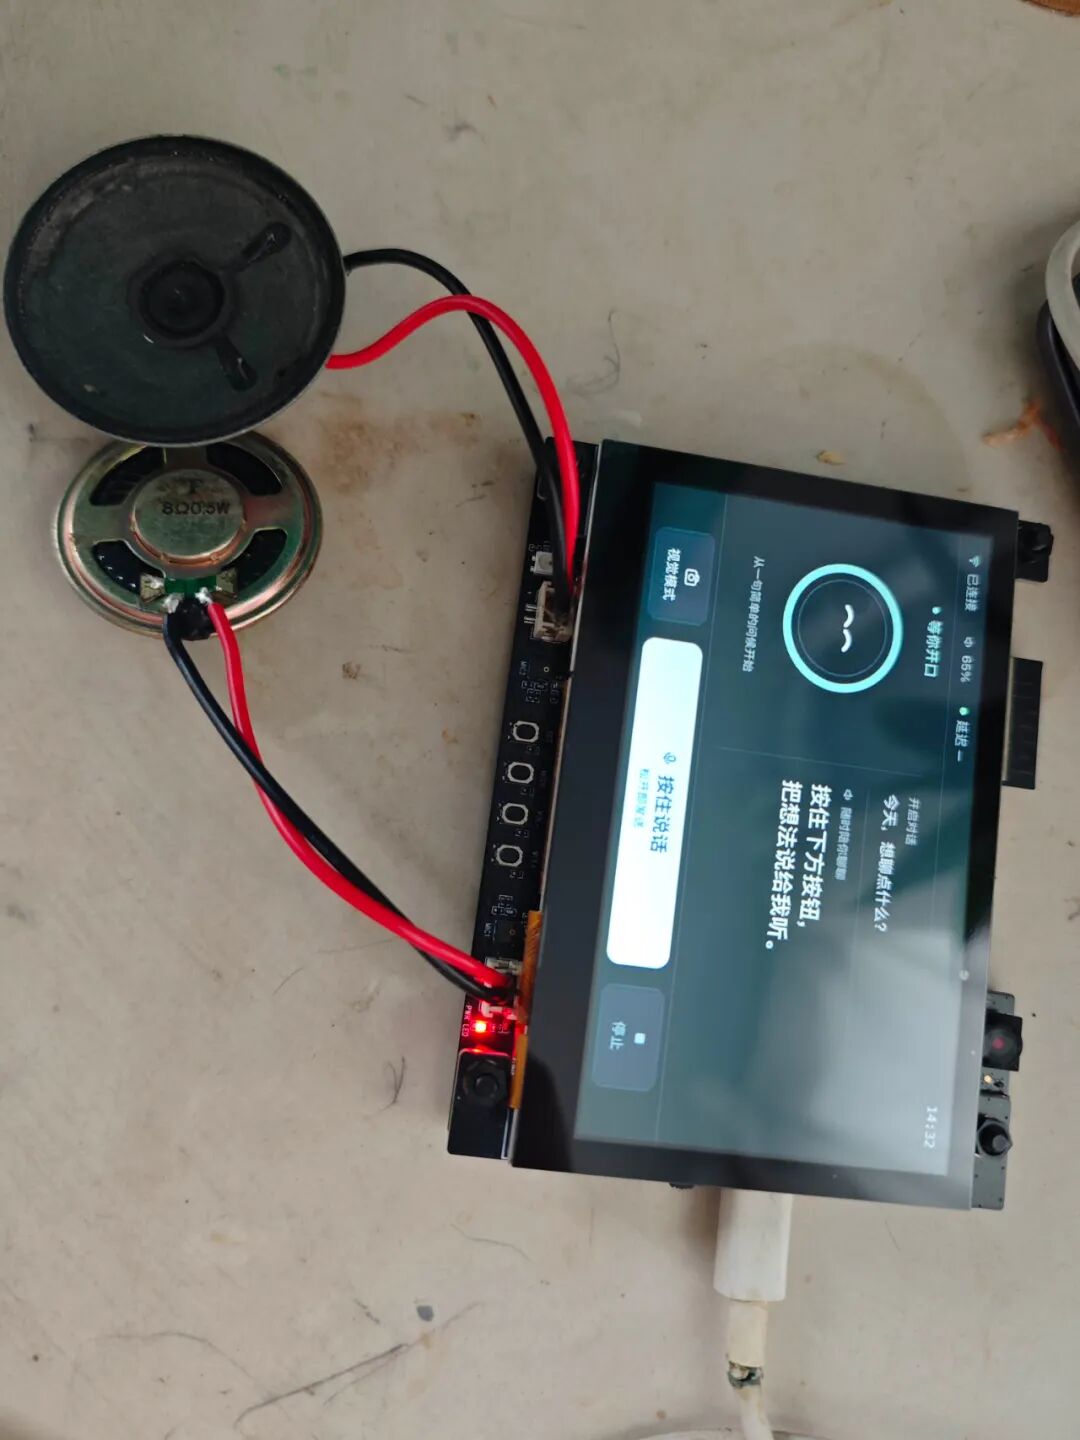
ESP-Claw 和小智 AI有什么区别
本文对比乐鑫官方的 ESP-Claw 与社区驱动的小智 AI 在架构设计、运行机制与适用场景上的根本差异:ESP-Claw 将 Agent 调度中心嵌入芯片,强调事件驱动与规则优先;小智 AI 则采用瘦终端+服务端语音流水线模式,聚焦低延迟流式交互与全链路可插拔。二者在芯片支持、语音能力、部署复杂度及工程可控性上形成明确取舍。
Reflection Beam模型发布:全球AI市场加速分化
Reflection AI推出5010亿参数开源混合专家模型Beam,对标中国GLM-5.2,凸显中美AI技术路线与生态的结构性分化;英伟达8亿美元注资及SpaceXAI算力合作,强化西方开源大模型基础设施支撑能力。