一个工具,十几分钟搞定:录屏字幕生成+错误字幕修正+多语言版本生成 | 开发者案例
阿里云百炼开发者 oil-oil 开源的 qwen-subtitle 工具,利用 ASR 语音识别与视觉理解模型协同纠错,解决录屏视频中专有名词(如 html2pptx→html to ppt)被误识别的问题;支持自动纠错、断句去水词、多语种字幕生成及配音合成,全流程由百炼 CLI 驱动,5 步约 15 分钟完成。
录屏字幕配错,古法怎么改?
你录了个教程视频,嘴里说的是 html2pptx,字幕生成的却是 html to ppt。读音一模一样,字幕却生成错了,看视频的人照着字幕去搜还总是搜不到准确的信息。要是专有名词多,错误量大,导出的视频改起来比你重新录一遍还费劲。最最关键的是,重新录一遍,生成的字幕也还是错的。
在视频编辑器里,打开自动识别出来的字幕,然后:
从头到尾逐条播放,耳朵听音频,眼睛看字幕,判断对不对。一点儿标记没有,全靠人眼一帧帧过。
改一处只要 3 秒,敲个正确的写法而已。难的是 快速找到错误的那一处!
这种错特别难修,主要有3个原因:
- 1、ASR(自动语音识别)只听声音,不会辨别
例如html to ppt这三个词念起来完全通顺,它不知道你说的是一个软件名,还是三个普通英文单词,所以按照它错误的理解生成错误的字幕。 - 2、人不容易发现
错的版本读起来甚至更顺,有时候扫一眼字幕根本看不出问题。 - 3、错误量大修改耗时耗力
一条二十分钟的教程字幕要是有十几处错误,逐句对着视频核对,比重新录一遍还累。
阿里云百炼开发者 oil-oil 的解法
oil-oil 发现,录屏 / 教程 / 讲解类视频有个别的视频没有的优势——嘴里说的词,往往就展示在屏幕画面里(PPT、代码、文件名上)。无论什么 ASR(自动语音识别),专有名词可能永远会被听错(Claude→cloud、Codex→class q、html2pptx→html to ppt)。qwen-subtitle 的核心做法是:让一个支持视频输入的视觉理解模型按照 ASR 时间范围去读取屏幕上那一帧真实画面来纠正错误字幕——这是纯语音工具做不到的。
1、识别声音,生成字幕
这一步用 fun-asr(语音识别) 把声音转成文字。
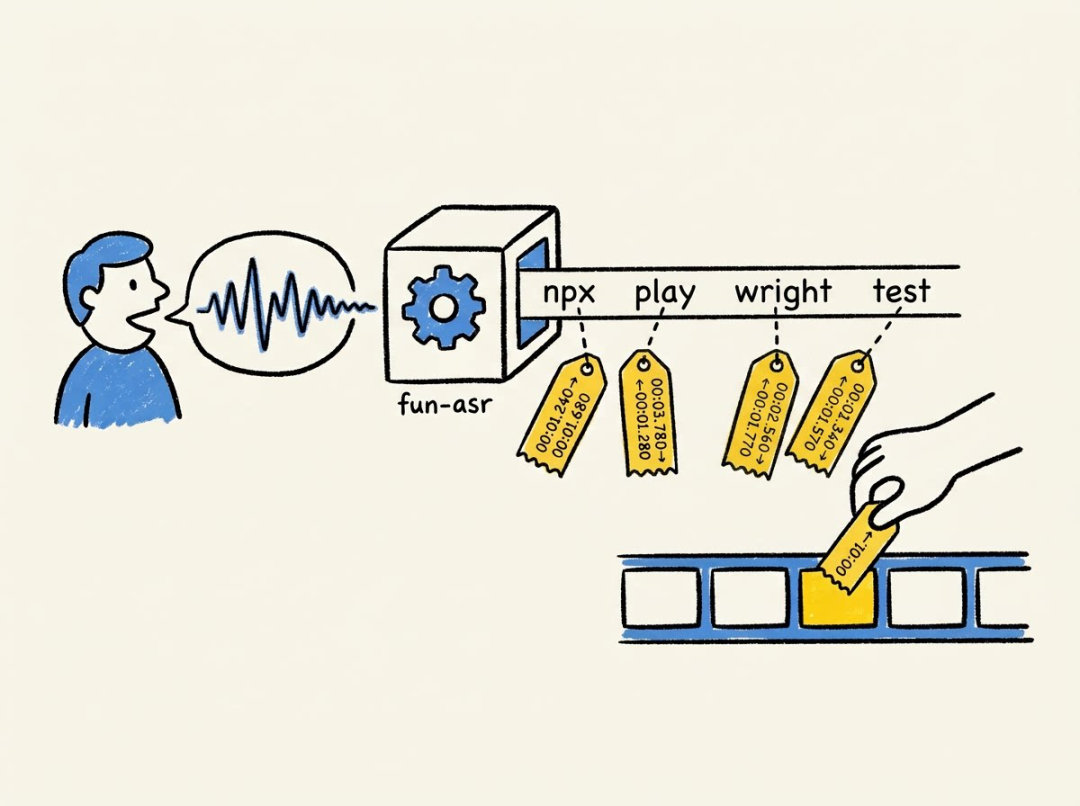
2、看屏幕纠错词
用 qwen3.8-max 大模型通读全篇,一次读取整段视频和带时间范围的 ASR(自动语音识别),最后返回结构化的“可疑错词”改动清单和每处带视频原画面的证据。
圈词规则:
- (1)不许猜
只认画面上能逐字读到的文字。靠图标、logo、配色、氛围或常识推断出来的,一律判"没找到"。 - (2)最小替换
只换听错的那几个字。画面上是一整条路径,但听错的只是其中那个工具名,那就只替换工具名,别把旁边的文件夹名、按钮名一起带进来。 - (3)规范大小写
专有名词用规范写法,GitHub、Node.js 这种,哪怕画面上出现的是小写的文件夹名。 - (4)发音要对得上
play right和Playwright对得上,at和@对得上。画面找到的词跟原文读音明显对不上,那就不是同一个词,判别结果就是"没找到"。
另外还有三条兜底:不补全不扩写、原文其实没错就让结果等于原文、任何不确定一律判"没找到"。
取证也不是只看一帧。先在字幕的时间戳那一帧找,找不到试句首、句尾。三帧都拿不到证据,就保留原文并打上 needs_review(待人工确认),绝不回头用第 2 步的猜测。
因为工具坚持零误改优先:字幕里一处错误的"纠正"比不纠正更糟,它会让用户误以为字幕可信,实则原字幕被污染了。
3、断句 + 去水词
去水词交给轻量的 qwen-plus 模型,只许删"呃、啊、嗯"这类口头禅和明显的口吃重复,术语、数字、英文、代码一律不碰,返回后程序再核一遍、只接受纯删除,模型哪怕顺手改了一个字,这一条就整条作废、保留原文。
4、生成字幕+配音
字幕
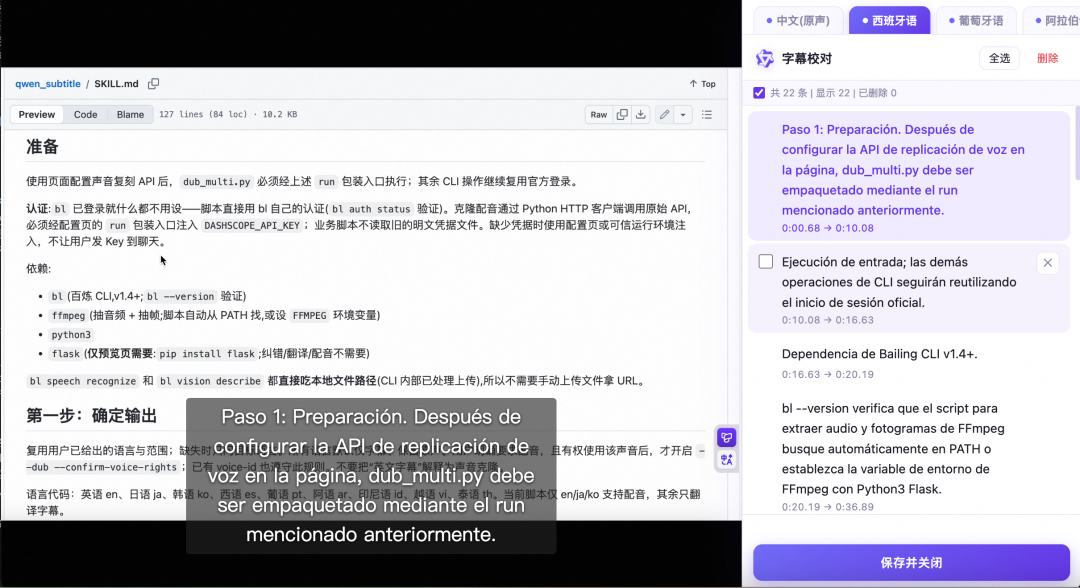
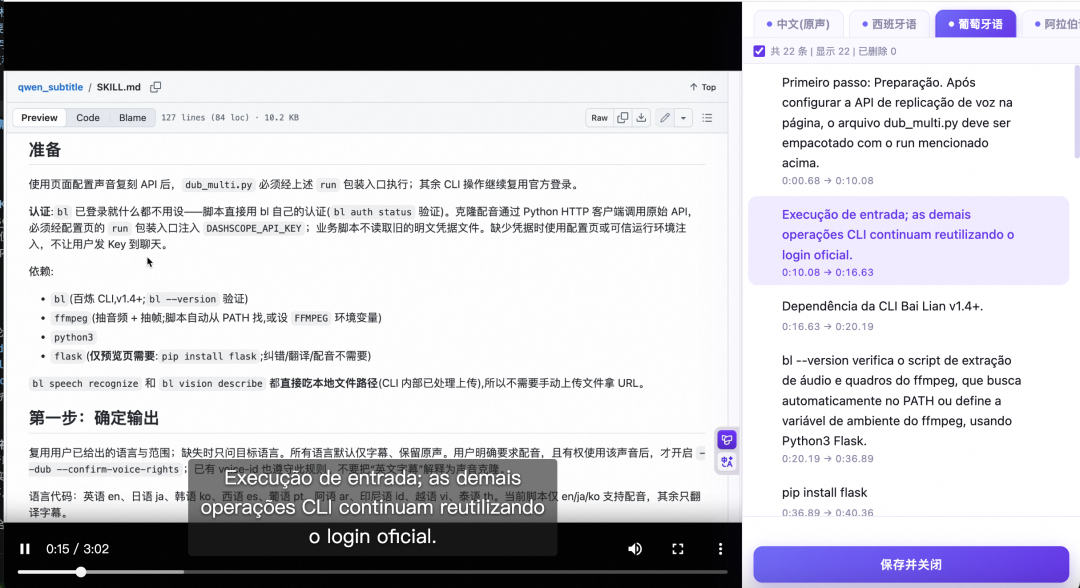
先把纠错后的字幕碎段按句号合并成整句。然后翻译分两路——只出字幕的语言交给翻译模型 qwen-mt-turbo;要配音的语言交给 qwen-plus 模型,按"这段镜头有几秒就限几个词"压缩译文,每种语言产出一份带时间轴的字幕。
配音
从原视频里取 18 秒人声,上传给 cosyvoice-v2 模型复刻出一个专属音色;再用这个音色把每句译文念出来;哪句念超了就用 atempo 加快语速塞回原来的时间段(最多 1.5 倍,只加快不拉慢、音调不变);最后按每句的开始时间把 22 段音频铺回时间轴,混成一条完整音轨。
注:atempo 是 ffmpeg 自带的一个音频滤镜,作用是:改变一段音频的时长,同时保持音调不变
5步,15分钟,完成录屏字幕生成+纠错+多语言翻译
第 0 步:开始之前
环境:Python、ffmpeg 和已认证的百炼 CLI;预览另需 Flask
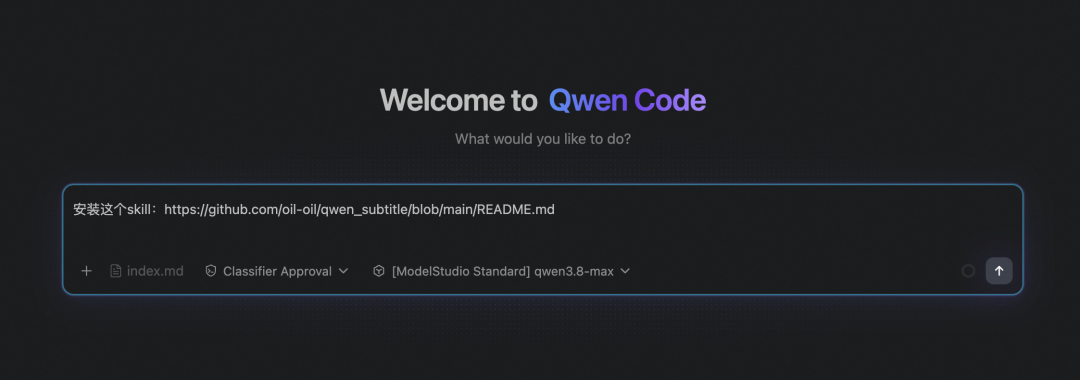
第 1 步:安装 Skill
将项目的 SKILL.md 文件发给你的 Agent,让 Agent 安装
https://github.com/oil-oil/qwen_subtitle/blob/main/SKILL.md
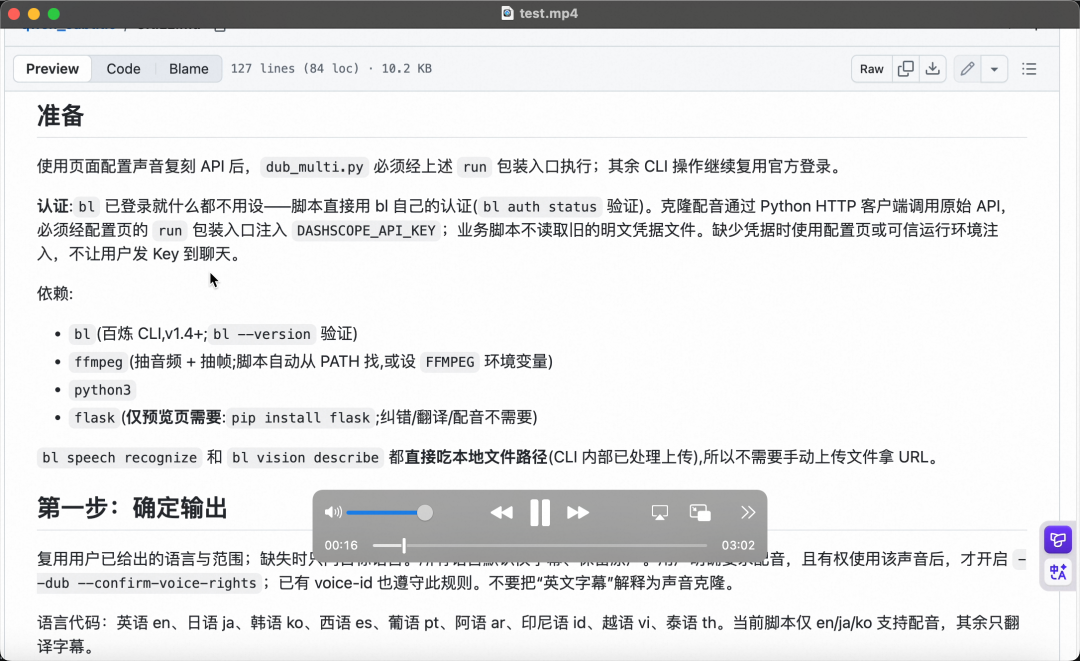
自己动手的话,克隆仓库:
git clone https://github.com/oil-oil/qwen_subtitle
cd qwen_subtitle
ls
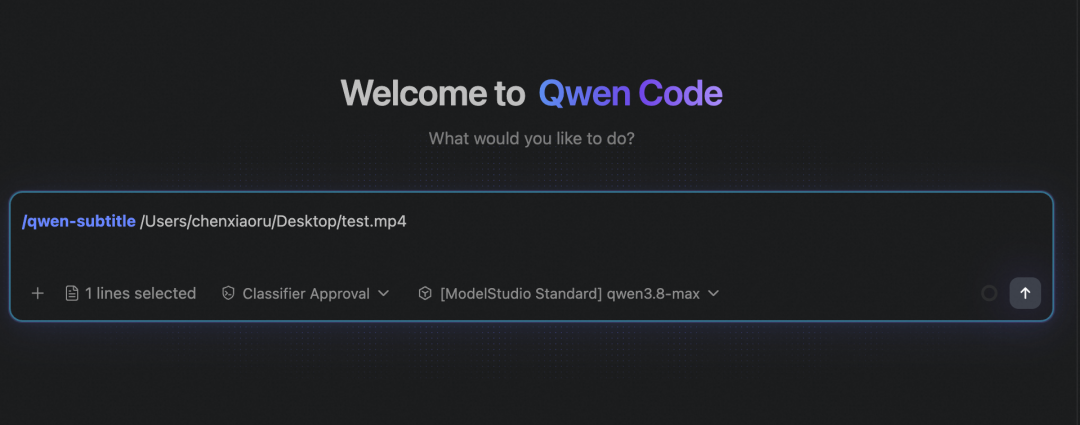
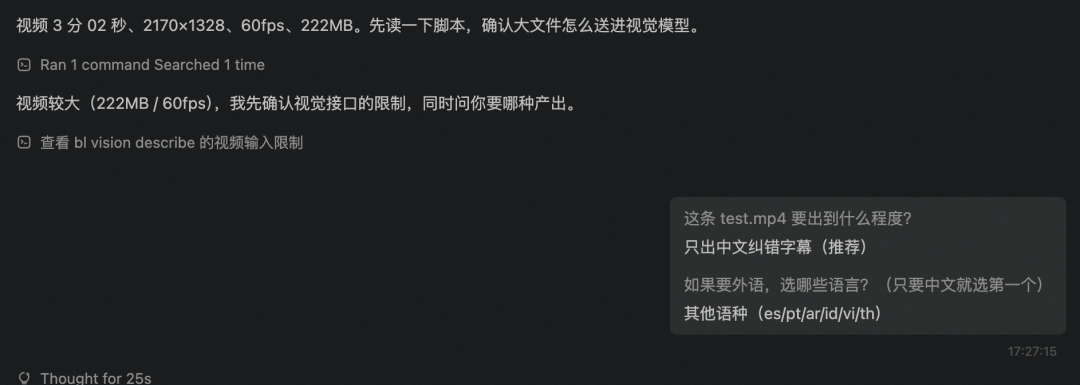
第 2 步:一条命令跑完整条录屏字幕生成+纠错
选中上一步安装好的 Skill,输入 /qwen-subtitle 指令,将录好的视频地址粘贴到指令后面。开始执行
原录屏:没有字幕且不带进度条
完成第一次纠错的录屏:生成了中文字幕且视频增加了进度条
除了字幕识别与纠错之外,这个 Skill 还有一个辅助功能:自动为视频添加底部进度条。
针对时长超过 3 分钟的视频,Skill 会自动计算并在视频底部渲染进度条。如果某些视频不需要显示进度条,也可以在配置项里直接关闭这个选项。
第 3 步:网页预览与错词库自动同步
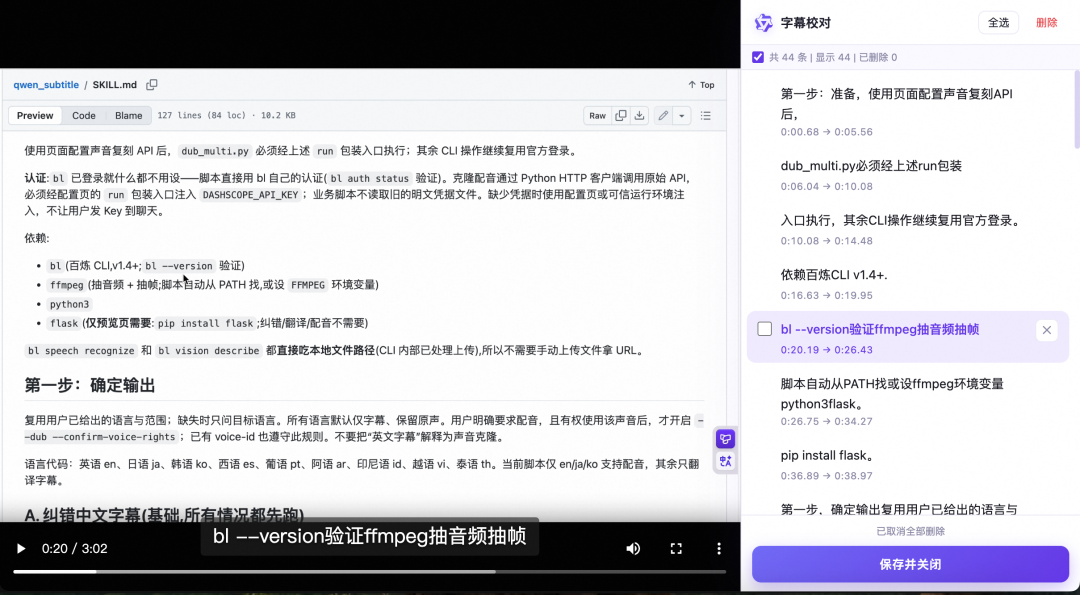
字幕生成并完成自动纠错之后,Skill 会提供一个本地网页预览界面。
页面的左侧可以实时查看视频播放和字幕的实际显示效果,右侧展示完整的字幕列表。点击列表里的任意一行,播放器会快速跳转到对应的时间点;双击列表文本,就可以直接编辑内容。
如果 AI 纠错之后仍然有个别遗漏,或者想微调格式(比如在英文单词与中文之间补充空格),可以直接在网页里修改并保存。确认没有问题后,再让 AI 执行最终的视频烧录。
在保存的过程中,Skill 会根据我们的修改行为做进一步判断:如果只是调整了空格或标点,系统不会记录;但如果发现我们把一个识别错误的词改成了正确词汇,它会自动把这组映射关系收录进错词库。这样在下一次处理新视频时,系统就会自动应用这套词汇规则,避免同一个技术名词反复识别出错。
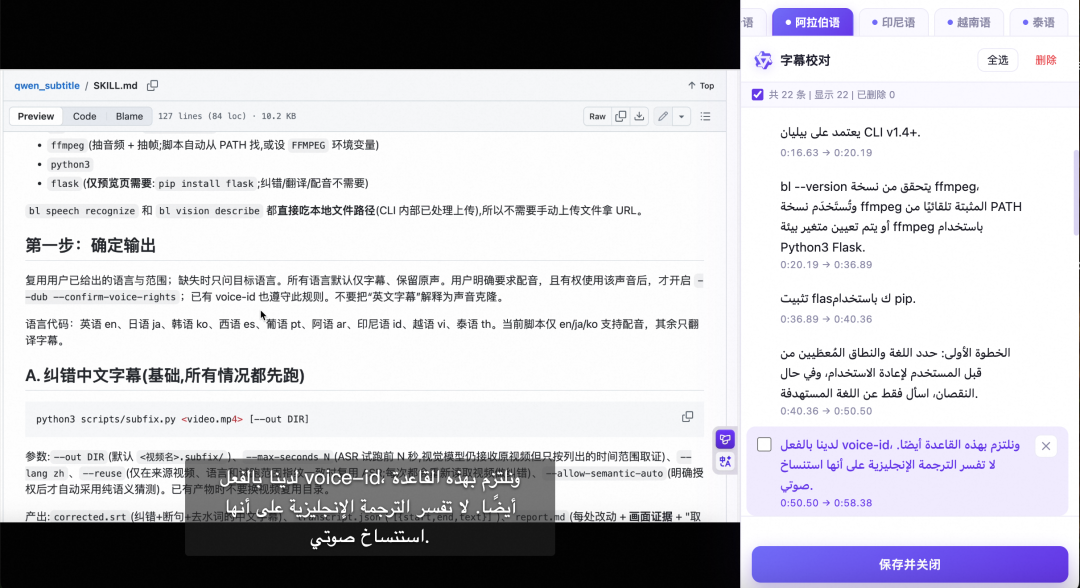
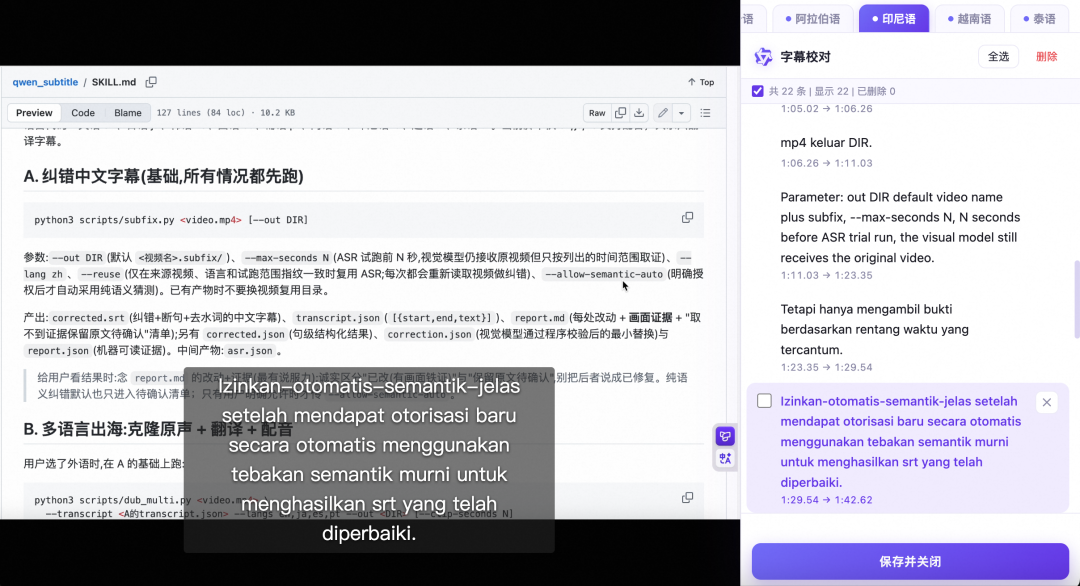
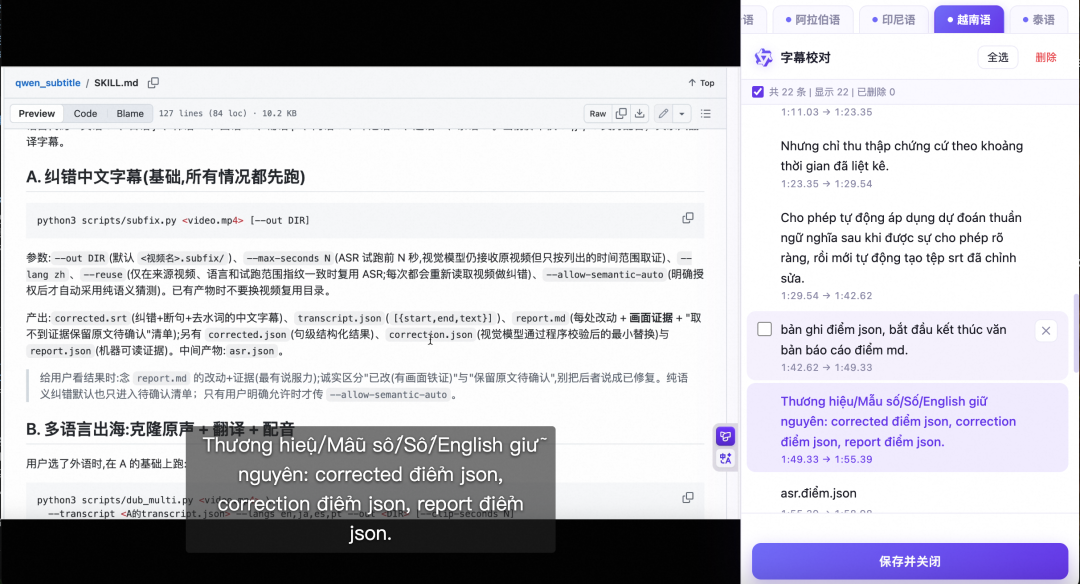
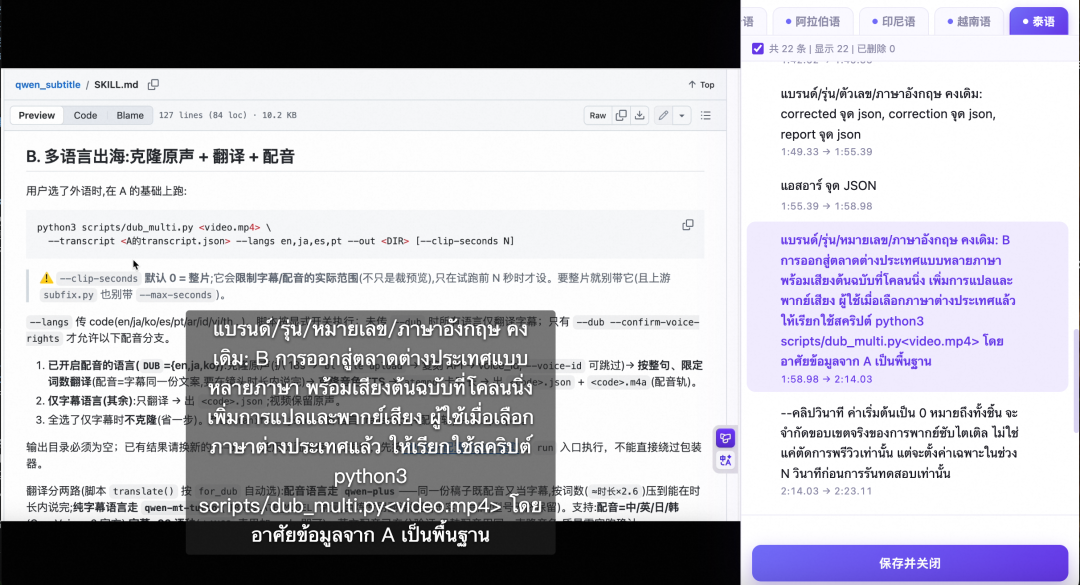
第 4 步:多语言字幕生成
第 5 步:多语言配音录屏生成
向Agent发送指令:克隆视频中的声音,按照纠错后的英文字幕,生成一条英文版录屏
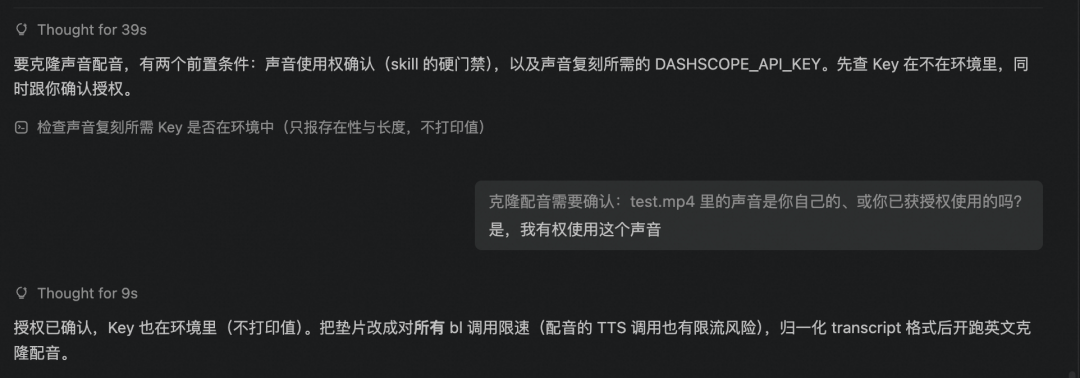
注意声音克隆必须显式选择并有声音使用权
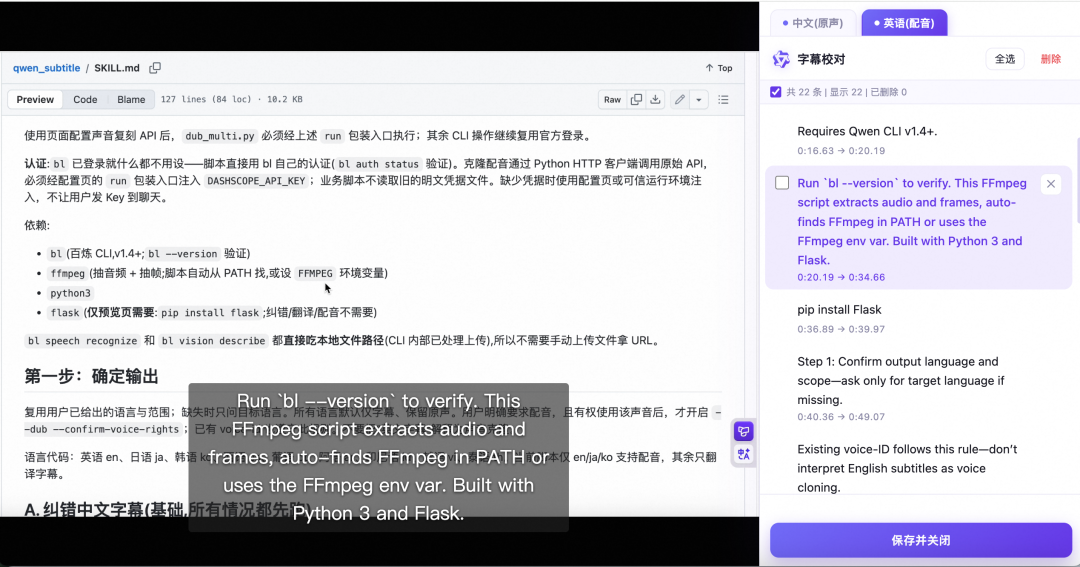
本案例只测试生成带有英文配音的录屏,更多语言配音,欢迎动手尝试
所有纠错步骤执行完毕之后,把最终确认的字幕烧录进视频,导出完整的视频文件。
如何用阿里云百炼 CLI 构建应用
1、打开阿里云百炼 CLI 官网
https://bailian.console.aliyun.com/cli
浏览模型服务、应用服务、工具能力。
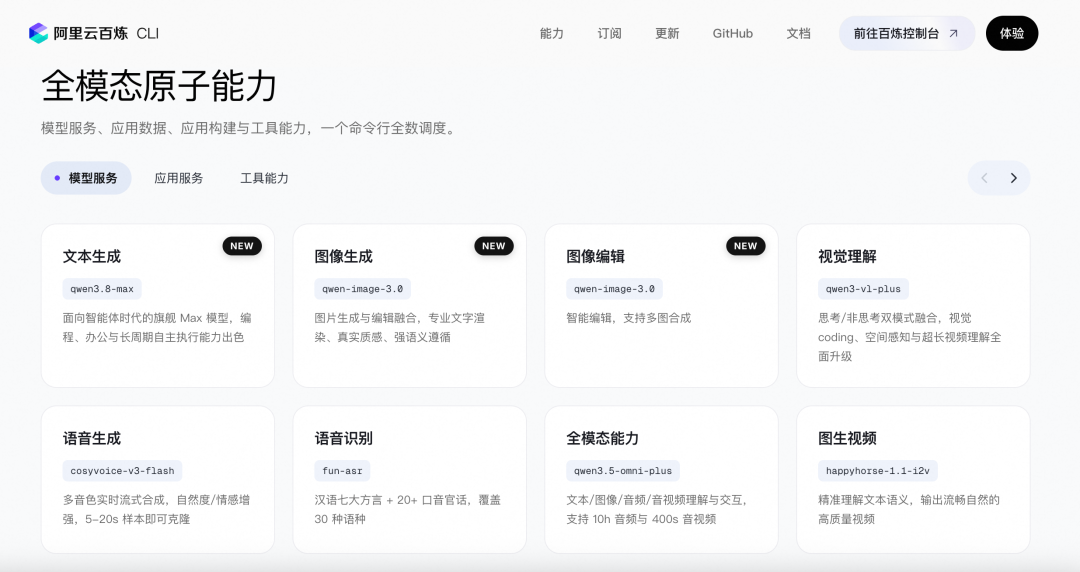
2、安装 CLI
复制下面的内容,告诉您的 AI Agent 阅读安装文档后,能够自动装好阿里云百炼 CLI。
请阅读:https://bailian.aliyun.com/cli/install.md 并按照说明为我安装阿里云百炼 CLI
3、鉴权配置
复制命令给 Agent 后自动完成鉴权信息配置。
帮我执行 bl auth login --console 控制台登录
4、开始使用
给您的 Agent 下发需求即可调度 CLI 能力进行产出,尝试给 Agent 发送第一个示例:
帮我执行 bl model list ,我要查看模型目录
本文开发者案例的五个步骤,就各自对应阿里云百炼的一种能力、一个模型、一条命令:
| 步骤 | 能力 | 模型 | bl 命令 |
|---|---|---|---|
| 1 听写 | 语音识别 | fun-asr | bl speech recognize |
| 2 看屏纠错 ★ | 一步完成标错、取证和最小替换 | qwen3.8-max(默认) | bl vision describe |
| 3 顺滑 | 断句(算法)+ 去水词 | qwen-plus | bl text chat |
| 4 翻译 | 字幕 / 配音稿 | qwen-mt-turbo / qwen-plus | bl text chat |
| 5 克隆配音 | 声音克隆 + 合成 | cosyvoice-v2 | bl file uploadbl speech synthesize |
也来提交你的案例
每一个案例的背后,都是一位具体的开发者。现在已经有 96 位开发者把自己的作品放了进来,覆盖内容出海、基础教育、无障碍、语言学习、生活健康、电商素材这些场景,这个数字还在涨。
JOTO 企业落地观察
- 该方案将视觉理解模型嵌入 ASR 流程,形成「语音+画面」双模态纠错闭环,对企业部署 RAG 知识工程具有启发意义:当结构化知识(如产品手册、UI 截图)可作为上下文注入纠错环节时,可显著降低专业领域 ASR 错误率,无需依赖海量标注数据微调模型。
- 其「最小替换」「不补全不扩写」「不确定即标记待审」等策略,体现了对智能体输出可控性的严格约束,这对企业级智能体工程中「可审计、可回溯、低幻觉」的要求提供了可复用的工程范式。
- 错词库自动同步机制本质是构建轻量级领域适配层,企业若将其与内部术语库、产品文档知识图谱打通,即可形成持续演进的私有化语音-视觉联合识别能力,避免重复投入人工校验成本。
- 全流程由 CLI 驱动、模块化拆分为 5 个原子能力,符合 FDE 驻场共创中「能力可插拔、流程可编排、结果可验证」的交付原则,便于企业根据自身合规要求裁剪配音、克隆等敏感环节。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们