知识库里一半答案是图,检索却只认字:一个 740M 免费模型把盲区填上了——我们跑通给你看
Google DeepMind 于2026年10月6日发布开源多模态嵌入模型 EmbeddingGemma 2(740M 参数,Apache 2.0 许可),支持文本、代码、图像、视频、音频五种模态统一映射至同一向量空间。实测表明,该模型可使纯图答案(如报错弹窗截图、PPT流程图)进入检索候选集,解决企业知识库中图文资产割裂导致的检索盲区问题。
知识库的图文割裂是真实痛点
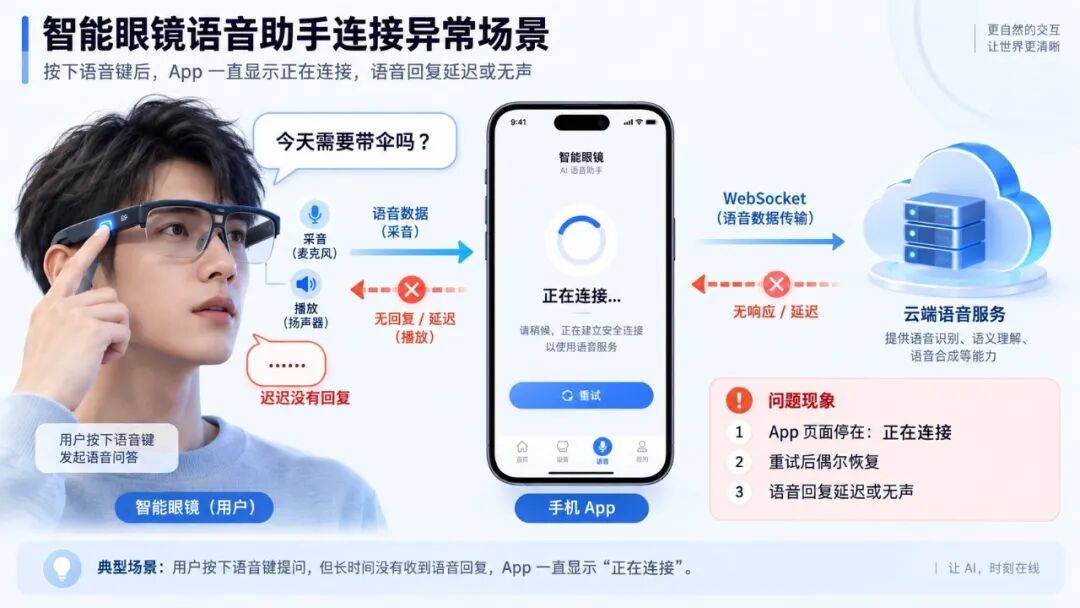
客服群里有人贴了张报错弹窗的截图,问“这个怎么处理”。新来的客服在知识库里搜了一圈,翻了十几篇文档,全是配置说明和操作手册,没有一条对得上截图里的报错。最后是老员工翻了三年前的内部记录,才找到当时处理这个报错的操作录屏。答案一直躺在知识库里,只是它是一张图,而检索只会认字。
这是企业知识库的老毛病。文档、FAQ、操作手册这些文字资产进得了 RAG;产品截图、操作录屏的帧、工单里的手机拍屏、PPT 流程图表,这些图占了知识库相当一部分,在检索眼里却是透明的。不是它们不重要,是纯文本嵌入天生看不到图。
传统方案贵、碎、难维护
要把图接进检索,通常得拼两条管线:
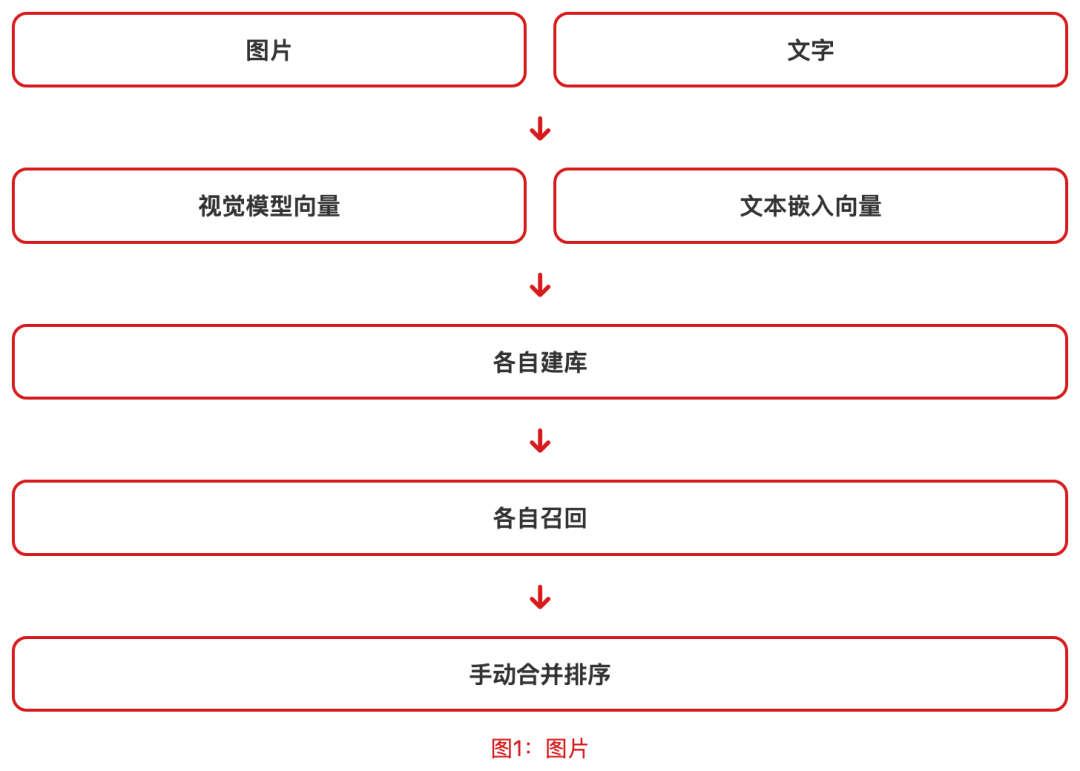
两套模型要分别维护,图文向量的空间对不齐,查询时还得写胶水代码做重排。贵、碎、难维护,所以真正落地的人少。
EmbeddingGemma 2 实现单模型统一嵌入
EmbeddingGemma 2 干的事,是把图文向量对齐这条碎路合回一条。2026 年 10 月 6 日 Google DeepMind 发布这个开源模型:740M 参数,Apache 2.0 许可,文本、代码、图像、视频、音频五种模态直接映射进同一个向量空间。一张报错截图和一段配置说明,落在同一个空间里,距离可以直接比较,不再需要两套模型拼装。
关键事实如下:
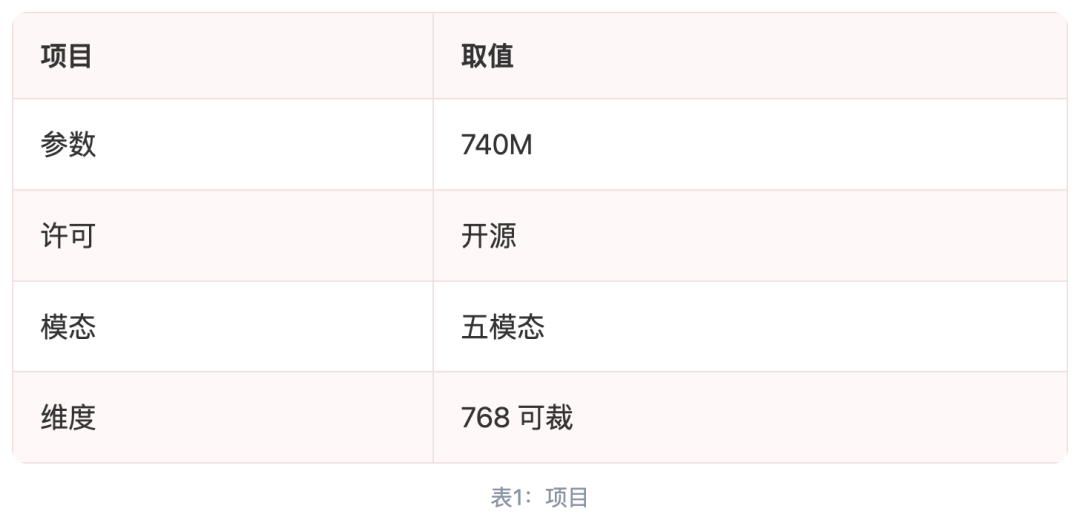
得益于 Matryoshka 表示学习,输出向量可以从 768 维截断到 512、256、128 维。维度降了,存储和算距离的成本跟着降,精度损失可控。图片多的时候先跑 128 维把成本压下来,命中率不够再往上提。模型权重在 HuggingFace 和 Kaggle 都有入口,sentence-transformers 几行就能加载,Google AI Edge 给出端侧部署路径。没有嵌入 API 月账单,一台带显卡的开发机就能跑。
实测:四条纯图答案中三条进 top-5
到这里还是模型解读。真正的价值是上手跑一遍:把文档和截图混着建进一个向量库,同一组问题分别用纯文本嵌入和统一嵌入去检索,看图片资产到底能不能被捞出来。
我准备的语料模拟中小企业知识库的真实形态:十来份产品文档和 FAQ 当文字资产,十六张图当图片资产——有报错弹窗截图、操作界面截图、手机翻拍的屏、PPT 流程图。图片不附加任何文字说明,文件名也是无意义序号,就是要逼它靠图本身被检索到。
建库三步:
- 装好 sentence-transformers 等依赖,下载 1.4GB 权重加载模型(老 Intel Mac 的 torch 轮子已停更,进 Docker 跑最省事)。
- 每张图走模型的图像分支编码成 768 维向量,写进向量库。
- 文档切片走文本分支编码,写进同一个库,和图片向量共享一个空间。
核心就几行,文本和图片是同一条编码入口:
emb = model.encode(chunk, prompt_name="Document")  # 文档切片入库
emb = model.encode({"image": screenshot})          # 截图入库
index.add(emb)  # 向量库任选;演示里直接用 numpy 矩阵
完整脚本我们整理在配套 AgentCase 档案里,这里只给最核心的入口。跑起来什么量级?我这台 2018 款、没有独显的 Intel MacBook 上,模型全量加载十几秒,二十六条语料建库花了三分钟——慢点全在图片编码,一张图约十一秒、一条文档不到一秒;检索本身毫秒级,内存峰值 4.4GB。
对比实验我设计了九条查询,分三类:答案纯在文档里的两条、答案只在图片里的四条、图文都相关的三条。每条查询执行流程如下:
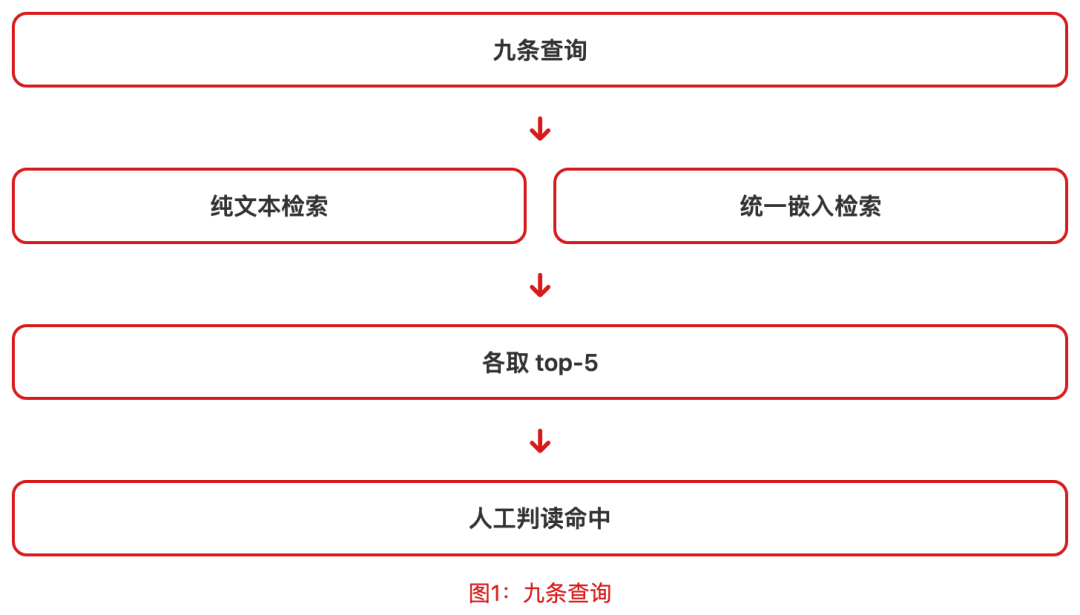
我一开始最担心图片质量。结果跑下来,三类查询的 top-5 命中汇总如下:
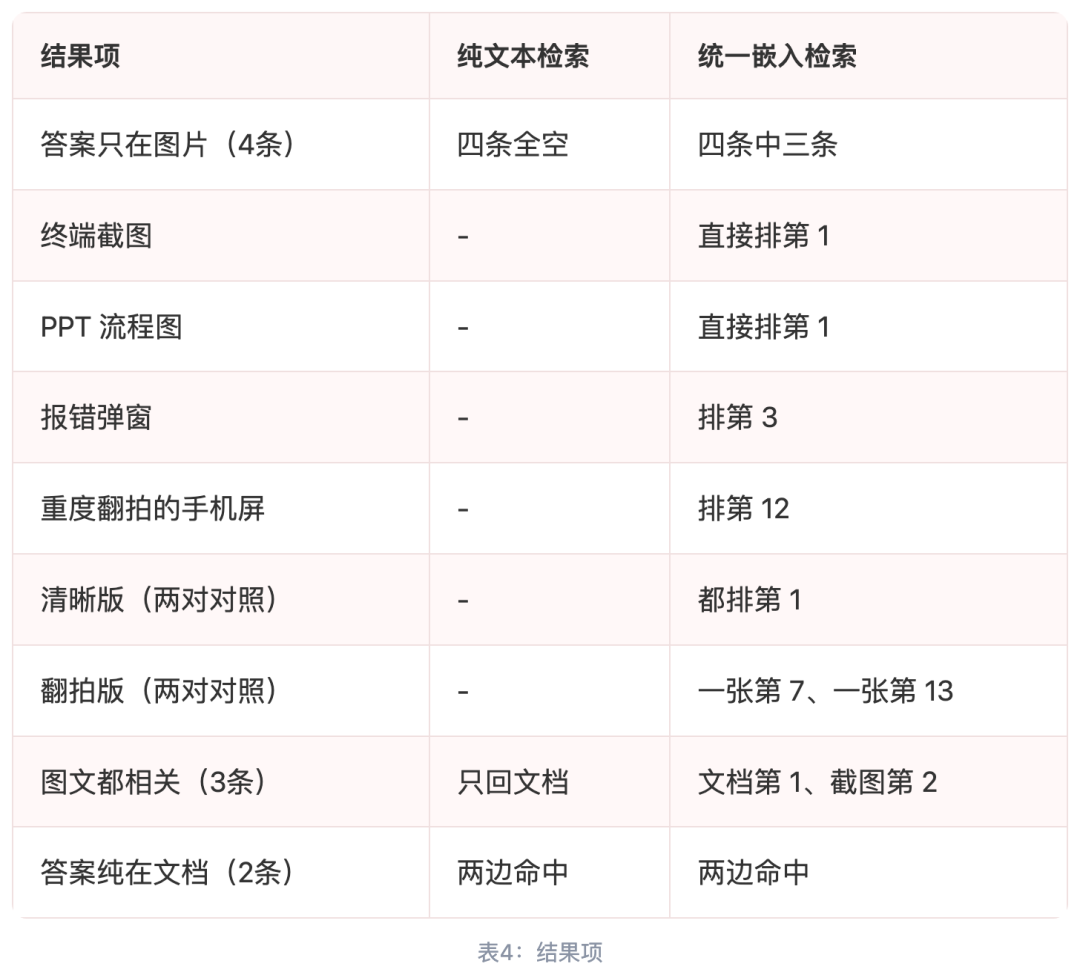
其中,答案只在图片里的四条问题,纯文本检索四条全空——因为图根本不在它的索引里,这不是能力问题,是盲区本身。统一嵌入四条中了三条:终端截图、PPT 流程图直接排第 1,报错弹窗排第 3;唯一失手的是重度翻拍的手机屏——倾斜、摩尔纹、糊成一片,正确答案在全库二十六条里排第 12。同一张图的清晰版和翻拍版对比更直观:两对对照里,清晰版都排第 1,翻拍版一张第 7、一张第 13。图文都相关的三条,统一嵌入把文档和截图一起带回来——文档第 1、截图第 2;纯文本检索只回文档。答案纯在文档里那两条,两边也都命中。
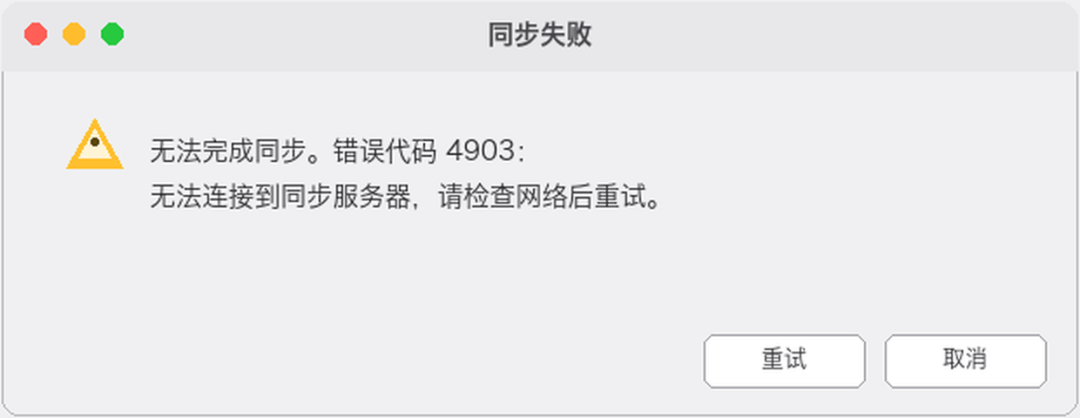
举例:报错弹窗那张截图,纯文本检索的 top-5 全是“常见报错排查”这类文档,没有一个真正对得上弹窗内容;统一嵌入把它排到第 3——前两名是错误码对照表和排查指南,都是相关内容。图文混进同一个候选池之后,文档和截图会互相争位次。差别不在算法先不先进,在图片资产终于进了候选集。
这条弹窗就是被一句话搜出来的:查询句是“桌面端同步失败弹窗报错”,它在统一嵌入的 top-5 里排第 3——开场客服贴的那种图,现在文字能把它捞回来。
落地建议与边界条件
想在自家 KB 借鉴这套思路,验收看三件事:
- 抽 20 条真实业务查询,人工标好“哪些问题只有图片能答”。
- 跑统一嵌入检索,核对这类问题里正确截图是否进 top-5。
- 对没进 top-5 的样本归因:截图质量差、查询和图片内容隔太远,还是维度截得太狠。
失败边界也要写清。手机翻拍的图,翻拍质量差到一定程度——倾斜、摩尔纹、糊——top-5 也会失守,实测里最差的一张掉到第 12;先做一轮截图规范化、关键图补 OCR,更划算。图片占比本来就低的库,专门跑一套多模态建库不一定划算,先盘完资产占比再动手。领域太窄且专有名词密集,740M 的通用模型可能不如垂直专用嵌入,先拿小规模标注集做一轮对比再决定。
谁该现在上?知识库里截图、录屏帧、工单图片占比高,客服或内部问答经常遇到“答案在图里”,这篇正好补上。谁该再等等?图片本来就少、OCR 已覆盖大部分图表、或对精度极度敏感的场景。
上次写 IBM Granite 聊的是嵌入模型怎么变便宜,这次聊的是 Gemma 家族的嵌入模型第一次认图——两篇不冲突,Granite 是纯文本嵌入,看不懂图;更早的企业知识库选型管文档规模档位,这篇补图片资产盲区。如果你正在做企业知识库或客服 Agent,图一直是个绕不过去的暗角,我们可以从语料盘点开始,把图文混合检索的建库、更新、验收一条链跑起来
JOTO 企业落地观察
- 企业知识库若存在大量未 OCR 化的截图、录屏帧、工单照片等非结构化图像资产,采用统一多模态嵌入可实质性降低“答案存在但不可检”的误判率,无需重构现有 RAG 架构,仅需替换嵌入模型并扩展图像预处理环节。
- Matryoshka 向量截断机制为企业提供了明确的性能-精度权衡路径:在资源受限环境(如边缘设备或轻量级服务)中,可先以 128 维向量完成初筛,再对高置信度候选集升维重排,避免全局高维计算开销。
- 该模型对翻拍图像鲁棒性有限,意味着企业若计划规模化接入手机拍摄类工单图,需前置部署标准化图像增强流水线(如畸变校正、摩尔纹抑制、分辨率归一化),而非依赖嵌入模型自身泛化能力。
- 统一嵌入不改变 RAG 的召回-重排范式,但将图像资产纳入初始召回池后,重排模块需适配图文混合排序逻辑——例如引入跨模态相关性打分或图文一致性约束,否则易出现文档与截图语义错位的高位次结果。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们