实时字幕只出字还不够,它还得知道谁在说
微软新发布的 VibeVoice-ASR-Streaming 实现端到端流式语音识别与说话人归属联合生成,延迟约2秒,支持10种语言。其核心价值在于实时场景中准确绑定语句与说话人,适用于会议纪要、客服质检和多人语音Agent。论文显示7B模型在说话人归属指标上12/13项达最优,但流式代价是WER/cpWER较非流式版本下降0.75–6.67点。
一场三个人以上的会议里,转写错一个词未必致命,把承诺记到错误的人名下才是真的麻烦。
普通流式 ASR 解决的是“声音刚进来,文字就出来”。但要把结果直接交给会议纪要、客服质检或语音 Agent,系统还得回答另一个问题:这句话是谁说的?微软新发布的 VibeVoice-ASR-Streaming,就是把这两件事塞进一次流式生成里。
它解决的不是字幕速度,而是实时归属
传统方案通常先做 ASR,再把音频交给说话人分离或 diarization 模块,最后按时间戳把两份结果拼回去。离线处理还能慢慢校正,到了直播、在线会议或多人语音 Agent,链路每多一层,延迟和错位风险都会增加。
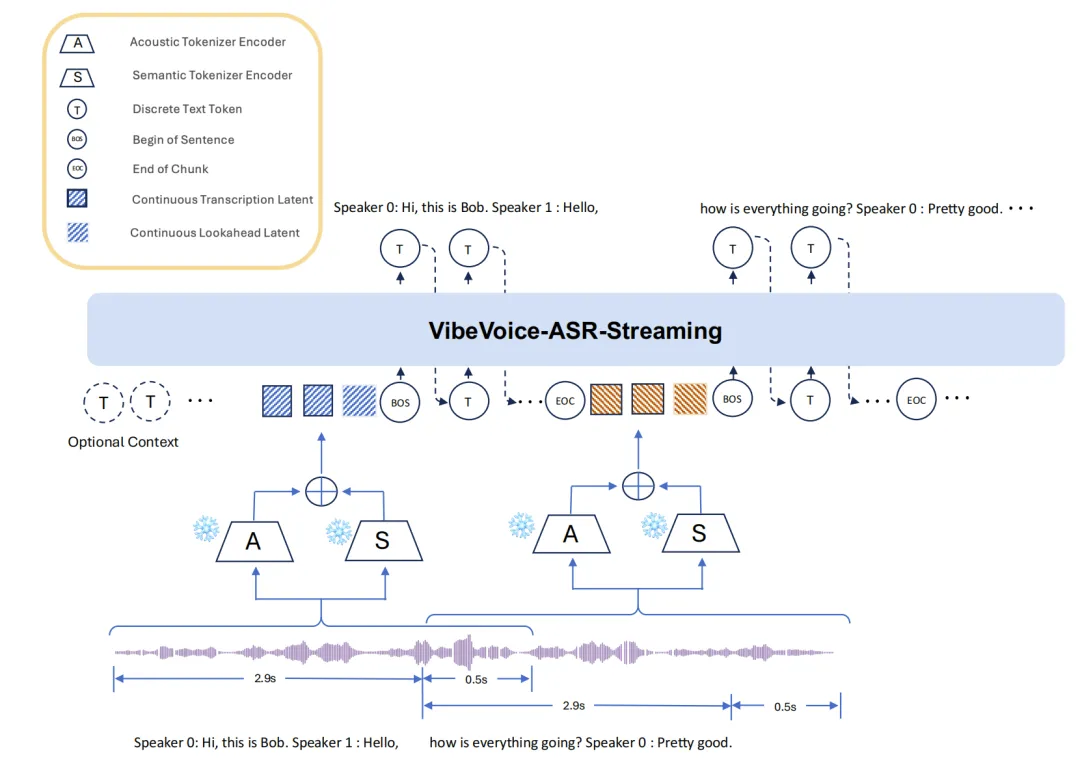
VibeVoice-ASR-Streaming 改成端到端生成:音频持续进入,模型按 chunk 输出文本,并在句子前带上 speaker 标签。它不是等录音结束再统一分角色,而是在人还在说话时就持续回答“谁说了什么”。
这对三个场景特别有用:会议字幕要把决定落到正确的人;客服质检要区分坐席和客户;多人语音 Agent 要知道当前指令来自谁,才不至于把旁边人的话当成操作命令。
两秒左右,它是怎么做到的
论文里的默认 22-frame 配置,会取约 2.9 秒当前语音,再多看 0.5 秒未来音频。这里的短暂 lookahead 是关键:模型不用等整段录音结束,又能借一点后文判断句子边界和说话人变化。
当前语音、少量未来语音和前面已经生成的文本,会交错进入同一个语言模型上下文。系统因此能够延续上一段对话里的说话人关系,而不是每个 chunk 都从头猜一次。默认配置的预期说话人归属延迟约 2.00 秒;如果换成 15-frame,可降到 1.53 秒,但识别和归属准确率也会下降。
这个取舍很现实。直播字幕可能更在意快,会议纪要更在意别认错人。论文给出的结果也说明,chunk 不是越短越好,模型规模同样不是越小越划算。
数据最好的一项,是“谁说的”
在论文统一比较的五组评测平均值上,VibeVoice-ASR-Streaming-7B 的 WER/CER 为 24.66,略低于 Gemini 3.5 Transcribe Live 的 25.23,也明显低于另外三套参照系统。中文、日语和韩语用 CER,其余语言用 WER,所以这张图适合看同表内的相对位置,不应拿去推导所有真实业务场景的绝对准确率。
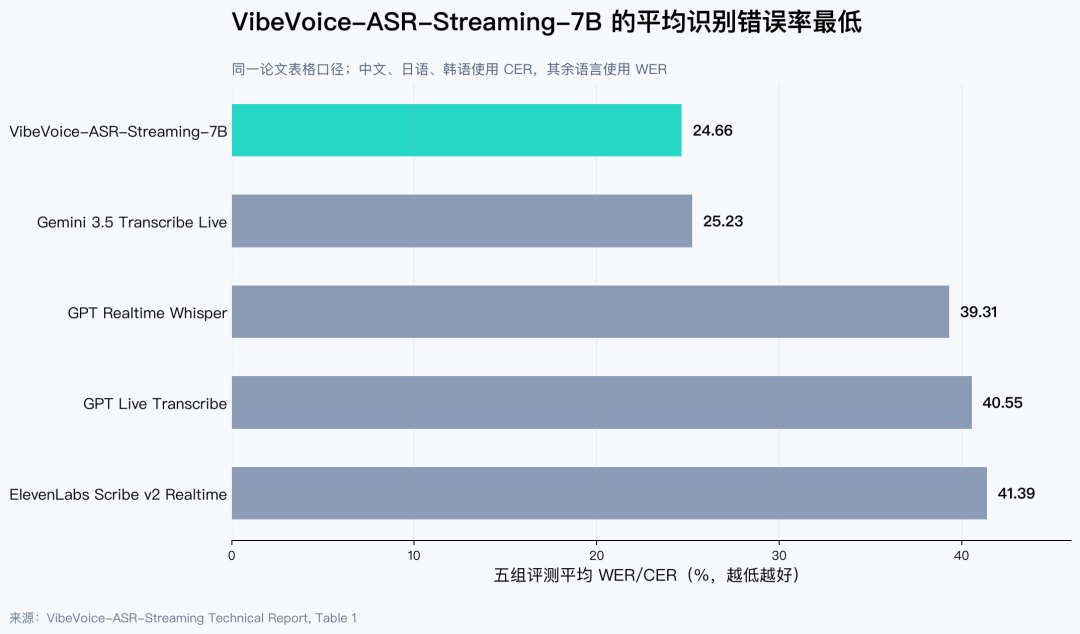
更重要的是说话人归属。技术报告称,7B 模型在 13 个评测设置里有 12 个拿到最佳或并列最佳;在会议 benchmark 上,相比 Azure ConversationTranscriber,cpWER/cpCER 改善 2.39 至 12.45 个点。对于多人实时转写,这比单独少错几个字更接近真正的使用价值。
但流式不是免费的。与同源非流式 checkpoint 相比,流式版本的 WER/CER 增加了 0.75 至 3.53 个点,cpWER/cpCER 增加了 5.13 至 6.67 个点。你得到的是边说边出的结果,代价是看不到完整后文,尤其说话人归属更容易受影响。
第一次体验,先别急着上生产
想快速感受效果,可以先打开官方在线演示,录一段两个人轮流说话的音频,观察每个 chunk 是否及时出字、speaker 标签会不会串人。真正部署时,官方推荐使用带 CUDA GPU 的 NVIDIA PyTorch 容器;文档没有给出最低显存,别在选机器时凭模型参数量硬猜。
第 1 步,启动官方验证过的容器
sudo docker run --privileged --net=host --ipc=host \ --ulimit memlock=-1:-1 --ulimit stack=-1:-1 \ --gpus all --rm -it nvcr.io/nvidia/pytorch:25.12-py3官方文档注明 NVIDIA PyTorch Container 24.07 到 25.12 已验证。如果镜像里没有 FlashAttention,还需按其官方说明安装。
第 2 步,安装代码和 FFmpeg
git clone https://github.com/microsoft/VibeVoice.git
cd VibeVoice
pip install -e .
apt update && apt install ffmpeg -y
安装完成后,应能在仓库的 demo/ 目录看到流式文件推理和 FastAPI 演示脚本。
第 3 步,用一段短会议录音检查结果
python demo/vibevoice_asr_streaming_inference_from_file.py \ --model_path microsoft/VibeVoice-ASR-Streaming-7B \ --audio_files /path/to/meeting.wav \ --context_info "VibeVoice,产品名称,参会人姓名"把音频路径和热词替换成自己的内容。程序会按 chunk 打印结果,第一次验证不要上来就塞长录音,先用一段说话人清楚、内容已知的双人对话,检查文字和 speaker 标签是否同时正确。
如果需要浏览器麦克风输入,可以运行:
python demo/vibevoice_asr_streaming_fastapi_demo.py \ --model_path microsoft/VibeVoice-ASR-Streaming-7B然后打开 http://localhost:7870。官方文档说明页面会通过 WebSocket 保持整段录音连接,让文字在说话过程中持续出现。
这几个边界,比排行榜更值得先看
第一,官方流式版本目前标注支持 10 种语言,不要和非流式 VibeVoice-ASR 的 50 多种语言混在一起。
第二,公开 checkpoint 支持最长约 8 分钟录音。更长会持续增加上下文和计算成本,如果要做长会议,应先评估分段和会话续接策略。
第三,它能处理多说话人,但多人同时讲话仍会让性能下降。模型最终还是把语音内容串行生成成一条文本流,不是专门的语音分离器。
第四,1.5B 更轻,但论文消融里 7B 的识别和说话人归属明显更稳。对准确率敏感的会议与客服场景,7B 更适合作为第一条验证路线;只想轻量试跑,再考虑 1.5B。
VibeVoice-ASR-Streaming 的价值,不是让所有录音转写都换模型。它真正适合的是那些不能等会后、又不能把人认错的任务。先拿一段真实双人对话测“文字、说话人、延迟”三个指标,再决定要不要把它接进系统,这比只看一张排行榜靠谱得多。
JOTO 企业落地观察
- 该模型将说话人归属嵌入流式 ASR 主干,意味着企业若需构建实时语音Agent,无需再集成独立 diarization 模块,可降低工程耦合度与延迟风险。
- 其 2 秒级归属延迟与明确的 10 语言支持范围,提示企业在设计跨语言会议系统时,需同步规划语种覆盖策略与实时性 SLA,而非仅关注单语识别准确率。
- 流式版本相较非流式在 cpWER 上下降超 5 个点,说明当企业选择“边说边出”架构时,必须接受说话人归属精度的确定性折损,并在质检规则中预留容错空间。
- 官方未提供最低显存要求,且依赖特定 PyTorch 容器与 FlashAttention,表明该模型尚未完成面向企业推理基础设施的轻量化封装,FDE 驻场共创阶段需重点验证部署适配成本。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们