iPhone断网跑35B多模态!国产开源新模型,只占3G内存
面壁智能与OpenBMB开源MiniCPM-V 4.7,含35B-A3B(MoE结构,仅激活3B)和1B两个版本,可在iPhone 17 Pro Max等端侧设备断网运行,解码速度超13 token/s,内存占用约3GB。模型在MMBench、OmniDocBench等基准测试中领先,支持iOS/安卓/鸿蒙及主流推理框架。
把35B装进口袋,断网也能用
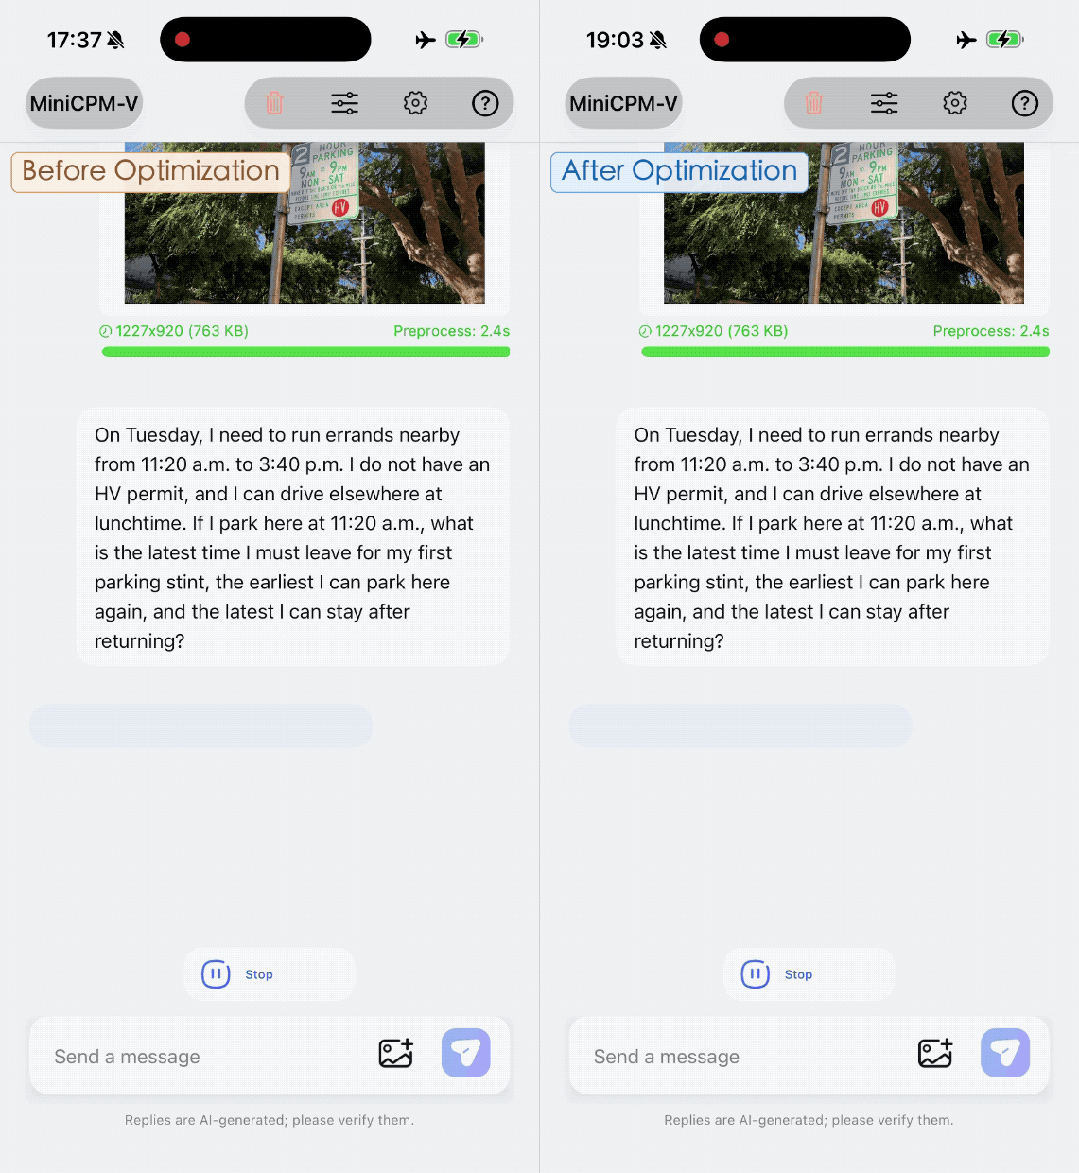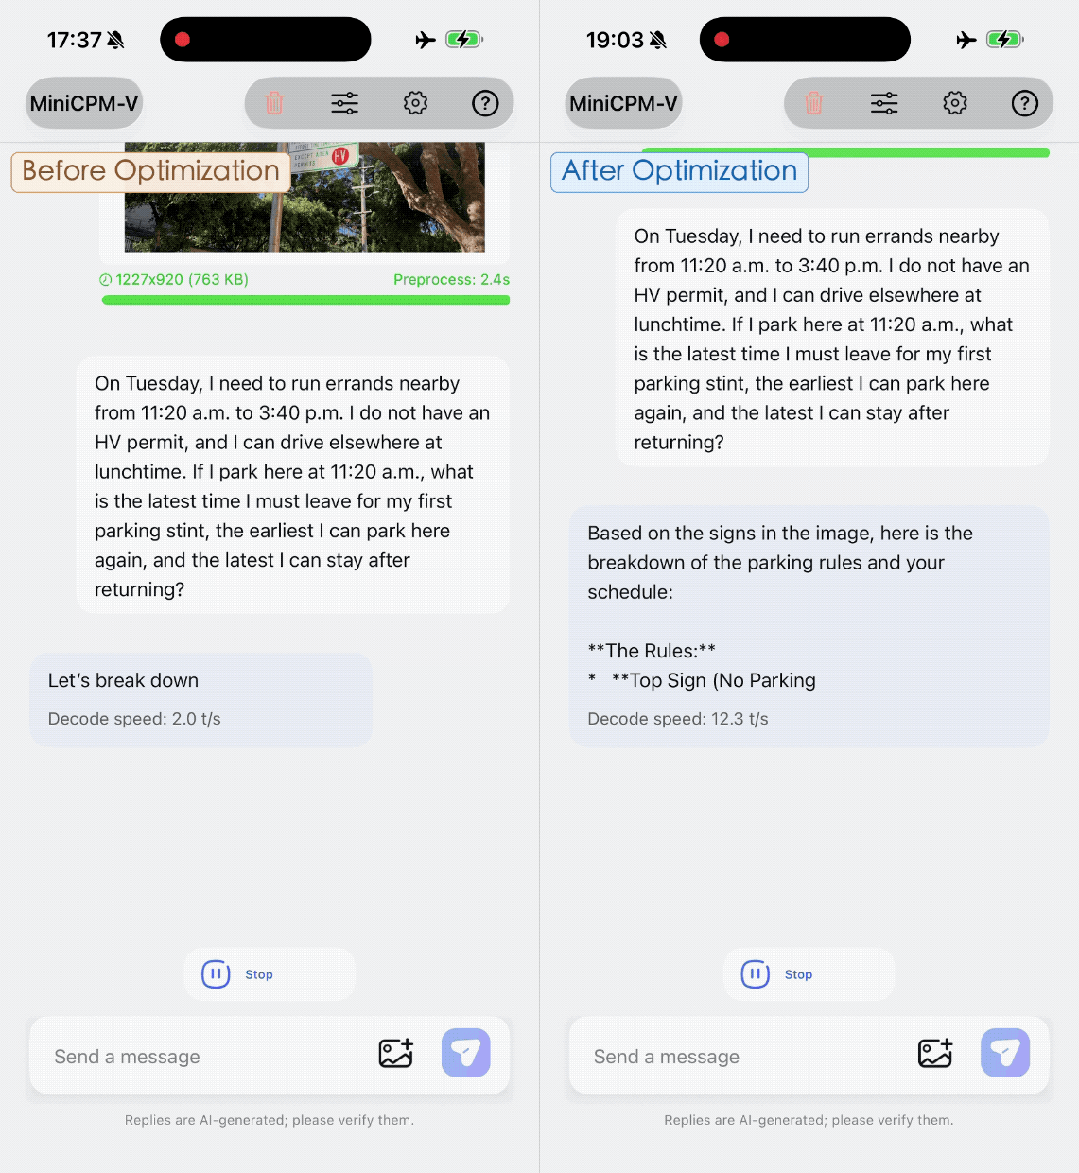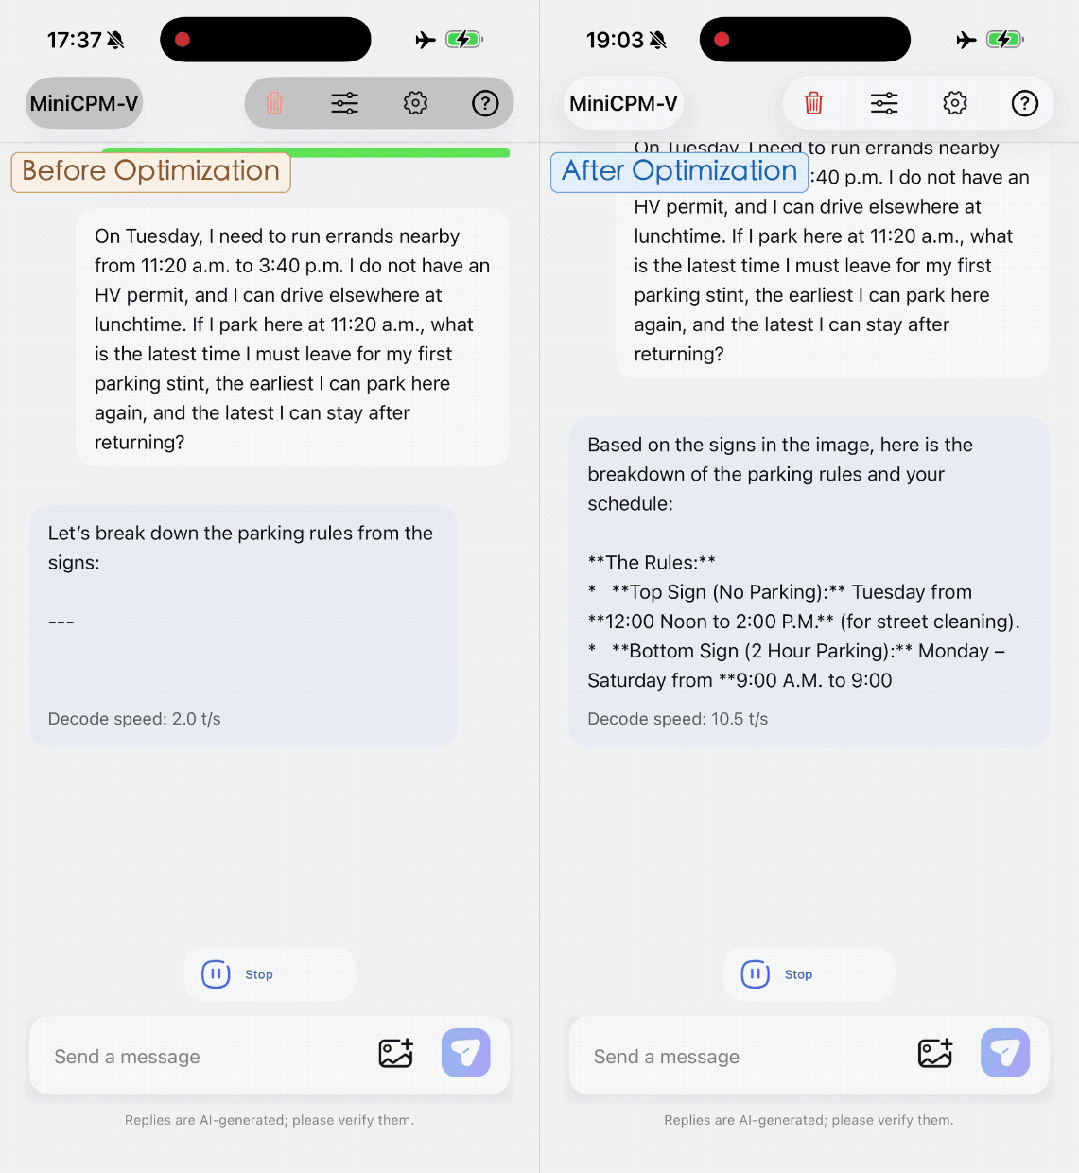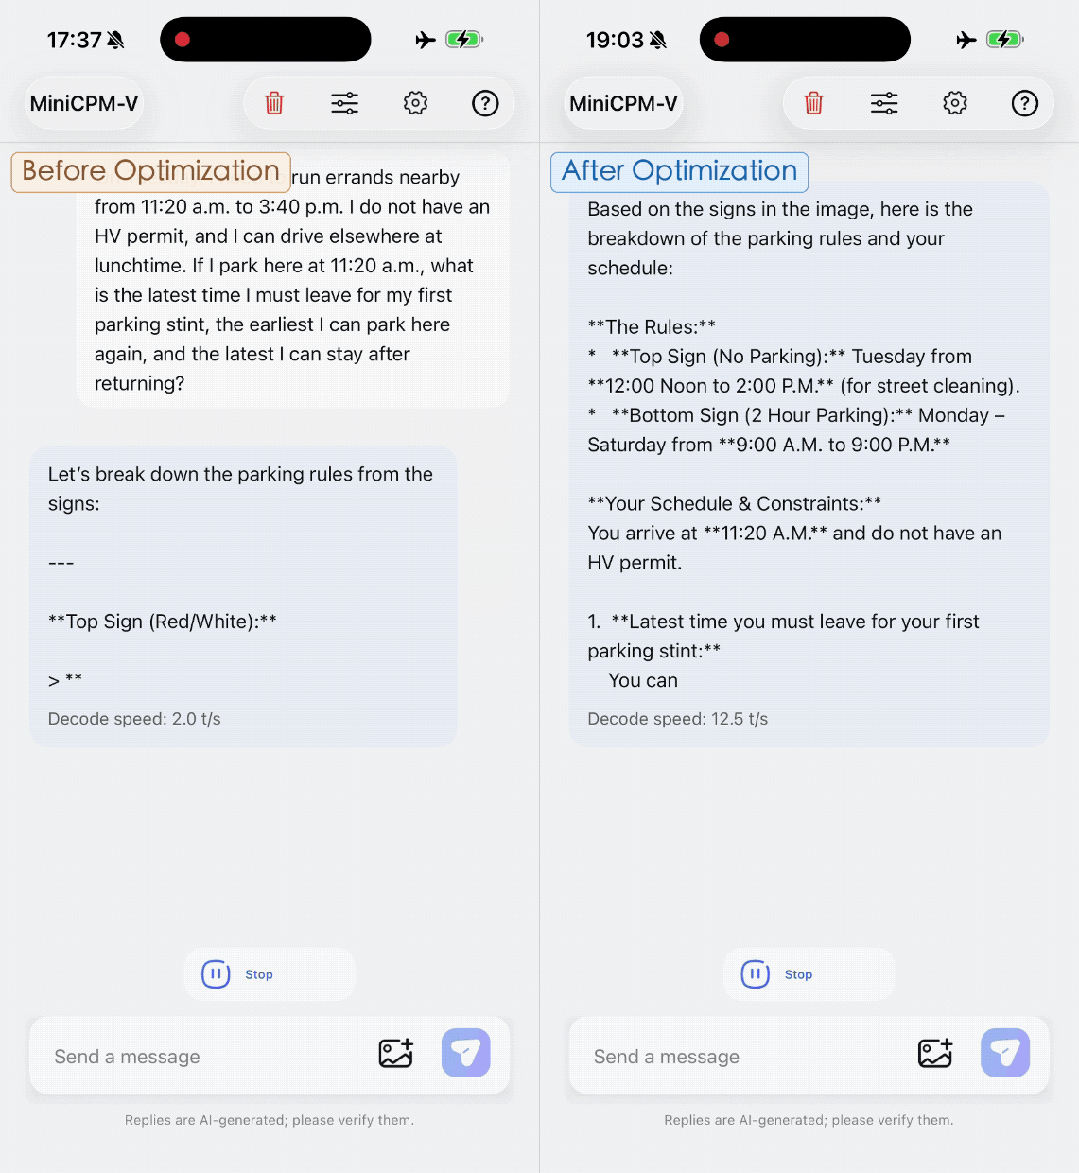
先来看一道和我们生活比较贴近的题目。
这次给模型输入的,是一张家庭用电调查表,上面列着空调、冰箱、电热水壶、电视、洗衣机和待机设备的功率与使用时长,再附上这个月的电费账单,一共420度电,126块钱。
这道题的问题一共有三个,它们分别是:
先估算每样电器一个月用多少电,排个序;再算算这几样加起来能解释账单的百分之多少,差出来的那部分能不能全算到别的电器头上;最后在三个省电方案里挑出最省的那个,分别是空调每天少开1小时、电视每天少看2小时,以及待机设备每天彻底断电8小时。
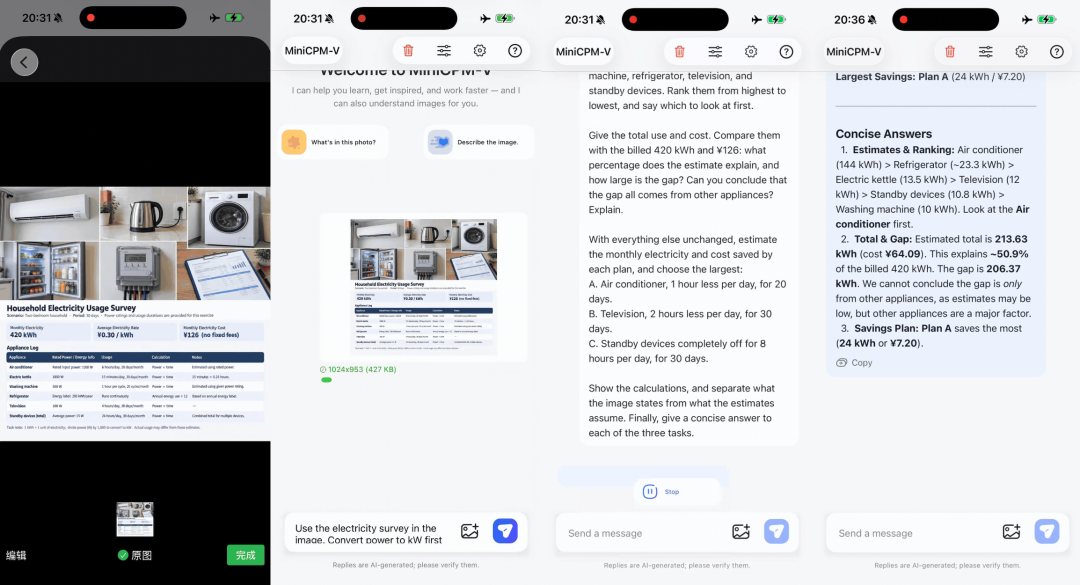
从结果来看,35B-A3B先把瓦换算成千瓦,再拿功率乘以使用时长,一项一项往下算。空调每月144度,排在第一位;冰箱则按标签上的年耗电280度,折算成每月约23.33度;后面依次是电热水壶、电视、待机设备和洗衣机。
六样电器加起来约213.63度,按账单的电价折合64.09元,只能解释账单的50.9%左右,还差206.37度。三个方案里,空调少开1小时最划算,一个月能省24度电,合7.2元。
可以看到,即便是在断网状态下,面对如此复杂的图表,35B-A3B依旧是稳稳拿捏住。
看完35B,我们再来看看1B这边的效果;这次给1B的任务,是把一页论文转成Markdown:
请将这个图片转写为markdown。
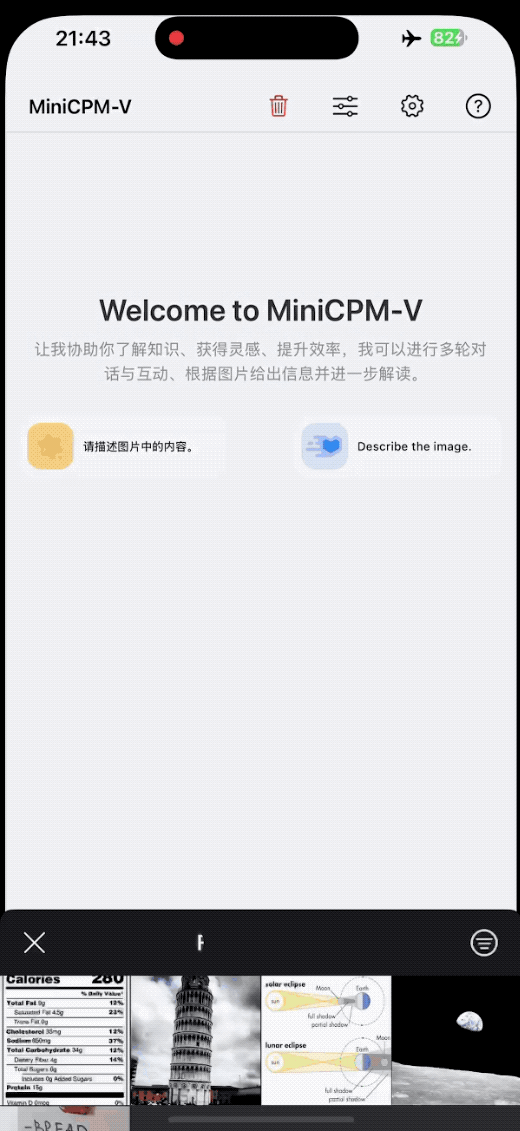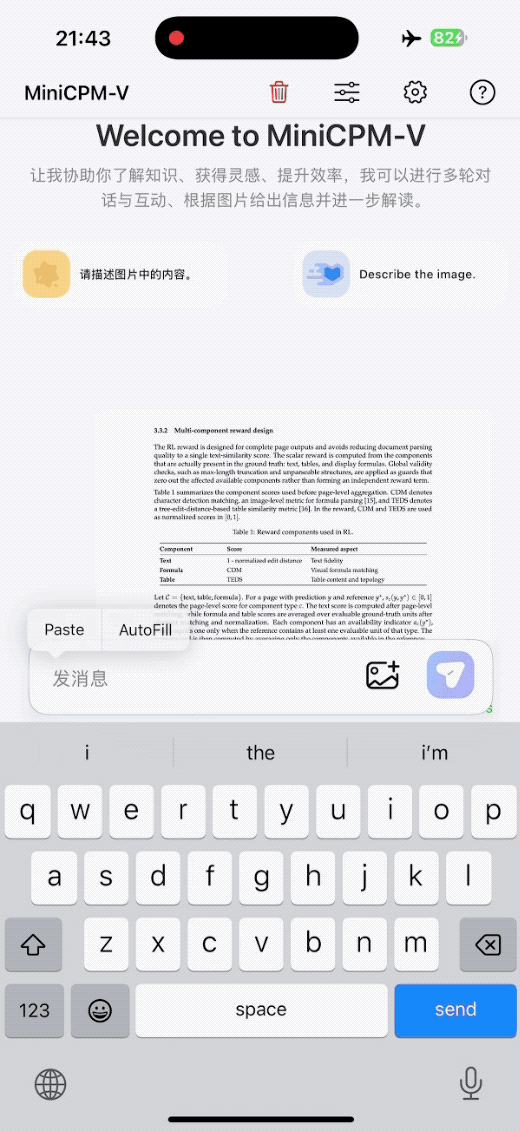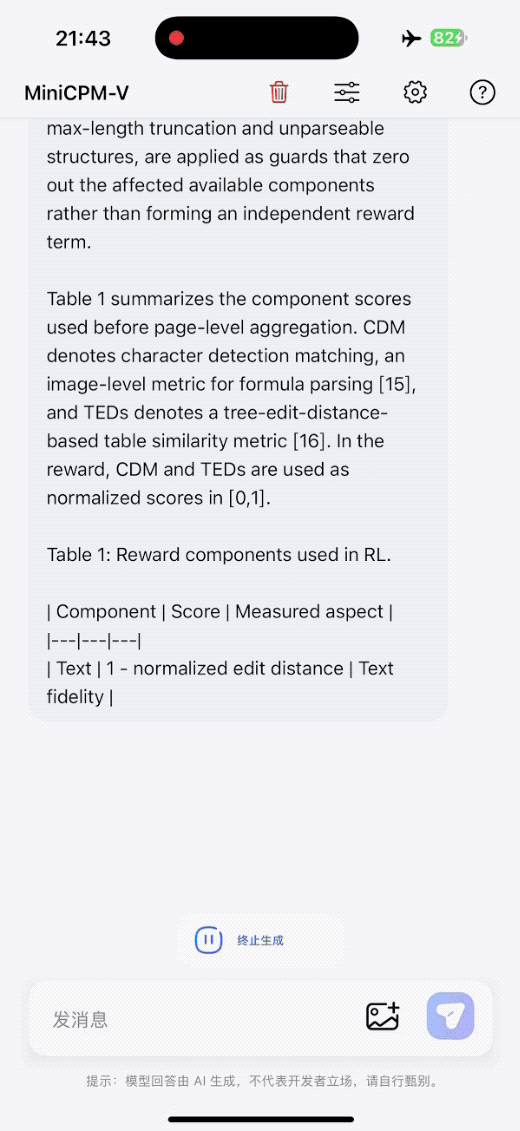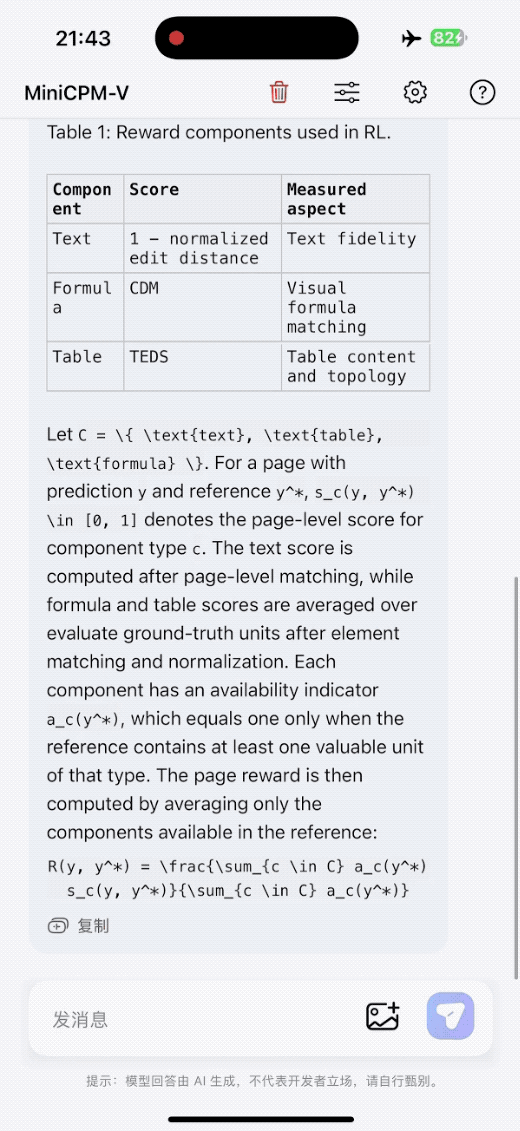
不到半分钟的时间,标题层级、段落和表格都被还原了出来,公式也写成了LaTeX,渲染之后和原文的排版基本对得上。
对经常要把论文截图、PDF页面搬进笔记的人来说,这类活儿过去大多要联网交给云端模型。现在一个1.3B的小模型,在手机本地就能干完。
当然,除了手机之外,像iPad这样的端侧设备,同样也是不在话下。
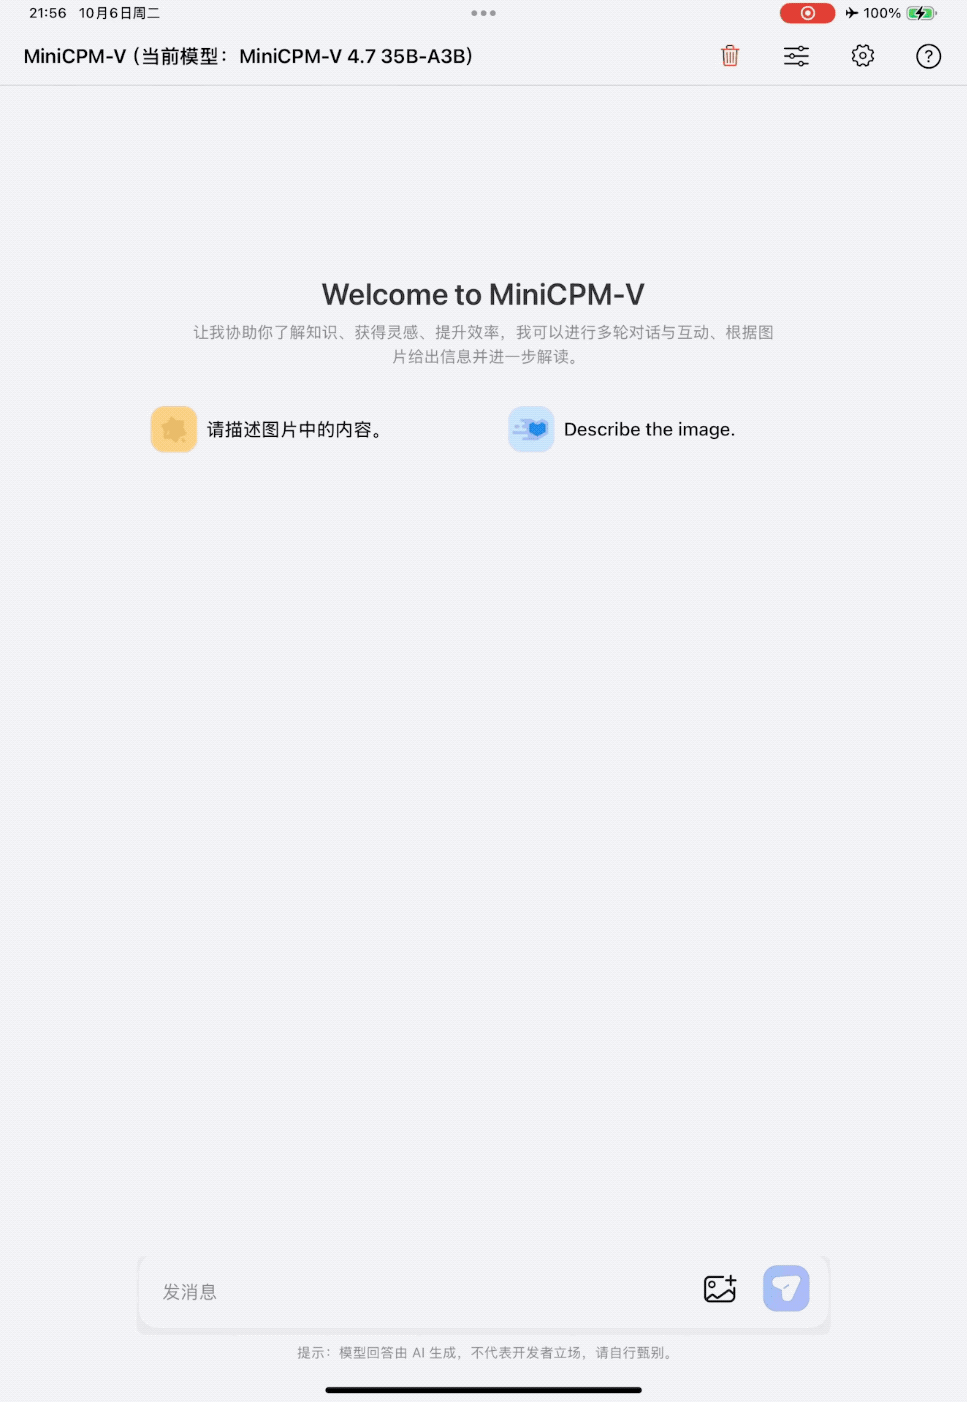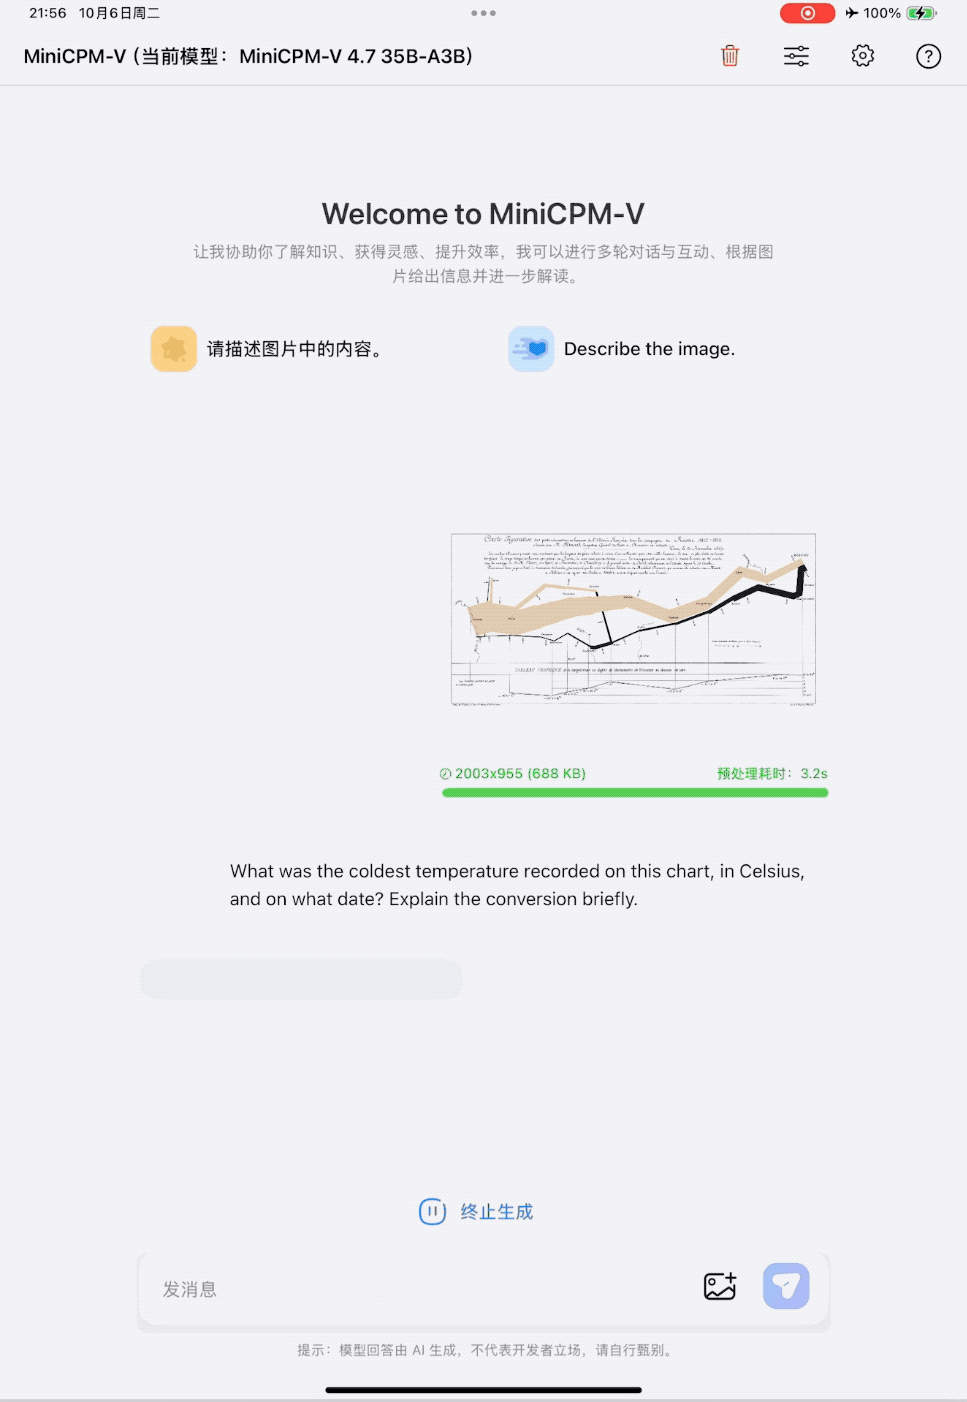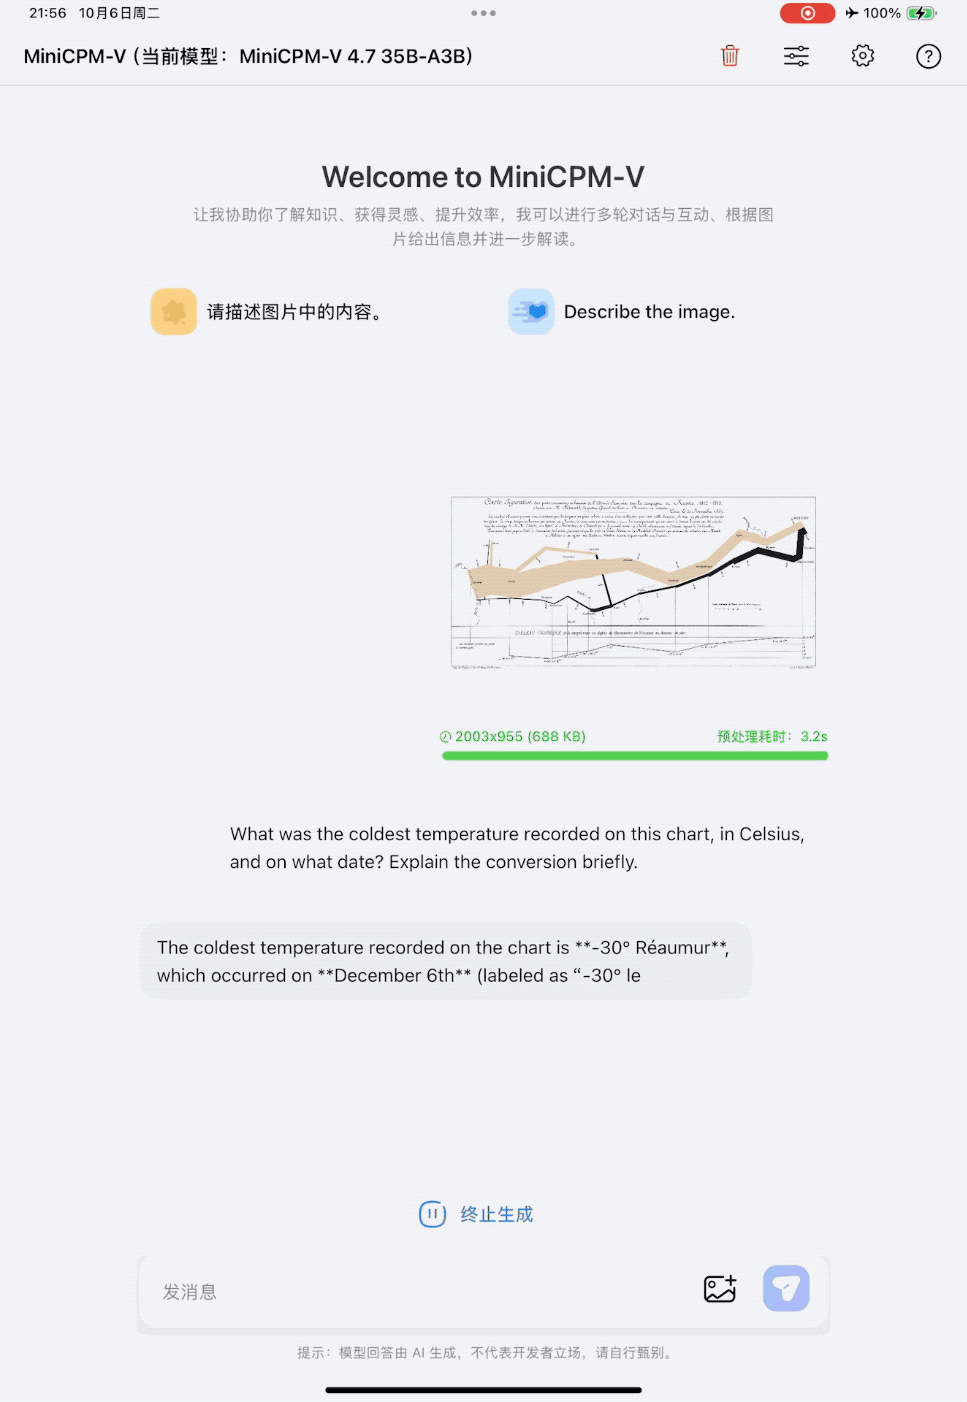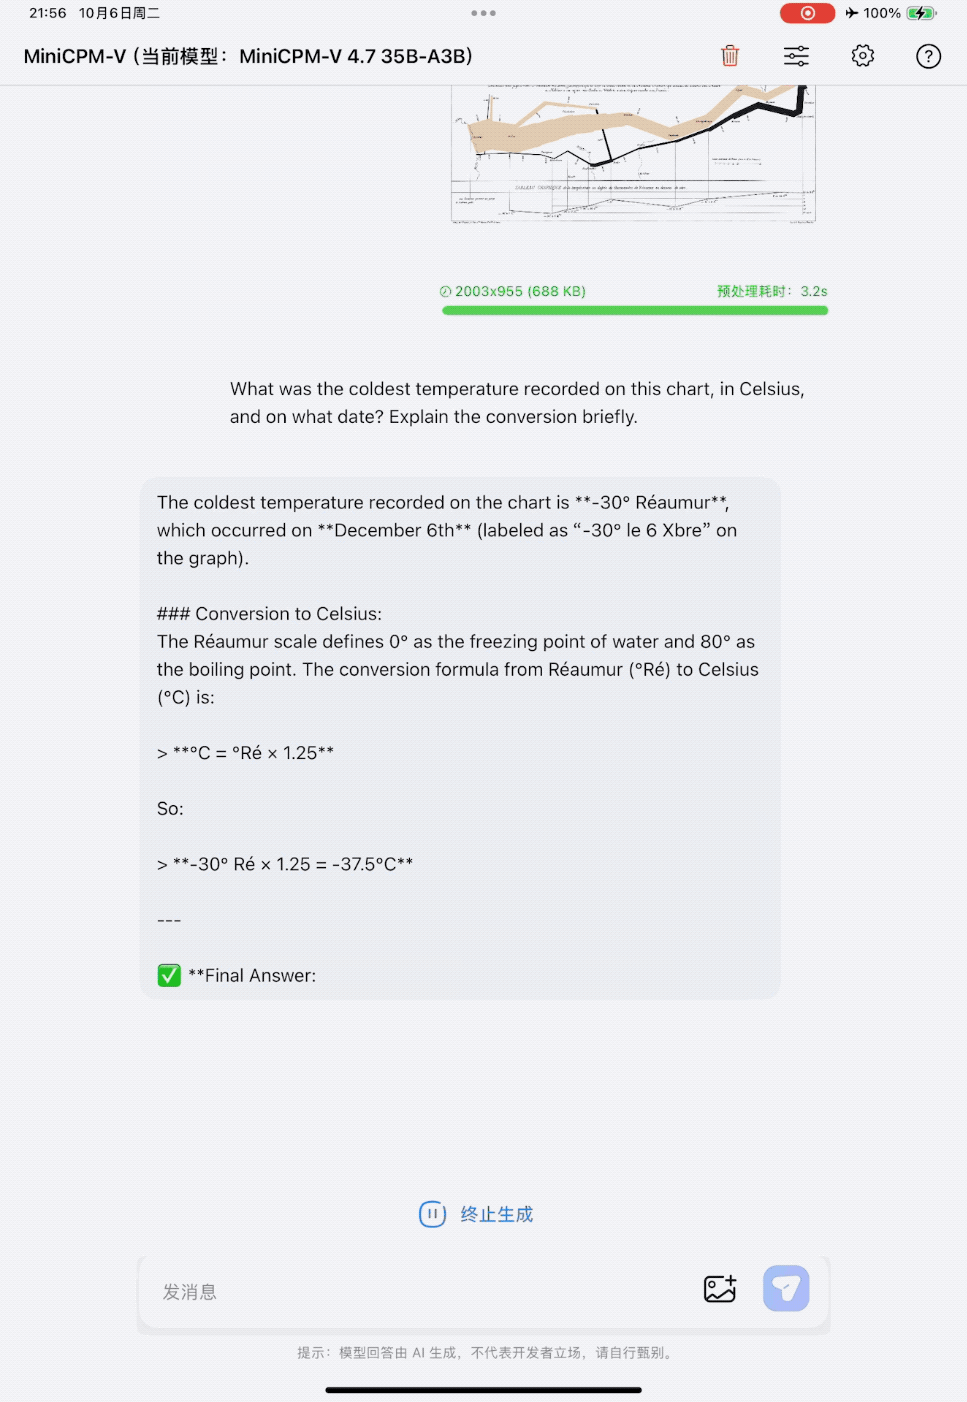
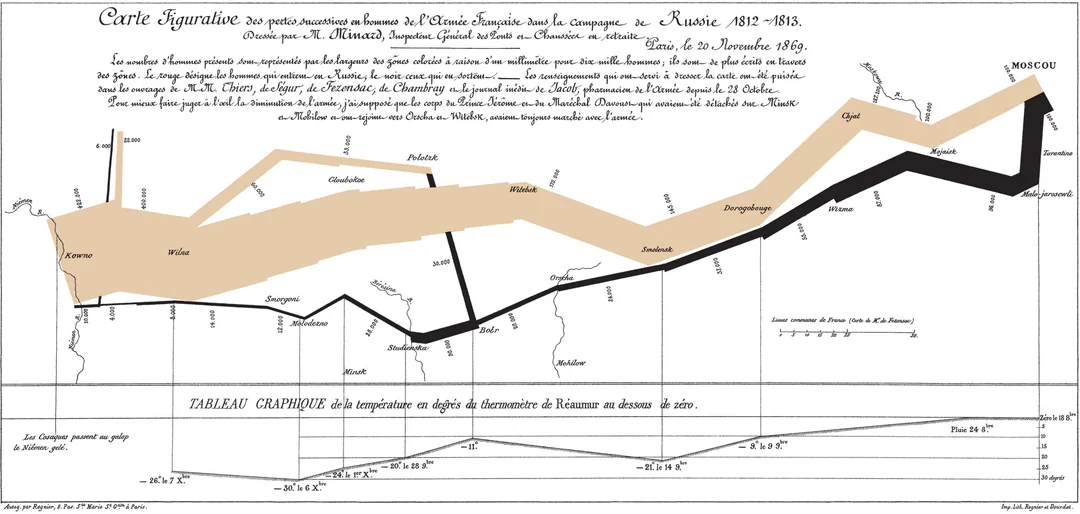
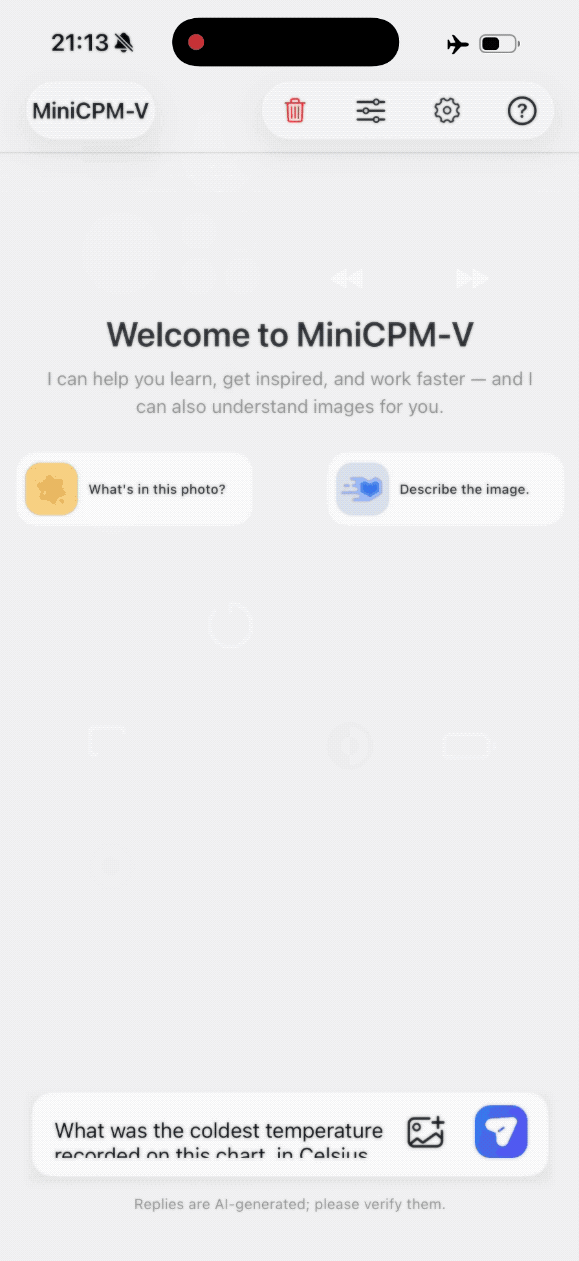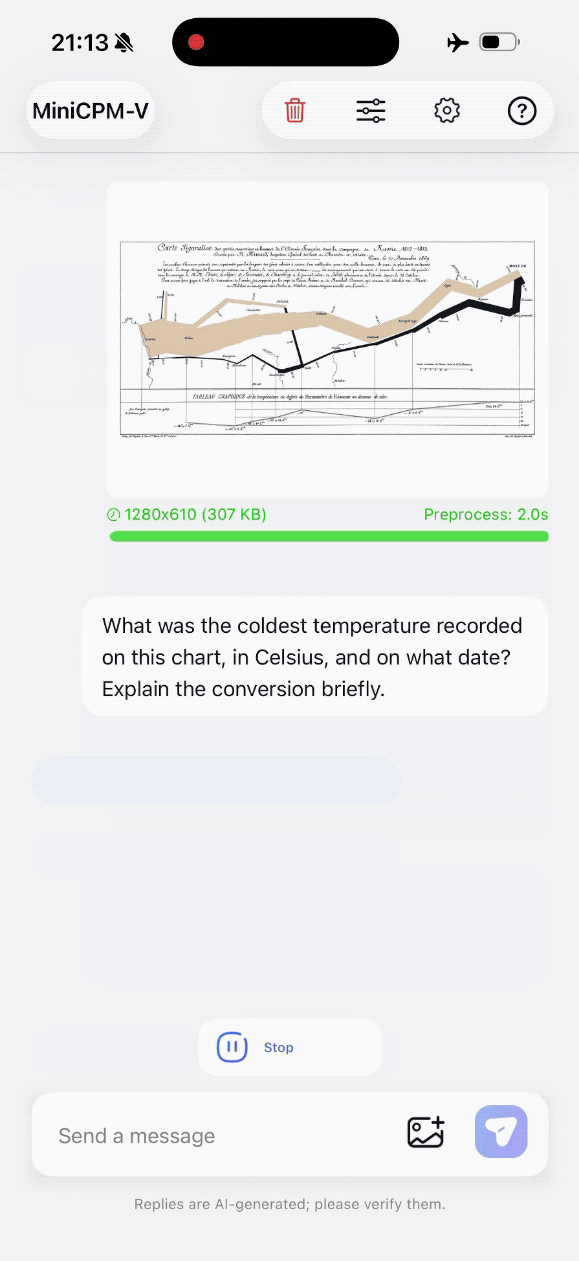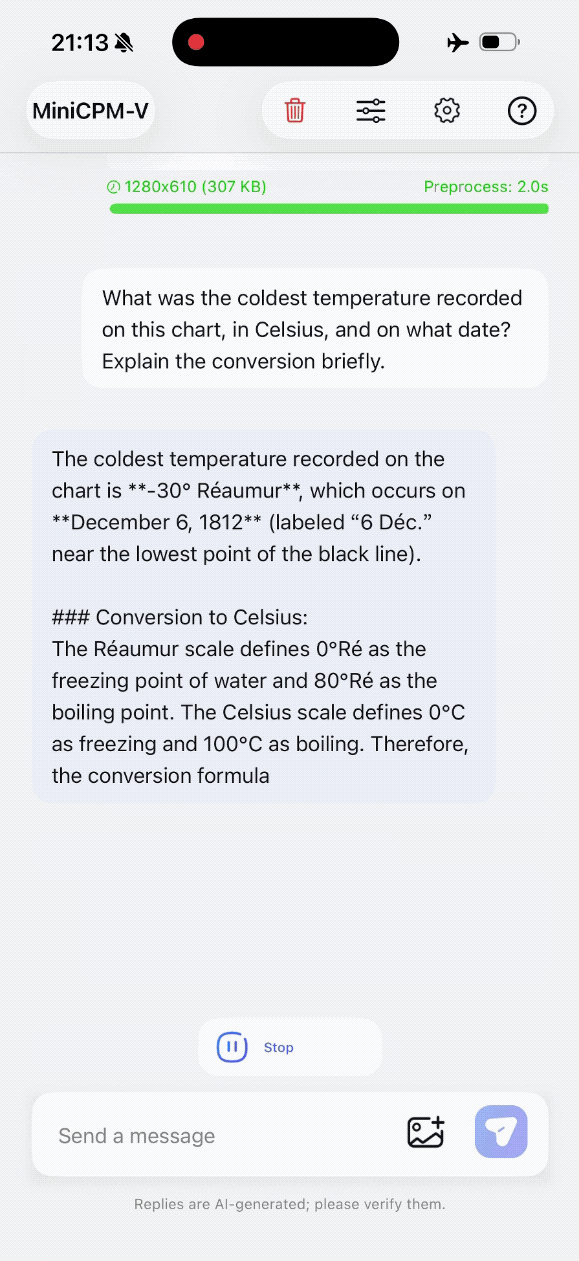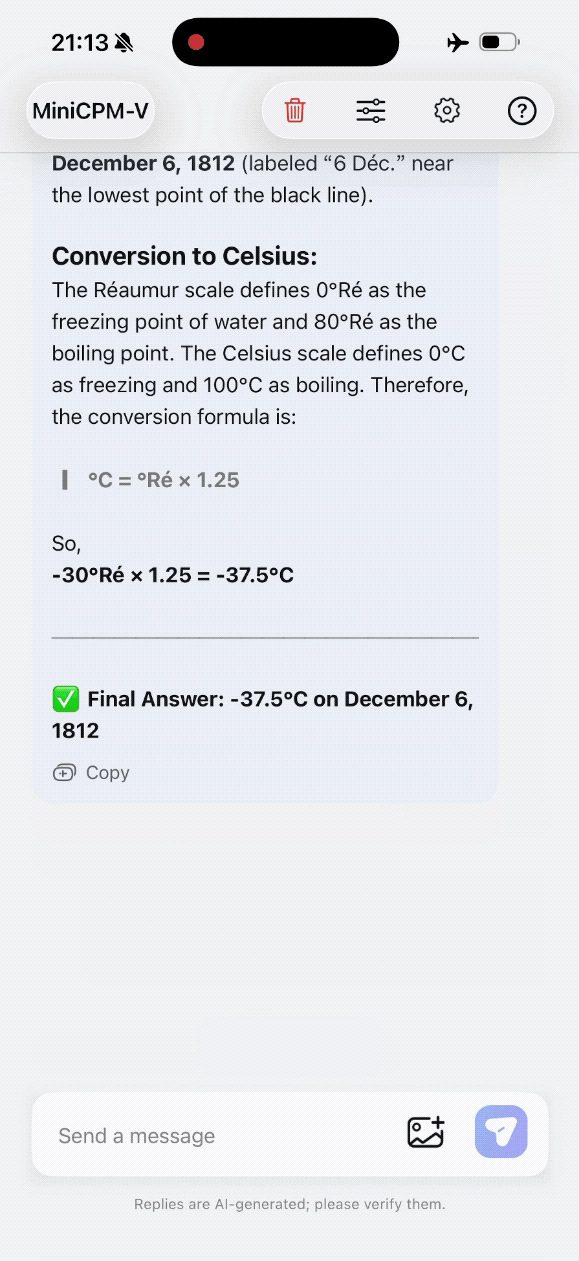
例如刚才我们那个拿破仑远征图的题,在iPad M4上跑了一遍,给出的答案依旧是1812年12月6日、零下37.5摄氏度。
除了端侧之外,我们还用API把MiniCPM-V4.7跑了一遍。
第一道题是记账,我们准备了一张超市小票的样张,上面有6样商品,从纯牛奶、全麦面包一直到抽纸,还有会员优惠和优惠券两笔减免,最后实付78.40元。要求是把它整理成一张中文记账表,再核对一下小票上的账算得对不对。
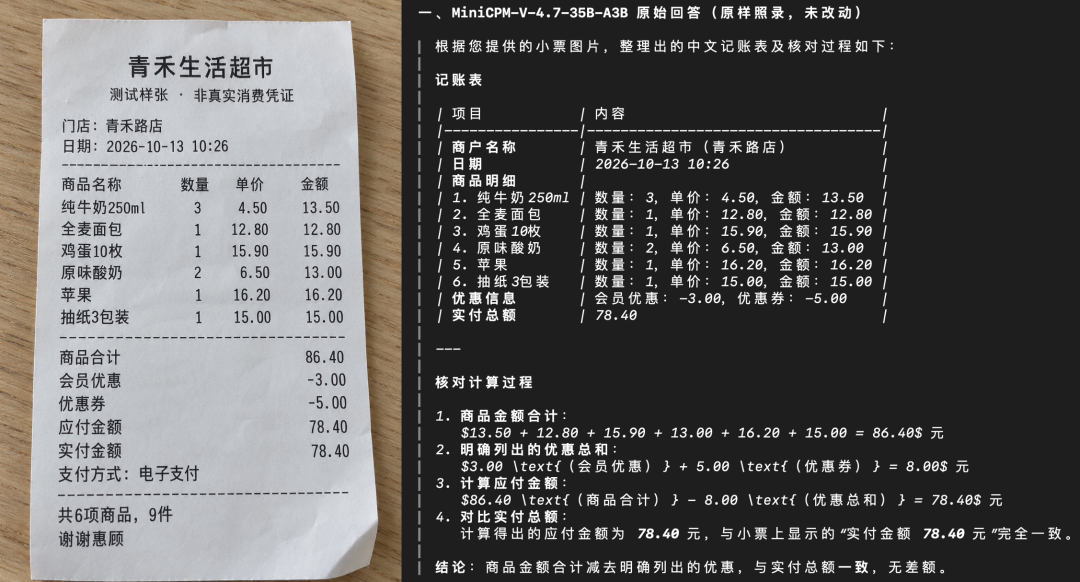
从结果来看,35B-A3B先把门店、日期和6样商品的数量、单价、金额一项项列进表里,跟原图逐个对下来,没有一处读错。
核对的时候,小票上明明印着商品合计86.40元,它还是把6个金额从头加了一遍,得出86.40元,再减去两笔共8元的优惠,算出78.40元,正好和小票上的实付金额对上。
第二道题也和停车有关,不过规则要比我们开头展示的更复杂一些。
我们设定的情况是,周二持居民证,当天还没在这里停过车,计划从14:10停到15:40。然后让它判断五件事,包括这次停多久、会不会撞上清扫禁停、有没有超过限时、要不要交停车费,以及整个计划合不合规。
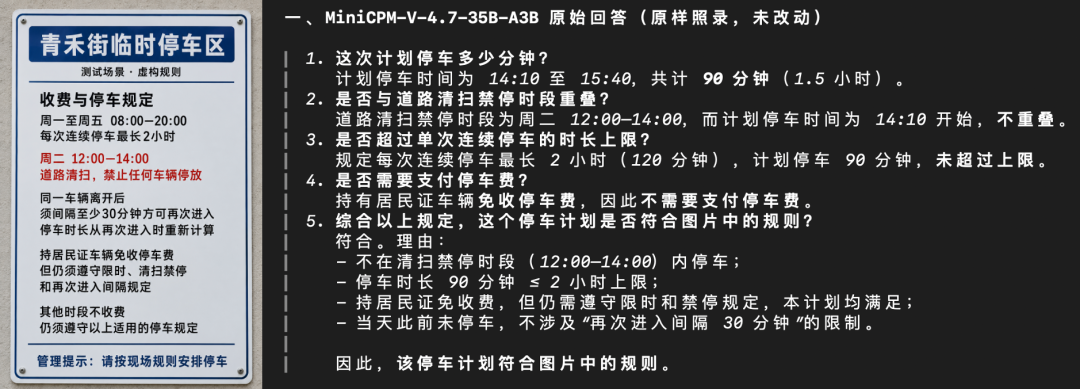
35B-A3B五个问题全部答对。它算出这次一共停90分钟,从14:10开始,正好避开了12点到14点的清扫时段,也没超过2小时的上限;因为持有居民证,停车费可以免掉。
最后的综合判断里,它把每条规则都过了一遍,还注意到当天此前没停过车,所以“再次进入要隔30分钟”这条用不上,结论是这个停车计划符合规定。
3G内存怎么跑动35B的?
看完效果,问题也就来了:
一个35B的模型,凭什么能在12GB内存的手机上跑起来,还跑得不慢?
35B-A3B这个MoE模型,虽然总共有35B参数,但生成每个token时真正参与计算的只有3B左右。不过这里还有个麻烦,那就是每一层该叫哪几位专家,要等上一层算完才知道。
而手机内存又装不下全部专家,大部分只能放在闪存里,用到了再读进来。
过去常见的办法有两种。一种是用到哪个专家就读哪个,大模型倒是能跑,可解码慢到没法实时对话;另一种是给整段对话提前固定一小组专家,读盘次数少了,模型能挑的专家也跟着变少,能力难免打折扣。
MiniCPM-V 4.7想要的是两头都顾上:速度要够快,能力也不能轻易掉。放到实际使用中,还得再考虑一步——开发者拿去定制自己的业务,模型学会了新技能,原来的本领也要尽量留住。
先看怎么跑得更快。
前瞻专家调度(LES)把专家预取、计算调度和权重存取一起做了优化:什么时候搬、先算哪个,以及每次搬多少,都有讲究。
团队利用了一个特点:模型相邻两层的输入特征往往高度相似。因此,当前层还在计算时,就可以把它的路由输入特征送进下一层的路由器,提前预测下一层可能用到哪些专家,再由后台线程把对应权重从闪存读进内存。
等到下一层真正开工,大部分所需专家已经准备好了。团队测试中,这种方法能提前备好超过 80% 的所需专家,而且无需额外训练。
计算顺序也跟着调整:实际路由选中、已经加载到位的专家先算,其余所需专家同步加载。 尽量让计算和读盘同时进行,少一点「等数据到了再干活」。
这里有个关键区别:预测只负责提前搬运和安排计算顺序,最终每个token使用哪些专家,仍由模型原有的路由机制决定。没猜中的专家照常加载、照常计算,不会为了提速省掉。
另一部分优化发生在权重本身。通过逐层混合精度量化,团队在基本保留模型能力的前提下,把专家权重压得更小,减少每次加载的数据量;再把权重重新组织成连续存储的布局,减少零散读取,让闪存更高效地顺序读数。
一个减少要搬的东西,一个让搬运更顺畅,再配合提前加载和并行计算,共同降低端侧的存储与带宽压力。
在16GB内存的iPad Pro M4上,前瞻专家调度方案综合提升了x5倍解码速度 。
此外,团队还为模型训练了配套的DSpark草稿模型,并接入llama.cpp等端侧推理框架。由草稿模型先提出多个token,再交给主模型批量核验,进一步加快生成。在16GB内存的M5 Mac测试中,解码速度平均进一步提升17%。
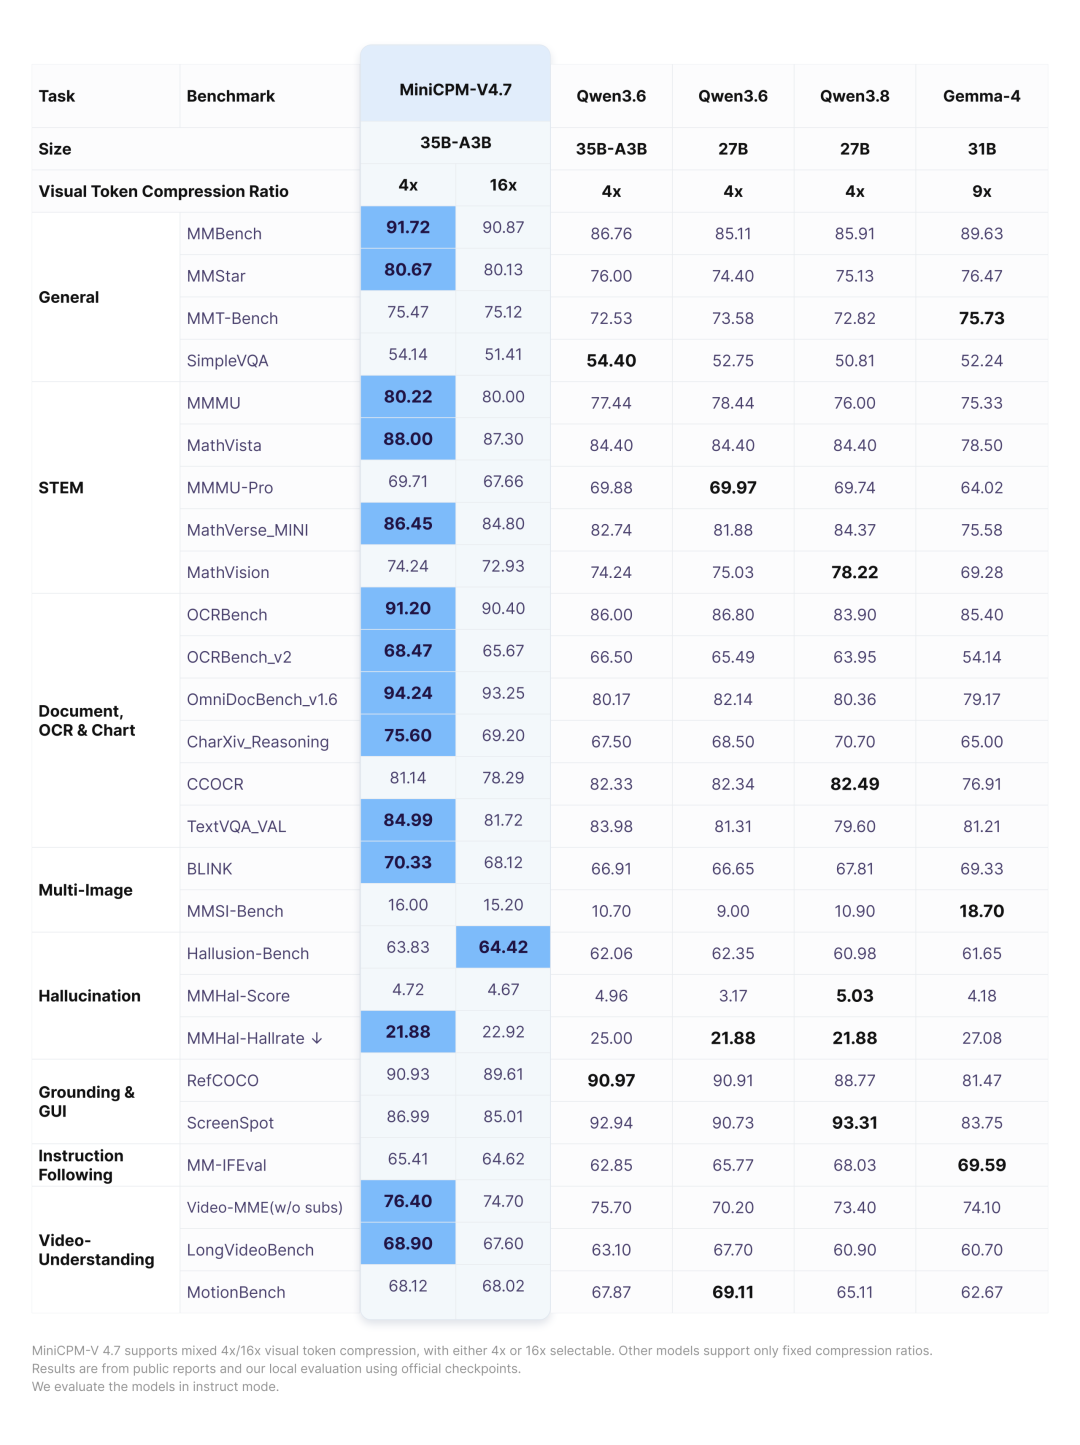
视觉这一侧也在省。MiniCPM-V 4.7沿用了LLaVA-UHD v4的ViT内早期压缩技术,在视觉编码器内部就提前合并视觉token,后面的层要算的东西就少了。开发者还能在4倍和16倍压缩之间切换,前面也提到,开到16倍时分数几乎没掉。
这几项技术叠加起来,就是面壁所说的“快上加快”了。
跑得快之外,还有一个开发者经常碰到的问题:模型针对业务微调后,新任务做得更好了,原来的通用能力却退步了。
面壁为此推出了自回放微调(Self-Replay Fine-Tuning)。做法很直观:在微调前,先让模型回答一批覆盖原有能力的问题,筛选出高质量回答,再把这些回答混进新任务的训练数据。模型一边学习新技能,一边复习自己原来会的东西,减少对已有能力的遗忘。
这些「复习材料」来自模型自身,更贴近它原有的回答方式。整个方法沿用标准微调流程,无需修改模型结构或损失函数。回放数据只需生成一次,就可以在模型学习不同新的能力或者开展多次训练时重复使用。
相比在线强化学习或者On-Policy Distillation等训练方法要求模型每次训练都采样新的数据,自回放微调让定制新能力的成本无限接近普通的监督微调(Supervised Fine-tuning),同时保留模型的通用表现。
当大模型不再挑手机
说完技术,我们再回到手机行业。
2026年,端侧AI正在走向大规模装机。根据IDC预计,今年中国新一代AI手机出货量将达到1.47亿台,同比增长31.6%,渗透率首次突破53%。换句话说,每卖出两台新手机,就有一台带着端侧AI。面壁智能CEO李大海也说过,2026年是端侧AI规模化落地的元年。
不过对手机厂商来说,还有一个很现实的问题,那就是成本。
内存一直在涨价,12GB已经成了AI手机的及格线,旗舰普遍标配16GB,部分机型开始往24GB上探。模型想变强,往往就得吃更多内存,而内存越贵,这条路走起来就越费钱。
所以,用更少的内存跑更大的模型,对厂商来说就很有吸引力。iPhone 17 Pro Max的内存是12GB,而35B-A3B大约3G内存就能流畅运行,剩下的空间还能留给其他应用。
从更长远来看,端侧AI的竞争重点也在变化。过去大家比的是芯片制程和算力,接下来,模型和推理框架能不能跟硬件配合好,会越来越成为拉开差距的地方。
生态方面,MiniCPM-V 4.7支持的平台也比较多。iOS、安卓和鸿蒙都能部署,发布当天就完成了瑞芯微、后摩、Intel、AMD和Arm等芯片平台的适配。推理框架支持SGLang、vLLM、llama.cpp和Ollama,微调可以用SWIFT和LLaMA-Factory,量化版本也给了GGUF、AWQ、GPTQ、FP8等好几种。
这条路线背后,是面壁和清华提出的密度定律。按这个规律,大模型的能力密度大约每3.5个月翻一番,同样的能力,需要的参数会越来越少。截至2026年9月,MiniCPM系列的累计下载量已经突破5000万次。
总而言之,把好用的大模型丝滑揣兜里,现在已经不是难事了。
JOTO 企业落地观察
- MiniCPM-V 4.7 的 MoE 架构与 LES 调度机制,为企业在边缘设备部署高能力多模态模型提供了轻量级工程范式,尤其适用于对网络隔离性、响应实时性有硬性要求的现场作业场景(如电力巡检、工业质检终端)。
- 其自回放微调(Self-Replay Fine-Tuning)方法大幅降低了业务定制门槛,使企业无需重构训练管线即可在保留通用能力前提下注入领域知识,这对构建可演进的企业专属智能体具有直接工程价值。
- 对 iOS/安卓/鸿蒙及 SGLang/vLLM/llama.cpp 的全栈适配,降低了企业跨终端 AI 应用的部署碎片化成本,尤其利于需统一管理移动办公、IoT 设备、车载终端等异构端侧入口的大型组织。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们