相关文章
597 篇高质量内容
企业AI落地难?JOTO如何用工程化智能体交付破解RAG幻觉、Agent不可控与上线延迟三大顽疾
引言:当92%的AI PoC止步于演示厅 Gartner 2024年《AI Adoption in Enterprise》报告指出,企业AI项目平均6.8个月后就停在原地。73%的问题出在同一个地方:PoC做得很漂亮,却没法真正跑起来——不是模型不灵,而是没人把Prompt实验、知识管理、Agent编排、上线监控这些环...
AI上线,全员点赞,然后全员装死:FDE怎么破?
文章以一线落地视角揭示企业AI系统“上线即冷场”的真实困境:员工表面响应积极,实际使用率趋近于零。核心症结在于工具设计脱离业务流——登录繁琐、提示词门槛高、结果不可信、责任边界模糊。通过将AI嵌入具体工单场景、提供确定性按钮、透明化推理依据,逐步实现从“精神部署”到“物理可用”的转变。
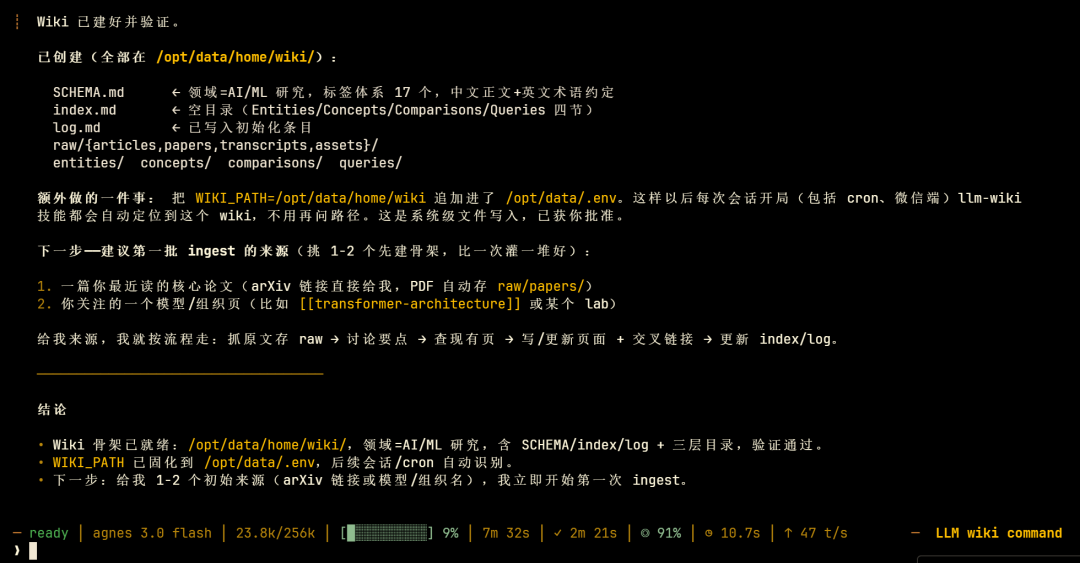
Hermes LLM Wiki知识库
Hermes 内置 LLM Wiki 工具,可将散落的文档自动编译为结构化、可演化的知识网络。它通过语义分析提取概念与实体,增量构建持久 Wiki 库,并与 Obsidian 图谱联动。与传统 RAG 不同,LLM Wiki 具备记忆性、答案完整性与主动进化能力,支持命令行一键初始化及双向同步部署。
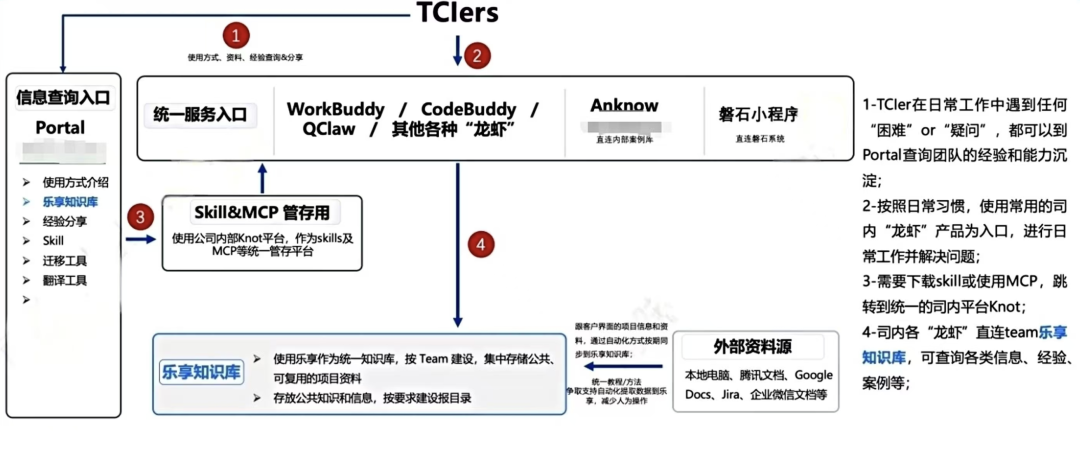
腾讯内部实践:腾讯云国际团队如何共建“AI大脑”
腾讯云国际团队(TCI)以腾讯乐享为知识底座,通过 Portal 和 WorkBuddy 将知识接入日常工作流,围绕知识管理、权限治理、AI技能封装、全员共建四条主线,构建可复用、有边界、能执行、持续生长的组织级“AI大脑”,推动知识从静态存档转变为动态生产力。
腾讯把企业知识库开源了,我第一时间拆了它的架构
腾讯开源企业知识库 WeKnora,支持 PDF、Word、扫描件等十余种格式解析,内置 PaddleOCR-VL 实现扫描件 OCR;采用父子分块策略兼顾检索精度与上下文完整性;提供关键词+向量混合检索、rerank、Graph RAG 等多层检索能力;全栈插拔式设计,支持 29 家大模型、8 种向量库及主流云存储;v0.8.2 起内置 MCP Server,可作为标准化 AI 工具后端服务。
企业AI知识库到底是不是伪需求,试了一大圈后我有了答案
作者通过一次失败的产品分析实践,揭示散乱、未治理的知识源导致AI输出不可靠、难溯源、易幻觉。测试腾讯乐享后发现,其知识治理能力可自动识别版本冲突、标定出处、构建知识关系图谱,并支撑Agent生成可验证、可审计的结论。文章对比通用大模型与协同办公平台AI,指出企业级知识库的核心价值在于将私域知识转化为长期可复用、可审计的资产。
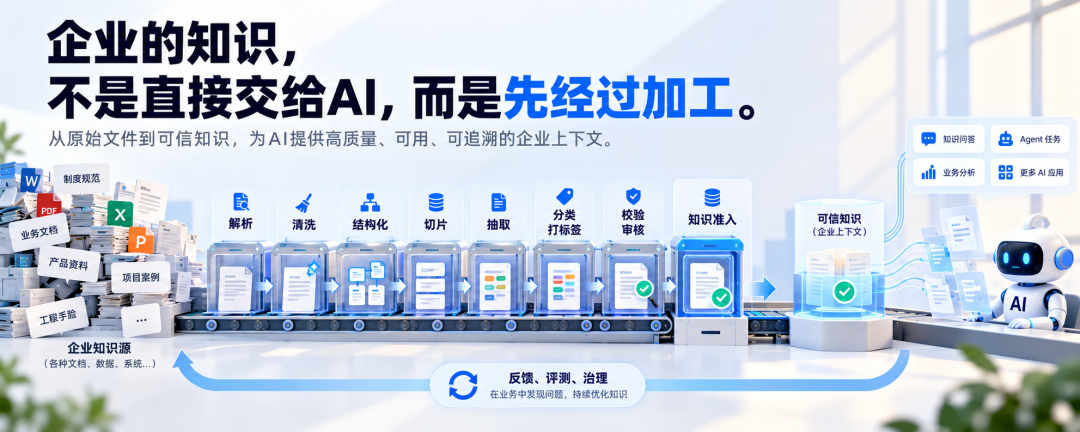
一家大型企业有几十万份文档,究竟应该怎样交给AI?
大型企业几十万份文档该如何交给AI?实战落地经验帮你理清核心问题与正确方向。 核心内容: 1. 大型企业海量文档交付AI的常见认知误区 2. 大型企业几十万份文档管理的真实落地痛点 3. 适配大型企业的AI知识管理建设思路
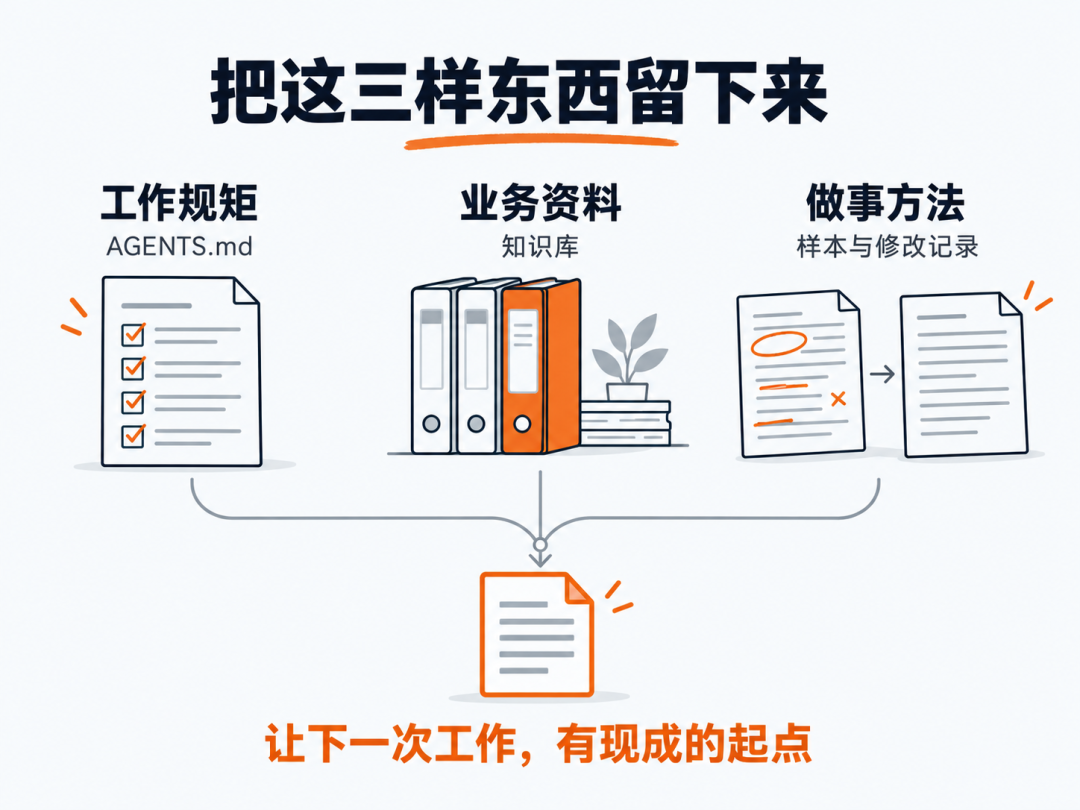
企业开始用 AI,老板先把自己的知识库搭起来
文章主张企业应用 AI 应从老板个人知识库建设起步,聚焦高频重复业务,将散落的沟通记录、操作流程与外部学习资料结构化沉淀为可检索、可更新、可执行的 SOP 和知识条目,并强调知识库需嵌入日常工作闭环,成为 AI 理解业务、辅助决策的真实依据。
所有老板都要构建一套「老板 AI」
本文基于李开复《AI未来已来》第7章,阐释「老板 AI」的核心价值:通过全域感知引擎,直接读取企业中已存在的沉睡数据(会议记录、群聊、代码提交、客服工单等),穿透组织内三重信息失真(有损压缩、信息茧房、主动过滤),为老板提供未经修饰的运营现实。它不替代决策,但能填补老板与真相之间的距离。
企业级RAG落地之难:不在检索,而在整条信息链的可靠性工程
RAG原型易建,但生产级部署需攻克数据质量、分块架构、混合检索、安全前置、时效运维等系统性难题。文章以Ring多地区支持系统为例,指出可靠RAG本质是围绕信息流的端到端工程实践。
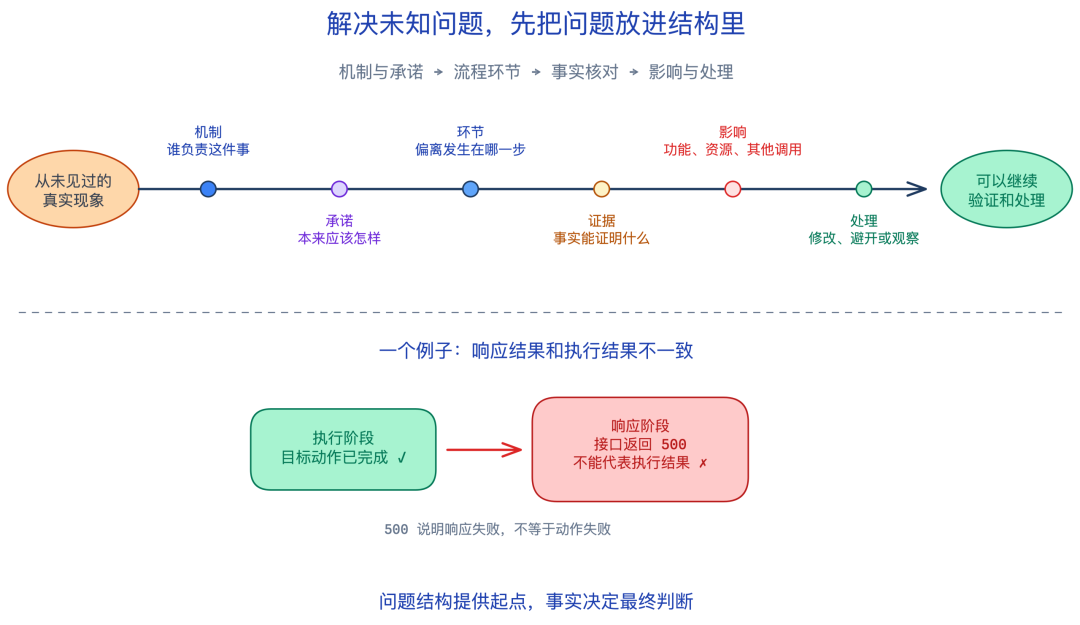
给项目建Agent知识库,一套完整方法来了!
文章提出面向生产故障定位的Agent知识库建设方法论,强调以判断目标驱动资料整理:先定义问题结构(机制-偏离-证据),再沿业务流程梳理正常行为,区分领域知识、项目实现、接口契约等不同更新节奏的内容,并通过入口文档(专家底座)组织知识,确保Agent能基于可验证依据做出判断,而非依赖静态文档或经验猜测。
从聊天到组织记忆:Slack 如何搭建真正的人类与Agent协作团队
本文基于Anthropic与Slack合作的第二篇「人类—Agent团队」系列文章,阐述Slack首席产品官Jaime DeLanghe提出的实践路径:将工作对话转化为组织记忆;通过持续交接而非单次自动化实现人机协同;为Agent定义清晰角色;设计公开默认但私密有意的上下文边界;以可见实例推动 Adoption;并强调应衡量真实工作结果而非Token用量等代理指标。
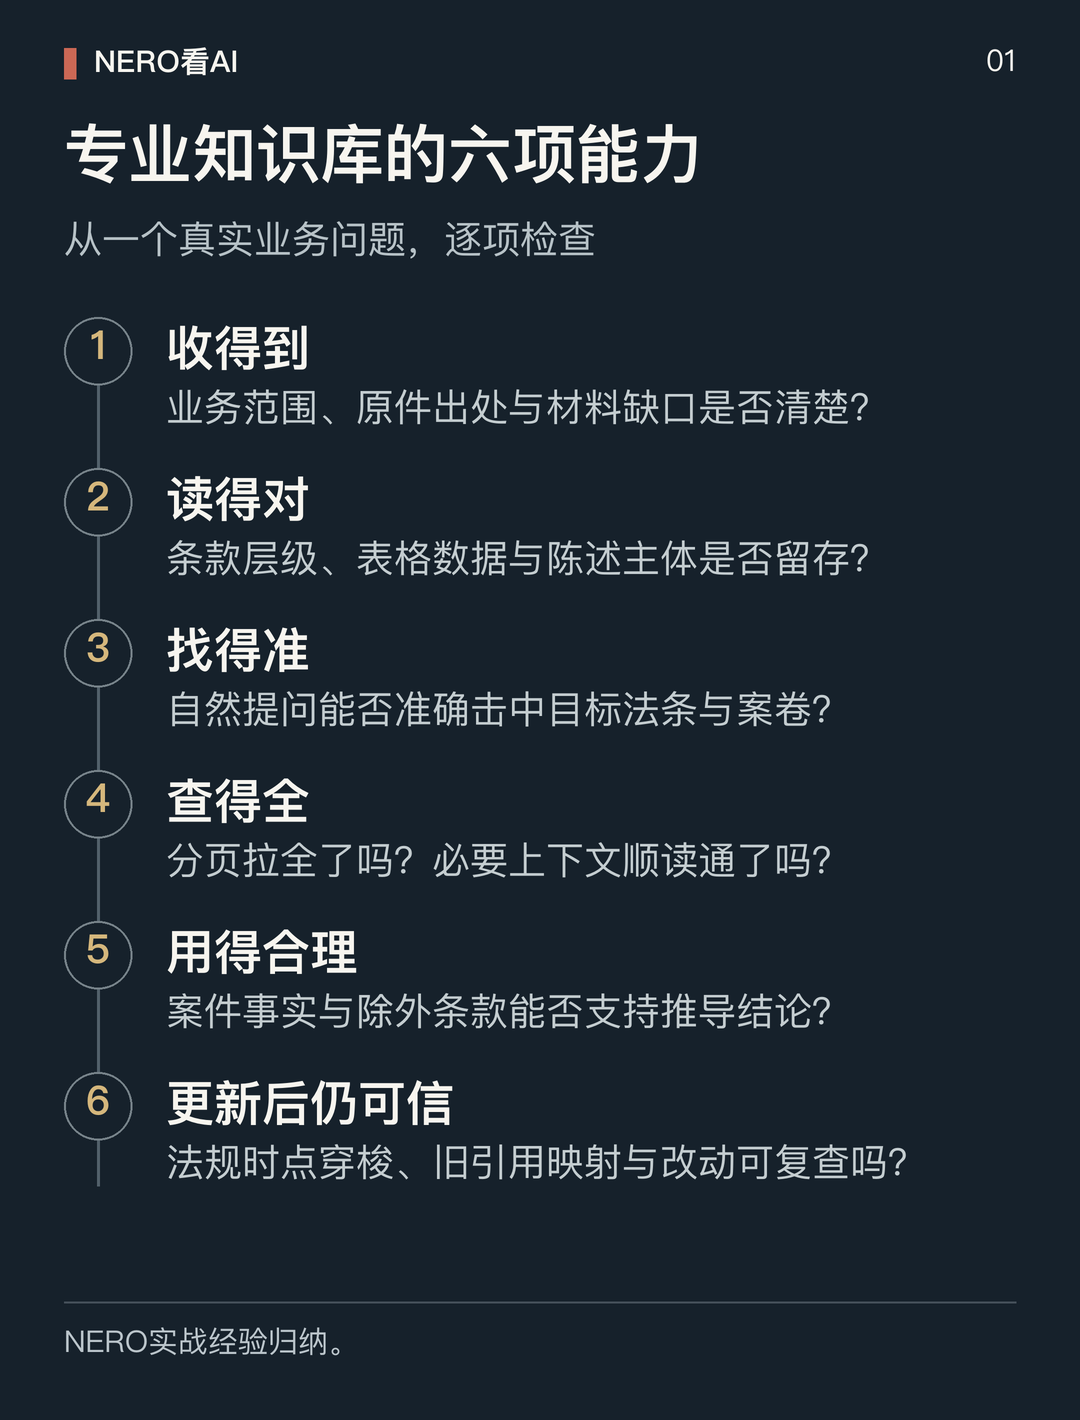
怎么搭建“证据级”AI知识库?50万页材料沉淀出来的6条铁律
文章基于50万页资本市场专业材料的工程实践,提出构建可信AI知识库的六条核心能力,聚焦‘收得到’(台账化资产治理)、‘读得对’(三方证据解耦与无损结构解析)、‘找得准’(多通道检索与语义鸿沟治理)。强调原始材料的身份标识、上下文保留、层级结构完整性及检索目标实体类型区分,指出通用RAG无法替代专业领域知识工程的深度结构化要求。
从会议纪要到 Playbook,中间还差什么?
文章探讨会议纪要生成之后的关键跃迁:如何将碎片化记录转化为可复用的组织经验。作者强调,真正价值不在于纪要本身是否精美,而在于能否将会议内容放回人物、历史、责任与结果构成的上下文中,持续积累可调用的判断与行动依据,并通过重复验证形成 Playbook。

为什么 AI 落地实施越来越像一项咨询工作?
AI项目实施正从确认功能转向共同发现价值,起点常是模糊方向而非明确需求。项目前半程关键在于厘清服务对象、业务问题、AI作用边界及可行性方案。企业级知识库等系统需同步解决知识生命周期、质量与价值三大管理问题,软件功能须深度支撑运营机制,准确性、稳定性与交互友好度仍是基本功。

企业知识库为什么总做成“又一个网盘”?五层架构讲清楚怎么改
本文指出企业知识库常沦为静态网盘的根本原因:未完成知识加工、检索增强与业务系统实时连接三重跃迁。文章以五层架构为框架,详解数据源、知识加工、存储检索、智能体应用与入口层的分工,并强调权限需随智能体动态控制,落地应从高价值样板间起步,而非全量上传。
AI可见性鸿沟:为何优质品牌正从AI答案中消失
当AI引擎直接生成答案,传统SEO指标失效。品牌不再需要‘排名第一’,而需成为AI合成答案的可信组成部分——这要求结构化知识、术语一致、权威验证与原创洞察。
为什么销冠的经验传不下去?哈佛653人实验戳破90%管理者的误区
哈佛商学院与呼叫中心合作开展653人对照实验,发现知识流动障碍90%出在“寻求端”而非“提供端”:34%普通员工因社交、协调、搜索三重成本不敢提问。结构化配对交流使RPC提升24%,效果可持续20周;而金钱激励仅带来13%短期增长且无法持续。研究证实,降低提问门槛比激励分享更能激活组织隐性知识。
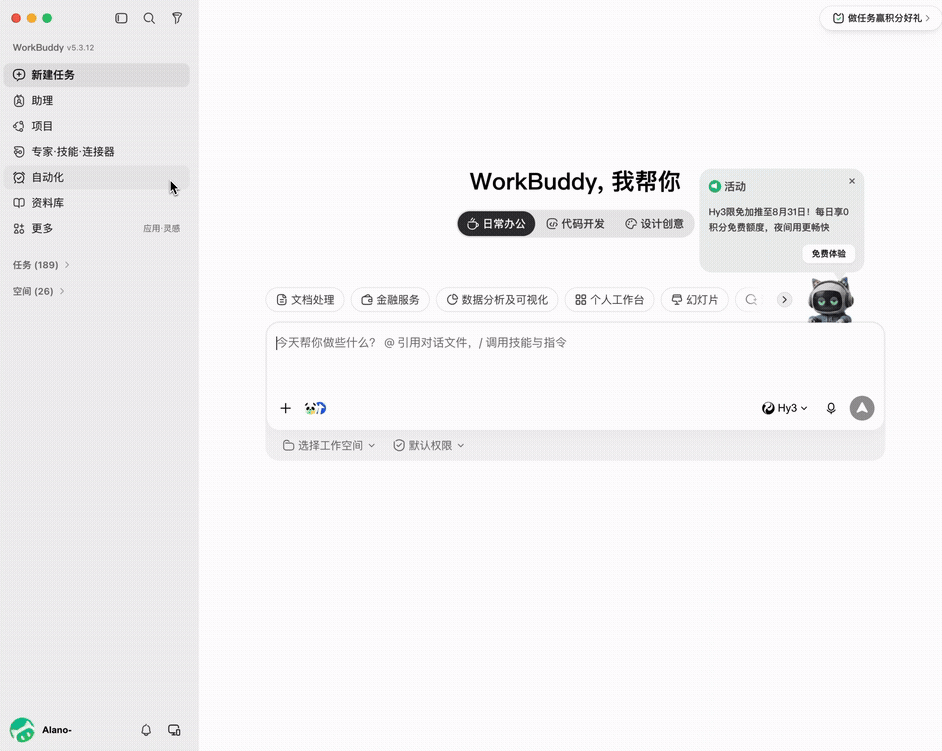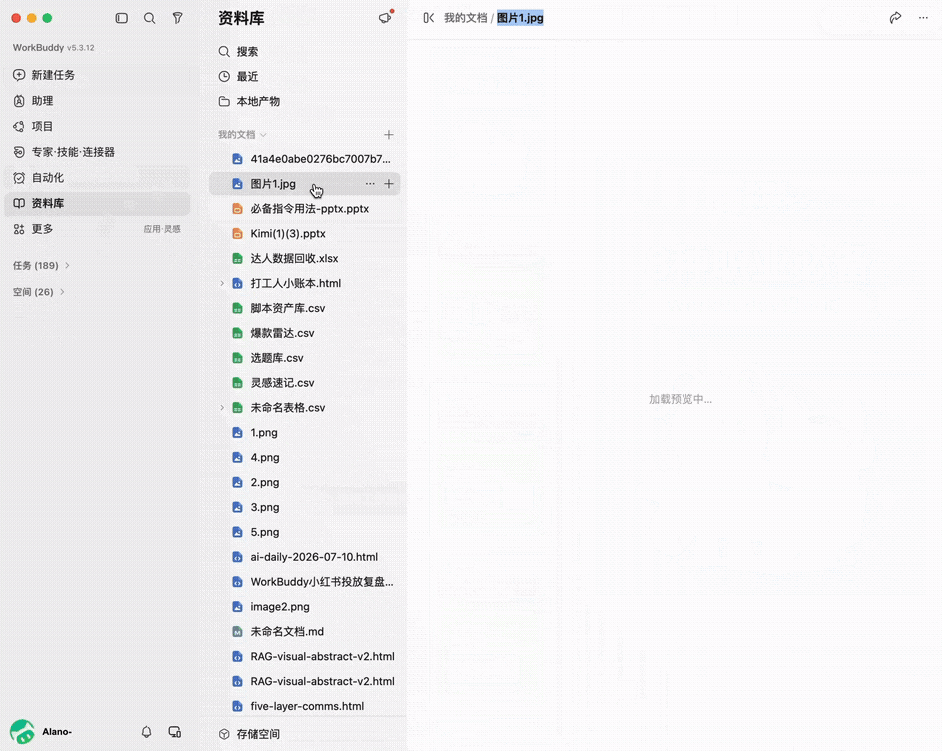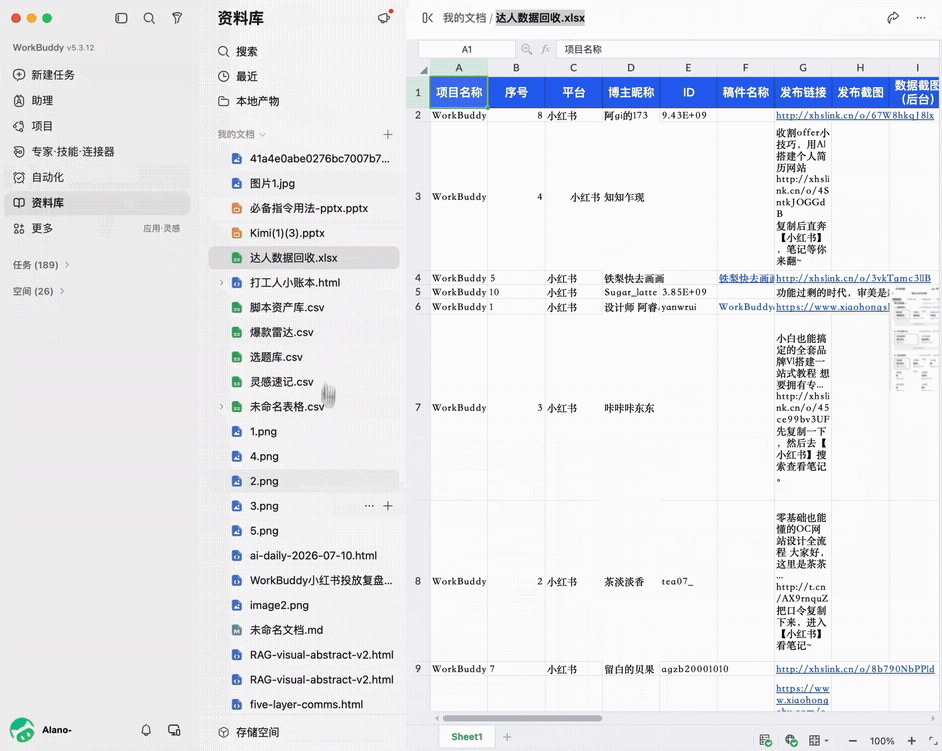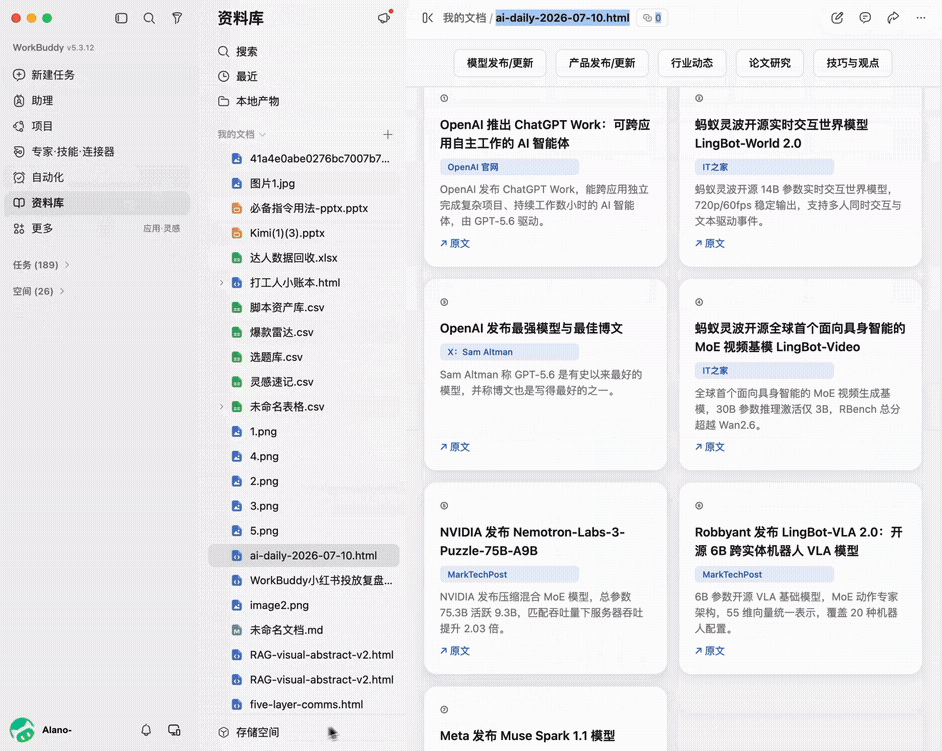
WorkBuddy 重磅升级:内置 AI 原生资料库,让你的资料 “活” 起来
WorkBuddy 5.3.11 版本升级资料库为 AI 原生知识管理空间,支持 HTML、Markdown 等格式的人机双写、多人多 AI 协同编辑,并可一键发布为带数据双向同步能力的轻应用网页。所有工作产物均可统一存放、实时协作、在线分享。
企业AI智能体的可靠性取决于背后最混乱的文档
当前企业AI过度依赖应用级上下文工程,导致知识不一致、变更难同步、流水线重复建设。文章提出分层企业知识平台(原始→精炼→整合→服务),将知识作为共享基础设施统一治理,支撑可靠、可演进、可治理的AI智能体规模化落地。