Google DeepMind 多模态 Agent 评测体系技术拆解
Google DeepMind 提出四维多模态 Agent 评测体系,强调高保真交互环境、空间对齐的几何化评估、长程规划的轨迹归因与系统级状态验证。该体系摒弃静态截图打分,转而通过硬断言检查数据库、文件系统等底层状态变化,并引入动态扰动、失败三层归因和任务树对齐等机制,直面真实落地中感知偏差、错误累积与环境不可控等工程瓶颈。
导读
静态数据集跑分再高的多模态 Agent,一到真实环境落地,依然频频"降智"、乱点、死循环——这是行业长期面临的工程困境。传统评测停留在"单轮问答、看图打分"的静态阶段,而 Google DeepMind 与 Google Research 联合建立了一套高保真、强交互、带系统级状态验证的评测体系。本文拆解这套四维评测体系的设计思想与工程细节。
📖 本篇目录
- 四维方法论总览
- 空间感知与视觉对齐(Grounding)
- 长程多步规划(Long-horizon Planning)
- 环境即代码(Environment as Code)
- Durable Reward 持久奖励机制
- VEF 视觉证据保真度
- 具身涌现能力与跨模态工具调用(RT-2)
- 三层错误归因诊断(Failure Attribution)
- 动态对抗性扰动测试(Perturbation Testing)
- 结语
01 四维方法论总览
Google DeepMind 把多模态 Agent 的评测解耦为四个相互支撑的维度:考什么(能力)、在哪考(环境)、怎么判(断言)、怎么复核(审计)。
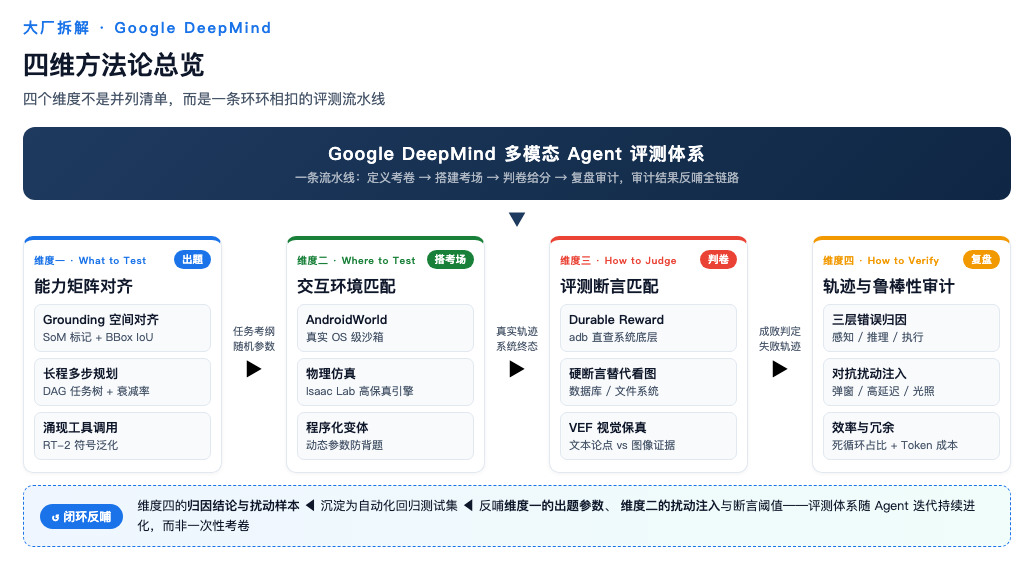
维度一:能力矩阵对齐(What to Test)
——不只测 Agent"知不知道",更测它"能不能做成",拆成三大核心场景能力:
- 空间感知与视觉对齐(Grounding):用 Set-of-Mark 视觉标记与密集边界框匹配,严格计算预测坐标与真值的重合度(IoU);
- 长程多步规划(Long-horizon Planning):考核任务树拆解能力,以及 10~30 步长链条下的错误累积衰减率;
- 具身涌现与跨模态工具调用(Emergent Tool-Use):在机器人与 VLA 场景中评估符号泛化——比如没有锤子时,能不能识别出石头可以当临时锤子。
维度二:交互环境匹配(Where to Test)
——"环境即代码":测试环境必须是真实操作系统或物理仿真、完全可重置、动态防背题。代表作是 AndroidWorld 的 Durable Reward 机制:不看截图像不像,直接通过 adb 查数据库或文件系统有没有发生真实改变。
维度三:评测断言匹配(How to Judge)
——Google 技术壁垒最高的一环:彻底抛弃"大模型看图盲目打分",改用系统级硬断言(后文 VEF 一章详述)。
维度四:轨迹与鲁棒性审计(How to Verify)
——不仅回答"做没做成功",更要回答"为什么失败、过程高不高效":失败轨迹自动归因到感知/推理/执行三层;评测中途还会注入弹窗、高延迟、光照突变等扰动,考察 Agent 能否触发自我反思并恢复。
下面进入每个维度的 deep dive。
02 空间感知与视觉对齐(Grounding)
空间感知与视觉对齐(Visual Grounding)是连接高层语义理解与底层物理/数字动作的"第一桥梁"。如果点击坐标从 [450, 320] 算成了 [450, 380],规划逻辑再完美,执行时也会直接"脱靶"。
1. 评估核心:空间对齐的底层数学映射
Visual Grounding 的本质,是评估多模态大模型能否将自然语言指令 L 与图像帧 I 建立双向映射,并精准输出空间表达——2D 像素坐标、2D 边界框或 3D 位姿。
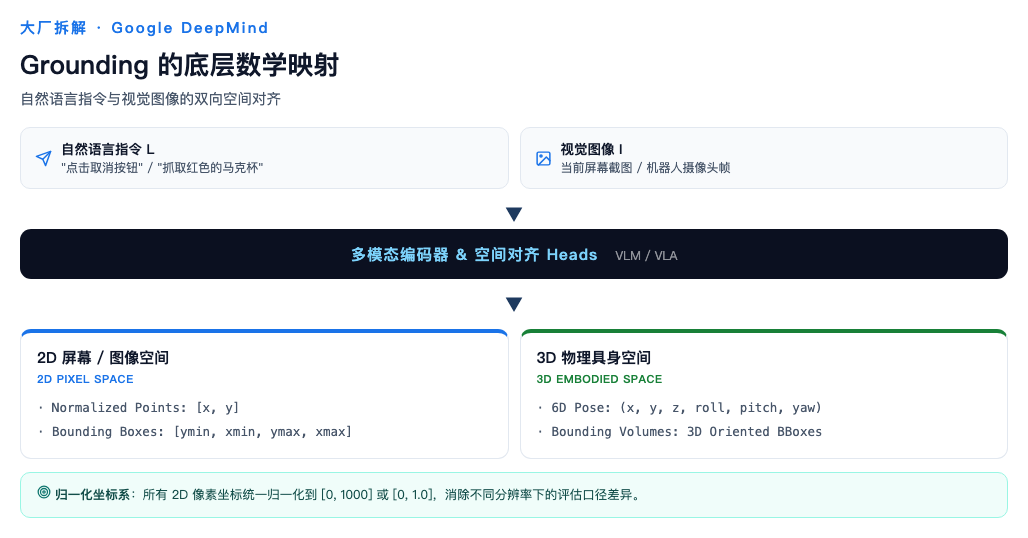
为了统一不同分辨率下的评估标准,Google 采用归一化空间坐标系:所有 2D 坐标归一化到 [0, 1000] 或 [0, 1.0]。
- 预测值:B̂ = [ŷ_min, x̂_min, ŷ_max, x̂_max]
- 真实标注(Ground Truth):B* = [y*_min, x*_min, y*_max, x*_max]
2. Google 落地技术一:Set-of-Mark(SoM)视觉标记评估法
在 AndroidWorld 及移动端 UI 评测中,直接预测绝对像素坐标的离散误差极高。Google 深度集成了 SoM 提示工程与对齐评估法:在图像送入 VLM 之前,先用轻量检测模型(SAM / Florence-2 / UI-Detector)在每个可交互控件上叠加带唯一数字标识的视觉掩码。
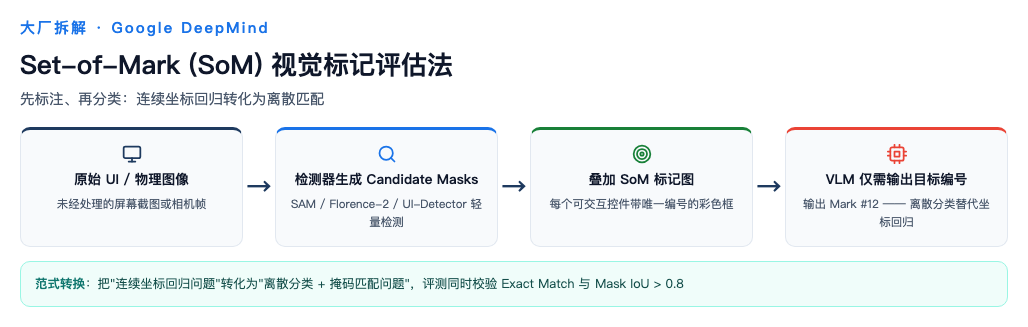
这把难度极高的"连续坐标回归问题"转化成了"离散分类与掩码匹配问题":
import numpy as np

def evaluate_som_grounding(predicted_mark_id: int, target_mark_id: int,
                           marks_registry: dict) -> dict:
    """ Google SoM 视觉标记对齐评估算法 """
    # 1. 离散编号硬匹配 (Exact Match)
    is_exact_match = (predicted_mark_id == target_mark_id)
    # 2. 像素级掩码重合度 (IoU) 计算,防止误打误撞选中相邻控件
    pred_mask = marks_registry[predicted_mark_id]["mask"]
    target_mask = marks_registry[target_mark_id]["mask"]
    intersection = np.logical_and(pred_mask, target_mask).sum()
    union = np.logical_or(pred_mask, target_mask).sum()
    iou = intersection / union if union != 0 else 0.0
    return {
        "exact_match": is_exact_match,
        "mask_iou": float(iou),
        "passed": is_exact_match and (iou > 0.8)
    }
3. Google 落地技术二:密集边界框与 IoU/GIoU 评估算法
当评测不依赖事先标记好的 UI 元素(开放世界定位物体)时,Google 采用交并比(IoU)及其变体 GIoU 做连续空间拟合度评估:
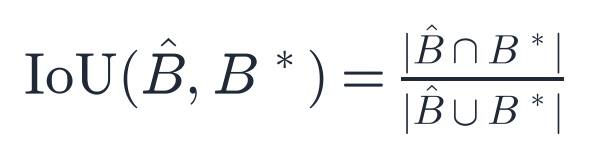
普通 IoU 有梯度消失问题:预测框与真实框完全不重叠时 IoU 恒为 0,系统无法区分"偏了一点点"和"偏了十万八千里"。因此 Google 引入 GIoU 作为连续度量:
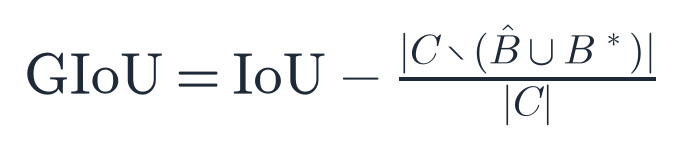
其中 C 是能同时包裹预测框与真实框的最小外接凸包。工程上以 IoU ≥ 0.5(更严格场景用 GIoU 阈值)判定该次定位是否通过,同时用平均 GIoU 度量整体定位质量——偏得越离谱,扣分越狠。
4. 从 2D 到 3D:具身 Grounding 评估(RT-2 / VLA)
当空间感知从屏幕延伸到物理机器人(RT-2、G1 人形机器人),Grounding 评估升级为 6D Pose(3D 坐标 + 3D 旋转角)。Google 具身智能团队采用 ADD(Average Distance of 3D Points)衡量抓取位姿是否达标:
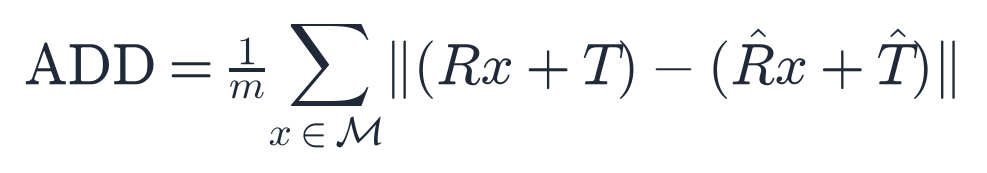
- M:物体的 3D 网格模型点集(m 个点);
- (R, T):真值的旋转矩阵与平移向量;(R̂, T̂):Agent 预测的末端位姿。
硬性判定标准:只有 ADD < 0.1·d(误差小于物体 3D 边界直径的 10%)且平移误差在 ±1cm 以内,该次 Grounding 才记为 Pass。
5. 小结
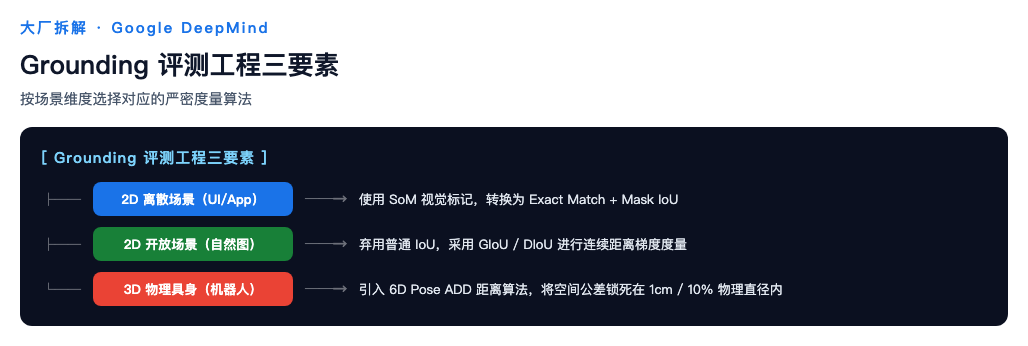
拒绝模糊的看图打分、全量采用几何与数理严密计算——这构成了 Google 多模态 Agent 在空间交互控制上的坚实底座。
03 长程多步规划(Long-horizon Planning)
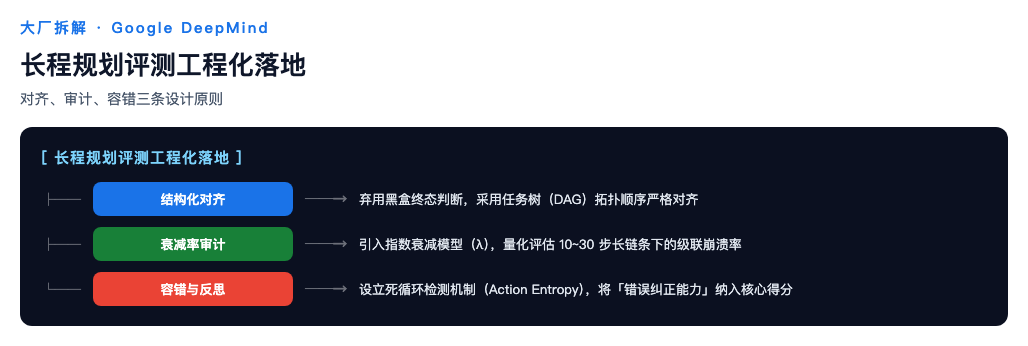
如果说 Grounding 考的是 Agent 的"视力",长程规划考的就是"战略思维与抗打击能力":面对 10~30 步的长交互链条(跨应用订机票、收拾厨房),Agent 极易错误累积、死循环、目标漂移。
1. 评估核心:长程规划的数学本质
长程任务的环境状态空间随步数呈指数级膨胀,Google 将其抽象为马尔可夫决策过程(MDP)的轨迹验证问题。设目标为 G,期望的最优子目标序列为:
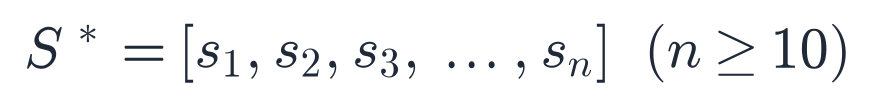
Agent 实际执行的轨迹为:
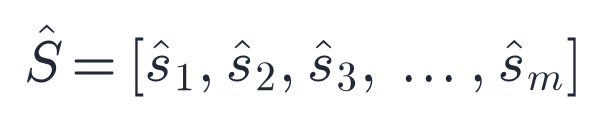
评测的核心痛点在于:即使最终结果蒙对了,中间路径可能早已崩塌;或者一步微小的感知错误,引发后续所有步骤级联崩溃。
2. 落地技术一:基于 DAG 的任务树对齐评估
Google 摒弃"终态二值判定",引入子目标有向无环图(Sub-goal DAG)匹配算法:
- 标杆定义(Golden Task Tree):为每个长程任务预定义带依赖关系的 DAG。例如"购买机票" = [登录账号] → [搜索航班] → [选座 & 勾选保险(并行)] → [支付];
- 轨迹映射:实时监控 Agent 的 Trace 日志,通过大模型裁判或确定性状态机,把实际动作映射到 DAG 节点上。
量化指标是子目标序列对齐度(Sub-goal Sequence Alignment):把实际轨迹逐步映射到 DAG 节点上做拓扑序比对,统计拓扑正确率与子目标覆盖率——拓扑正确率 ≥ 0.8 才判规划通过,一旦顺序错乱,后续链条整体失效。
3. 落地技术二:错误累积衰减率的数学建模
Google 发现,长链条任务中 Agent 的成功率不是线性下降,而是指数级衰减。设每步决策正确的概率为 p,n 步任务的端到端成功率为:
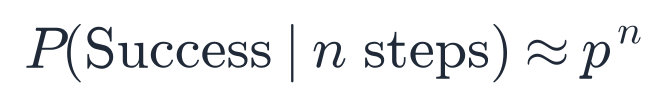
单步准确率高达 0.9 的 Agent,在 20 步任务中:
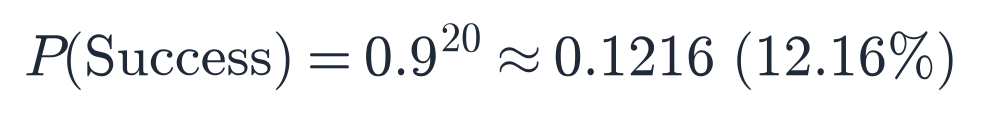
不做长程反思与纠错,单步 90% 的准确率会在 20 步后暴跌到 12%。为了量化不同架构的抗衰退能力,Google 在评测流水线中拟合衰减系数 λ:
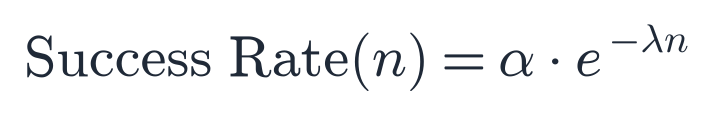
λ 越小,说明长程记忆、上下文保持与错误纠正能力越强;λ 越大,说明模型存在严重的"越走越偏、一步错步步错"级联幻觉。
4. 错误隔离、死循环检测与反思机制
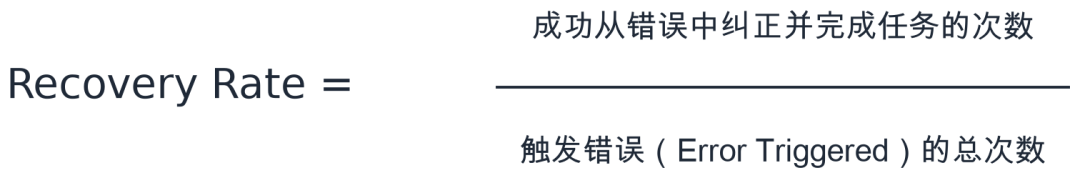
Google 尤其看重 Agent 犯错后的自愈能力:优秀的长程 Agent 允许在第 5 步出错,但必须能在第 6 步通过反思(Reflexion)纠正回来。
认知死锁与循环检测:长链条中最常见的灾难是无限死循环——反复点击同一个无效按钮、在两个页面之间无限横跳。评测后端实时计算动作三元组熵(Action Trigram Entropy):连续 3 步以上动作签名完全相同,直接判定"长程认知死锁",强制终止并扣除规划分。
恢复步数比(Recovery Step Ratio):
5. 小结
只有这套严密的网状评测,才能揪出那些"单轮对话聪明、一到长任务就智障"的虚假 Agent。
04 环境即代码(Environment as Code)
Agent 的每一步操作都会真实改变外部环境——修改手机数据库、移动机械臂、改写文件。如果测试环境不具备确定性、可隔离、可重置,评测结果就是一场"玄学"。Google 把"环境即代码(EaC)"奉为底层工程原则,将评测环境打造成具备三大硬核特征的基础设施。
1. 为什么"静态数据集"救不了 Agent
MMLU 时代的评测是"静态问答对",而多模态 Agent 是交互式实体:输出是动态动作,环境是状态机——第 5 步的操作直接决定第 6 步的屏幕呈现。如果环境不够真实、无法快速重置或存在数据污染,Agent 就会靠"背测试集"或钻模拟器漏洞过关,一到真实世界彻底崩溃。
2. 特征一:真实操作系统与物理仿真
Google 极力反对简陋的"玩具沙箱",环境底座分两大阵营:
- 数字端:AndroidWorld 真实沙箱。 拒绝 MiniWoB++ 这类轻量网页模拟器,直接运行在真实 Android 实例(真机或高保真 AVD)上;测试框架通过 ADB、UIAutomator 与 Intent 注入实现系统级状态的无损观测,而不是靠图形识别去猜。
- 物理端:高保真物理孪生。 具身评测依赖 GPU 加速的物理引擎(如 NVIDIA Isaac Lab / MuJoCo),光影、摩擦系数、重力、关节回差均经过严格的 Sim-to-Real 参数校准,确保仿真中验证的策略能平稳迁移到实体机器人。
3. 特征二:状态级完全可重置
无论 Agent 在上一个用例里把系统搞得多么混乱(甚至删库、死机),环境都要能毫秒级恢复到初始状态。每个评测任务被封装为标准 Python 对象,强制实现三个生命周期钩子:
class BaseEvaluationTask:
    """Google 风格的评测任务生命周期基类"""
    def set_up(self, env) -> dict:
        """ 1. 初始化阶段:将系统重置到指定初始状态
            - 恢复数据库快照
            - 清理多余文件
            - 注入指定的初始业务数据
        """
        raise NotImplementedError

    def execute(self, agent, env):
        """2. 执行阶段:Agent 开始与环境交互"""
        raise NotImplementedError

    def tear_down(self, env):
        """ 3. 清理回滚阶段:擦除所有测试残留,恢复绝对干净状态 """
        raise NotImplementedError
状态隔离与快照回滚:数字端靠 Docker 容器隔离、Android 虚拟机快照或 SQLite 事务回滚,做到用例之间零状态污染;物理端靠重置刚体位姿、清空接触力缓存,瞬间复位机械臂与物体。
4. 特征三:动态参数化防背题
为了防止厂商把测试集硬编码进训练集,Google 引入动态参数化任务生成器:任务模板固定,但初始状态与实体参数程序化随机生成。
import random

class DynamicEmailTaskGenerator:
    """动态参数化任务生成器:从根本上杜绝"背题" """
    FIRST_NAMES = ["Alice", "Bob", "Charlie", "David", "Elena"]
    DOMAINS = ["gmail.com", "work-mail.net", "tech-corp.io"]
    MESSAGES = [
        "Project deadline moved to Friday.",
        "Please review the attached PR.",
        "Meeting room changed to B3."
    ]

    def generate_random_instance(self) -> dict:
        """每次评测随机生成一组完全不同的测试参数"""
        target_name = random.choice(self.FIRST_NAMES)
        target_email = f"{target_name.lower()}@{random.choice(self.DOMAINS)}"
        message_body = random.choice(self.MESSAGES)
        return {
            "prompt": f"给 {target_name} 发送一封邮件,内容是:{message_body}",
            "expected_state": {
                "recipient": target_email,
                "body": message_body
            }
        }
当收件人、邮箱、甚至 App 界面主题色都在随机变化时,死记硬背的捷径全部失效,Agent 必须具备真正的泛化理解与动态视觉 Grounding 能力。
5. 总结
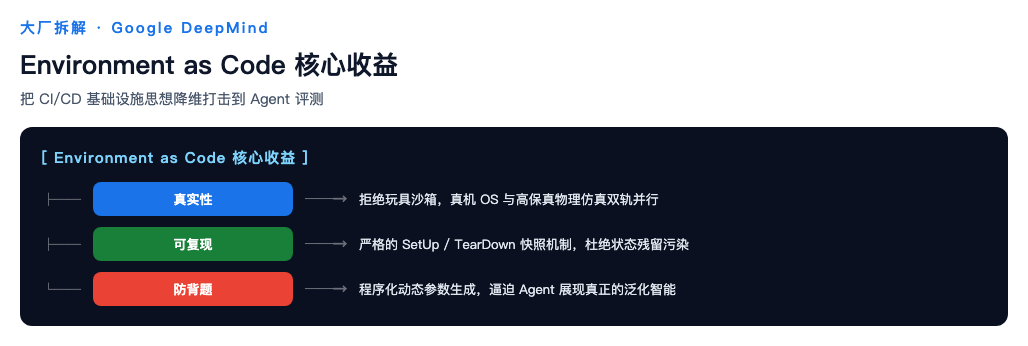
"环境即代码"本质上是把软件工程成熟的 CI/CD 与基础设施自动化思想,降维打击到 AI Agent 评测领域——这套基础设施,才是保证 Agent 快速迭代中不发生"灾难性遗忘"和"智商倒退"的最强护城河。
05 Durable Reward 持久奖励机制
传统交互评测最大的痛点是"表象与真相脱节":Agent 看起来点了按钮、页面也跳转了,但由于网络抖动、线程未同步或渲染伪影,任务可能根本没写进系统。AndroidWorld 的 Durable Reward(持久奖励机制)正是为解决这一痛点而生。
1. 为什么"视觉/截图奖励"会失效
早期判断任务成功有两种常用方式:截图比对(比对结束帧与标准答案的像素相似度)和 VLM 看图打分(让 GPT-4V/Gemini 看最后一张截图判断成败)。它们在工业级任务中漏洞百出:
- 视觉欺骗:UI 显示"保存成功",但后台数据库事务可能因网络超时已回滚;
- 状态隐蔽性:很多任务的结果根本不在屏幕上——"清理后台缓存""修改加密配置文件"没有任何视觉变化,但系统底层发生了巨变。
2. 核心原理:基于系统状态的"绝对硬断言"
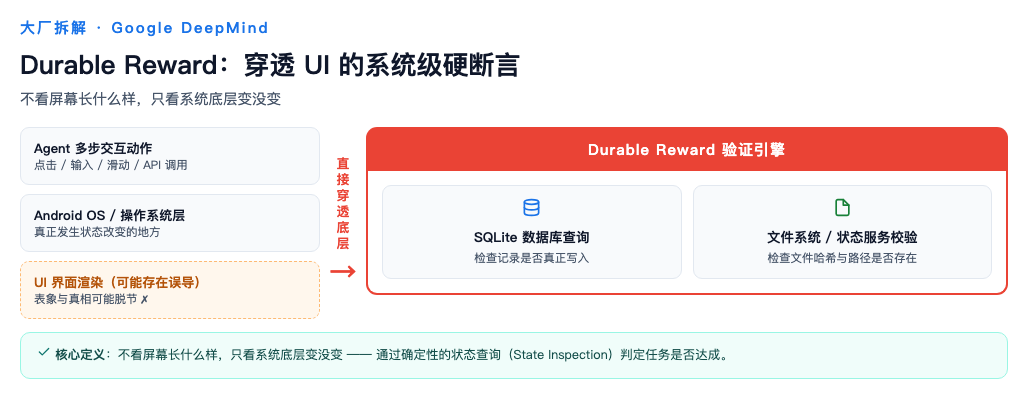
Durable Reward 彻底抛弃表象层的视觉判断,核心定义一句话:
不看屏幕长什么样,只看系统底层变没变。
它直接穿透 UI 渲染层,深入操作系统底层(SQLite 数据库、文件系统、系统服务状态、API 响应日志),用确定性的状态查询判定任务是否达成。
3. 工程落地:AndroidWorld 中的实现
每个评测任务绑定一个专属的 durable_reward 验证函数。以"下载并解压指定文件"为例——传统做法看它有没有点下载按钮,Google 的 Durable Reward 直接通过 ADB 深入文件系统做硬校验:
import os
import hashlib

class DownloadAndExtractDurableEvaluator:
    """ Google 风格的 Durable Reward 评估器:不看屏幕,直查底层文件状态 """
    def __init__(self, adb_client, target_file_name: str, expected_hash: str):
        self.adb = adb_client
        self.target_file_name = target_file_name
        self.expected_hash = expected_hash
        self.device_download_path = f"/sdcard/Download/{target_file_name}"

    def evaluate_durable_state(self) -> float:
        """ 执行持久状态检查 """
        # 1. 检查文件是否存在于底层文件系统
        check_file_cmd = f"ls {self.device_download_path}"
        result = self.adb.shell(check_file_cmd)
        if "No such file or directory" in result:
            # 文件根本没下载下来,直接判 0 分,绝不给"态度分"
            return 0.0
        # 2. 拉取文件计算哈希,验证文件内容的完整性与真实性
        # (防止 Agent 下载了一个残缺或同名的错误文件)
        local_temp_path = "/tmp/audit_target_file"
        self.adb.pull(self.device_download_path, local_temp_path)
        actual_hash = self.calculate_sha256(local_temp_path)
        if actual_hash == self.expected_hash:
            return 1.0  # 状态完全吻合,持久奖励满分!
        return 0.5      # 文件下了,但内容不对(部分分)

    @staticmethod
    def calculate_sha256(file_path: str) -> str:
        sha256_hash = hashlib.sha256()
        with open(file_path, "rb") as f:
            for byte_block in iter(lambda: f.read(4096), b""):
                sha256_hash.update(byte_block)
        return sha256_hash.hexdigest()
再如"新增联系人"任务,则直接查询 Android 通讯录 ContentProvider 底层数据库,校验目标姓名与手机号是否真实落库——命中即满分,未命中即零分,没有任何"看起来像"的灰色地带。
4. Durable Reward 的三大工程特征
- 抗 UI 改版干扰:App 把按钮从蓝色改成红色、换了位置,基于截图的测试会全面崩溃;而它检查的是底层数据库和文件——UI 怎么变,底层状态逻辑不变,评测脚本永远有效。
- 零容忍的客观性:判定是对就是对、错就是错,把"大模型裁判看走眼"的主观偏见降到零。
- 闭环反哺:判定结果是绝对二值或精准百分比,结构化失败轨迹可无缝流入自动化数据飞轮,直接转化为高权重的离线回归测试集。
5. 对企业级 Agent 开发的启示
- 为每个任务编写对应的"系统状态探针(State Probes)",告别截图判定的舒适区;
- 测试沙箱必须打通底层 API/数据库白盒权限,拥有读取数据库、Logcat、文件树的"上帝视角";
- 坚持结果导向:宁可评测脚本写得复杂一点去查 SQLite,也绝不依赖脆弱的视觉比对。
06VEF 视觉证据保真度
当多模态 Agent 输出长篇分析报告时,最大的痛点是"文图两张皮"——文字写得天花乱坠,引用的图表数据、趋势却张冠李戴,甚至纯属捏造。VEF(Visual Evidence Fidelity,视觉证据保真度)就是一道防幻觉硬闸门:用数学定义与多级交叉验证,强制锁死文本论点与视觉证据的对齐关系。
1. 评估核心:什么是视觉证据保真度
传统多模态评估只看 VQA 单点正确率,VEF 评估的是"长篇合成内容中的全局图文一致性与引用纪律",解决三个问题:
- 数据准确性:报告写"2025 年 Q3 利润增长 45%",图表像素里到底是不是 45%?
- 多模态幻觉:Agent 是否捏造了图表中根本不存在的趋势?
- 证据支撑度:文本段落是忠实转述视觉证据,还是过度发散?
2. 技术架构与工作流
在 Google 的多模态评测流水线(结合 TRACE 引用对齐与 MOSAIC 完整性校验)中,VEF 作为独立硬门槛模块运行:
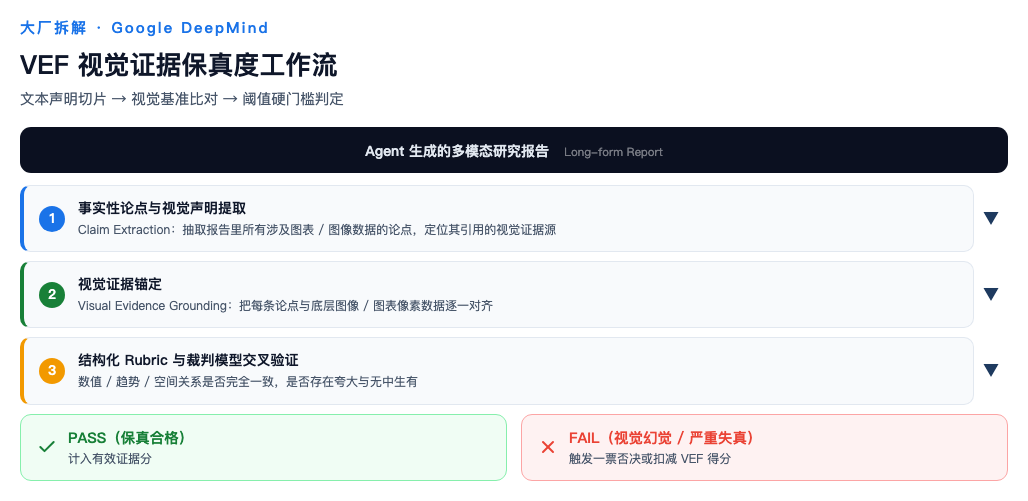
VEF 视觉证据保真度工作流:声明提取 → 证据锚定 → 交叉验证
3. 底层算法与判定逻辑
VEF 的核心计算不依赖模糊的语义相似度,而是"文本声明切片 → 结构化视觉基准比对 → 阈值硬门槛判定"三段流水线:先从报告中提取所有引用图表的事实性论点并锚定到对应的视觉证据源,再逐条与底层像素或结构化数值比对输出保真度分,最后取全篇平均——低于 0.85 直接判 FAIL,一票否决,绝不搞平均主义。
4. VEF 在综合评分中的决定性权重
在 MMDR-Bench 综合评分中,VEF 不是参考项,而是直接决定总分排名的核心支柱:
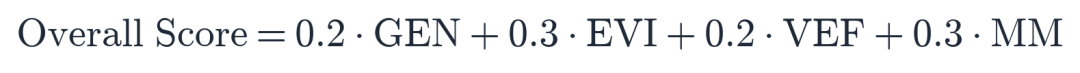
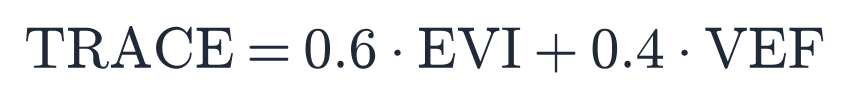
内部引用信用判定系数与检索引用对齐指标(TRACE)深度融合:
写作能力再好(GEN 得分高),一旦 VEF 没过关——频繁图文不符、视觉幻觉——整体评估就会断崖式扣分。
5. 工程启示
- 抛弃"只看文本输出"的懒惰评测:必须建立"文本声明 ↔ 图像原始数据/结构化 Ground Truth"的双向交叉验证链;
- 设置防幻觉硬阈值:对涉及关键数据、图表解读的环节设一票否决,严禁"看起来像真的"的幻觉内容流入生产;
- 强化引用意识:逼迫 Agent 生成每句涉及客观数据的结论时,显式挂载对应的视觉证据区块,可溯源、可审计。
07具身涌现能力与跨模态工具调用(RT-2)
传统机器人只能完成"特定场景抓取特定物体"的硬编码任务。Google 的核心突破在于:通过将机器人动作编码为 Token,并与大规模互联网图文数据联合训练(Co-fine-tuning),让机器人继承 VLM 的常识推理能力——面对陌生环境或缺标准工具时,展现出"临时替代与跨模态工具调用"的涌现能力。
1. 评估核心:什么是具身涌现与符号泛化
给机器人下指令"把钉子敲进去",桌上没有锤子,只有石头、木棍和苹果——传统 Agent 直接报错。Google 的评测把涌现能力分为三个层级:
- 符号理解:把抽象语言符号("我太困了""地上有个易燃物")与视觉空间中的具体实体正确对齐;
- 物理属性推理:理解硬度、重量、形状——"石头是硬的、重的"与"锤子"的功能属性在语义空间中高度相似;
- 跨模态工具调用:缺乏标准工具时,自主选择场景中的替代品完成任务。
2. 技术实现:为什么大模型能"无师自通"
动作即词元(Actions as Tokens):把机械臂的连续控制指令(六维位姿 Δx, Δy, Δz, roll, pitch, yaw 与夹爪开合度)离散化量化,当成普通"语言 Token"输入大模型:
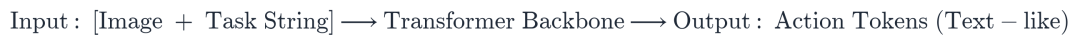
联合微调的知识迁移:互联网图文数据赋予常识与世界知识,机器人演示数据教授物理控制。两者在参数层面碰撞后,模型不仅学会"怎么抓",还学会"为什么要抓"和"可以用什么代替抓"。
3. 如何量化评估"涌现工具调用"
Google 采用闭环基准测试(Emergent Evaluation Suite):
涌现能力闭环基准测试:常规匹配与涌现工具调用双路径
零样本泛化测试:测试集引入训练数据中从未出现的物体组合,统计零样本替代工具选择准确率——比如 100 次"需要重物压住纸张"的场景(无镇纸),模型是拿水瓶、字典还是砖头,语义合理性与执行成功率各多少。
思维链多阶段推理评估:升级版评测强制 Agent 在输出动作前先输出推理链:
Instruction: "把桌子上的钉子敲进去。"
(注:工作台上没有锤子,只有一块石头和一个香蕉)

Agent CoT (Reasoning): "当前任务需要锤击工具。桌面上没有标准锤子。
香蕉质地软,不能用于敲击。石头质地坚硬且有重量,可以用作临时锤子。
因此,我应该选择拿起石头。"

Action Output: 执行抓取石头并移动到钉子上方敲击的动作 Token。
评测系统用大模型裁判对 CoT 的逻辑严密性与底层动作的一致性联合打分。
4. 行业启示
- 摆脱特定数据依赖:传统具身开发要为新工具采集上万条真机示范;依托涌现能力,只要大模型具备互联网常识,机器人就能零样本"举一反三"。
- 把常识推理纳入安全红线:涌现能力是双刃剑——会"拿石头当锤子",也可能产生"拿剪刀当螺丝刀"的危险幻觉。Google 同步强化了具身安全边界校验,确保涌现能力在护栏之内释放。
08三层错误归因诊断(Failure Attribution)
一条评测轨迹失败时,只抛出一个全局 Fail 了事,研发团队就无法针对性优化。Google 的自动化归因引擎会解析 Trace 日志,把故障根源精准切分为三个正交层级:感知、推理、执行。
1. 三层归因流
| 错误归因层级 | 诊断方法与指标 | 典型 Failure 样例 |
|---|---|---|
| 感知层 (Perception) | Visual Grounding Accuracy 对比识别的 Bounding Box 与 Ground Truth | 视觉编码器没有识别出屏幕角落里的微小关闭按钮。 |
| 推理层 (Reasoning) | Action Sub-goal Sequence Matching 评估高层 Task Tree 拆解逻辑 | 视觉识别对了,但逻辑错了(如未解锁屏幕就直接点击应用)。 |
| 执行层 (Execution) | Action Schema & Parameter Validation 校验 API 参数/坐标触控越界情况 | 决策正确,但传给 click(x, y) 的坐标偏离了可点击区域。 |
2. 感知层:视觉编码器没看清
定义:VLM 或 UI 检测器未能正确解析环境状态,输入到"大脑"的信息本身就是失真的。典型表现:Grounding 偏移("确认"按钮的预测框严重偏离)、小目标漏检(边缘微小图标、遮挡弹窗)、视觉幻觉(把灰掉的不可点按钮看成可点)。
量化判定:Visual Grounding Accuracy / IoU——注意力热力图或预测坐标与真实 UI 元素边界的重合度低于阈值,直接标记为感知层故障。
3. 推理层:感知对了,但想错了
定义:环境状态获取正确,但高层任务规划或逻辑链出现偏差。典型表现:目标漂移(让找最便宜的机票,被漂亮 UI 吸引点了一张最贵的头等舱)、子任务死锁(页面加载慢时不懂得等待,陷入反复切换的死循环)、常识错误(感知到"请输入密码",却填了明文用户名)。
量化判定:Action Sub-goal Sequence Matching——感知输入正确但下一步动作偏离黄金任务树,归因于推理层故障。
4. 执行层:想对了,但下手走样
定义:感知与规划都完美,但在决策转化为动作或 API 调用的底层环节崩塌。典型表现:参数不合法(click(x, y) 坐标越界 OutOfBounds)、动作类型错配(想滑动列表,底层被解析成高频连点)、异步时序冲突(指令下发时页面恰好刷新,点在错误的新元素上)。
量化判定:Action Schema & Parameter Validation Rate——底层驱动抛出参数异常、越界异常或响应超时,一律归因于执行层故障。
5. 为什么三层归因至关重要
没有归因时,团队看到失败只会盲目"换更大更贵的基础模型";有了归因,资源可以精准投放:
- 感知错误占大头 → 不必微调大模型,优化前置的视觉检测小模型(更好的 SAM 或 SoM 标记);
- 推理错误占大头 → 优化 Prompt 中的思维链或增强任务树引导;
- 执行错误占大头 → 加固工程代码层的参数校验、自动重试和坐标映射容错。
09动态对抗性扰动测试(Perturbation Testing)
静态跑分考高分,只是"理想实验室"里的成绩。对抗性扰动测试是直接把 Agent 扔进狂风暴雨的现实世界:评测进行到中途,系统向环境、网络或视觉输入注入突发干扰,逼迫 Agent 暴露脆性,并考察它能否触发 Reflexion(自我反思与动态纠错)。
1. 为什么要引入对抗性扰动
真实世界里环境从来不是静态的:数字端有突然弹出的系统升级、聊天弹窗、低电量告警和 5 秒网络高延迟;具身端有光照突变、目标物体被挪动 5 厘米、传感器抖动产生视觉噪声。传统 Agent 的通病是"一被打扰就当场瘫痪"——对着弹窗疯狂乱点,或陷入无限死循环。扰动测试正是为了量化抗打击鲁棒性与自我拯救能力。
2. 扰动注入分类矩阵
扰动注入器(Perturbation Injector)在运行时按计划或随机注入三类核心干扰:
动态对抗扰动注入矩阵:四类干扰覆盖数字与物理两界
3. 如何评估 Reflexion 自我反思机制
扰动发生时,评测系统不只看任务成败,而是追踪 Trace 日志评估 Agent 是否触发了"Reflexion 循环":
Reflexion 自我反思评估:崩塌与自愈的两条路径
三个关键量化指标:
- 异常识别延迟(ADL):从扰动注入到 Agent 首次在思维链中显式承认"当前状态与预期不符"的步骤数;
- 反思有效率:识别异常后,成功消除干扰并返回原任务路径的概率;
- 级联崩溃率:未能处理扰动导致记忆污染、开始胡乱输出动作的比例。
4. 扰动注入与 Reflexion 的联动评估
扰动注入器作为中间件挂载在仿真环境与 Agent 之间:到达预设步骤时注入弹窗、延迟等干扰,同时扫描 Agent 思维链中的反思信号("unexpected""异常""弹窗"等关键词),据此计算鲁棒性得分——任务成功且触发了反思记满分,蒙对了但没反思记 0.5,直接崩溃记 0 分。
5. 对 AI 工程落地的意义
- 打破理想主义跑分:拒绝只能在静态数据集拿 100 分、一遇风吹草动就崩溃的"温室花朵型 Agent";
- 倒逼思维链升级:训练 Agent 时不仅要灌输任务规划,还要增强"异常边界感知与自我打断"能力;
- 安全护栏的终极检验:长程任务中遭遇网络中断或恶意弹窗时,强鲁棒的 Agent 能安全熔断或正确恢复,而不是状态错乱触发越权操作。
10结语
Google DeepMind 的多模态 Agent 评测体系向整个行业证明:评测不是大模型研发的附庸,而是定义 Agent 能力边界的尺子。只有从"纸上谈兵的静态跑分"走向"深入真实系统状态与全轨迹诊断",才能筛选出真正具备工业落地价值的多模态 Agent。
JOTO 企业落地观察
- 企业部署多模态 Agent 时,若仍依赖截图比对或大模型视觉判分,将无法识别界面显示成功但后台事务失败的场景。Durable Reward 机制表明,必须穿透 UI 层,直接校验数据库记录、文件哈希或系统服务状态,才能建立可信的上线验收标准。
- 智能体工程需重构测试基础设施:环境必须支持毫秒级状态重置、跨用例隔离及动态参数化任务生成。这意味着企业不能仅复用轻量模拟器,而应基于真实操作系统实例或高保真物理引擎构建可编程、可版本化的测试环境,否则长期迭代中易出现状态污染与背题过拟合。
- RAG 知识工程需向具身 Grounding 对齐范式延伸:当 Agent 需操作 UI 或物理对象时,传统文本召回失效。企业须将知识结构化为可映射到像素坐标、边界框或 6D 位姿的几何语义单元,并采用 SoM 标记或密集 IoU/GIoU 计算替代模糊的相关性排序。
- AI 安全治理需覆盖执行链全过程:评测中引入动作三元组熵检测死循环、ADD 误差约束抓取精度、子目标 DAG 拓扑对齐验证逻辑一致性,说明企业不能仅关注输入输出合规性,还需在运行时监控动作序列的统计特征与状态跃迁路径,以识别隐性失控风险。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们