技术解读|会议 ASR 的下一站:让大模型自己学会听懂会议
本文探讨会议语音识别(ASR)的技术演进方向,指出传统模块化系统在真实会议场景中面临声学复杂性、多人重叠说话、专业术语混杂等挑战;提出ASR大模型应将声学鲁棒性、多说话人结构理解、长上下文一致性与输出克制等能力内生化,直接从原始音频生成带说话人归属与时间戳的结构化转写。
真实会议的复杂性远超理想假设
如果一个会议转写系统足够理想,用户体验应该非常简单:把一段原始会议录音丢进去,系统直接产出一份可靠的会议文本。不要求用户懂设备、懂前端、懂降噪,也不会在多人插话时把几个人的话揉成一团。
但真实会议不会配合这个假设。
有人坐在设备旁边,声音很清楚;有人坐在会议桌另一头,声音变小,还带着房间反射;有人习惯低声补充一句;空调、键盘、翻纸、投影风扇一直在响;讨论中还经常夹着英文缩写、项目代号、模型名、数据集名和临时造出来的术语。更麻烦的是,人不会排队说话——真实会议里有插话、有附和、有打断、有笑声,也有两个人同时说出半句话。
会议 ASR 要处理的不是一句干净语音,而是一段混乱但有结构的现场。
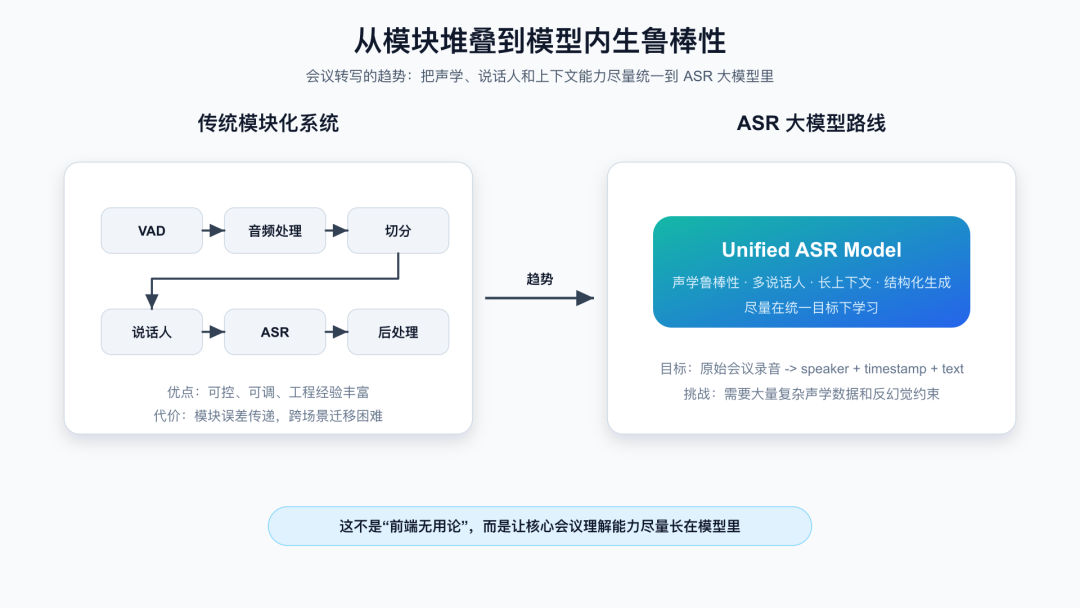
传统 pipeline 的误差传播瓶颈
过去的会议转写系统常常依赖一条很长的 pipeline:先判断哪里有人说话,再做音频处理和片段切分,再做说话人分割,最后把片段送给 ASR。这个系统工程当然有效,也长期支撑了会议转写的发展。
但它的代价也很明显:每多一个模块,就多一层误差传播;每换一个会议室、录音设备、语言风格和说话习惯,都可能出现新的不匹配。在长音频、多说话人、强上下文的会议场景里,前面某个模块切错、分错、归错,后面的 ASR 和摘要模型只能在错误输入上继续加工。
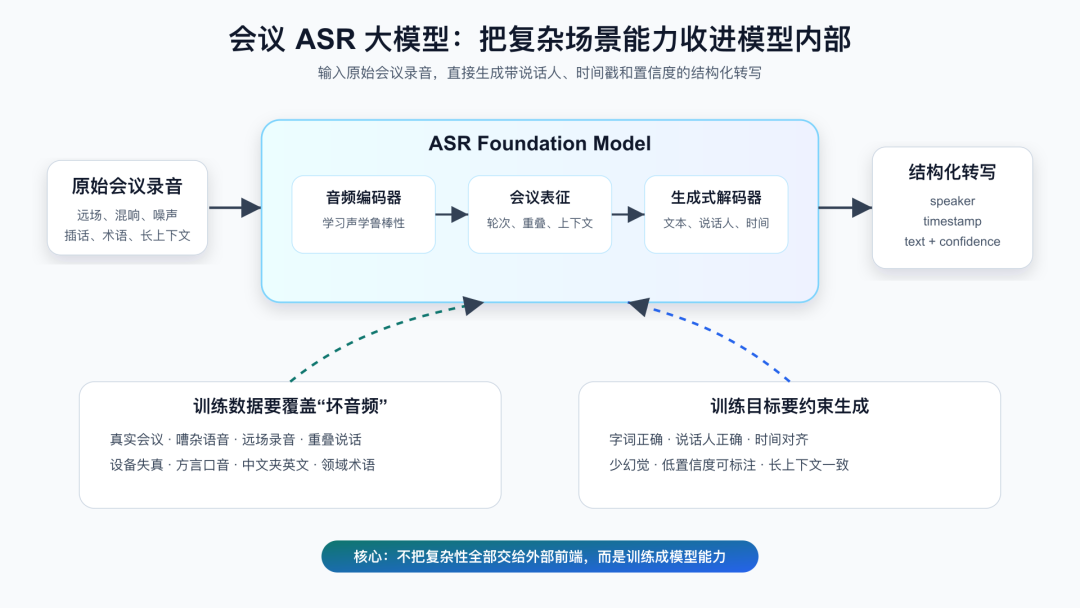
大模型路线提供了另一种可能:让一个 ASR foundation model 在训练中见过足够多复杂声学和多人会议数据,直接从原始会议音频中生成结构化转写。
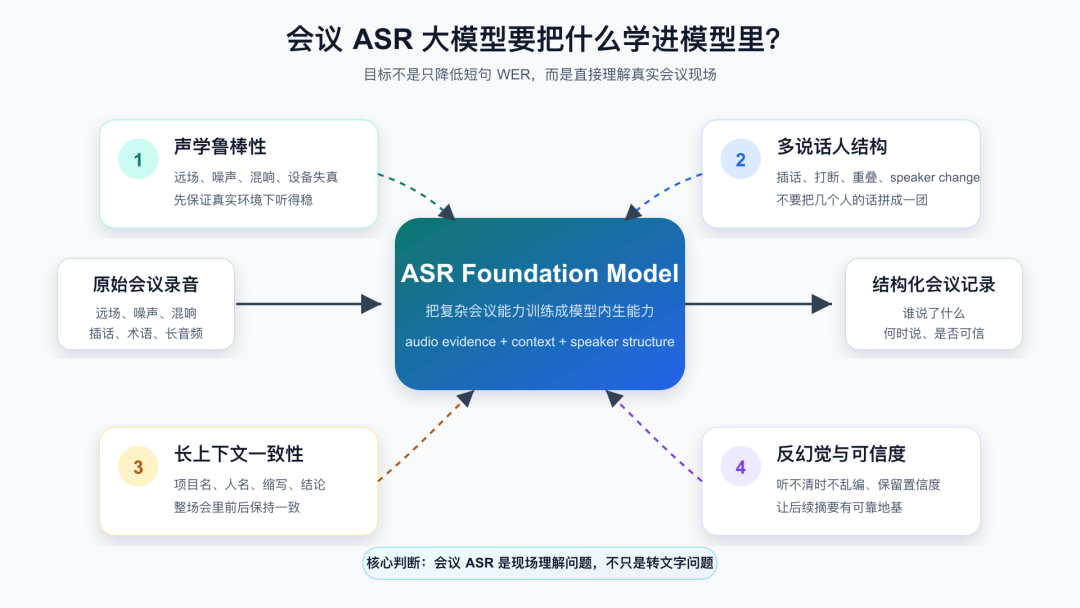
ASR 大模型需具备四项内生能力
声学鲁棒性
会议音频里同时存在距离、混响、噪声、设备失真和音量差异。模型训练不能只依赖干净朗读语音,而要系统覆盖这些变化。否则模型在干净 benchmark 上看起来很好,一到真实会议就开始漏词、错词,甚至产生幻觉。
多说话人结构
会议不是单人独白。模型需要理解 turn-taking、插话、抢话、短反馈和重叠说话。它最好能直接输出 speaker change、时间戳和重叠片段,而不是只给一串没有归属的文本,再让后处理去猜。
长上下文理解
会议里很多词只有结合上下文才听得准。项目名、缩写、函数名、人名、数据集名,经常不是靠当前几秒声学信息就能完全确定。大模型的优势正在这里:利用更长的上下文,让前后术语保持一致,让同一个结论在后续引用中不被改写。
克制
ASR 大模型越像生成模型,越要避免在听不清时自由发挥。会议转写不是创作任务。可靠性比流畅度更重要。一个成熟的系统应该能表达不确定,保留时间锚点,并把低置信度位置交给后续校对或人审,而不是编出一段看似顺滑的错误文本。
研究趋势:从通用 ASR 到会议 ASR 大模型
大规模、多语言、多任务弱监督训练,已经让 ASR 模型具备了很强的跨域泛化能力,这改变了很多人的预期:ASR 不一定只能在每个数据集上专门调一个系统,足够大的 Speech Foundation Model 可以成为通用起点。
但会议场景会进一步挑战这个范式。多人重叠、远场混响、长音频漂移、说话人归属,都不是普通短句 ASR 的核心训练目标。因此,后续研究开始围绕 Speech Foundation Model 做会议化改造。方向大致有三:
- 多说话人输出。Serialized Output Training 让模型学习在同一段音频里按顺序输出多个人的话,并显式建模 speaker change。思路很直接:既然会议里天然会多人轮转,那训练目标就不应该假装音频里只有一个说话人。
- 说话人条件注入。DiCoW 和 SE-DiCoW 这类方向把 diarization 信息或目标说话人片段作为条件注入 ASR,让模型在重叠语音中知道“这次应该听谁”。虽然这还不是完全无辅助的最终形态,但它透露出一个趋势:说话人归属不应该只是 ASR 后面的补丁,而应该进入模型内部。
- 统一生成。TagSpeech 直接把 ASR 和 diarization 合成一个任务,建模 “who spoke what and when”,让模型同时输出文本、说话人和时间锚点。这更贴合会议转写的产品逻辑:用户最终要的不是一串没有归属的文字,而是一份可追溯的会议记录。
同时,Qwen-Audio-3.0-ASR 这类工作说明,ASR 正在进入更大的音频 Foundation Model 阶段。模型不只追求干净语音 WER,而是开始强调真实场景、长音频、噪声、方言、多语言、实体词和上下文理解。
这给会议 ASR 一个很重要的启发:想让模型不靠复杂外部前端适应会议室,关键不是简单把模型做大,而是让模型见过足够多真实世界的坏音频。
输出升级:从纯文本到结构化会议记录
如果会议 ASR 只输出一整段纯文本,它离真实产品需求还差一步。
会议记录真正需要的是结构化结果:谁说了什么,什么时候说,是否存在重叠,哪些位置置信度较低,哪些词可能是领域术语。这样的输出才能继续支撑会议摘要、行动项提取、责任人识别、知识库沉淀和后续问答。
理想输出不应该只是这样:“这版先不要加到主训练集对先单独看 overlap case 等错误类型稳定之后再合进去”
而应该更接近这样:
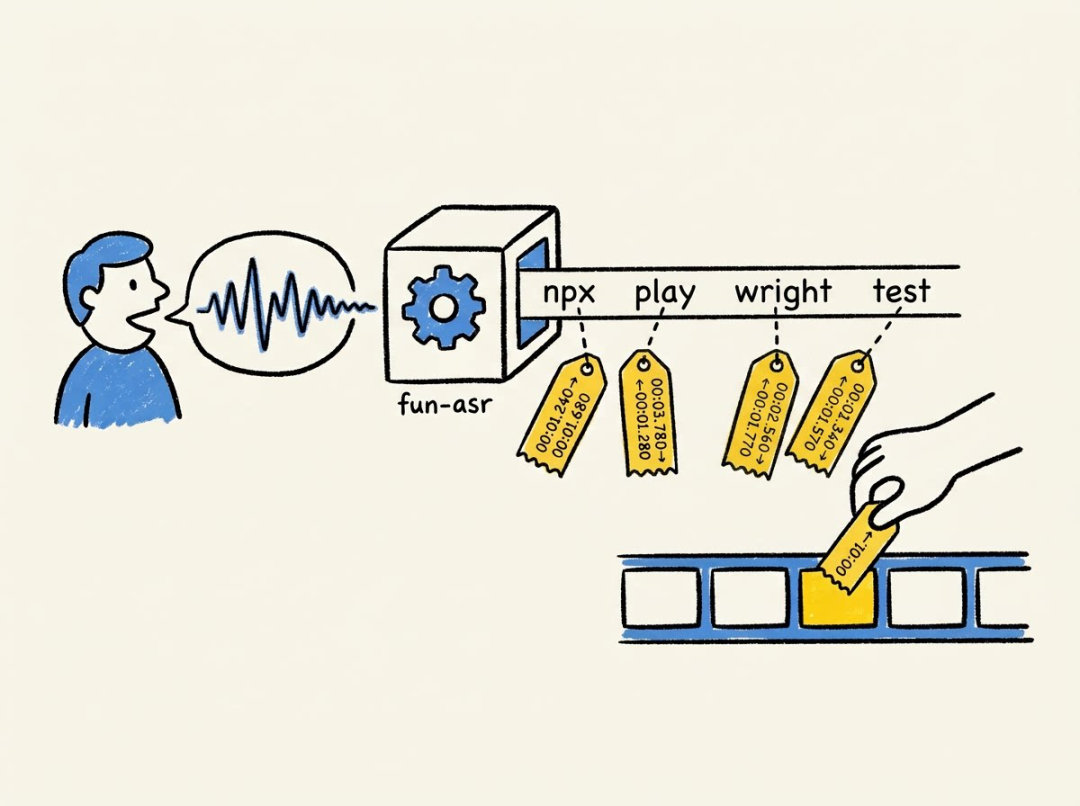
[00:03:21.4 - 00:03:23.8] Speaker A: 这版先不要加到主训练集。
[00:03:23.0 - 00:03:24.4] Speaker B: 对,先单独看 overlap case。
[00:03:24.2 - 00:03:27.1] Speaker A: 等错误类型稳定之后再合进去。
这种输出把 ASR、说话人归属和时间结构放在一起,才更接近会议智能体真正需要的输入。
这不是“前端无用论”
需要再强调一次:本文并不是否定传统前端。
语音增强、分离、说话人分割、VAD、时间对齐等技术在今天仍然有效,也仍会出现在很多强系统里。真正的问题是产品边界和模型能力边界正在变化。过去我们默认复杂会议必须拆给多个模块;现在大模型给了另一种可能:把更多复杂性吸收到统一训练目标中,让模型直接面对原始会议音频,减少场景化调参和模块间误差传递。
从产品角度看,这件事尤其重要。会议智能体的上层能力,比如摘要、待办、问答、检索、决策追踪,都依赖 ASR 提供第一层事实。如果 ASR 把关键术语听错,或者把一句话归错人,后面的总结再流畅,也可能建立在错误地基上。
所以,会议 ASR 的下一站不是简单追求更低的短句 WER,而是让模型真正听懂会议。一个理想的系统应该像训练充分的会议听写员:不要求环境足够干净,不要求用户懂前端参数,而是直接从真实录音中提取内容、说话人和时间结构。
结语
真实会议不会为 ASR 让路,人会插话,会低声补充,会临时造词,会中文夹英文,会在键盘声和空调声里讨论关键决定。一个面向未来的会议 ASR 大模型,应该把这些复杂性变成自己的训练经验,而不是把它们全部交给外部系统兜底。
当模型能够直接从原始会议录音中输出“谁在什么时候说了什么”,并且在噪声、重叠、长上下文和专业术语中保持克制与一致,会议智能才真正有了可靠的语音入口。
JOTO 企业落地观察
- 企业部署会议 ASR 大模型时,不能仅以公开测试集 WER 为验收标准;真实会议室中的远场混响、键盘噪声与多人重叠,构成不可绕过的声学验证门槛,需在产线环境中闭环测试。
- 这类系统的取舍在于:是否接受将说话人分割、VAD、语音增强等能力从独立模块收编至 ASR 模型内部。收编可降低误差传播,但也提高对训练数据多样性和推理延迟的敏感度。
- 会议 ASR 的结构化输出(speaker + timestamp + text)是企业构建会议知识图谱的前提。若模型无法稳定输出说话人归属,后续行动项提取与责任追溯将失去事实依据,RAG 系统亦难以建立可靠的时间-角色-内容索引。
- 模型在低置信度段落选择‘留空’或‘标注存疑’而非自由补全,对企业 AI 安全治理具有实质意义:它避免了错误事实向下游摘要、知识库与决策支持系统的隐性渗透。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们