相关文章
553 篇高质量内容
千问上线 Qwen3.8-Omni-Flash:1M 上下文,音频输入价格降幅超98%
千问Qwen3.8-Omni-Flash全模态模型发布!1M上下文+音频输入价格降超98%,性能平均提升超26%。核心内容:1. 模型核心能力与发布信息2. 性能提升与评测表现3. 价格优化与新功能
给AI产品接上嘴——ASR+TTS接入实战,延迟从2秒压到300毫秒
语音对话2秒延迟致体验差?AI助手秒变“排队客服”!实战拆解ASR+TTS链路,延迟压至300ms的选型、踩坑全攻略。核心内容: 1. ASR/TTS主流方案对比(延迟、准确率、成本) 2. 流式方案必要性及不同类型(整句vs流式,首字延迟差异) 3. 延迟优化实战:分句合成等链路拆解方法
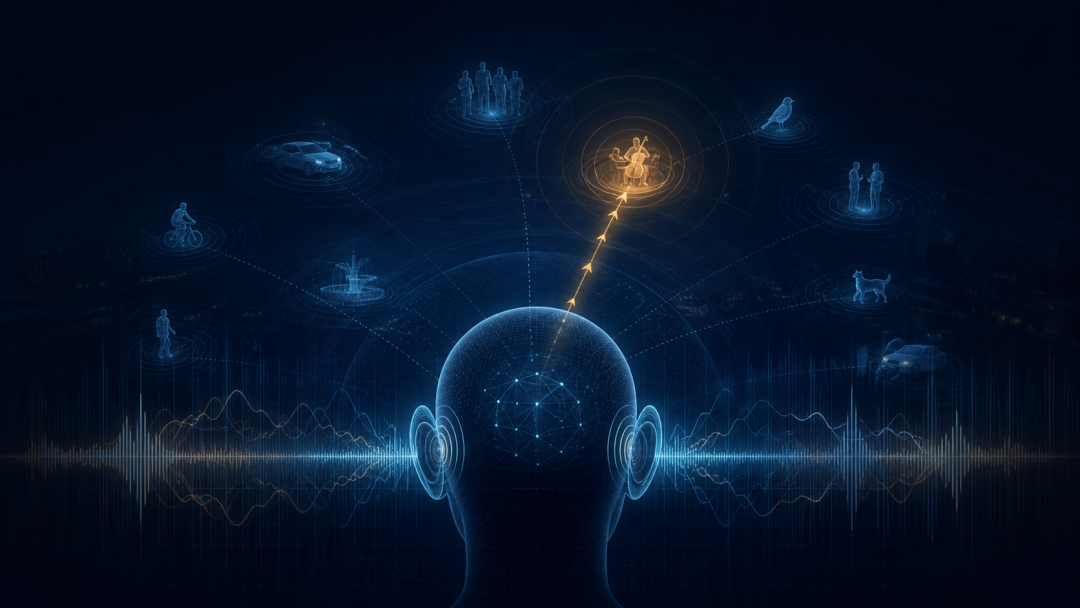
论文解读|LuSeeL:让 AI 既能“听出声音是什么”,又能“听出它来自哪里”
复杂环境下AI难以同时识别声音内容与定位方向,阿里LuSeeL框架通过自然语言指令+双耳信号,实现精准声事件提取与定位。核心内容:1. 自然语言驱动目标声音提取(关键词/描述指定声源)2. 双耳音频双域(时域+频域)分析与跨模态融合3. 方向估计输出(0~360°声源到达方向似然分布)
GPT Images 2.5 突发上线!网友的「灵魂画作」一个比一个离谱
GPT Images 2.5重磅上线!修改精度与细节质量飞跃,新增手绘参考等功能,网友离谱创作成热议。 核心内容: 1. 新模型核心功能升级:细节、速度、编辑精度及一致性提升,新增手绘参考等功能 2. 修改能力突破:精准执行用户指定修改,保留主体特征,解决误改问题 3. 应用场景与用户创作:网友离谱创作案例,每周30亿张生成量,覆盖多场景
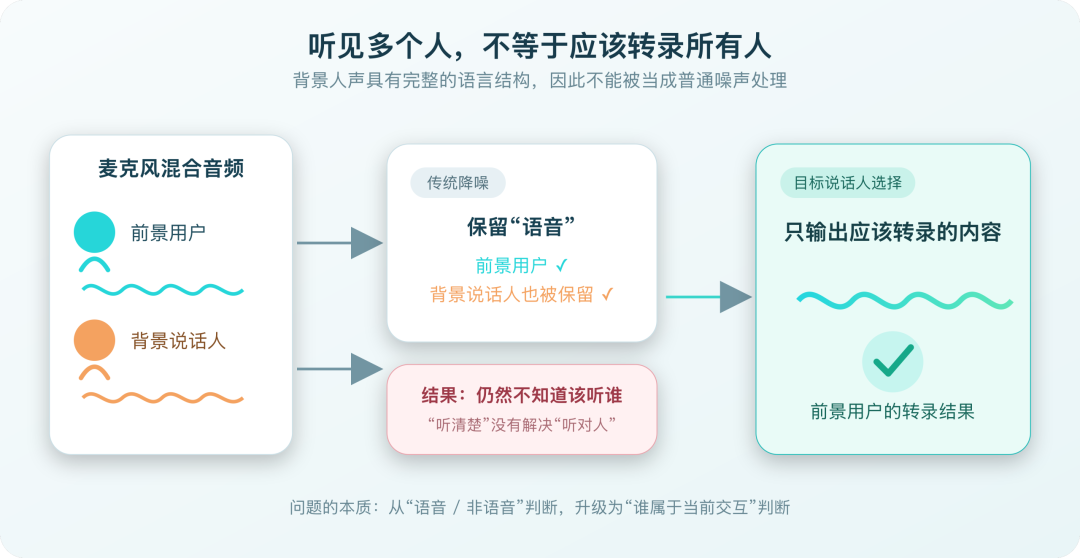
技术解读|复杂人声干扰下,如何让 ASR “听对人”
复杂人声干扰下ASR常误识多人对话,本文解析“听对人”技术突破,从目标说话人选择到双路线方案,破解语音识别核心难题。 核心内容: 1. 复杂人声环境下ASR的识别困境(误转多人对话) 2. 背景人声干扰的本质:目标说话人选择而非普通降噪 3. 双技术路线:身份锁定与场景判断的ASR方案对比
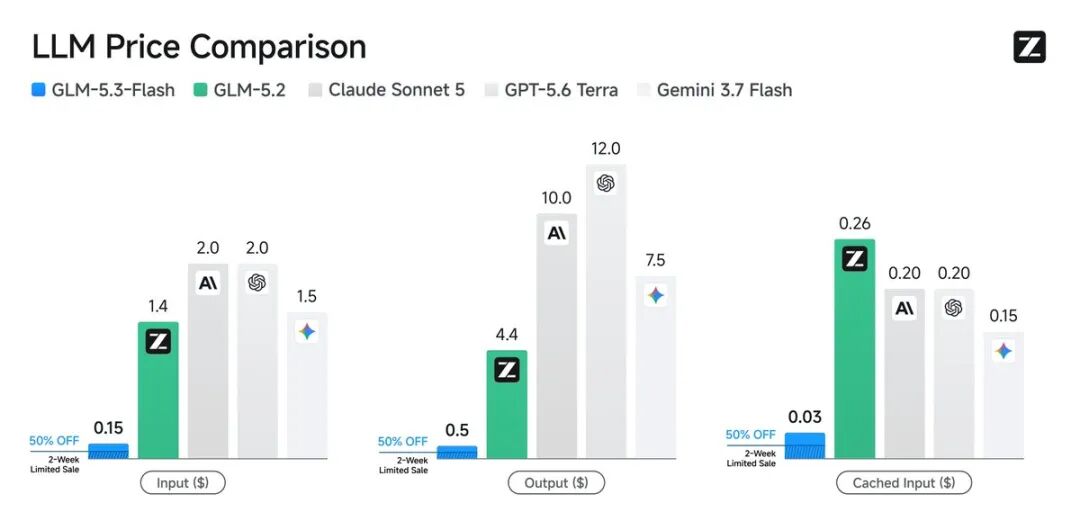
GLM 5.3 Flash 这价格太离谱了,新的斩杀线
国产芯片算力超100T/日,GLM 5.3 Flash半价仅Opus 4.8的1/40,性能持平,新性价比斩杀线已形成。 核心内容: 1. 国产芯片支撑超100T/日算力供应,改变行业格局 2. AI指数57分与Opus 4.8打平,价格仅为其1/40 3. 超低成本架构+原生多模态能力,开启AI应用春天
扔个 PPT 进去,30 秒吐出一条视频:拆解阿里 Wan3.0
阿里 Wan3.0 实现文档秒生成视频,30秒产出1080p汇报片,打工人做视频的痛点被自动化。核心内容:1. Wan3.0 核心功能升级:支持文档直转视频,30秒生成1080p内容2. 行业痛点突破:对比竞品,解决时长限制与文档输入难题3. 阿里商业化策略:从开源到闭源的权重开放路径调整
Qwen3.8-Flash:全新架构,更强更稳更划算
Qwen3.8-Flash多模态MoE模型发布,全新架构提升性能与效率,支持1M token超长上下文,千问平台即将上线服务。核心内容: 1. 多维度架构升级:GDN+QSA Hybrid Attention、Gated Residual等优化 2. 超长上下文能力:原生262k token,YaRN扩展至1M token 3. 成本与生态布局:训练成本降至前代1/9,千问API及开源Next架构
DeepSeek小模型长了眼睛,Agent基准干翻顶级闭源模型
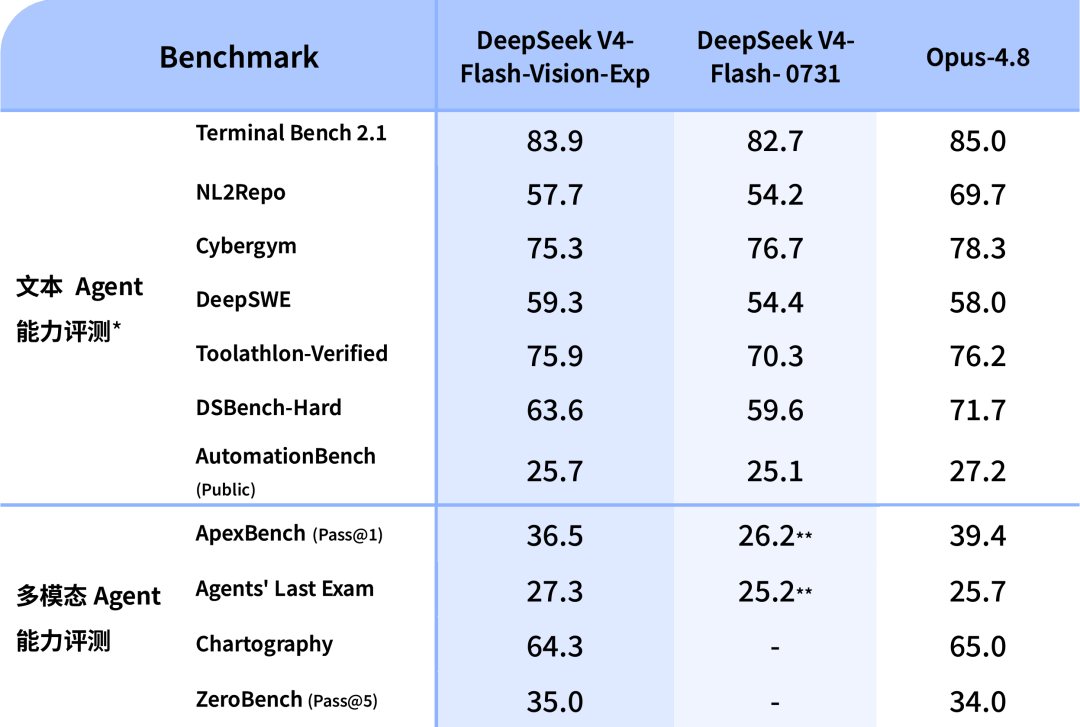
DeepSeek轻量多模态模型V4-Flash-Vision-Exp,在Agent基准测试中击败顶级闭源模型,视觉与文本性能双优且成本可控。核心内容: 1. 多维度基准测试成绩优异,Agents' Last Exam、ZeroBench等超闭源模型 2. 视觉能力叠加后文本性能未降,DeepSWE、Toolathlon等任务成绩提升 3. 轻量架构+成本控制,Agent工作流能力增强,多场景实用价值显著
V4-Flash-Vision-Exp 上线,开启多模态 API 服务
DeepSeek-V4-Flash-Vision-Exp多模态模型上线API,文本能力持平正式版,视觉理解Agent能力大幅跃升接近Opus-4.8。 核心内容: 1. 文本与多模态能力平衡(纯文本能力持平,视觉理解Agent能力跃升) 2. 多模态能力解锁的Agent场景示例(商业PPT、开发者网站、动态特效创作) 3. API服务使用方式与计费规则(token计费,价格与V4-Flash一致)
DeepSeek Harness 更新:官方多模态支持
DeepSeek Harness三次版本迭代,多模态能力重磅升级,子代理协作更灵活,体验与稳定性全面优化!核心内容:1. 多模态能力增强(新增多模态模型,支持图文输入及图片持久化)2. 子代理与插件组合灵活(子代理接入Job Panel,插件可注册设置卡片)3. 稳定性与体验持续提升(修复问题,优化交互细节)
DeepSeek终于长出“眼睛”,V4 Flash视觉模型上线
DeepSeek V4系列首支视觉模型上线,支持图片输入,补齐Agent感知入口,参数价格细节曝光。核心内容:1. V4 Flash视觉模型核心参数(支持图片输入、1M上下文、384K输出、JSON等功能)2. 价格策略(与Flash版本一致的缓存及输出价格)3. 与Agent系统整合(接入Harness,联动模型、工具与执行链)
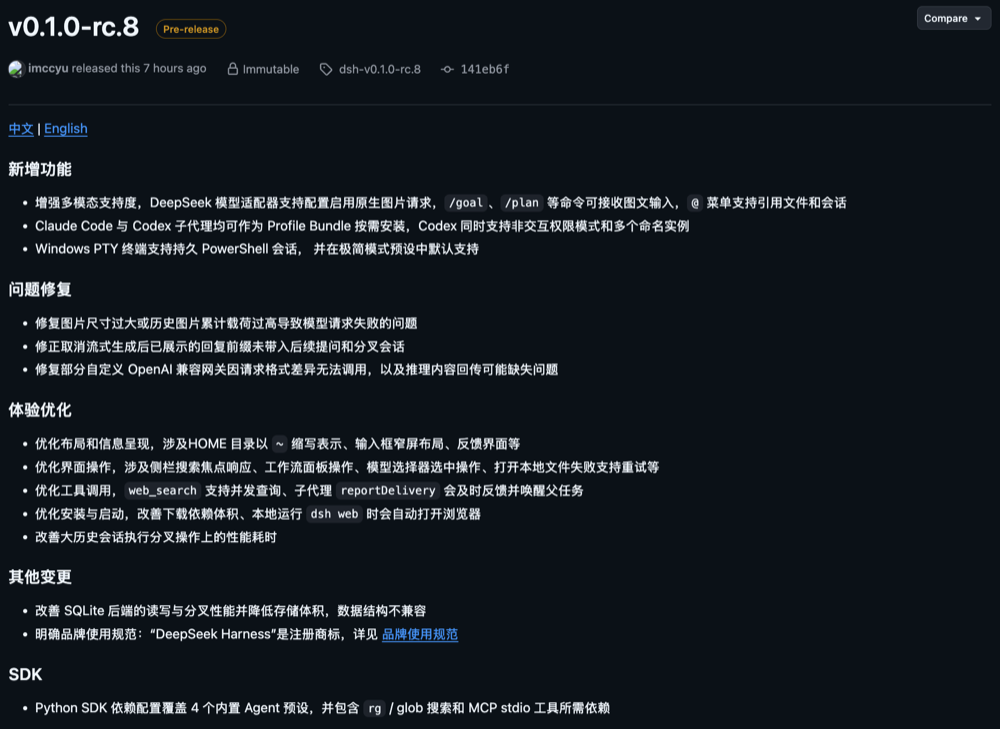
昨夜,DeepSeek Harness首发新版本:14项更新,多模态能力拉满!
昨夜DeepSeek Harness发布v0.1.0-rc.8版本,14项更新补齐多模态能力,子代理与工具体验全面升级! 核心内容: 1. 多模态输入能力升级(原生图片/图文混合支持) 2. Claude Code、Codex子代理体系扩容 3. 终端体验与工具调用问题修复优化
DeepSeek Harness重磅更新:原生解锁多模态
DeepSeek Harness RC.8版本重磅更新!多模态能力原生解锁,Claude Code/Codex子代理按需安装,框架体验全面升级。 核心内容: 1. 多模态与子代理增强:原生图片请求、Claude Code/Codex子代理支持 2. 关键问题修复:图片载荷过高、流式生成前缀丢失等问题解决 3. 体验与工具优化:布局信息呈现、并发查询支持及安装启动改善
GitHub又火了一个语音转录库,我跑了5分钟
本地语音备忘录开发不再崩溃!transcribe.cpp基于ggml,统一C/C++底层+多语言接口,5分钟实现跨平台分发。 核心内容: 1. 本地ASR跨平台分发的痛点(模型拼接、格式转换难题) 2. transcribe.cpp的设计方案:统一底层+多语言接口 3. v0.1.0版本的关键能力(模型覆盖广、后端支持多、验证严格)
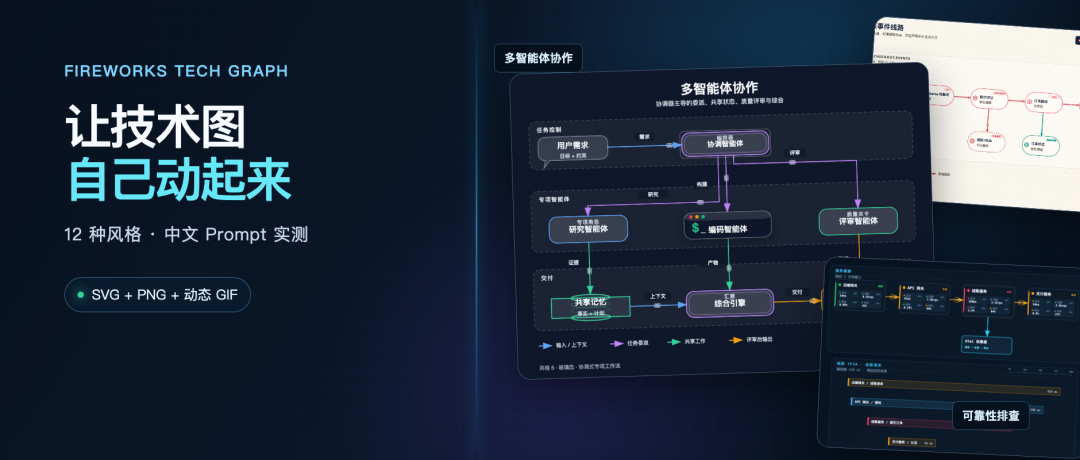
写一句中文 Prompt,技术架构图自己动起来了
用中文描述系统,直接生成可编辑的SVG和动态GIF技术架构图,让箭头按业务逻辑流动起来。 核心内容: 1. 项目核心:解决手动画技术架构图慢且易错的问题 2. 技术亮点:将需求转为结构化语义,生成可校验的SVG与动态GIF 3. 应用场景:覆盖14类UML图及多种AI场景,提供12种视觉风格
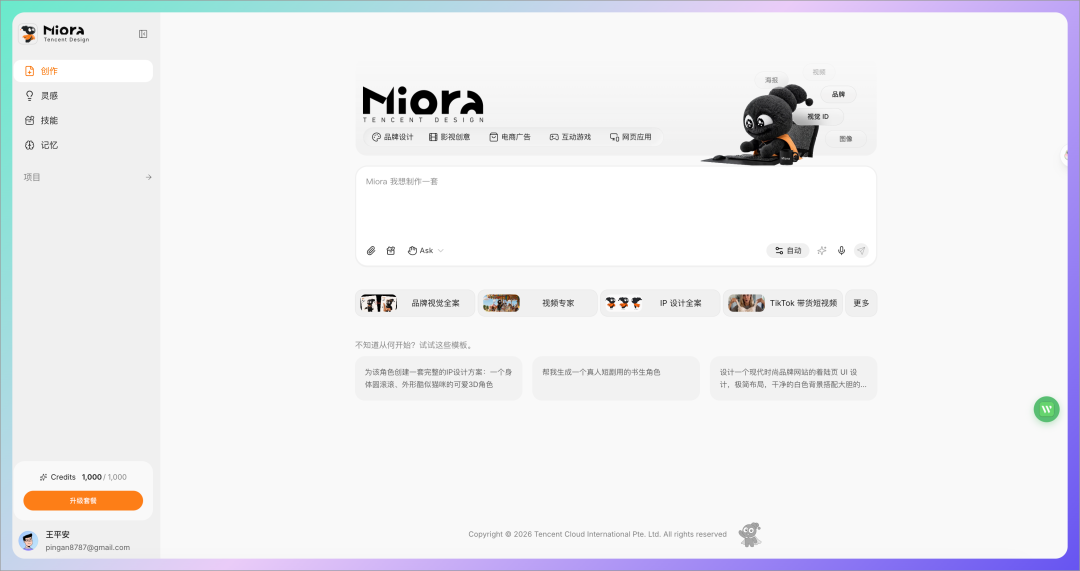
腾讯 Miora 正式发布,设计工作也可以交给 AI 了
腾讯Miora让AI接管品牌设计全流程,从定位到视觉资产一键生成,设计师的创意伙伴来了。 核心内容: 1. Miora作为腾讯AI设计Agent的核心功能与使用流程 2. 支持品牌、影视、电商等多场景的模板化创作 3. 智能规划、多模型协同与交互式修改的三大优势
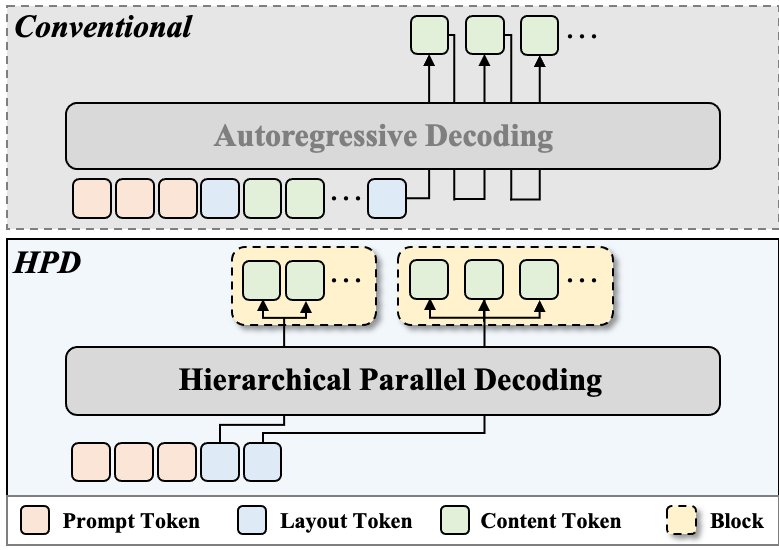
告别逐字等待:PaddleOCR推出高吞吐层级并行文档解析技术 HPD-Parsing
告别传统文档解析的低效串行模式,PaddleOCR推出HPD-Parsing技术,实现团队协作式并行处理,解析效率大幅领先。 核心内容: 1. 传统自回归解析的瓶颈与HPD-Parsing的并行解析机制 2. 在OmniDocBench评测中实现吞吐量三倍以上提升,解析精度保持领先 3. 文档越长,其并行处理的效率优势越显著,代码与模型已开源
TMAP平台图生视频推理加速实践
TMAP平台通过多卡并行、Attention加速、量化与缓存优化,在保证质量无损的前提下实现4.87倍推理加速,单次成本降至0.15元/秒以下。 核心内容: 1. 针对图生视频模型推理瓶颈的四大优化领域 2. 关键加速技术:序列并行、SageAttention算子与混合量化 3. 自研DPCache缓存方案带来的全局最优调度效果
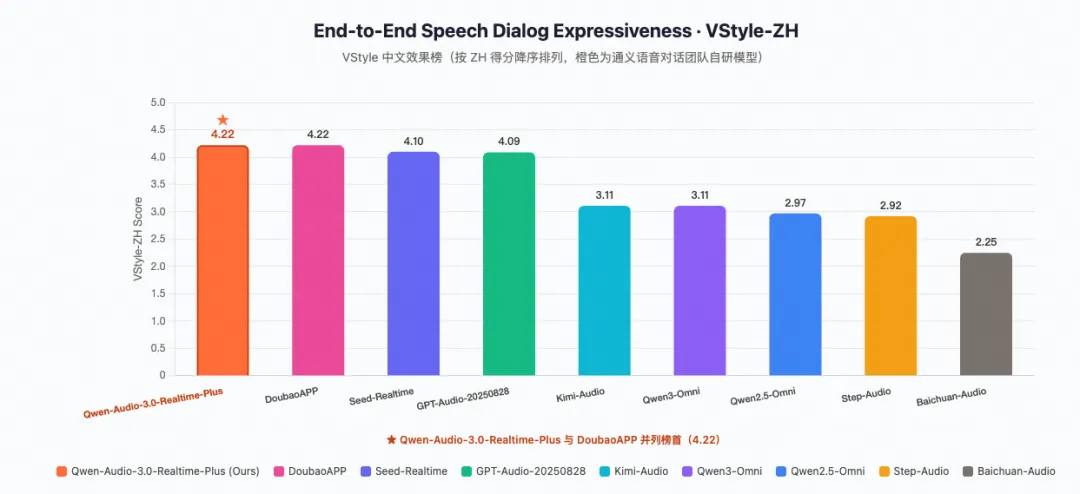
Qwen-Audio-3.0-Realtime 如何让语音交互“懂倾听,更聪明”?
阿里新一代实时语音模型如何让AI“听懂人心”?通过动态情感与多模态双工,实现拟人化交互。 核心内容: 1. 高表现力与共情对话:动态调整语气情感,支持音色克隆 2. 流畅双工交互:多模态感知,嘈杂环境下抗干扰 3. 智能任务处理:动态工具调用,超越基础聊天功能