相关文章
7144 篇高质量内容
刚刚,程序员通宵找Bug的历史要结束了,Claude只用几周,把整个软件测试行业改写了
Anthropic安全红队利用Claude在RISC-V汇编层面为123个主流开源软件生成1.8亿行数学证明,首次实现对小于64MB任意输入下绝对不崩溃、不越界、逻辑成立的数学级验证。该方法绕过传统模糊测试的路径覆盖局限,直接在机器码层进行形式化验证,并通过独立Rocq检查器完成毫秒级可验证性确认。
苦搜索引擎久矣,DeepSeek 和腾讯终于动手了
10月17日DeepSeek发布V4.1-Flash-1017并开放Search与Fetch两个AI专用搜索API;10月20日腾讯元宝搜索通过腾讯云对外开放。二者均面向开发者而非终端用户,旨在为AI Agent提供更可靠、可过滤的联网检索能力。澎湃新闻实测显示,相比传统搜索引擎大量返回假冒售后电话,DeepSeek等AI搜索未返回此类结果。
Personal Agent 落地思考:主动性从哪来,又卡在哪?
文章剖析 Personal Agent 主动性的本质来源与落地瓶颈:主动性由身份、数据源、记忆三要素共同构成;其核心驱动力是「目标−现状」差距引发的问题识别;作者提出分层模型(L1–L5),指出 L4/L5 的执行受限于责任归属与失败代价;实践表明,升仓关键在于显式定义目标与可检查的验收规则。
上下文工程的现状:从塞满到遗忘
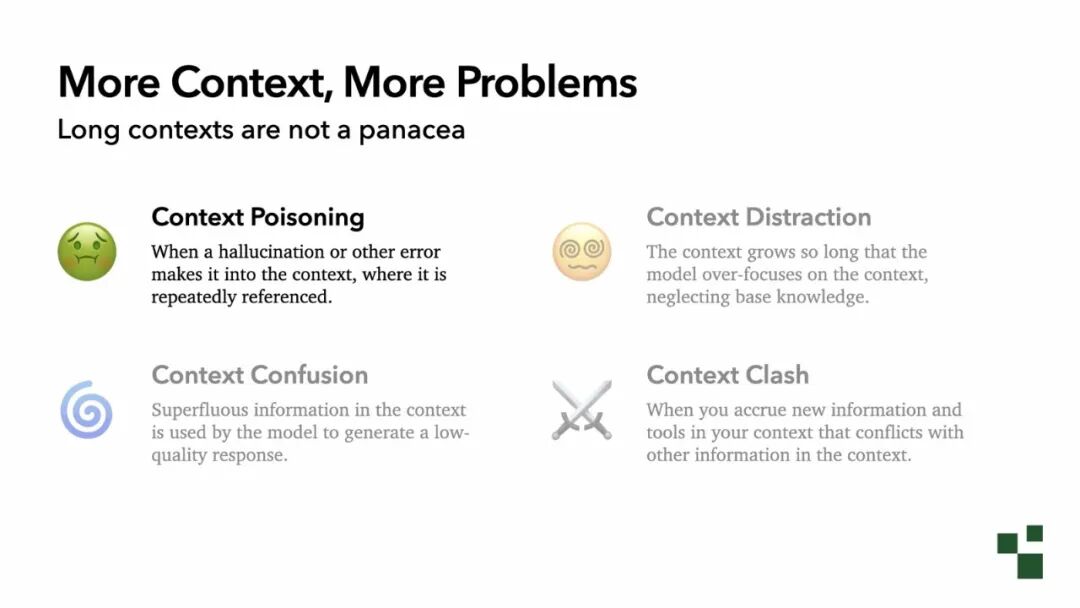
本文基于Drew Breunig 2026年10月发布的《The State of Context Engineering》,系统梳理长上下文场景下AI助手面临的信息管理挑战。重点分析四类上下文失败(毒化、分心、混淆、冲突),六种上下文管理手段(增强、装载、隔离、剪枝、卸载、压缩),以及重置前需保留可接手状态的关键实践。
万字图文讲透 AI Native 研发体系:四个维度建起你的 AI 生产线
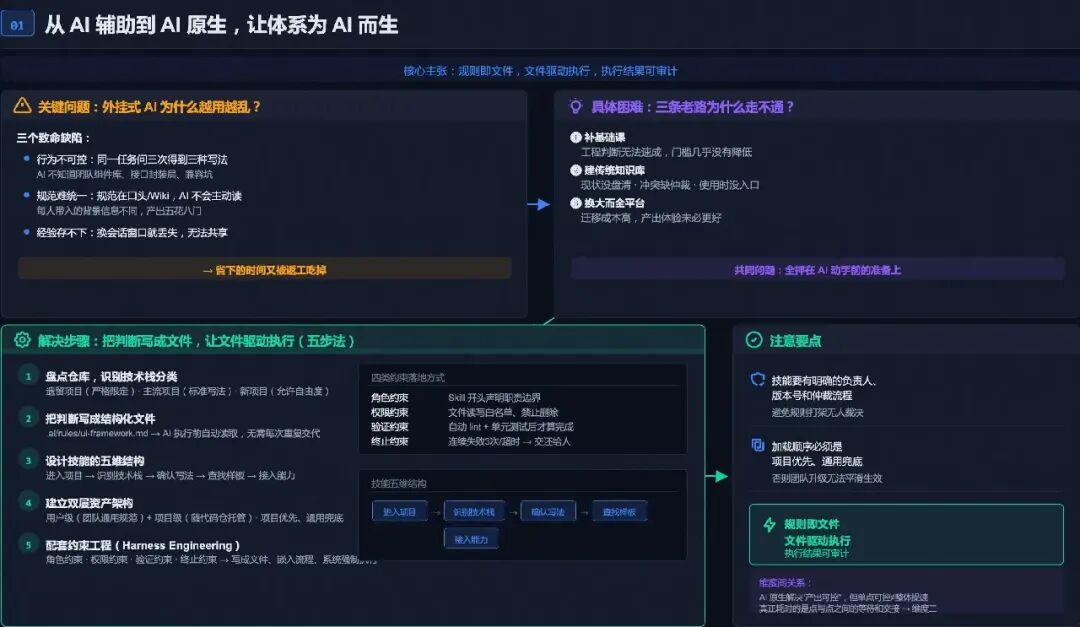
文章指出AI工具普及后团队整体交付未提速,主因在于生产体系未适配AI特性。提出四个升级维度:AI原生(规则文件化、约束工程化)、系统工程(需求数字线程与阶段门禁)、组织能力(经验版本化沉淀)、多角色协同(角色专属Agent)。核心是将隐性规范、上下文和判断转化为可加载、可验证、可审计的结构化资产。
月之暗面Kimi K3.1 Pro发布:3万亿参数开源权重在即,多任务智能体能力跃升但陷付费推广争议
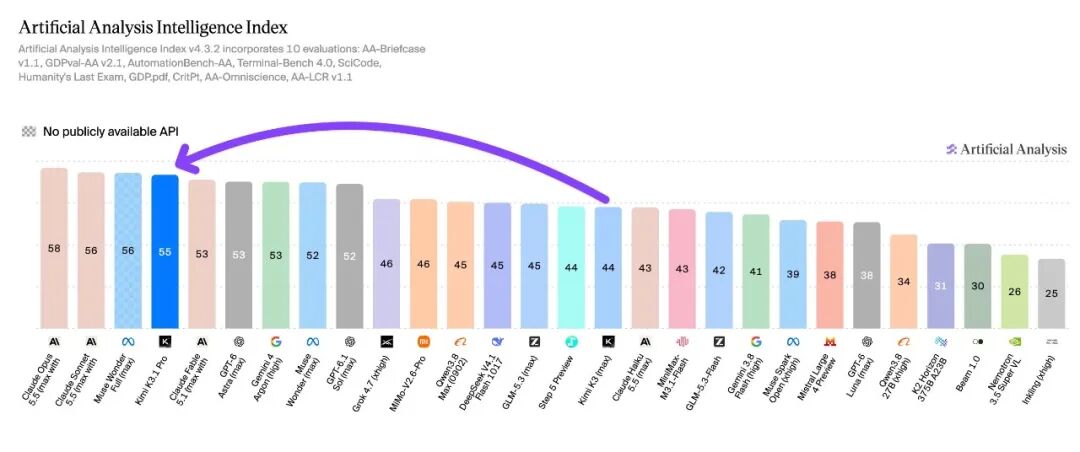
月之暗面发布Kimi K3.1 Pro——3万亿参数大模型,第三方评测中多项指标领先GPT-6 Astra与Muse Wonder;拟于2026年11月4日开源权重,成全球最强开源LLM候选;但遭X平台曝光涉嫌要求网红隐匿付费合作,引发合规风险。
为什么你的 AI Agent“越改越差”?Anthropic 总结了 8 步评测方法
Anthropic 提出 AI Agent 评测的系统性框架,指出盲目迭代导致的“盲飞”问题,定义 Task/Trial/Grader/Transcript/Outcome 等核心概念,区分能力评测与回归评测,并详解三类评分器(代码/模型/人工)的适用边界。文章强调非确定性影响,推荐 pass@k 与 pass^k 指标,给出从真实失败中提炼用例、环境隔离、轨迹审查等 8 步落地路线。
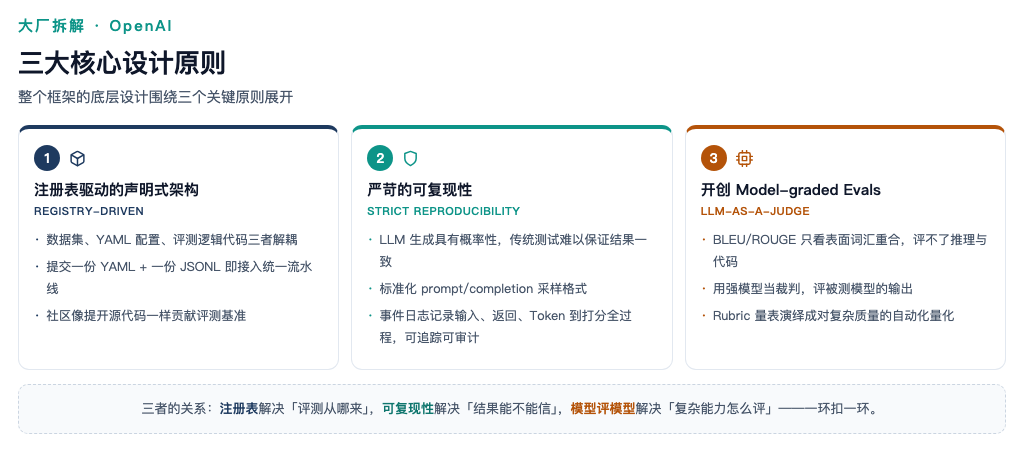
OpenAI Evals技术拆解:Agent评测的入门教科书
OpenAI Evals 是一个开源评测框架,核心是标准化的注册表机制、严格可复现的日志体系和模型即裁判(LLM-as-a-Judge)范式。它支持从单轮文本生成到多步 Agent 行为轨迹的评估,通过 JSONL 数据集、YAML 配置与解耦的 Solver/Completion 组件实现灵活扩展,为复杂推理、工具调用与状态变更类任务提供结构化评测能力。
Kimi K3.1 Pro:智能前沿,更进一步
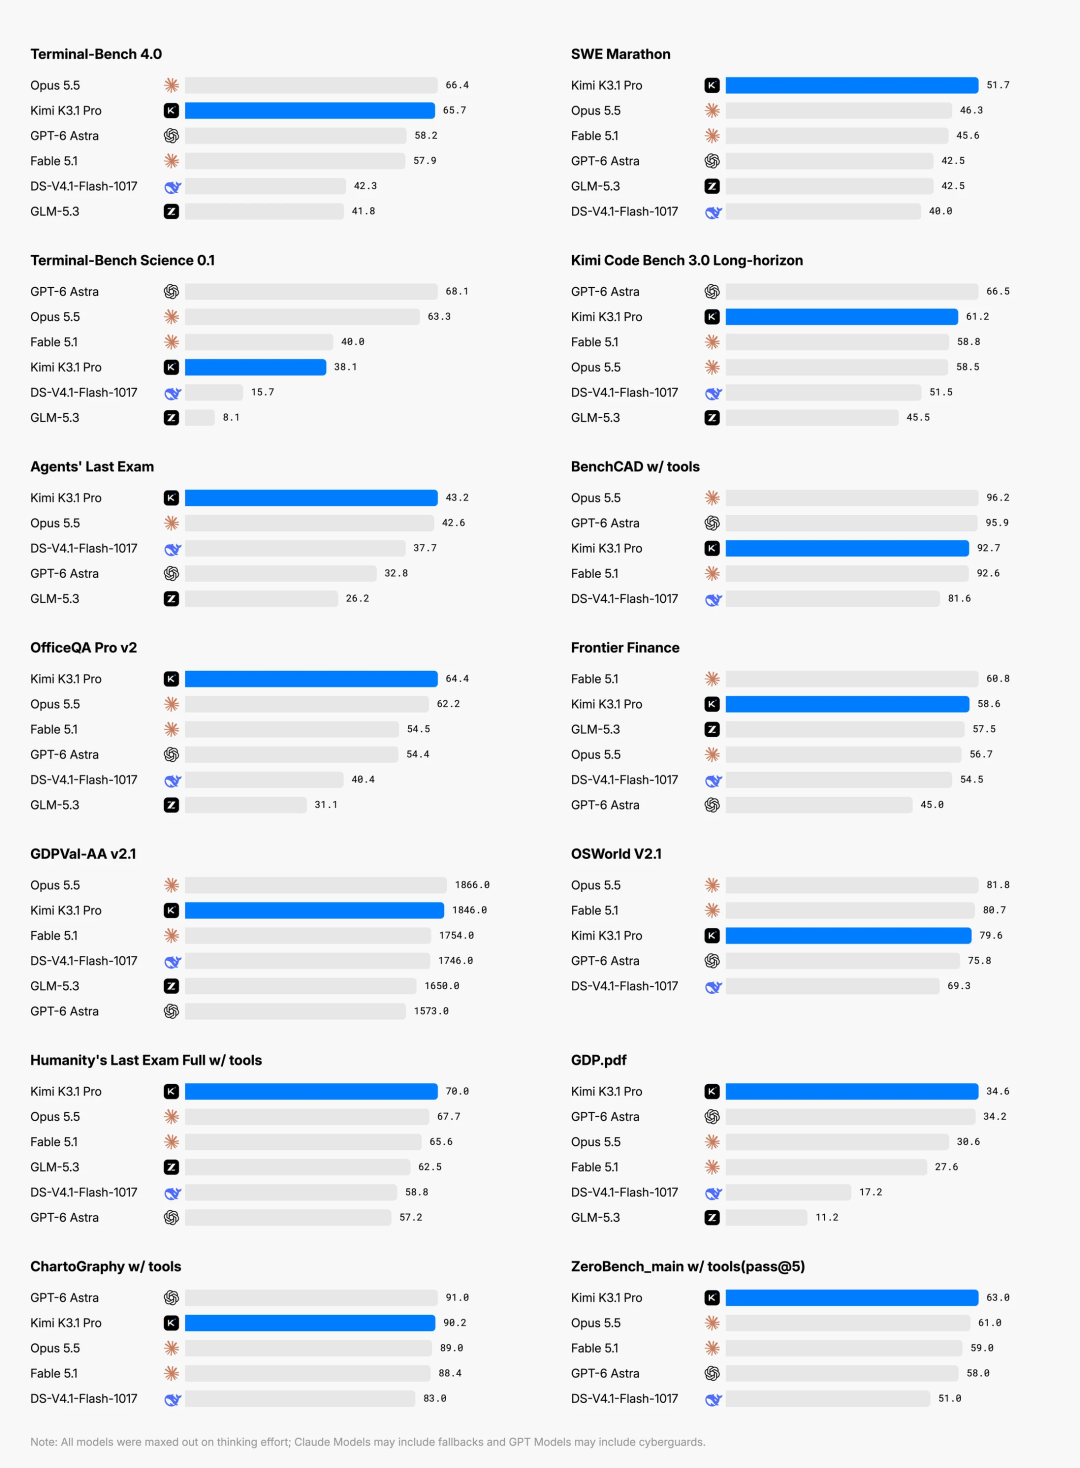
月之暗面正式发布 Kimi K3.1 Pro,3 万亿参数模型,支持 100 万上下文。该模型在代码、3D 创作、金融研究及长程 Agent 能力上显著提升,在 Terminal-Bench 4.0 得分 65.7%,BenchCAD 得分 92.7%,OfficeQA Pro v2 达当前最优成绩(SoTA)。同步推出高速版 K3.1 Pro Highspeed,输出速度约快 2~3 倍。模型已开放 API 及多端使用,并将于 11 月 4 日前发布完整权重。
刚刚,月之暗面发布Kimi K3.1 Pro。这把超Astra了?!
月之暗面正式发布Kimi K3.1 Pro模型,基于K3后训练,在代码(Terminal Bench 4.0得分65.7)、3D建模(Bench CAD得分92.7)、金融(OfficeQA Pro v2得分64.4)、网络安全(自建Benchmark得分81)等多维度能力显著增强;幻觉率降至8.3%,API输入/输出价格下调,Kimi官网、Kimi Code及Kimi Work已全面上线。
Kimi K3.1:超越 Astra 大模王,贡献了最好的「秦始皇骑北极熊」
Kimi全新K3.1 Pro大模型重磅发布,性能比肩国际顶尖大模型,干货满满。核心内容:1. Kimi K3.1 Pro的基础配置,以及它生成的「秦始皇骑北极熊」3D网页游戏演示效果2. 多维度官方基准测试跑分,展现其代码等核心能力的行业排位3. 该版本长程任务能力的提升逻辑与相关官方典型应用案例
精彩焕新|Google Play 多项更新助力您触达目标用户,加速业务增长
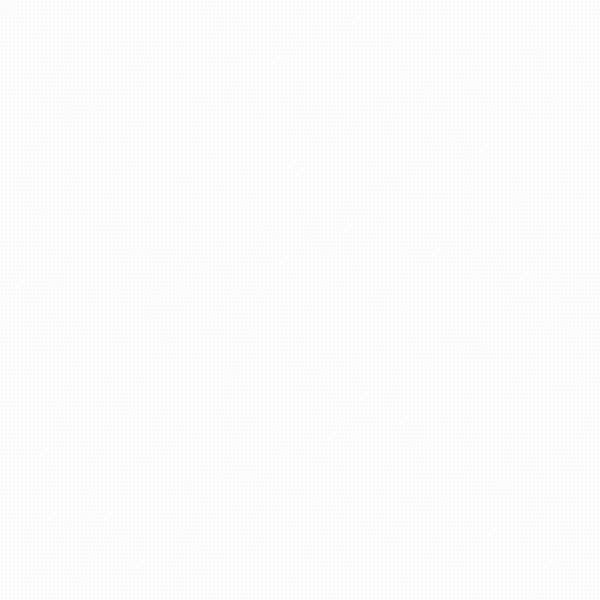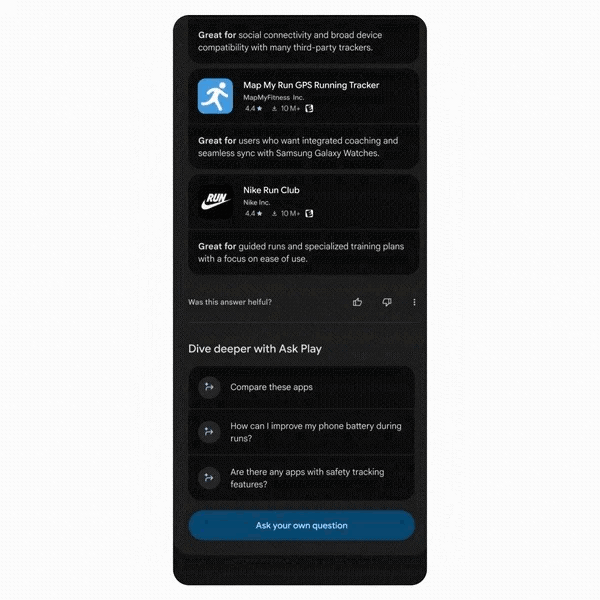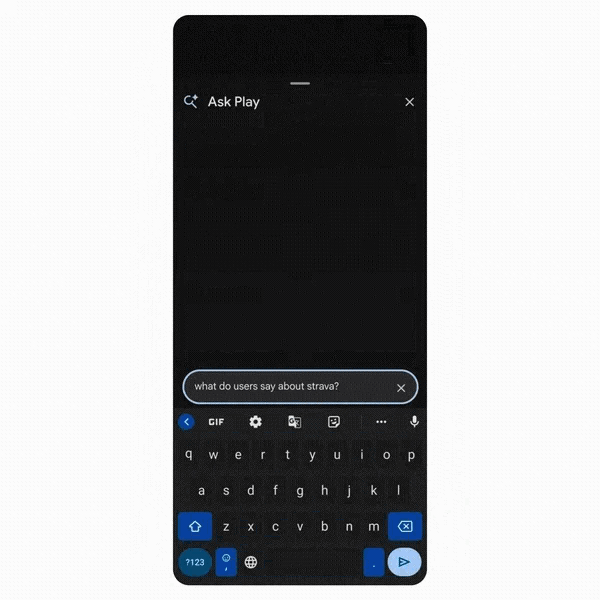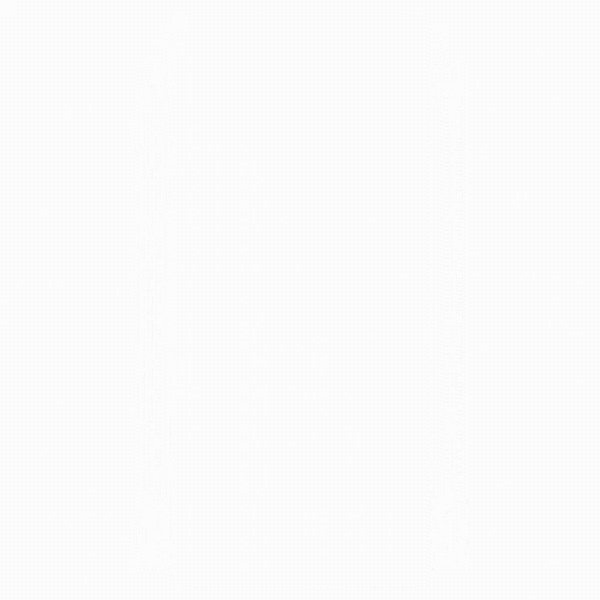
Google Play 推出多项更新:Ask Play 应用对比、Game finder 游戏推荐、Play in Gemini 对话式发现;新增 Sidekick Playbacks、冲刺赛(Sprints)和任务(Quests)提升玩家参与;通过 Apps Experience 和 Level Up 计划降低服务费率,回馈优质应用。《PUBG MOBILE》等案例显示高价值玩家新增安装量提升22%。
换模型效果归零?一文扒透Harness落地11个坑
本文系统梳理Harness Engineering在企业落地过程中常见的11个认知与实践误区,涵盖将Harness误作高级Prompt、混淆SDK与Harness本质、忽视记忆保鲜与置信度、迷信模型而轻视Harness设计、缺乏可观测性、让AI自我评估、仅关注二元评测结果、盲目抄袭大厂实践、误以为可一次设计到位、忽略对人的工程约束,以及忽视企业级权限/长周期/合规等特殊约束。核心指出:Harness不是工具堆砌,而是反映团队工程纪律与组织能力的镜子。
OpenAI称模型协助发现PHP核心漏洞,Wiz披露可致RCE
OpenAI与Wiz联合披露两项PHP底层漏洞CVE-2026-109618和CVE-2026-109619,统称PHP2Shell,严重性评分为9.2,可导致未经登录的远程代码执行(RCE)及内存信息泄露。漏洞源于PHP致命错误处理中的内存管理缺陷,影响所有PHP安装,尤其mod_php部署方式风险最高。GPT-5.6 Sol与Gemini 4 Argon等模型在漏洞验证与利用路径探索中发挥关键作用。PHP官方已发布8.2.35等修复版本,但更新需落实至实际运行环境。
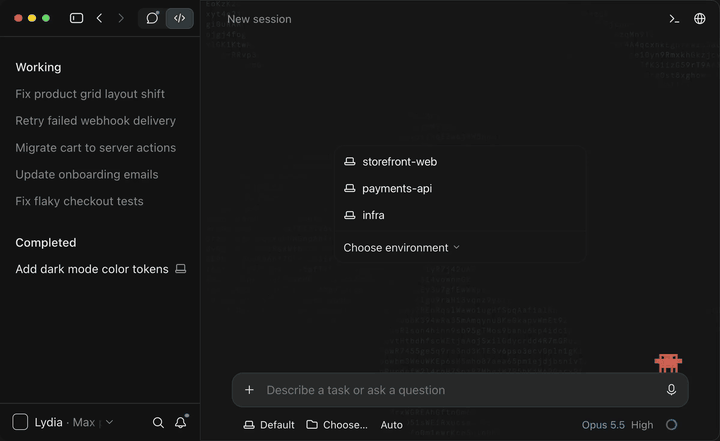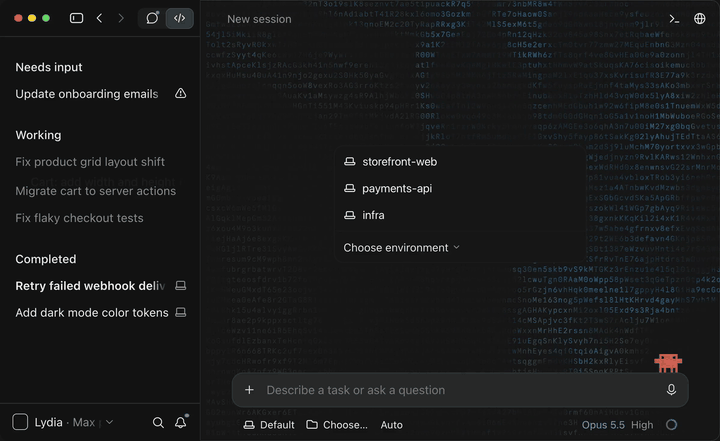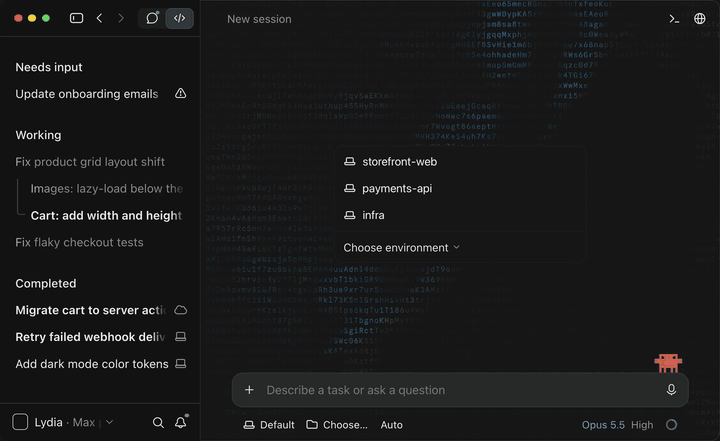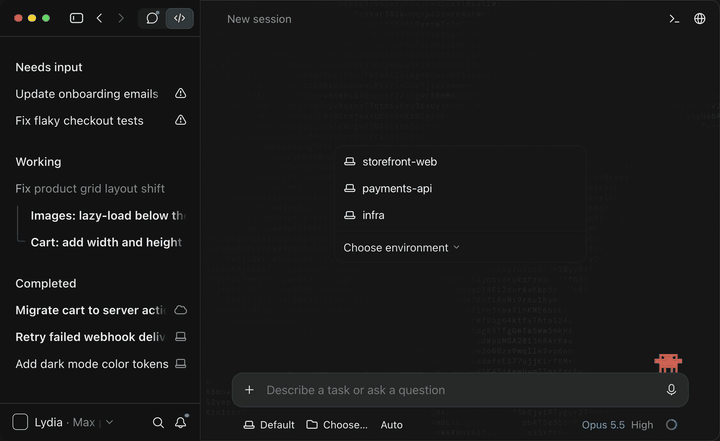
Claude Code 桌面版大更新,团队成员说“几乎像 v2”
Claude Code 桌面版推出重大更新,面向 Pro、Max、Team、Enterprise 订阅用户(Linux 版仍为 beta)。核心变化包括:会话状态分组可视化、支持自动派生子会话并行执行、/btw 快捷插话机制、环境与 worktree 管理、实时待办与回顾卡片。更新未发布官方博客,亦无明确版本号。
万字复盘 Codex:一个在模型公司如何做产品的「典型」故事
Codex 的发展经历多次战略转向:从早期云端 Agent(Codex Cloud)因配置复杂、交互僵硬而未获市场认可,到团队转向本地终端形态并彻底重写底层 Agent 架构;其演进反映模型能力跃迁(如推理模型 o1)如何倒逼产品形态重构,也揭示在模型快速迭代背景下,企业需容忍内部多路径探索,并通过跨职能协作(产品、工程、研究员)将研究能力转化为可交付系统。
刚刚,Anthropic推出个人智能体Claude Duet:opus 5.5 驱动
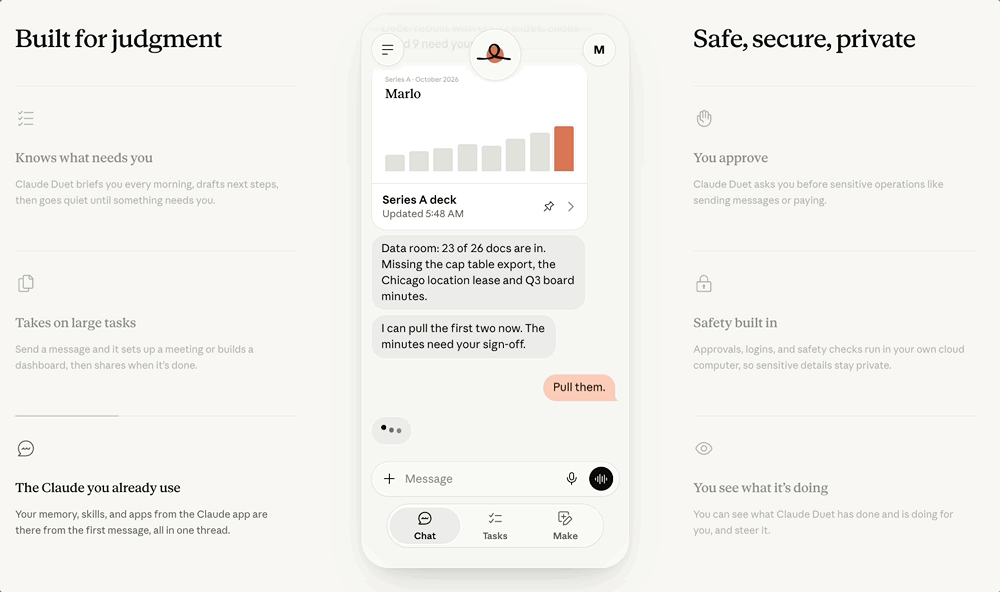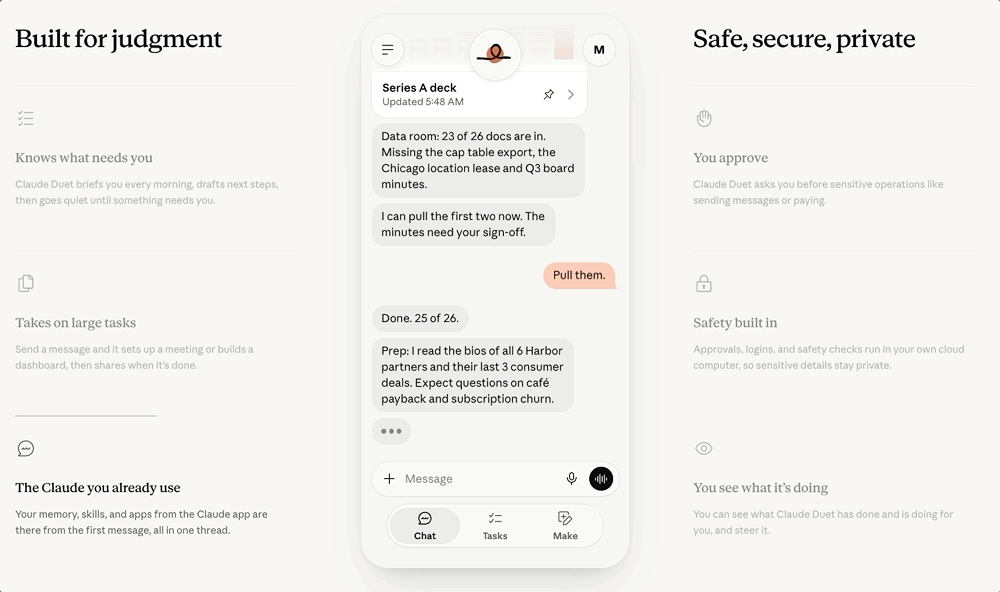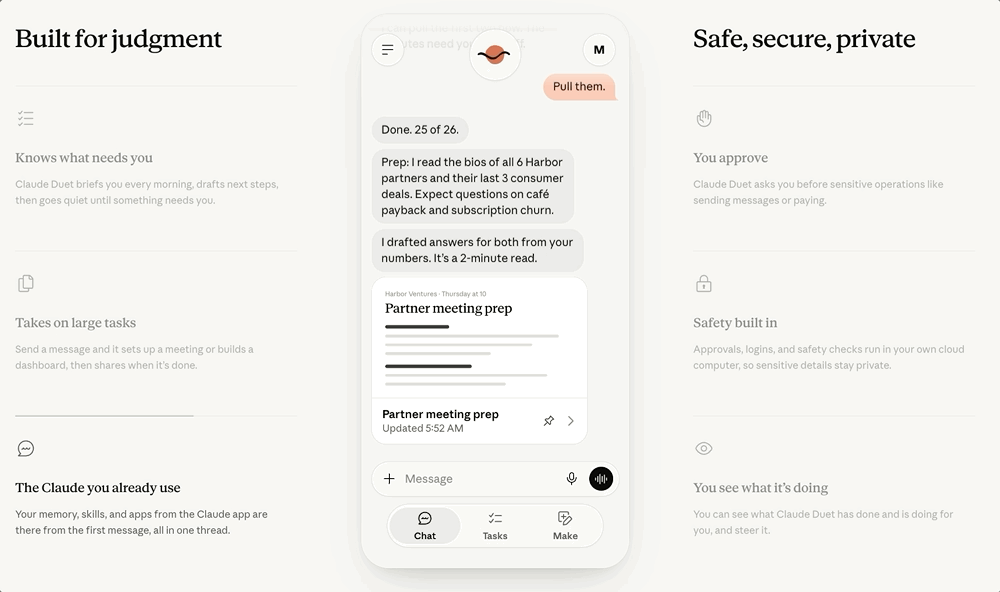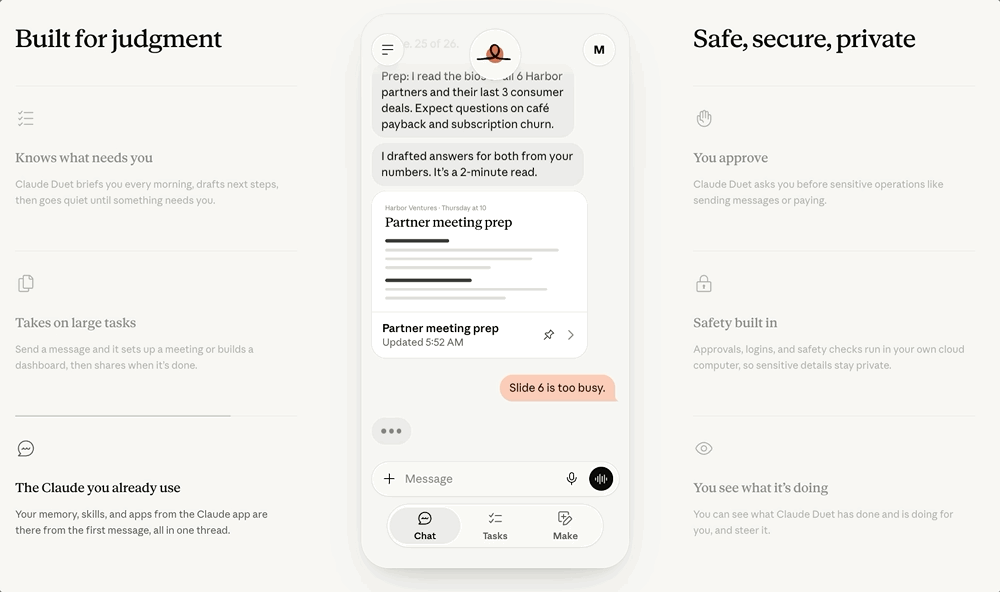
Anthropic正式发布个人智能体Claude Duet,由Claude Opus 5.5驱动,支持后台虚拟机运行、6000+工具接入及虚拟卡支付。目前仅向美国地区Claude Pro/Max用户开放候补名单,具备任务分级响应、安全权限隔离与关键动作人工确认机制。
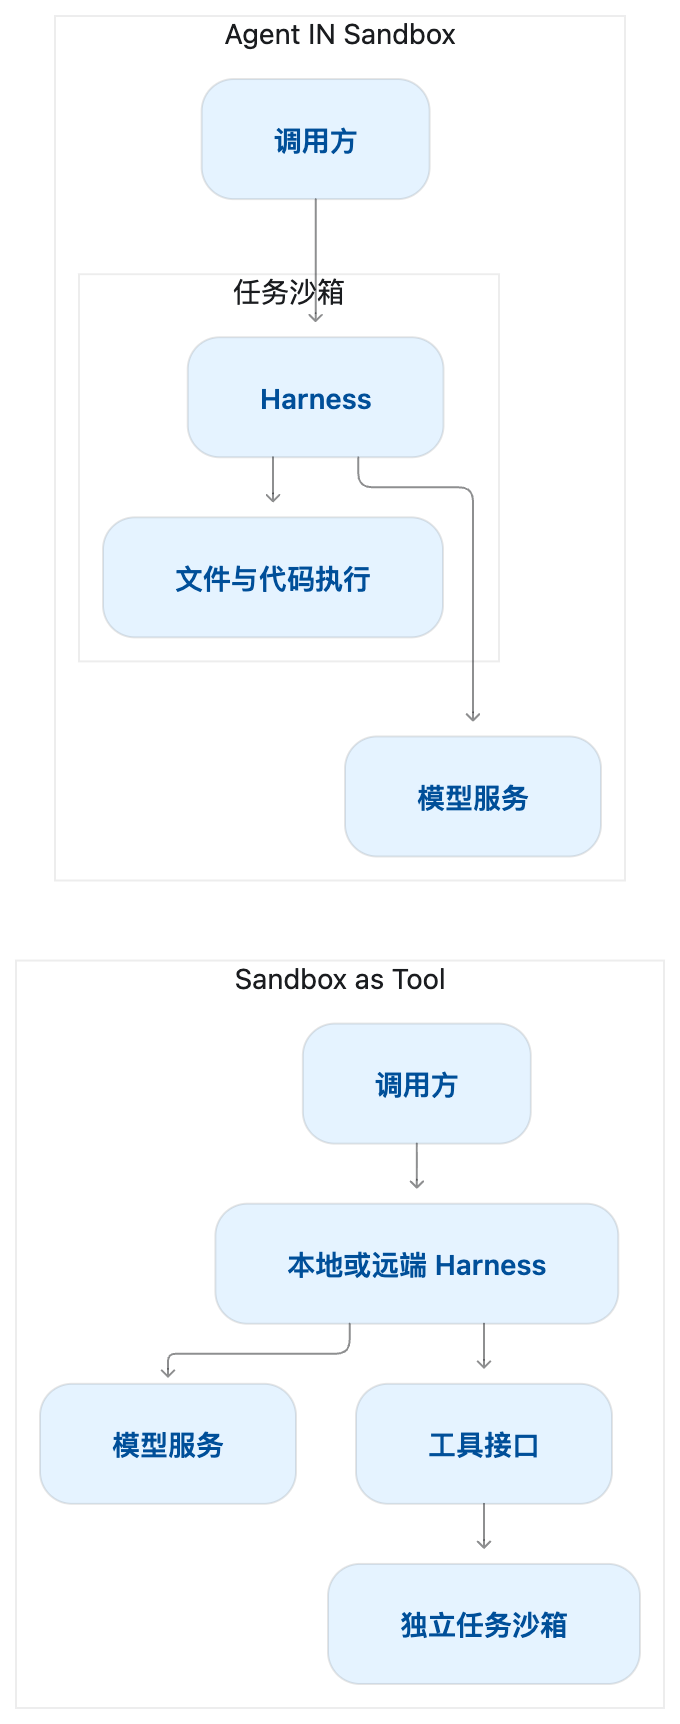
Agent as a Service:驱动 Personal Agent 与企业智能体的服务架构
文章提出 Agent as a Service 架构,以统一支持 Personal Agent 与企业智能体的持续任务交付。核心在于解耦 Harness(推理控制)、Context/Memory(状态管理)与工具执行(Hands),通过稳定任务标识、云端状态服务和 Sandbox as Tool 模式实现跨环境续做。架构强调任务生命周期独立于运行实例,支持推理与执行资源按需调度、权限分层管控及长时工具调用的挂起恢复。
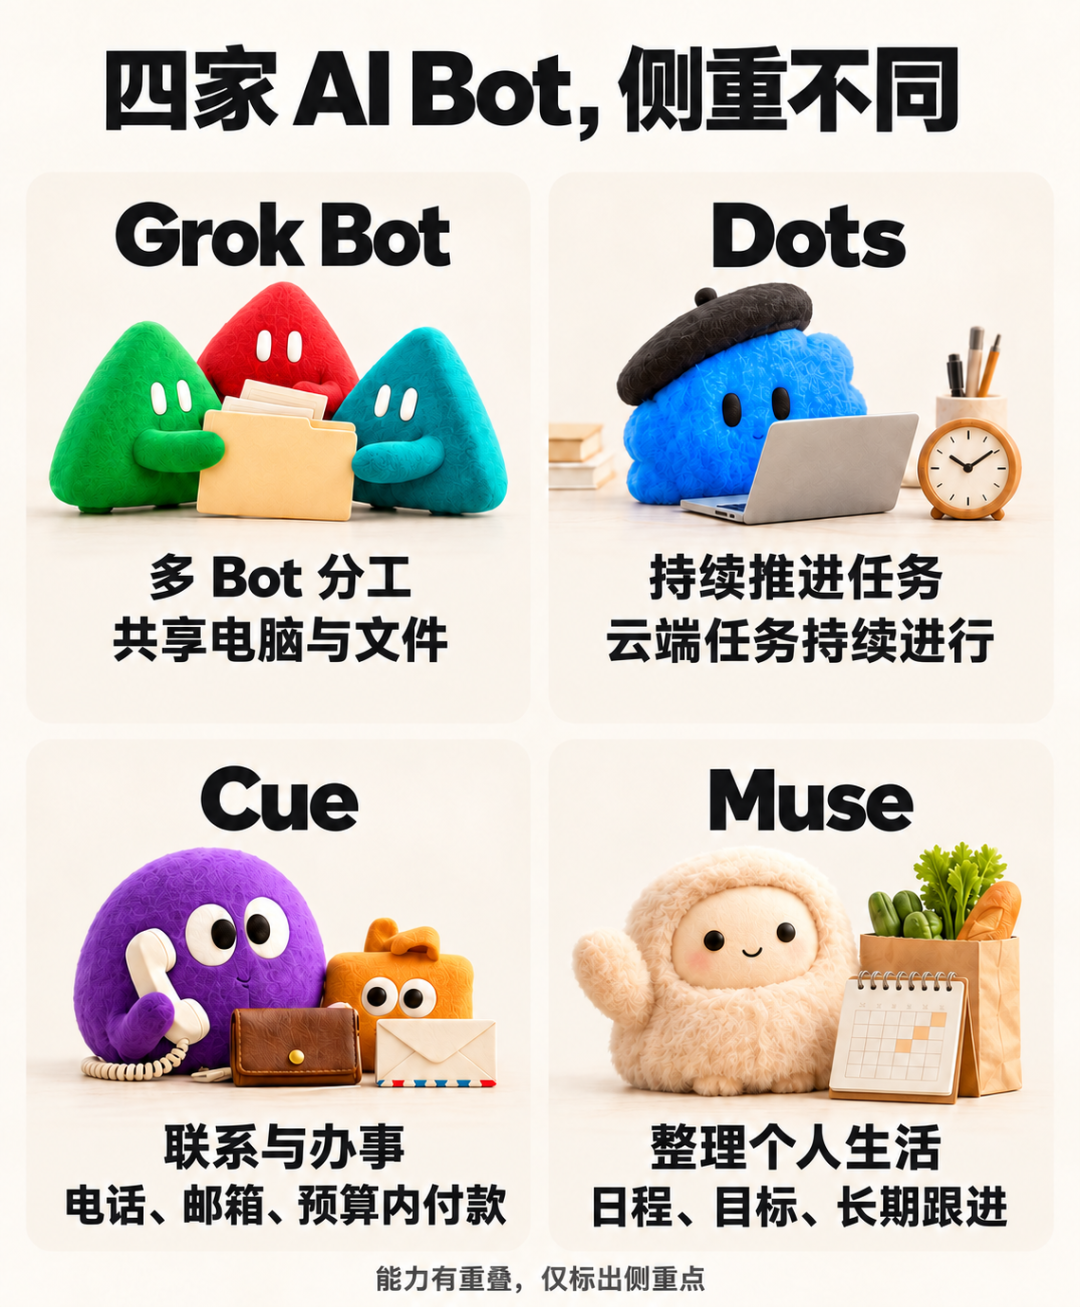
Grok Bot、Dots、Cue、Muse:四家 AI Bot 到底有什么不一样?
本文对比 xAI Grok Bot、OpenAI Dots、Manus Cue 和 Meta Muse 四款 AI Bot 的核心差异:Grok Bot 强调多 Bot 协作与共享云电脑;Dots 聚焦单任务长周期推进与状态延续;Cue 配备独立邮箱、电话、钱包等现实世界接口;Muse 专注私人生活场景中的零散事务与长期目标管理。四者共同指向 Personal Agent 的不同实现路径。
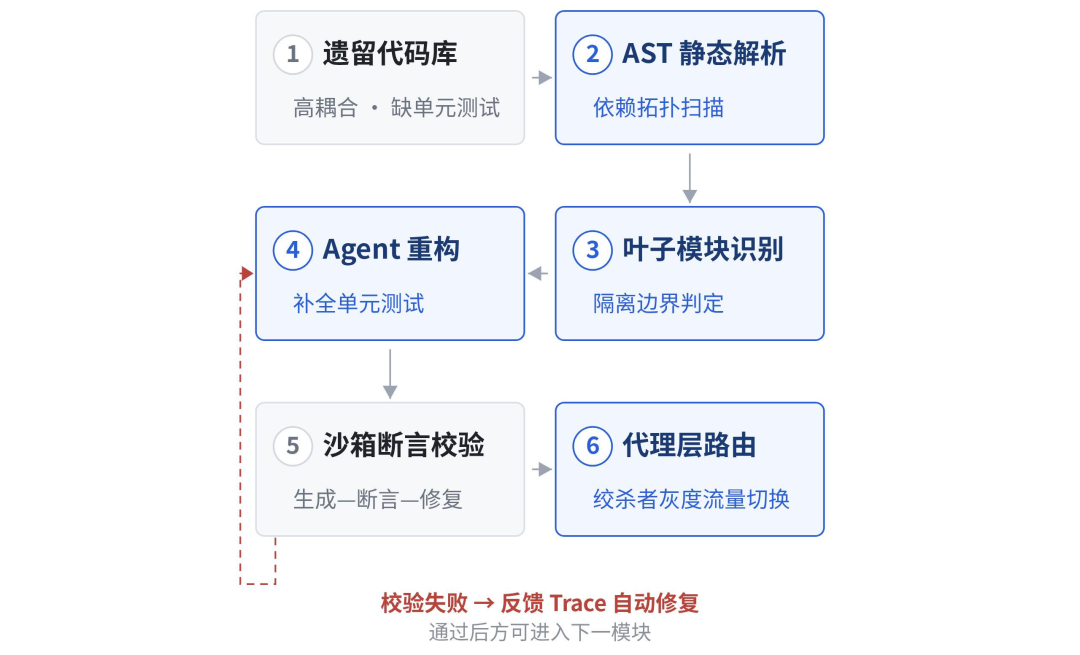
基于AST与LLM的遗留代码重构:绞杀者模式自动化实践
本文提出“AST静态解析+代码Agent局部重构+沙箱闭环校验+绞杀者代理层灰度路由”的渐进式遗留系统重构路径。在十万行级电信BSS模块实践中,实现解耦自动化率72.0%、回归故障率从4.8%降至0.3%,验证了该方法在高耦合、低测试覆盖率遗留系统中的工程可行性。