ESP-Claw 和小智 AI有什么区别
本文对比乐鑫官方的 ESP-Claw 与社区驱动的小智 AI 在架构设计、运行机制与适用场景上的根本差异:ESP-Claw 将 Agent 调度中心嵌入芯片,强调事件驱动与规则优先;小智 AI 则采用瘦终端+服务端语音流水线模式,聚焦低延迟流式交互与全链路可插拔。二者在芯片支持、语音能力、部署复杂度及工程可控性上形成明确取舍。
项目出身与生态定位
之前有网友推荐小智AI做语音助手,我研究了一段时间,现在基本上搞清楚了原理。在 ESP32 上做 AI 助手,有两条路线:一条是乐鑫官方的 ESP-Claw,一条是虾哥的 xiaozhi-esp32。两块板子跑起来都能交互(小智是语音对话,ESP-Claw 默认走 IM 文字交互),但它们的设计思路几乎相反,适合干的事也不一样。
这篇把两条线的内部结构拆开讲清楚。原理部分对照了双方源码和官方文档。
| ESP-Claw | 小智 AI | |
|---|---|---|
| 出品方 | 乐鑫官方(espressif/esp-claw) | 固件:虾哥(78/xiaozhi-esp32);服务端:社区版 xiaozhi-esp32-server(华南理工刘思源教授团队主导) |
| 开源协议 | Apache-2.0 | 固件 MIT;服务端 MIT |
| 代码量/热度 | 约 2.2k star、470 fork,759 次提交 | 固件约 30.2k star、7.1k fork;服务端约 10.7k star、3.6k fork |
| 本体语言 | C(ESP-IDF 组件)+ Lua 动态层 | C++(ESP-IDF) |
| 支持的芯片 | ESP32-S3 / P4 / C5 / S31 | ESP32 / C3 / C5 / C6 / S3 / P4 / S31(需 IDF 6.1+) |
| 支持的板子 | 官方主力是 S3,另有 P4 等,专属开发套件 | 138 个板级目录、171 个固件发行版本,S3-BOX-3、M5Stack CoreS3 等 |
| 官方云服务 | 无,自己配模型 Key | 有,xiaozhi.me 注册后免费用 Qwen 实时模型 |
这张表能看出一个大致格局:ESP-Claw 是乐鑫官方下场、工程化程度高但还很年轻(2.2k star);小智是社区驱动、热度高出一个数量级(固件 30k+ star),生态和板型支持都更成熟。(表中 star / fork 数据截至 2026-09-26)
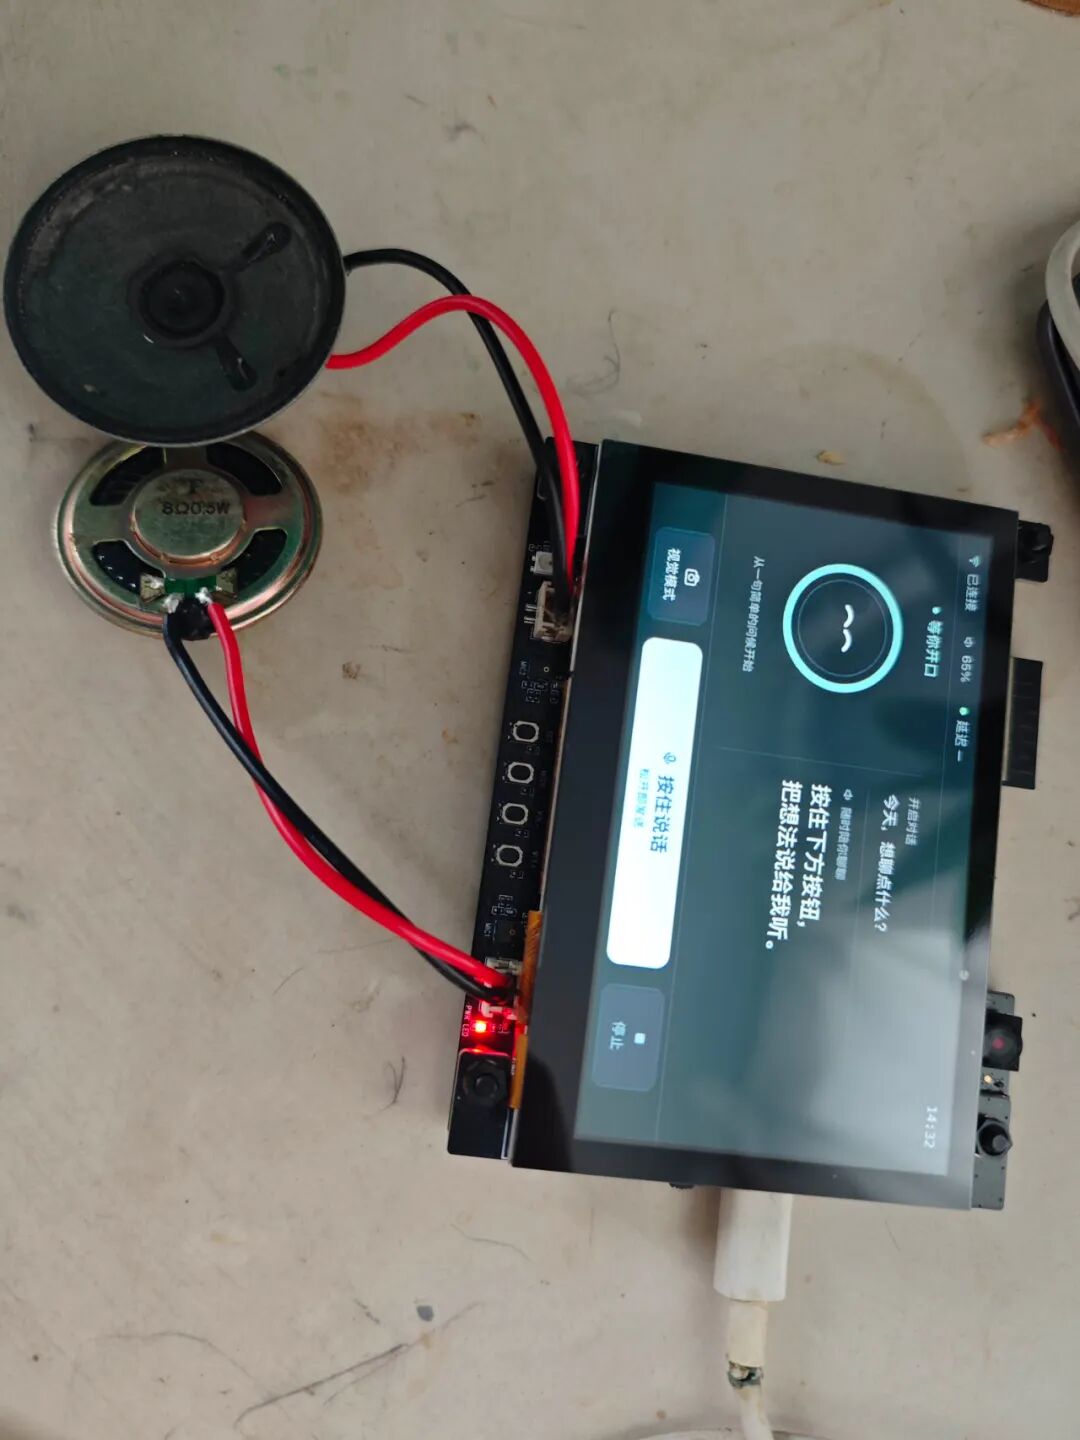
这两条路线都能跑在乐鑫的 ESP32-S31-Korvo-1 上——一块 4.3 寸 800×480 触摸屏、双麦、带摄像头、能接喇叭的板子。下面这张图就是它实际跑起来的样子,外接了小喇叭,屏幕上是一个语音助手界面:
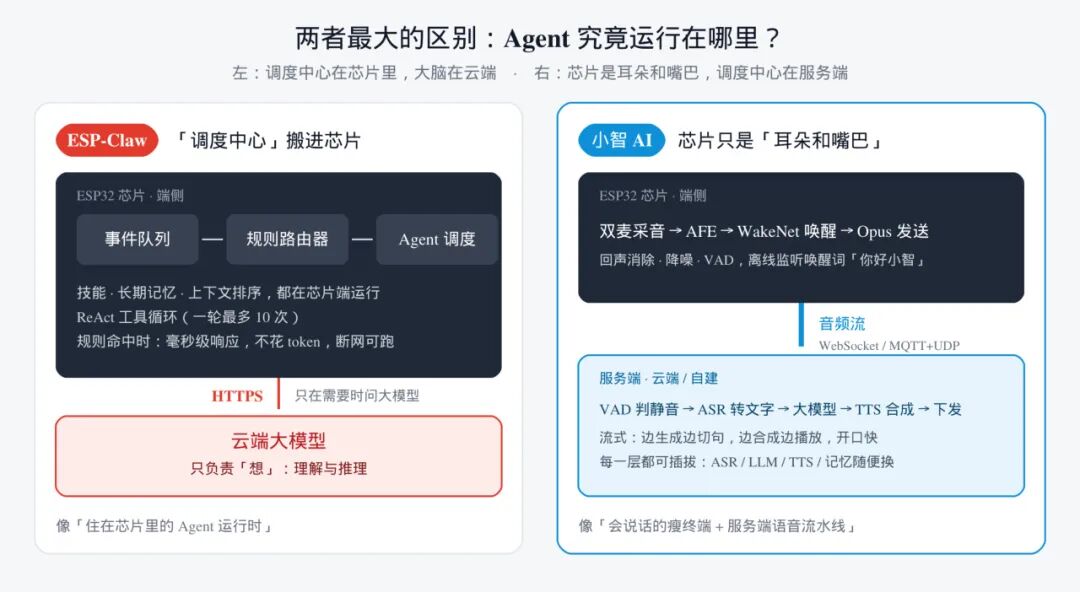
核心架构差异
最核心的一句话:
ESP-Claw 是把 Agent 的"调度中心"搬进了芯片,但大脑(大模型)还在云端;小智是把芯片做成大脑的"耳朵和嘴巴",调度中心在服务端。
一个像"住在芯片里的 Agent 运行时",一个像"会说话的瘦终端 + 服务端语音流水线"。
ESP-Claw 的运行机制
ESP-Claw 的本体是 C 写的 ESP-IDF 组件,Lua 只是上层的脚本层。它的骨架不复杂。
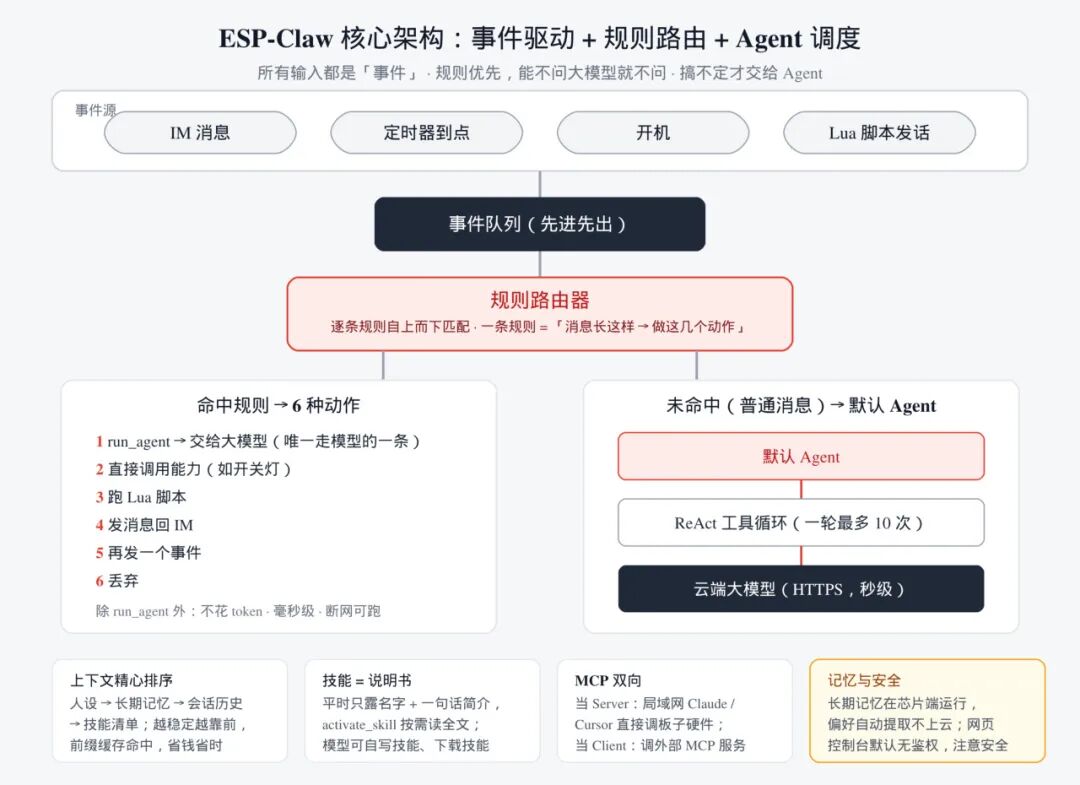
它把一切都当成"事件"。 IM 发来一条消息是事件,定时器到点是事件,开机是事件,Lua 脚本发句话也是事件。所有事件先进一个队列,后台有个路由器拿规则从上往下比对。
这个路由器是精髓。一条规则就是"如果消息长这样,就做这几个动作,不用问大模型"。比如仓库自带的一条规则:在 IM 里发 /session xxx,路由器直接调能力处理掉,再把结果发回——全程不花一个大模型 token。
规则的动作一共 6 种,最关键的是 run_agent(交给大模型),另外 5 种(直接调能力、跑 Lua 脚本、发消息、再发个事件、丢弃)都不经过大模型。所以"开关灯、定时"这类动作可以写成规则,毫秒级响应,断网也能跑。
那什么时候找大模型?没有任何规则命中、又是条普通消息时,就交给默认的 Agent。这个 Agent 是个 ReAct 式工具循环:把上下文拼好发给云端大模型,模型要调工具就调,一轮最多调 10 次,直到给出最终回复。
上下文是精心排过序的。 人设(性格、名字、用户偏好)在最前面,然后是长期记忆、会话历史、技能清单。原则是"越稳定的越靠前,历史只追加不改写"——这样云端接口的前缀缓存能一直命中,省钱也省时间。官方还强调长期记忆完全在芯片端运行,偏好习惯从对话里自动提取、不上云。
技能是随装随用的说明书。 一个技能就是一个 Markdown 文件,平时模型只看到名字和一句话简介,要用时调 activate_skill 读出全文。模型还能自己写新技能、去技能中心(Skills Lab)下载、改路由规则。所以"对话即编程"这件事,ESP-Claw 是认真的。
MCP 是双向的。 板子既能当 MCP Server(局域网里的 Claude Desktop、Cursor 可以直接调用板子的硬件能力),也能当 MCP Client 去调别的 MCP 服务。
但它没有语音链路。 想做语音助手,得自己补唤醒、回声消除、识别、合成这一整套,框架只提供一个 Lua 录音放音模块。
小智 AI 的运行机制
小智分两半:设备端固件 xiaozhi-esp32(C++),加服务端 xiaozhi-esp32-server(Python/Java/Vue,社区开源版)。官方云 xiaozhi.me 的服务端不开源,要完全掌控就自己搭社区版服务端。
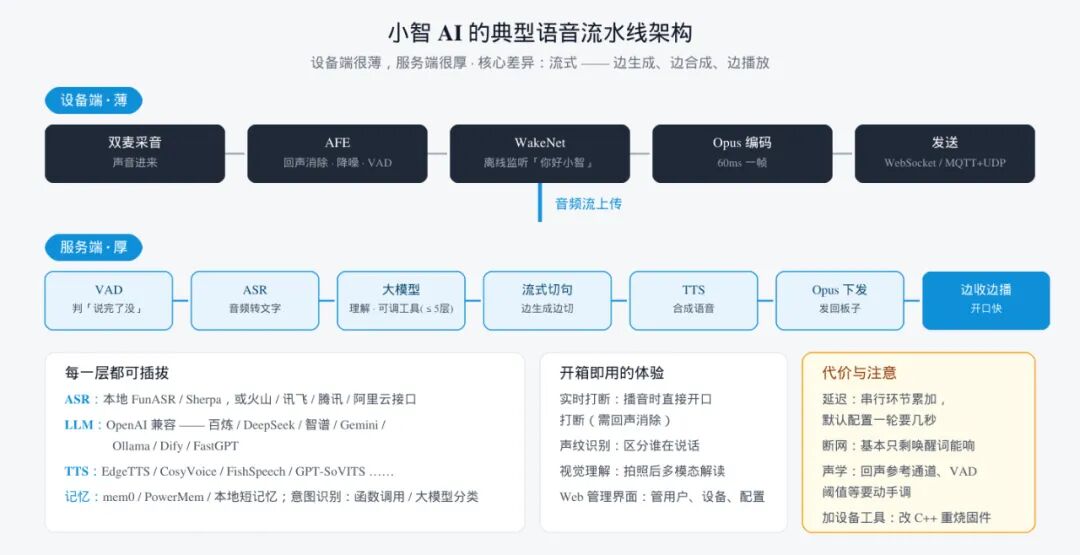
和 ESP-Claw 相反,小智的设备端很薄,服务端很厚。
板子上的事:双麦采音,过 AFE(回声消除、降噪、VAD),WakeNet 离线监听唤醒词"你好小智"(可自定义),命中后把音频用 Opus 编成 60 毫秒一帧,走 WebSocket 或 MQTT+UDP 发给服务端。之后就没了。听清没有、说的是什么、怎么回答、怎么说出来,全在服务端。
服务端是一条流水线:VAD 判断"这句话说完了没"(静音若干毫秒算说完)→ ASR 把音频流转成文字 → 大模型理解、可能要调工具 → 把回复流式地边生成边切句 → 每句送 TTS 合成 → 编成 Opus 发回板子,板子边收边播。
这个"流式"是小智和 ESP-Claw 最大的不同。ESP-Claw 是一次性生成完整段文字再发;小智是大模型吐一点、切一句、合成一句、播一句,所以开口快。服务端还支持声纹识别(区分谁在说话)、视觉理解(拍照后用多模态模型解读)。
打断也做得细。支持"实时模式":它自己在播的时候,用户直接开口就能打断,不用等它说完——前提是设备端或服务端做了回声消除。
服务端每一层都可插拔。 ASR 能选本地的 FunASR、Sherpa,也能接火山、讯飞、腾讯、阿里等云接口;LLM 走 OpenAI 兼容接口,百炼、DeepSeek、智谱、Gemini、Ollama、Dify、FastGPT 都能接;TTS 有 EdgeTTS、CosyVoice、FishSpeech、GPT-SoVITS 等一长串;记忆能在 mem0、PowerMem、本地短记忆之间切换;意图识别有函数调用和大模型分类两种。社区版服务端还带一个 Web 管理界面,能管用户、设备、配置。
工具的玩法也不一样。小智的工具最多递归 5 层,而且工具可以选"直接念结果"(不回头问大模型)或"只记录"。这在语音场景很实用——每多问一次大模型,用户就多等一拍。
适用场景与能力取舍
抛开具体场景,客观说两条线的长短。
ESP-Claw 适合:
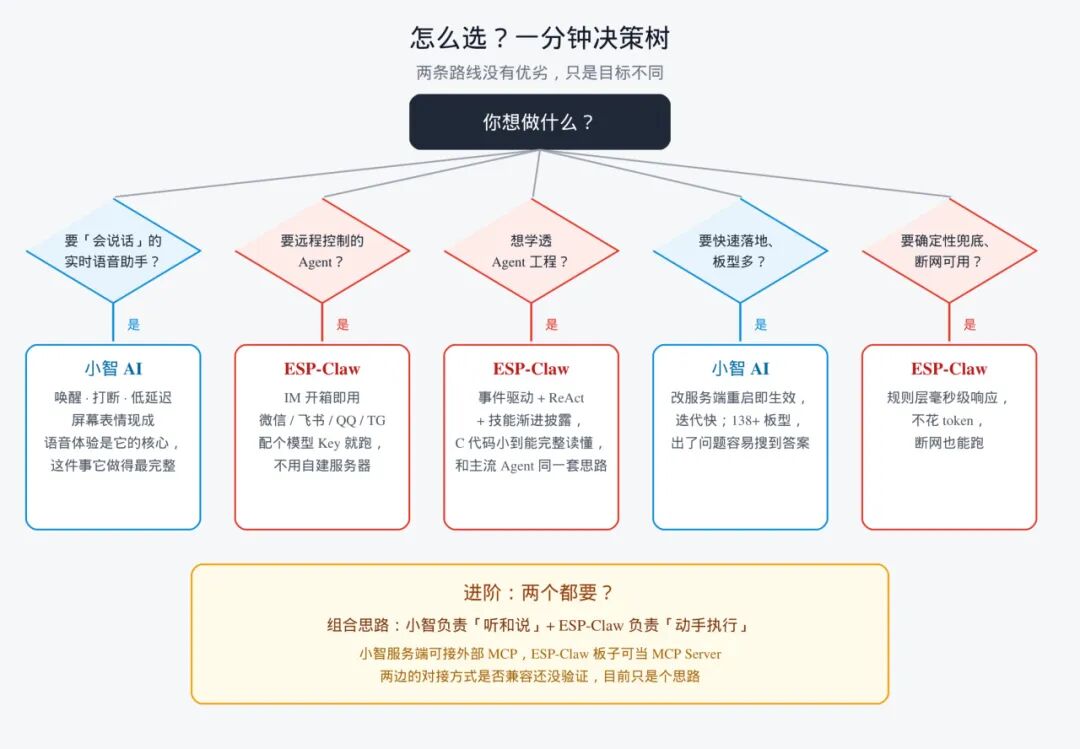
- 想快速搭一个"能远程控制的 Agent",喜欢 IM 交互(Telegram、微信、飞书、QQ 都开箱即用),不想自建服务器,配一个模型 Key 就能跑。
- 想研究 Agent 工程:事件驱动、ReAct 工具循环、技能渐进披露、上下文为缓存排序、子 Agent、记忆,这套设计和 Claude Code 这类主流 Agent 是同一套思路,而且是 C 写的,规模小到能完整读懂。
- 常用指令可以写成规则,不花 token、断网也能跑,适合"规则优先、确定性兜底"的场景。
- 想做"AI 能直接操作的硬件":MCP 双向,板子既能被上位机 AI 调用,也能调别的 MCP 设备。
ESP-Claw 的短板:
- 想做语音助手,得自己补整条语音链路。
- 每个 Agent 请求都是多轮 HTTPS,耗时秒级;断网后只剩规则、定时任务和 Lua 脚本能跑。
- 板上资源紧:事件队列、Lua 脚本大小、异步并发都有硬上限,长历史和大工具清单都吃 PSRAM。
- 安全面要注意:网页控制台默认没有鉴权,API Key 存在芯片里,模型能写文件、改规则、执行命令、重启设备,建议只在可信局域网用。
- 比较年轻,2.2k star,S31 这类新平台还要自己扛驱动问题。
小智适合:
- 目标就是一个"会说话的 AI 助手"。语音体验是它的核心,唤醒、打断、低延迟、屏幕表情都现成。
- AI 逻辑全在服务端,改完重启服务就生效,迭代快;每一层都可插拔,模型随便换,能全本地也能全云端。
- 板型支持最全(138 个厂商目录),S31-Korvo-1 有官方板级支持,出了问题容易搜到答案。
- 有现成的 Web 管理界面、声纹识别、视觉理解、RAG 知识库。
小智的短板:
- 离不开服务端:自建要维护一个后端服务(Docker 或源码部署,全功能建议 4 核 8G),断网基本只剩唤醒词能响。
- 延迟是一串串行环节加出来的(VAD 判静音 → 识别 → 等大模型首包 → 合成首句 → 下发),默认配置下实测一轮要几秒。
- 声学问题难:回声消除参考通道、降噪在新芯片上的兼容性、回声自打断、VAD 阈值——这些都不是改提示词能解决的。
- 加一个设备工具要改 C++ 重新烧录固件。
JOTO 企业落地观察
- ESP-Claw 的事件驱动+规则路由架构,对企业部署轻量级边缘智能体具有明确参考价值:其“规则优先、断网可用”的设计,适用于工业现场对确定性响应要求高的设备控制场景,但需额外投入语音链路工程。
- 小智 AI 的服务端流水线模式,凸显了语音类智能体对 RAG 知识工程与声学治理的强耦合性——企业若选择该路径,必须将 VAD 阈值调优、回声消除适配、TTS 语调一致性纳入标准交付项,而非仅关注大模型替换。
- 两类系统在 MCP 协议支持上的差异,直接影响企业构建统一 AI 设备中枢的能力:ESP-Claw 的双向 MCP 更利于嵌入现有工控网络,而小智依赖服务端桥接,需额外设计设备接入网关层。
- 小智服务端的全链路可插拔特性,为企业开展 AI 安全治理提供了结构基础——ASR/LLM/TTS 各层可独立审计、替换与沙箱隔离,但同时也抬高了跨层协同测试与合规验证的成本。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们