一机三吃:AI工作站+创作机+游戏本 ,联想 YOGA Pro 15 RTX Spark 深度评测
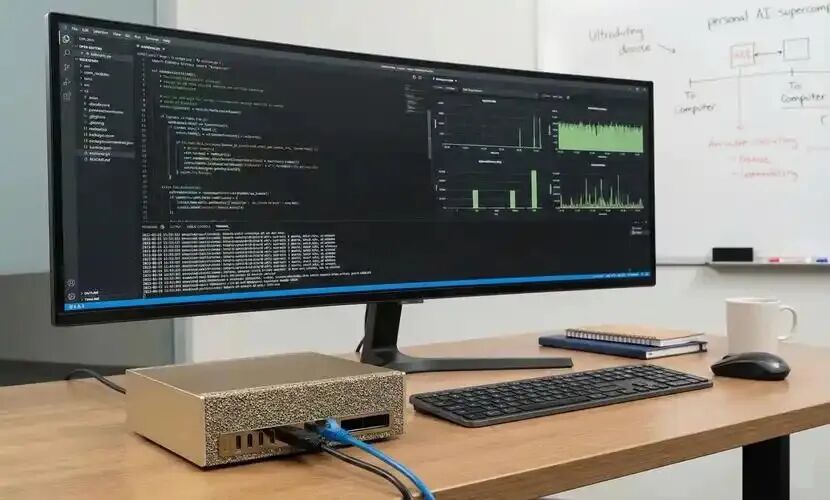
联想 YOGA Pro 15 RTX Spark 售价 42999 元,配备 128GB 统一内存与最高可分配 96GB 显存,整机仅 1.75kg、16.7mm 厚。其 3DMark Steel Nomad 跑分仅 3010 分,性能对标桌面 RTX 5070,但胜在容量确定性:支持 27B~32B 模型本地加载、3 分 40 秒 LoRA 微调、ComfyUI 运行 Flux2.DEV(32B)不崩溃,并原生运行 Arm64 版 Blender、DaVinci Resolve、Photoshop 等专业软件。
一、先把"输"这件事说清楚
不回避,直接上数据。
3DMark 三项:
| 项目 | 结果 | 含义 |
|---|---|---|
| Port Royal(光追) | 8689 分 / 40.23 fps | 大致等于满功耗版 RTX 5070 笔记本 GPU |
| Speed Way(光追) | 2945 分 / 29.45 fps | 同上 |
| Steel Nomad(纯光栅) | 3010 分 | 略超 RTX 5070 笔记本 GPU |
Blender Cycles(Arm64 原生):
| 场景 | 得分 | 对比桌面 RTX 5070 |
|---|---|---|
| Classroom | 1334.19 | 基本持平 |
| Junkshop | 1493.03 | 基本持平 |
| Monster(复杂场景) | 1870.65 | 明显落后 |
看到了吗?小场景打得有来有回,一到 Monster 这种高面数、高纹理吞吐的复杂场景,就掉队了。
原因只有一个字:带宽。
这台机器的 LPDDR5X 统一内存,16 通道 256-bit,峰值 300GB/s,稳定 273.2GB/s。而一张桌面 RTX 5070 的 GDDR7 显存带宽是它的两倍以上。
带宽不够,就意味着高分辨率纹理、复杂几何体、大体量 BVH 结构都得排队。
所以它注定不是一台"渲染农场"。
如果评测到此为止,结论就是"溢价严重,不值"。但真正的故事从下一页开始。
二、它赢的那条赛道,叫"能不能装下"
来算一笔账,这是整篇文章最关键的推算。
一个 27B~32B 的模型,用 FP16 精度加载,光权重就占约 50GB。
你还要加上长上下文的 KV Cache——这是模型记住前文的关键数据结构,随对话长度线性膨胀。跑长文档、多轮任务时,它很快会把总占用推到 60~80GB。
于是出现了这样一条分水岭:
| 内存容量 | 结果 |
|---|---|
| 32GB | ❌ 跑不起来,直接出局 |
| 64GB | ⚠️ 能跑,但 KV Cache 一涨就紧张,长上下文随时爆 |
| 128GB | ✅ 游刃有余,长文档、多轮任务、多模型并存都不慌 |
这就是 128GB 存在的全部理由。
而且它还做了一件更聪明的事:在 NVIDIA App 里用一个滑块,把统一内存分配给 GPU 当显存用,最高可分配 96GB。不够时还能动态再要。
换句话说——你买的不是一台笔记本,是一张 96GB 显存的显卡,外加一台能带走的电脑。
市面上哪张消费级显卡有 96GB 显存?没有。专业卡有,但那是一块砖头,需要插在服务器里,还要配一套供电和散热。
而它被塞进了 16.7mm、1.75kg 的机身。这就是那 42999 元真正买的东西。
三、AI 实测:34.39 tokens/秒,是什么水平
AgentPerf Local 实测(Llama.CPP + DFlash + Qwen3-27B 稠密模型):
- 负载:8 个任务、168 轮真实对话,总输入超 200 万 token,输出约 3.1 万 token
- 结果:约 20 分钟跑完,解码速度 34.39 tokens/秒
34.39 tok/s 是什么概念?比你阅读理解的速度快,比你打字的速度快得多。一个 27B 的稠密模型——注意是稠密,不是 MoE,每生成一个 token 都要读完整份权重——能跑到这个数,日常办公、代码、写作完全够用。
其他几组更直观的:
| 测试 | 结果 |
|---|---|
| PHI 3.5 平均首字延迟 | 0.27 秒 |
| PHI 3.5 输出速度 | 73.45 tokens/s |
| LLaMA-3.1 输出速度 | 接近 50 tokens/s |
| MLPerf Client 最复杂"大量文本摘要" | 73.4 TPS |
| 智能体平均工具调用耗时 | 约 5.3 秒 |
| 1024×1024 出图 | 1.64 秒/张(约 36 张/分钟) |
0.27 秒的首字延迟,这个数字比跑分重要得多。它意味着你敲完问题,字就开始往外蹦,没有那种"转圈等一下"的停顿感。
这是本地 AI 和云端 AI 体验上最大的分水岭——不是快慢,是"有没有延迟"。
四、LoRA 微调 3 分 40 秒:这才是"入场券"的意思
我认为整篇评测里最有分量的一组数据,是这一条。
测试对象:Qwen3.5-9B 挂 LoRA 适配器
数据集:从 NVIDIA FrameView 用户手册派生的问答数据集
参数:3 轮训练、学习率 0.0005、batch size 4、梯度累积 1
目标:让模型学会 ASD-STE100 简化技术英语风格
耗时:3 分 40 秒。
效果呢?基础模型回答冗长、格式细节还经常出错;微调之后,明显收敛到目标风格,回答简洁、快速、准确。
你得明白这意味着什么。以前做一次像样的微调,流程是:申请 GPU 服务器 → 排队 → 配环境 → 跑 → 等 → 出结果不满意 → 再来一轮。一次迭代周期按天算。
成本不在于算力,在于那套流程带来的心理摩擦——你不会为了改一个标点而重新排一次队。
而当微调只要 3 分 40 秒、就在你腿上放着的时候,迭代的方式彻底变了。你会愿意试 20 个版本,因为试错的成本几乎为零。
这才是"入场券"三个字真正的含义。不是"我也能跑大模型了",而是"我终于可以像写代码一样,快速试错地调模型了"。
五、创作实测:那个"必崩"的组合,它跑完了
ComfyUI + Flux2:
| 模型 | 单张耗时 |
|---|---|
| Flux2.DEV-NVFP4(32B / 320 亿参数) | 41.97 秒/张 |
| Flux2.Klein 4B | 14.12 秒/张 |
注意第一个。Flux2.DEV 是 32B 模型,此前在很多高端独显上跑这个组合会直接崩——不是慢,是崩,显存不够。它在这里跑完了,41.97 秒一张。
视频生成:LTX 2.5 蒸馏版 NVFP4 量化,8 步生成 1280×720 / 120fps短片,约 80 秒。
专业渲染:V-Ray 6 得 RTX 模式 2909 分 / CUDA 模式 2438 分;Blender 可无损加载超大场景,不再显存溢出降速;替换 DLL 后可开启 DLSS 4.5 光线重建——相比 OptiX 降噪,反馈几乎无延迟,细节更丰富、光照更准确。
Adobe 全家桶原生跑:PS 28.0 生成式擦除几乎瞬时;Premiere 音频增强跑 TensorRT for RTX,数十秒的会议录音 57 秒完成对白/音乐/环境声分离;物体遮罩用 TensorRT 跟踪,回放帧率没明显掉。
这里有个容易被忽略的关键:这些软件都是原生 Arm64 版本——Blender、DaVinci Resolve、Affinity、Photoshop 全都有,GPU 代码根本不需要转译。
损失只发生在 CPU 指令层,不发生在你最在乎的 GPU 算力上。这是 ARM PC 这次能站住的底层原因。
六、游戏:8 款 3A,1080p 全部破百
8 款主流 3A(最高画质 + 最高光追,支持的都开路径追踪,含《黑神话:悟空》《赛博朋克 2077》):
- 1440p:几乎所有游戏实现或接近 100+ fps
- 黑神话、2077 在 1440p 约 100fps,稍微降一档画质或光追就能轻松破百
- 1080p:8 款全部 100+ fps
其中《漫威争锋》用的是 Arm64 Beta 体验版——这又是个信号:厂商开始主动适配了。
DLSS 5体验用《NBA 2K27》:皮肤次表面散射、面部毛发受光、球衣与篮球的接触阴影都有明显增强,而且是用已渲染帧 + 运动矢量去补,不破坏场景结构和角色身份。
注意一个细节:它是 8 款里 6 款走 x86 兼容层跑出来的成绩。能到这个帧数,说明 Prism 兼容层的效率比想象中好。
七、代价:续航、温度,和那颗雷
代价一:电池。92.5Wh,游戏一小时出头就没了;但视频能撑 9 小时 38 分。这个取舍其实很清醒——它不是游戏本,是能打游戏的工作站。
| 场景 | 模式 | 续航 |
|---|---|---|
| 赛博朋克 2077(高负载光追) | 平衡 | 1 小时 36 分 |
| 赛博朋克 2077 | 性能 | 约 1 小时 |
| CS2 | 平衡 | 约 1 小时 49 分 |
| CS2 | 能效 | 2 小时 40 分 |
| 持续视频播放 | 平衡 | 约 7.5 小时 |
| 持续视频播放 | 能效 | 9 小时 38 分 |
代价二:温度。双烤(FurMark + CPU-Z):GPU 45W + CPU 15W ≈ 稳定 60W,峰值超 80W,整机约 106W。室温 25℃ 持续一小时后热成像:高温点集中在机身中部和铰链出风口,键盘中部最高 45.3℃,摸着有热感;但两侧主要操作区控制在 35℃ 左右。
热的地方你本来也不碰——这个散热设计是懂行的。
代价三:ARM 兼容性。测下来大部分常用程序状态优秀,但 GPU-Z 这类部分 x64 程序直接跑不起来。原因不难理解:Prism 兼容层只转译 CPU 指令,那些深度挂钩底层驱动的工具类软件最容易翻车。
对普通用户影响不大。
但如果你工作流里有一堆小众行业软件——先列个清单,逐个确认。
八、所以,42999 到底值不值?
我的答案很明确:看你是谁。
✅ 该买的人:
- AI 开发者 / 科研人员:27B 稠密模型 + 长上下文 + 3 分钟微调,这套组合以前需要一台服务器
- 需要本地 AI 的内容创作者:ComfyUI 跑 Flux2.DEV 32B、Blender 出图、PR 音频增强,一条链路全闭环
- 数据不能出内网的行业(医疗/法务/金融/政企):这是核心刚需,不是加分项
- 要"零 Token 成本"的重度用户:一次买断,长期跑,不算 API 账
❌ 别买的人:
- 没有强 AI 需求的普通玩家:同样预算买游戏本,帧数翻倍还不用忍受兼容性问题
- 重度依赖冷门 x86 行业软件的人:兼容清单先过一遍,别赌
- 要长时间离电高性能输出的人:1 小时出头的游戏续航,注定了它是"插电用"的机器
一句话:它是一张入场券,不是终点机器。它让"想法 → 原型 → 训练 → 验证"这条链路,第一次能在便携设备上闭环。
九、最后
回到开头那个问题:一台四万三、跑分打不过桌面显卡的笔记本,凭什么?
因为过去我们衡量电脑,只有"快"这一个维度。而 YOGA Pro 15 RTX Spark 提出了第二个维度:装得下。
装得下一个 32B 的模型,装得下 80GB 的长上下文,装得下你那批永远不能上传的合同和病历,还装得进一个 1.75kg 的包里。
它不是最快的。但它是第一台让你在飞机上、在没信号的会议室里、在涉密办公区里,依然拥有完整 AI 工作流的个人电脑。
性能输给桌面 5070 是真的。但它能干的事,桌面 5070 一件都干不了。
这大概就是"One PC"这个说法,最诚实的一次落地。
JOTO 企业落地观察
- 企业部署 AI 工作站时,需重新评估“性能”与“容量确定性”的优先级——当模型规模突破 27B、KV Cache 占用逼近 80GB,统一内存架构的容量保障比峰值带宽更具实际价值。
- 这类系统对 RAG 知识工程的意义在于:本地化长上下文处理能力使私有知识库无需切片压缩即可参与推理,避免语义断裂,但要求企业提前验证文档解析与向量化环节的 Arm64 兼容性。
- AI 安全治理团队应关注其“零 Token 成本”特性带来的新风险面:本地模型微调门槛大幅降低,可能引发未经审批的模型变体在终端侧扩散,需配套建立轻量级模型签名与策略下发机制。
- FDE 驻场共创中,该设备可作为客户现场的“可信沙盒”,支撑涉密数据不出域前提下的原型验证,但需前置确认客户工作流中关键行业软件的 Arm64 支持状态,避免交付阻塞。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们