两台DGX Spark搭出一个DeepSeek:从开箱到跑通,一篇讲透
本文详细记录使用两台英伟达DGX Spark本地部署DeepSeek V4 Flash模型的完整流程,涵盖硬件选型依据、双机物理互联与网络配置、SSH免密集群搭建、vLLM推理引擎部署及性能调优要点,并列出QSFP接口Down、NCCL带宽不足、OOM和HuggingFace下载卡顿等常见问题的精准解决方案。
为什么选DGX Spark搭建DeepSeek V4 Flash
如果你是一个AI爱好者或开发者,想在本地跑大模型,又不想花几十万买数据中心级GPU,NVIDIA DGX Spark是一个很务实的选择。
它搭载了GB10 Grace Blackwell超级芯片,拥有128GB统一内存,单台就能处理最高2000亿参数的大模型。更重要的是,两台DGX Spark通过ConnectX-7网络互联后,内存合并为256GB,可以支撑高达4050亿参数的模型。DeepSeek V4 Flash是一个284B参数(激活21B)的MoE模型,正好落在这个能力范围内。
简单说:一台DGX Spark大约能跑200B以内的模型,两台组集群就能覆盖DeepSeek V4 Flash这个级别。
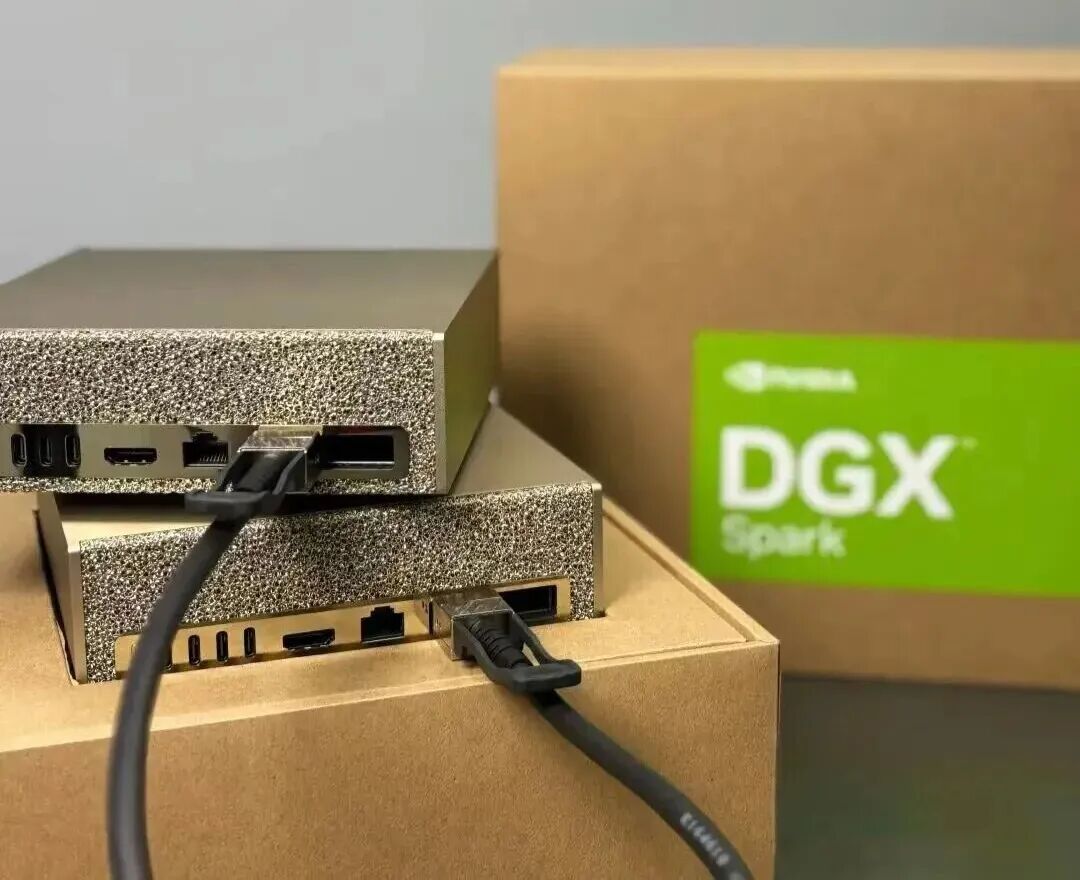
前期准备:硬件与网络要求
2.1 硬件清单
| 项目 | 数量 | 说明 |
|---|---|---|
| DGX Spark | 2 台 | 单台 128GB 统一内存 |
| QSFP 线缆 | 1 根 | 两台直连,200GbE 带宽(双机套装通常自带) |
| 显示器 + 键鼠 | 各 1 套 | 首次设置用,之后可远程 |
| 网线 | 2 根 | 接入局域网,用于 SSH 管理 |
| 电源适配器 | 2 个 | 随附,务必用原装 |
DGX Spark双机套装通常自带一根400G QSFP56线缆,直接连接两台设备的QSFP端口即可,无需交换机。
特别提醒:如果你需要额外购买QSFP线缆,务必选择标注“DGX Spark认证”的QSFP56线缆。市面上很多QSFP28线缆虽然外观相似,但带宽只有50Gbps,会被硬生生限制到四分之一的性能。这个坑很多人踩过,不要问我是怎么知道的。
2.2 网络环境
相同的用户名:两台系统上必须用同一个用户名登录
都能 SSH 访问:后续集群操作全部通过 SSH 完成
有 sudo 权限:需要配置网络和安装软件
稳定的互联网连接:首次设置需要下载系统更新和模型文件
第一步:单机开箱与初始化设置
两台DGX Spark需要先各自完成首次设置。
3.1 首次开机
DGX Spark通电后会自动开机。在开机之前,先把显示器、键盘、鼠标和网线都接好——设备一通电就开始初始化,没有“先通电再接外设”的窗口期。
首次设置时,你有两种访问方式:
本地设置:直接接显示器和键鼠,在设备上操作
网络设置:从另一台电脑通过浏览器访问,适合没有多余显示器的场景
新手推荐用本地设置,流程更直观。
3.2 完成初始化
开机向导会引导你完成:
选择语言和时区
连接Wi-Fi或有线网络
下载并安装系统更新(中途不要断电或重启,否则可能损坏系统)
创建用户名和密码
两台设备设置完成后,各自确认一下基本状态:
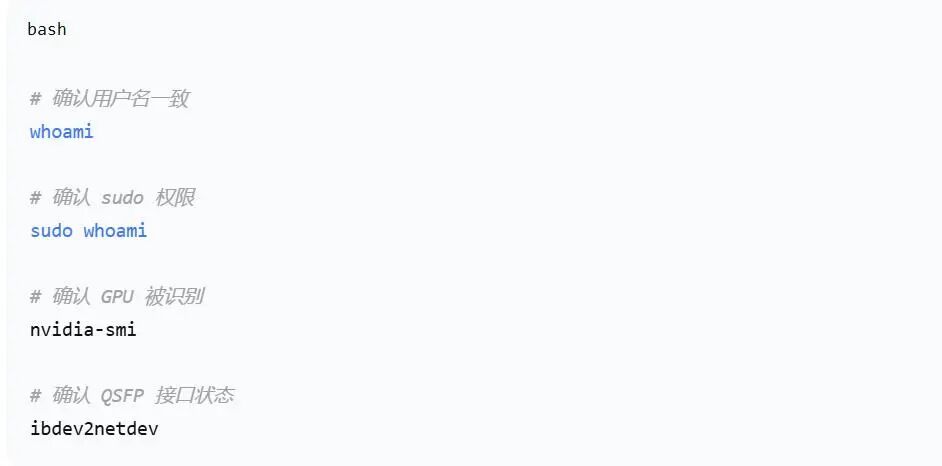
ibdev2netdev会列出所有RoCE接口。连接QSFP线缆后,你应该看到至少一个接口显示(Up)状态
ibdev2netdev第二步:两台Spark物理互联与网络配置
这是整个过程中最关键的一步。两台DGX Spark需要通过网络互联,才能像一台机器一样协同工作。
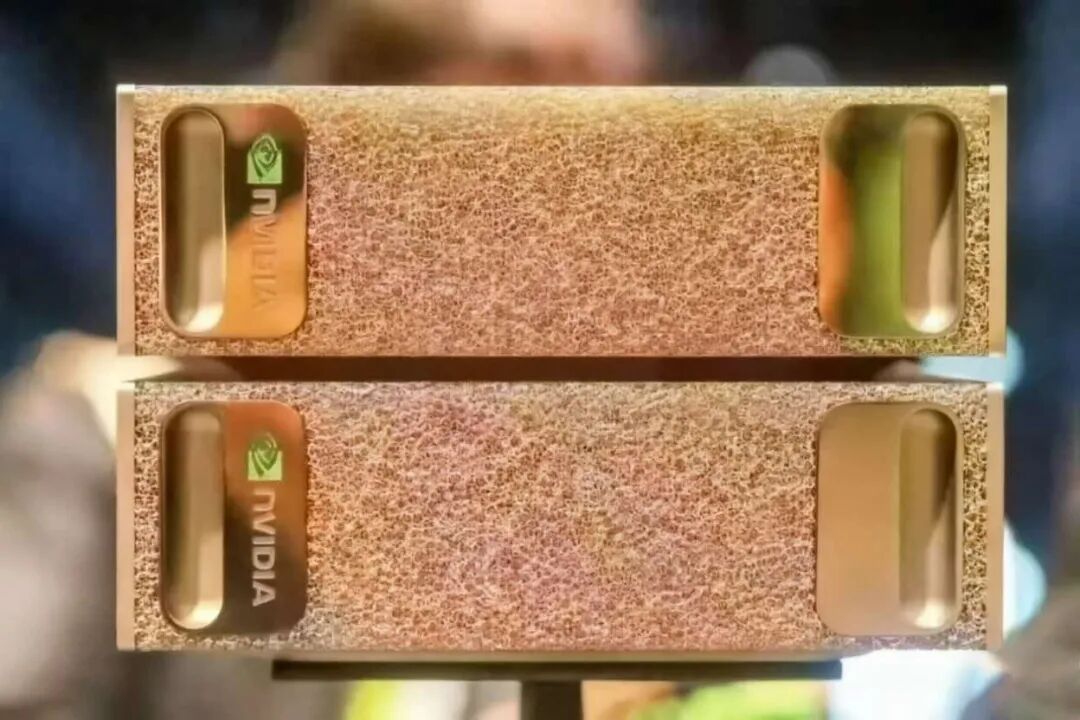
4.1 物理连接
用QSFP线缆连接两台DGX Spark的QSFP端口(任意一个端口都可以)。连好后,两台设备之间就建立了一条200GbE的高速直连链路。
4.2 配置网络接口
两台设备之间需要分配IP地址才能通信。NVIDIA官方推荐用netplan配置固定IP。
在Spark 1上,创建netplan配置文件:
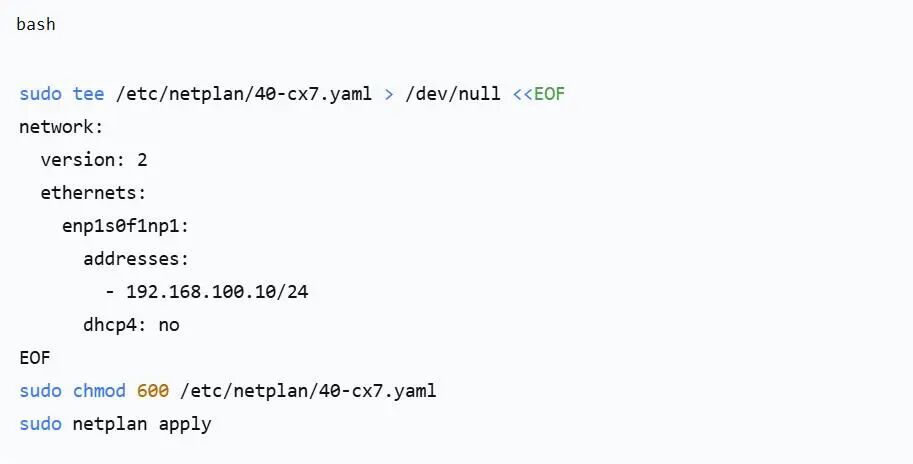
在 Spark 2 上,同样操作,但 IP 改为 192.168.100.11/24: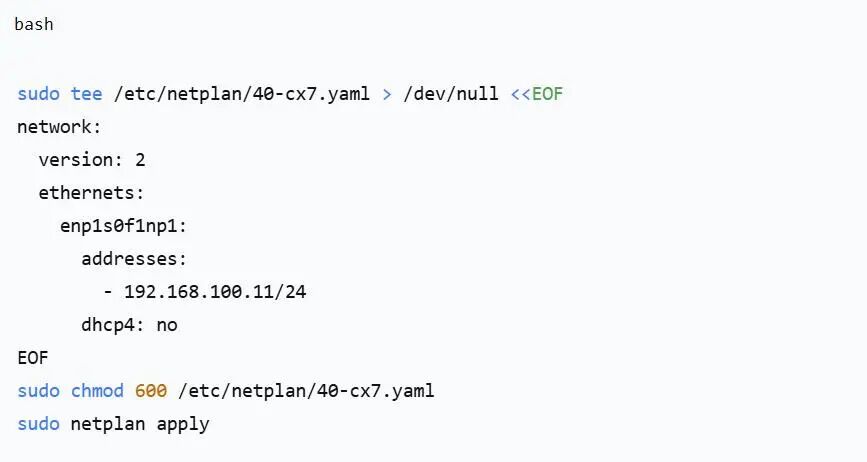
注意:接口名
enp1s0f1np1需要根据ibdev2netdev的实际输出替换。不同设备上显示为Up的接口可能不同。
配置完成后,从Spark 1 ping一下Spark 2:
能ping通就说明网络层通了。
4.3 配置SSH免密登录
集群操作需要Spark 1能免密SSH到Spark 2。在两台设备上都执行:
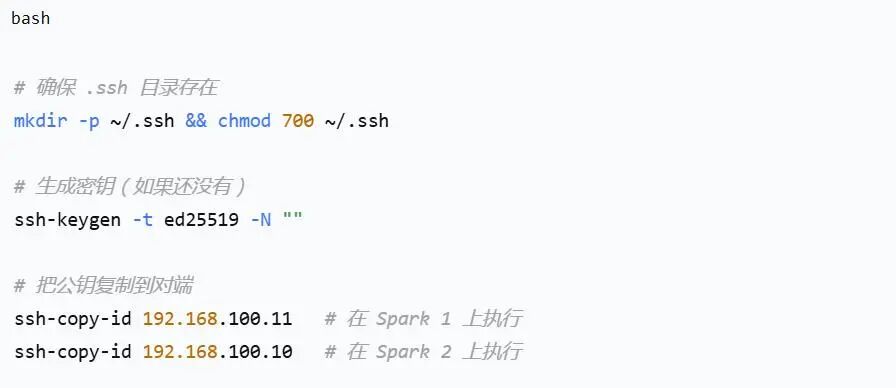
完成后测试:
如果无需输入密码就返回“连接成功”,说明SSH免密配置完成。
小技巧:NVIDIA在GitHub上提供了一个自动发现脚本 discover-sparks.sh,可以自动扫描节点并分发SSH密钥,省去手动操作。但手动配置一次也就5分钟,新手建议手动走一遍,理解每一步在做什么。
4.4 用Cluster Assistant简化配置(可选)
如果你觉得上面的netplan配置太麻烦,NVIDIA还提供了一个图形化工具——Cluster Assistant。在NVIDIA Sync应用中找到“Cluster Assistant”,选择“Add New Cluster”,系统会自动检测已通过QSFP连接的两台设备,并自动完成网络配置。
不过要注意,Cluster Assistant只负责网络配置,不负责推理工作负载的部署。模型部署还是需要手动操作
4.5 验证集群通信
网络配好了,但带宽到底跑满没有?用NCCL测试工具验证一下:
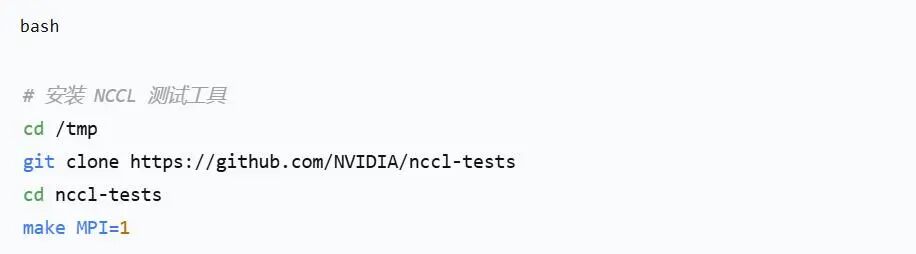
在两台设备上分别运行all-reduce测试,观察带宽是否接近200Gbps(约25GB/s)。如果只有几GB/s,说明网络配置有问题,需要回查netplan。
第三步:部署DeepSeek V4 Flash推理服务
集群就绪后,就可以部署模型了。DeepSeek V4 Flash在DGX Spark上的部署方案比较成熟,推荐使用vLLM作为推理引擎。
5.1 确认前置条件
DeepSeek V4 Flash的FP16原始模型需要约284GB内存,远超两台Spark的256GB。所以必须使用量化版本。目前社区有几种方案:
2-bit专家量化:模型约91GiB,适合单机运行。
NVFP4量化:约87GB,可在单台128GB Spark上运行。
FP4 + 2节点张量并行:利用两台Spark的256GB内存,性能最优
推荐用双节点张量并行方案,充分利用两台设备的算力。
5.2 拉取Docker镜像
DGX Spark使用ARM64架构(GB10芯片),不能直接用x86的vLLM镜像。需要专用镜像:
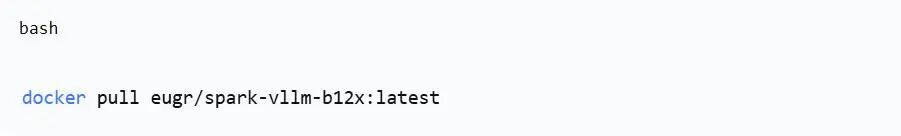
这个镜像由社区维护,专门适配DGX Spark的GB10芯片(SM121架构),包含了vLLM主分支中尚未合并的B12X后端优化
5.3 下载模型权重
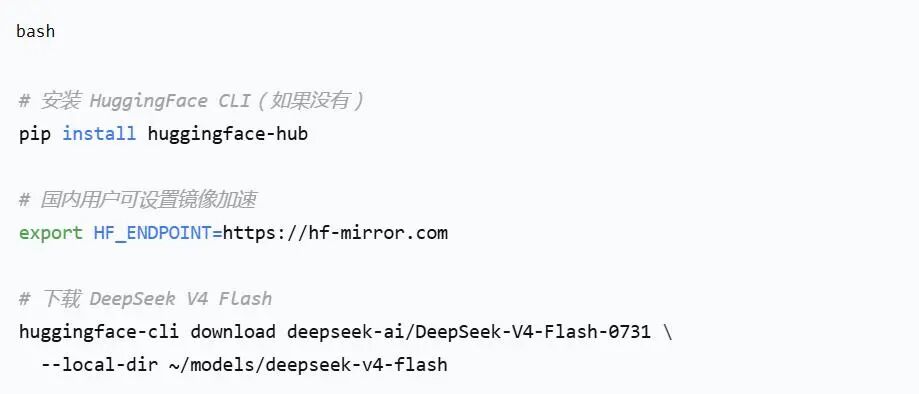
模型文件约91GB(2-bit量化版),下载时间取决于网络速度。
5.4 启动双节点推理服务
在两台设备上分别执行以下命令。先启动Spark 1(head节点),再启动Spark 2。
Spark 1(Head节点):
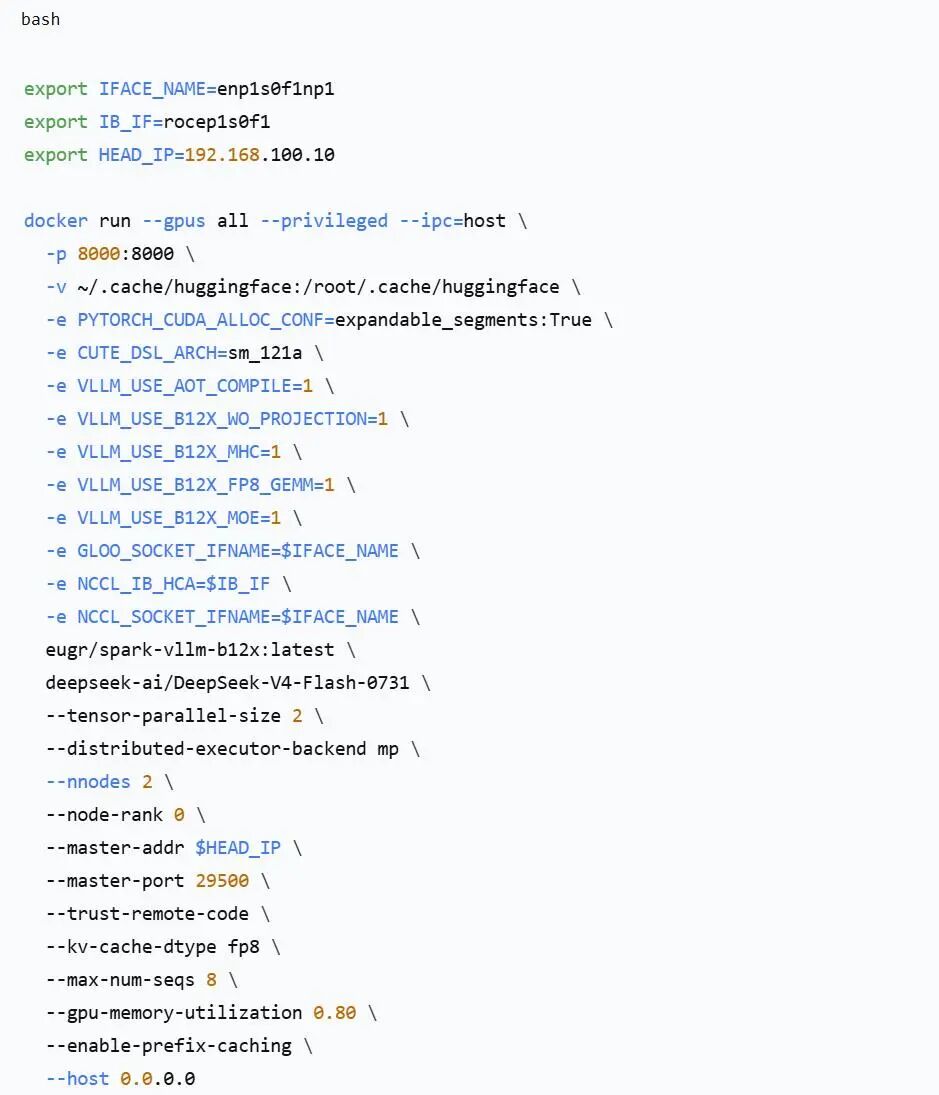
Spark 2(Worker节点):
与Spark 1相同的环境变量和镜像,但把--node-rank改为1,并加上--headless参数。
参数说明:--tensor-parallel-size 2表示用2个GPU做张量并行,把模型的权重矩阵切分到两台设备上。--gpu-memory-utilization 0.80留出20%内存给系统和其他进程,避免OOM
第四步:服务验证与性能调优
6.1 验证服务是否正常
服务启动后,在Spark 1上测试:
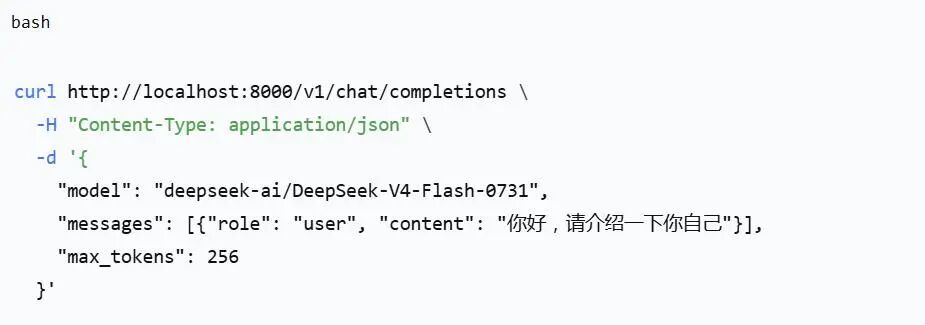
如果返回正常的JSON响应,说明推理服务已经跑通了。
6.2 性能调优要点
DGX Spark的性能瓶颈主要在内存带宽。单台Spark的LPDDR5X带宽约273GB/s,这个带宽决定了token生成速度的上限。
几个实用的调优方向:
使用NVFP4量化:相比FP8,内存占用减少约40%,性能提升最高2.6倍
开启前缀缓存:--enable-prefix-caching,多轮对话场景下后续请求启动时间从分钟级降到秒级
控制并发数:--max-num-seqs 8适合DGX Spark,过高的并发会导致显存溢出和性能下降
启用投机解码:DeepSeek V4 Flash支持DSpark投机解码,结构化任务生成速度可达27-35 token/s
常见踩坑与解决方案
问题 1:QSFP接口显示Down
检查线缆是否插紧,尝试重启系统。如果仍然Down,换一个QSFP端口试试。
问题 2:NCCL带宽只有几GB/s
大概率是netplan配置的接口名不对。用ibdev2netdev确认实际为Up的接口名,确保netplan中配置的是同一个接口。
问题 3:模型加载时OOM
把--gpu-memory-utilization从0.85降到0.80或更低。双节点模式下,两个节点的内存分配需要协调,过高的利用率会导致worker被kill。
问题 4:HuggingFace下载卡住
国内网络环境下,设置HF_ENDPOINT=https://hf-mirror.com使用镜像加速。如果仍然卡顿,可以尝试用hf_transfer加速下载。
全流程总结
两台DGX Spark搭建本地DeepSeek V4 Flash的完整流程可以概括为四步:
单机设置:两台设备各自完成首次开机配置
双机互联:QSFP线缆物理连接 + netplan配置 + SSH免密
模型部署:Docker拉取专用镜像 + 双节点张量并行启动vLLM
验证调优:API测试 + 根据场景调整量化精度和推理参数
JOTO 企业落地观察
- 企业若计划将DeepSeek V4 Flash类MoE模型纳入生产环境,需重点评估其对FDE驻场共创流程的适配性:模型依赖高带宽RoCE互联与精细的内存协同调度,现场工程师必须具备底层网络拓扑诊断与NCCL通信调优能力,而非仅关注API封装。
- 这类基于GB10芯片的ARM64集群部署,对RAG知识工程提出新约束:传统x86生态下的文档解析与向量化流水线需重新编译适配,且向量数据库的嵌入模型必须与主模型共享同一套量化策略,否则跨组件精度衰减不可控。
- 双节点张量并行架构下,AI安全治理的关键控制点前移至集群初始化阶段:SSH免密配置、netplan静态IP绑定、以及NCCL通信加密开关,均构成推理服务可信边界的基线要求,任何跳过这些步骤的“快速上线”都会导致横向越权风险。
- 对于企业智能体工程团队,该实践凸显了“硬件感知型提示工程”的必要性:当token生成速度被LPDDR5X带宽锁定时,提示词设计必须严格控制上下文长度与结构化输出格式,避免因解码延迟引发的Agent状态机超时崩溃。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们