GPU推理中60%算力浪费于重复计算上下文:NVMe闪存卸载KV缓存可提升利用率至95%
WEKA CTO指出,LLM多轮推理中GPU因KV缓存逐出频繁重算历史上下文,导致最高60%算力浪费;采用NVMe闪存卸载并共享KV缓存,可使单卡服务用户数达4–5倍,GPU利用率从30%跃升至95%。
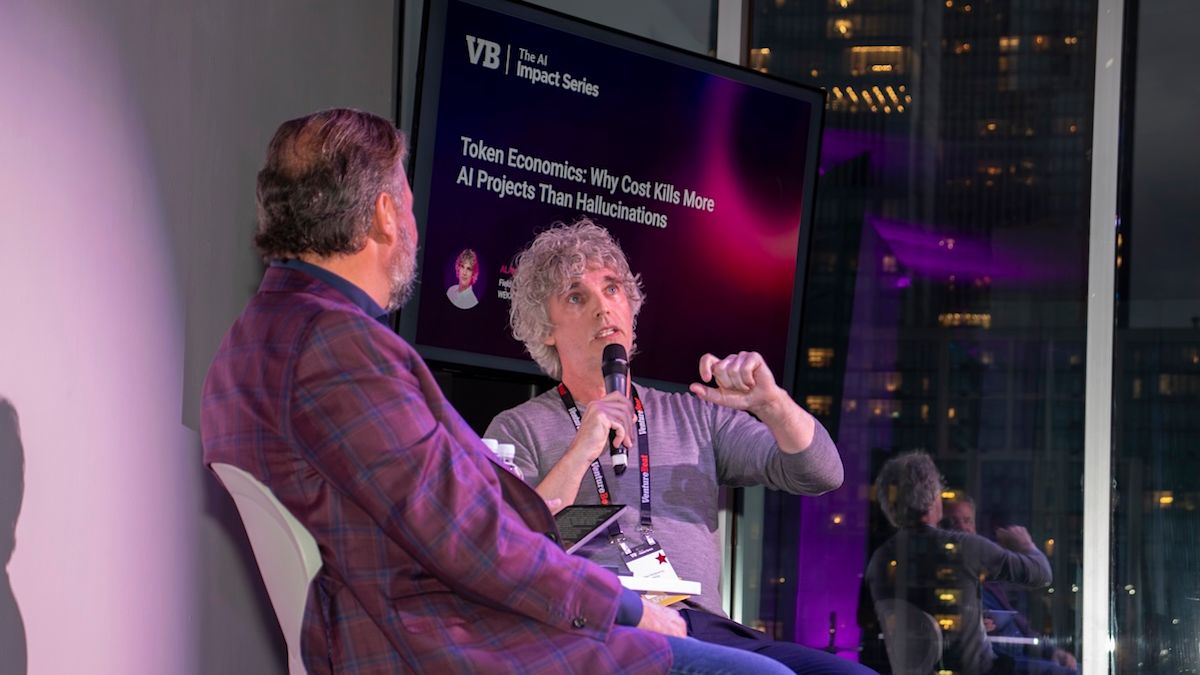
WEKA公司首席技术官(CTO)艾伦·麦克塞文尼(Alan McSeveney)表示,运行大语言模型(LLM)推理任务的GPU最多会将60%的算力浪费在重新计算其已处理过的上下文上。他在最新一期VentureBeat AI影响力系列活动中,与VentureBeat首席分析师罗布·斯特雷查伊(Rob Strechay)对话时指出,这种浪费源于大语言模型将对话历史保存在GPU内存中的方式;他主张,解决该问题可使企业利用现有硬件服务数倍于当前的用户量。WEKA客户面临的最大效率难题体现在基础设施层面,这与各企业为其自身业务领域所调优的应用指标是相互独立的。
麦克塞文尼表示:‘人们遇到的制约因素包括预算、电力供应和数据中心空间。这些限制目前正阻碍许多组织的增长尝试,因此各方都在努力从已做出的资本投入中获取更高回报。’
为何GPU在多轮次LLM推理过程中会重新计算KV缓存
在多轮次推理过程中,GPU将已处理的上下文存储于KV缓存中,从而避免每次交互都重新计算。但GPU内存容量有限;当较早的上下文被逐出时,会话恢复后GPU可能不得不重新计算相同的历史记录。
他表示:‘若不采取任何策略应对该问题,GPU在处理新任务时的利用率可能低至30%;而采用良好策略后,利用率可提升至90%以上,最佳情况下可达95%。’
他补充道,当一家公司自行构建AI工作负载基础设施时,GPU成本占总预算的80%以上,因此一张将大量计算周期耗费在重复计算上的GPU卡,‘是巨额的资金浪费’。
NVMe闪存优于DRAM用于KV缓存卸载
业界已开始更积极地推进KV缓存复用与卸载,相关实践涵盖Mooncake及近期DeepSeek的技术方案,以及英伟达(Nvidia)集成于Vera Rubin堆栈中的CMX上下文内存平台。麦克塞文尼认为,相较于扩充服务器DRAM,使用NVMe闪存来存储该缓存更具经济性:其在存储KV缓存方面性能匹配甚至优于DRAM,扩展性远超DRAM,且成本显著更低。
他表示:‘应尽快将数据移出GPU,让其他任务占用该GPU,待需要时再将其数据快速加载回GPU。’
该交换操作的速度决定了单张GPU所能服务的用户数量。若系统能足够快地完成缓存卸载与重载,则每张GPU可服务的用户数可达原先的四至五倍。面临容量缺口的公司可在订购下一张GPU前,于现有服务器上容纳同等倍数的更多用户或智能体(agents)。
WEKA增强型内存网格(Augmented Memory Grid)如何在GPU服务器间共享KV缓存
WEKA增强型内存网格运行于其NeuralMesh存储软件之上,它从GPU服务器捕获KV缓存,集中存储,并可按需将其加载回数据中心内任意主机。因此,一个会话可在某台服务器上暂停,并在另一台服务器上恢复,而第二台GPU无需重新计算该会话的历史记录。
麦克塞文尼表示,相较将缓存卸载至DRAM,采用集中式KV缓存加载方式使相同GPU上的用户数量提升了7倍,并在同一时间段内将输出量从20万个token提升至200万个token。但缓存优化并未触及应用层面的问题。
他解释道:‘你仍须尽可能优化你的应用程序、工作流及流水线。’
关于应优先通过量化(quantization)与微调(fine tuning)优化模型权重,还是优先优化模型外围的封装层(harness),不同客户的选择各异。但大多数具备真实LLM实践经验的团队,已学会抑制幻觉(hallucinations)、减少浪费并验证结果。而在基础设施层面,知识鸿沟更为显著——许多客户尚不清楚其现有系统尚有多少闲置容量可用于承载更多查询与更多用户。
通过GPU或按token计费的API捕获KV缓存节省效益
麦克塞文尼表示,问题并非在于应构建专有技术栈还是采用托管服务——收益归属掌握GPU控制权的一方,这既包括自行运营硬件的公司,也包括租用裸GPU实例并在其上运行自有软件的公司。
他表示:‘如果你按token向基础模型提供商付费,那么其在自身侧实施的任何缓存优化所带来的大部分收益都将归其所有,而非你所有。’
随着GPU供应日趋紧张,这一权衡变得愈发重要。麦克塞文尼援引谷歌(Google)向客户发出的信息称:其为Google Cloud已订购但尚未安装的所有GPU,均已确定全生命周期服务买家;且未于12月前完成预约的客户,不应指望能获得按需(on-demand)算力。同样从受限供应中采购GPU的服务提供商也将面临同等压力。
麦克塞文尼表示:‘自行运营部分基础设施或许并非你的首要考虑,但它可能很快成为一项必要之举。’
JOTO 企业落地观察
- 对企业部署而言,该技术揭示现有GPU集群存在大量隐性闲置容量——客户无需新增硬件即可通过缓存共享与卸载,在相同GPU上承载4–5倍用户量,这对预算受限、电力/空间紧张的AI规模化落地具有直接降本增效价值。
- 对智能体工程而言,会话可在不同GPU服务器间无缝迁移并复用历史KV缓存,避免重算,显著提升多智能体并发响应稳定性与吞吐量(如token输出量从20万升至200万),为长生命周期、跨节点调度的智能体编排提供底层支撑。
- 对FDE落地而言,文中明确指出基础设施层的知识鸿沟比应用层更严重——多数企业尚未意识到其系统尚有可观闲置算力;这意味着FDE推进需优先建立GPU级资源可见性与缓存效率度量能力,而非仅聚焦模型或应用优化。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们