90 天 2 万 Star:腾讯把 Agent 的记忆做成了团队资产
腾讯云数据库团队开源 TencentDB Agent Memory,90 天获 26,546 Star。它不追求让 AI 记住更多,而是将对话、技能、文档、代码四类经验沉淀为可归属、可审计、可装配的「记忆资产」,通过四层分层(L0–L3)与 Memory Hub 治理体系,支持团队级 Agent 协同。项目强调记忆即装备、按需加载、混合检索(BM25+向量+RRF),并已适配多款主流 Agent 框架。
记忆不是让 AI 记住所有事,而是让人不必重复所有事
你大概经历过这个场景:周一在 Claude Code 里把项目背景讲清楚,周三换到 Codex 开新会话,又从头讲了一遍。同事上周排查了半天的那个故障,这周换个人遇上,还是得重新排查一遍。
不是模型不够聪明,是这些经验从来没被存下来过——它们只活在某个聊天框里,会话一关就散了。
腾讯云数据库团队把这件事做成了一个开源项目:TencentDB Agent Memory。据腾讯云官方发布稿,项目在 2026 年 5 月正式开源,90 天内 GitHub star 突破 2 万,并多次登上 GitHub Trending 第一名。截至 2026 年 9 月 13 日,GitHub API 显示这个仓库有 26,546 star、2,502 fork。
记忆不是让 AI 记住所有事,而是让人不必重复所有事。
四类记忆资产:对话、技能、Wiki、代码图谱
多数「Agent 记忆」项目只解决一件事:把对话历史存下来,下次检索出来。TencentDB Agent Memory 存四样东西。官方把每一类都注册成了一种「Memory Asset」(记忆资产)。
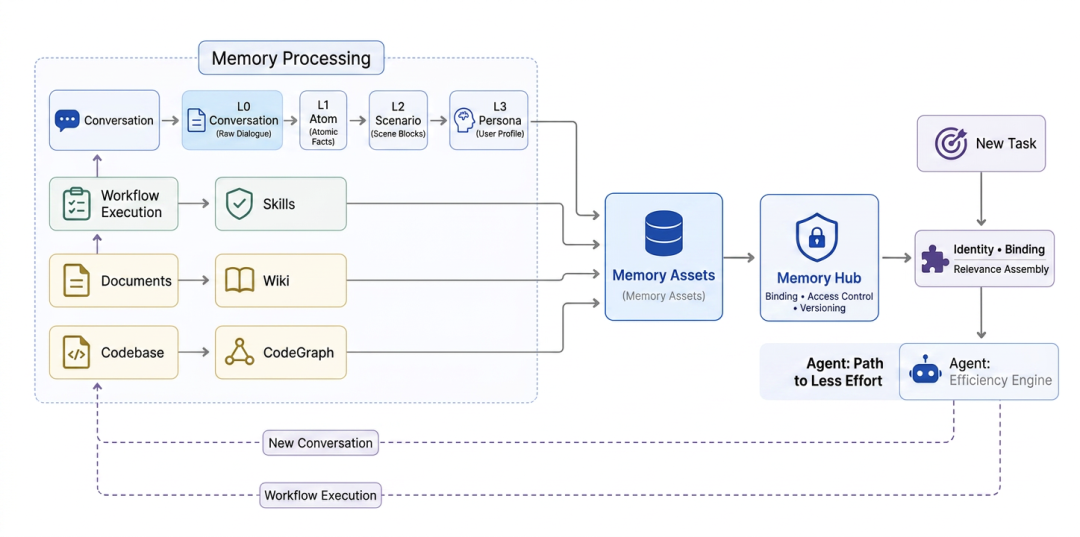
01 Chat Memory(对话记忆)
保留偏好、事实、决定和交互历史。每个 Agent 被创建时就自动带上自己的记忆,新会话不用再自我介绍一遍。
它按四层蒸馏:L0 对话原文 → L1 原子记忆 → L2 场景 → L3 画像。这四层的运转方式放到后面专门拆。
02 Skill(技能库)
Agent 完成一次复杂工作后,系统能从对话和工具调用里把过程提出来,变成可复用的技能,再按需注入到指定 Agent。
一个 Skill 具备版本、资源文件、触发边界、执行步骤、验证规则。个人技能默认私有,经过审核才能共享给团队并分配。
举个例子:某位开发者排查了一个内存泄漏,过程被沉淀成技能。下次另一个 Agent 遇到同类报错,这套排查步骤会自动出现在它的能力清单里。经验第一次有了载体。
03 Wiki(LLM-Wiki 知识图谱)
把产品文档、设计规格、运维手册转成带链接图的结构化页面。
这一层的思路来源是 Andrej Karpathy 提出的 LLM knowledge base 构想——把文档当作「由 LLM 增量维护的知识产物」,而不是一次性灌进向量库的死数据。项目 README 在致谢里明确写了这一点。
04 CodeGraph(代码图谱)
索引代码符号、文件、调用关系和影响路径。Agent 可以搜、可以读、可以查调用者与被调用者,改代码前先做影响分析。
这个模块的代码基础来自开源项目 colbymchenry/codegraph,README 也做了致谢。
记忆治理体系:四档可见性与 Memory Hub
除了存,还要管。四类资产之上是一套治理体系。可见性分四档:private(只有资产归属人可读,团队管理员也看不到)、team(团队可读)、restricted(精确到用户/角色/Agent 的授权)、agent(团队内定向装配)。角色分两层:全局 System Admin 管用户和团队,团队里再分 Admin 和 Member。
配套的 Memory Hub 控制面板能看到每项资产的归属、版本、状态、使用次数和绑定的 Agent。
记忆分层:L0 到 L3 的四层档案楼
把记忆想成一栋四层的档案楼。
- L0 原文层:全量保留每一轮交互。原始记录,不做加工。
- L1 原子层:从原文里自动抽出四类东西——事实、偏好、约束、阶段结论。
- L2 场景层:按任务把原子记忆聚合成知识块。
- L3 画像层:持续蒸馏出稳定的长期画像。
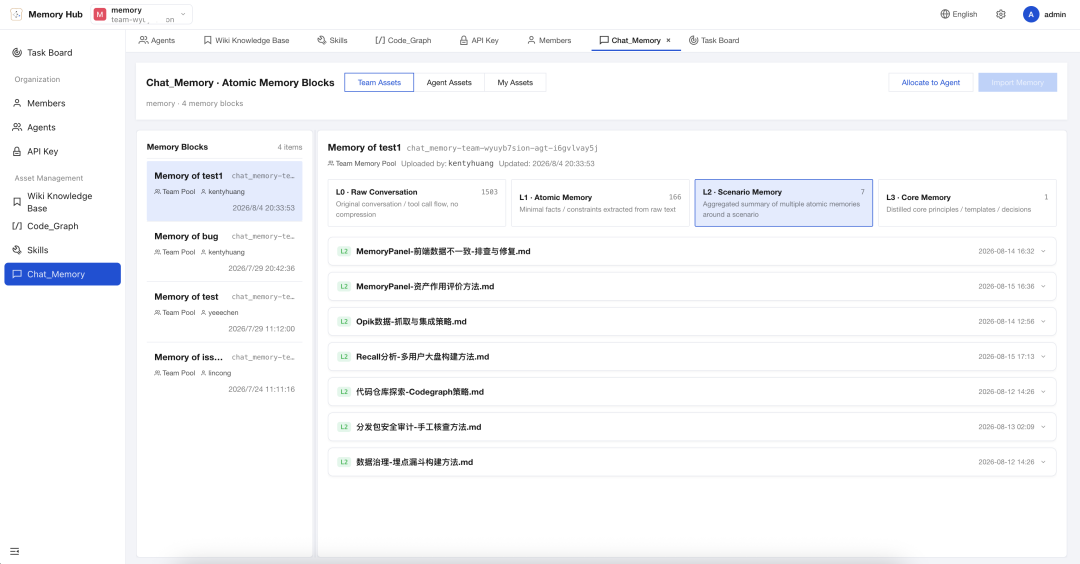
层与层之间靠一条管道连起来:提取 → 聚合 → 蒸馏。每一层只干一件事,而且任何一层都可以独立升级或替换。
为什么要分这么细?因为「我用 TypeScript」和「帮我查一下天气」在原始对话里长得一模一样。前者是长期偏好,后者是一次性请求,价值完全不同,但在纯压缩方案里会被平等对待,权重一起被压扁。
分层的意义就在这儿:不同寿命的信息,住不同的楼层。
检索也是分层的,这点比存储更实用。 Agent 处理日常任务时,先加载 L2 场景层和 L3 画像层,用少量 token 快速建立上下文背景。只有当需要精确事实——比如某个配置项的具体值——才回落到 L1 甚至 L0 去捞原文。
回落时用的是混合检索:官方 README 写明是 BM25 + 向量检索 + RRF 融合。BM25 负责关键词精确命中的部分,向量负责语义相近,RRF 把两路结果融合排序。
这里有个细节值得一提:纯向量检索在真实生产里经常翻车,因为错误码、文件路径、版本号这类东西靠语义相似度是找不准的。带上 BM25 是工程上的必要选择。
为了避免检索结果把上下文撑爆,系统还有三重限制兜底:条目数、字符预算、超时。
记忆即装备:按需装配与零代码接入
还有一层设计叫「记忆即装备」。 四类资产统一注册后,通过 Fixed Binding + ACL 决定某个 Agent 能用哪些资产。流程是先按 Team / User / Agent / 可见性收敛出权限范围,再在当前范围里做检索。
这个设计的好处是:换 Agent、换框架、甚至换底层模型,都不用重建记忆系统,重新「装备」一次就行。
知识按需调用,不预加载。 Agent 先通过 /v3/tools/list 发现有哪些能力可用,再用 /v3/tools/call 去读页面、源码或影响路径。文档和代码只在真正被需要时才进入上下文。
存储层面,默认是 SQLite 加本地文件,MongoDB 后端目前标注为实验性、默认关闭。仓库的 topics 里有 local-first,指的应该就是这个。
上手:三步启动,但需填两组参数
官方给的快速启动是三行命令:
git clone https://github.com/TencentCloud/TencentDB-Agent-Memory.git
cd TencentDB-Agent-Memory/deploy/global-images
cp .env.example .env
# 填入两组 LLM 参数:memory 组 + proxy 组
./start-all.sh
./start-all.sh 会同时拉起三个服务:
- memory-core:记忆核心,负责分层存储与检索
- memory-hub:团队记忆面板与管理后台
- proxy:代理层,负责零代码接入
启动完成后终端会打印一行可以直接粘进 Agent 配置里的命令。面板地址是 http://localhost:8125。
接入方式是它比较讨巧的一点。 不需要插件、不需要 hook、不需要 MCP Server,只要把 Agent 的 base URL 指向 Proxy 就行。README 列出的已适配清单包括 DeepSeek Harness、Claude Code、Codex、CodeBuddy、WorkBuddy、Hermes、OpenClaw,其他框架可以参照 Generic integration guide 自己接。
冷启动可以直接导入「存档」。 代码库丢进去自动建 CodeGraph,文档丢进去自动生成 Wiki,历史会话丢进去自动抽 Skill 和 Chat Memory。新成员、新 Agent 不必从零开始。
不过要提醒一句:Wiki 和 CodeGraph 是异步构建的,导入之后得等状态变成 ready 才能查。如果你打算把它接进自动化流水线,这段等待时间要算进去。
如果你是老版本升级上来的,MemoryCore/scripts/migrate-v2-to-v3/ 目录下有 v2 到 v3 的数据迁移工具;全新安装可以跳过。
效果数据:token 用量下降,任务完成率上升
项目方公布的 benchmark 数据里,最有意思的是「token 用量」和「任务完成率」同时在往好的方向走。以下数据来自腾讯云官方开源文章,测试方式是给 OpenClaw 接入记忆插件前后做对比:
| 测试项 | 类型 | 接入前 | 接入后 | 变化 |
|---|---|---|---|---|
| WideSearch | 短期 | 33% | 50% | +51.52% |
| SWE-bench | 短期 | 58.4% | 64.2% | +9.93% |
| AA-LCR | 短期 | 44.0% | 47.5% | +7.95% |
| PersonaMem | 长期 | 48% | 76% | +59% |
同一份测试里,WideSearch 的 token 消耗从 221.31M 降到 85.64M,降幅 61.38%;SWE-bench 从 3474.1M 降到 2375.4M,降幅 33.09%。
⚠️ 注意 需要说清楚的是,这些是官方公布的数字,不是第三方独立复现的结果。另外 GitHub README 里只保留了 PersonaMem 这一条(48% → 76%),其余几项出现在腾讯云的官方文章里。
WideSearch、SWE-bench 这类测试考察的是「长链路任务中记忆是否真的帮上了忙」,PersonaMem 考察的是「长时间交互后还能不能正确理解并应用用户信息」。前者看任务能力,后者看人设记忆,两个维度互补。
与主流记忆框架的路线差异
市面上做 Agent 记忆的开源项目不少,但定位差别很大。下面这张表的 star 数据来自 2026 年 9 月 13 日的 GitHub API:
| 项目 | Star | 协议 | 核心路线 |
|---|---|---|---|
| mem0 | 65,221 | Apache-2.0 | 框架无关的记忆层,向量为主 |
| Graphiti(Zep) | 30,846 | Apache-2.0 | 实时时序知识图谱 |
| TencentDB Agent Memory | 26,546 | 见仓库 LICENSE | 团队级记忆资产 + 治理 |
| Letta | 24,717 | Apache-2.0 | 有状态 Agent 运行时,分层记忆内建 |
| MemOS | 11,303 | Apache-2.0 | 自演化记忆操作系统 |
mem0 做的是「薄薄一层」。 它把自己定位成框架无关的记忆中间件,你接进来就能用,集成成本低。它主要回答的问题是:这段信息该不该存、存了之后能不能检索出来。
Letta(前身 MemGPT)走的是「厚运行时」路线。 它认为记忆不该是外挂的向量库,而应该是 Agent 运行时的一等公民,用 core / archival / recall 三层来调度。想用它,基本意味着要接受它那套 Agent 运行时。
Graphiti 押注时序。 它解决的是「这个事实什么时候是真的、什么时候被更新了」——知识图谱里每条边都带时间维度。金融、医疗、合规这类必须追溯事实有效期的场景会更在意这件事。
TencentDB Agent Memory 走的是第四条路:把记忆变成资产,然后治理它。
这个差别最直观的体现是它多出来的那堆东西:可见性四档、Owner 归属、版本、状态、使用次数、Agent 绑定、审核共享。前面四家基本不碰这一层。
所以你判断要不要用它,其实不该先问「它记得准不准」,而该先问一句:你需不需要知道「这条记忆谁能用、哪一版有效、该装配给哪个 Agent」。
需要,它就是四家之外唯一的选择。不需要——比如你只是一个人用、只想让 Agent 别忘了上周聊过的事——那 mem0 的集成成本要低得多。
三个还没解决的问题
第一,它的「重」是设计选择,也是真实成本。 三个服务、两组 LLM 参数(memory 组和 proxy 组都要填)、网关密钥、数据迁移脚本——这套东西跑起来有门槛。官方 roadmap 把「零配置冷启动」放进了 v2.0.1 的计划里,这本身就说明现阶段的冷启动还不够轻。
如果你只是想给单个 Agent 加个记忆,直接上 mem0 加一个向量库,可能半小时就能跑通。
第二,CodeGraph 的覆盖面还在补。 README 的已知限制里写得很明确:CodeGraph 目前优先支持公开的 HTTPS 仓库,私有仓库和 SSH 凭据的支持仍在完善。如果你公司的代码在内网、走 SSH 协议,这一块现在还用不上,得等。
第三,治理能力还差最后一段自动化。 Hub 目前支持手动绑定资产,全自动的记忆路由还在迭代。也就是说,权限和装配这套体系基本是「配好」,而不是「自学习」。
另外仓库的 issue 区目前有 765 个未关闭条目。数量多不一定是坏事,它同时也说明项目迭代很快、社区反馈积极,但接口和实现也确实还有变动的可能,生产环境建议锁定版本。
关于许可证还有一个细节要提醒:README 和腾讯云官方公告都写明是 MIT 协议,但 GitHub API 返回的许可证字段识别结果是 Other。大概率是 LICENSE 文件做了署名定制,但认真要商用的话,动手前自己打开 LICENSE 原文看一眼更稳妥。
记忆正在从功能变成资产
回到开头那个场景。
这个项目最值得注意的,不是它 Star 涨得多快,而是它对「记忆」的定位变了。过去两年,记忆是模型的加分项——加个向量库,把历史对话塞进去,能多记住点东西就算赢。
现在的做法是把它当成资产来管:归谁、什么版本、谁能看、装配给谁。
差别在哪?前者回答「能不能找到」,后者要接着回答「该不该给你、哪一版算数、你现在该用哪一份」。
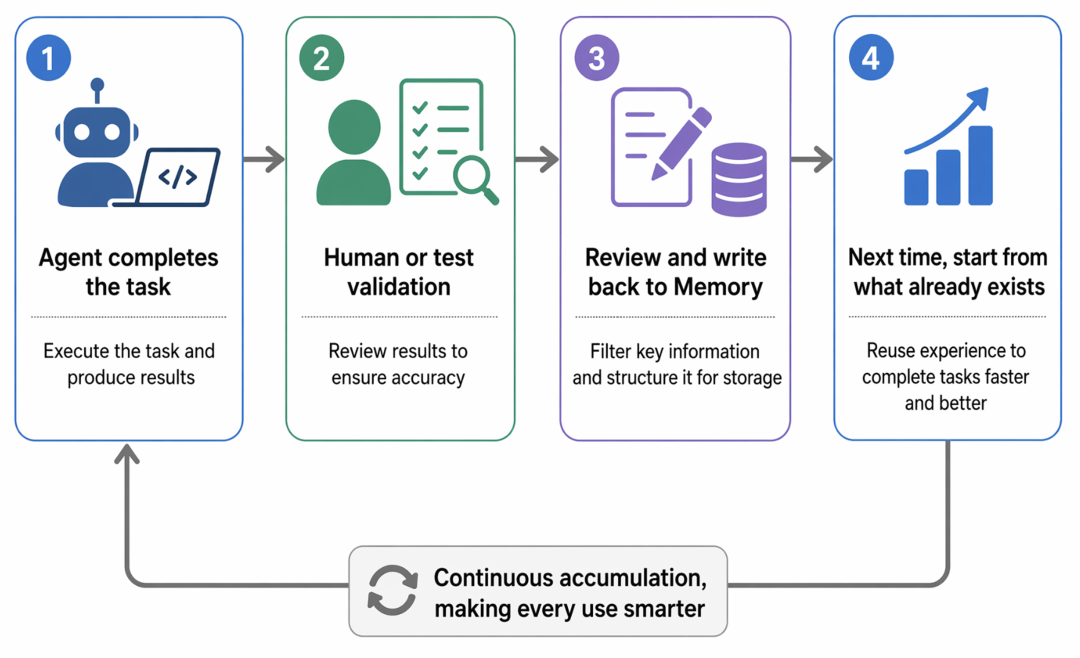
这个转变背后是个挺朴素的判断:无记忆的循环只是更快地重复;有继承的记忆,每次迭代才有机会优于上一次。
JOTO 企业落地观察
- 企业部署 Agent 时若涉及跨角色协同(如开发、测试、运维共用同一套知识),TencentDB Agent Memory 的四档可见性与资产归属机制,可直接支撑组织级权限策略落地,避免传统向量库‘全有或全无’的粗粒度访问控制问题。
- 这类系统的取舍在于:当团队需要将技能、代码图谱、文档等异构知识统一纳入治理闭环时,其 Memory Hub 的资产装配能力成为关键优势;但若仅需轻量级单点记忆增强,mem0 等薄中间件仍具更低实施成本。
- RAG 知识工程实践中,该项目将 Wiki 和 CodeGraph 设计为异步构建、按需加载的模块,意味着企业可在 CI/CD 流水线中嵌入知识图谱生成环节,并严格控制其就绪状态,从而规避‘文档已上传但不可查’的典型 RAG 时效性陷阱。
- AI 安全治理视角下,L0–L3 分层结构天然支持审计溯源:L0 原文提供完整操作留痕,L1 原子层可校验事实抽取逻辑,L3 画像则构成 Agent 行为基线。这种分层不可篡改性,为企业满足合规性审查提供了结构化证据链。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们