小红书 AllSpark 发布 Iris:同量级最强开源 Search Agent
小红书 AllSpark 团队发布开源 Search Agent 模型 Iris,35B 与 397B 版本在 BrowseComp、BrowseComp-ZH、DeepSearchQA、HLE 四个 Agentic Search 基准上取得同量级最强开源成绩。其核心突破在于端到端的数据构造 pipeline、SFT–RL Climbing 训练范式,以及剥离框架干扰的标准化评测设计。Iris 的搜索能力还泛化至 General Tool Use 与 Cowork 等非搜索任务。
Search Agent 的三重门槛
普通语言模型的评测中,任务、上下文和算力预算大多在开始前就固定好了。Search Agent 不一样:它要自己决定搜什么、怎么读检索回来的内容、什么时候继续找、什么时候证据够了可以回答。这让它更强,也让它更难训练、更难被公平评测。
团队把难点归纳为三个,Iris 的配方也正是围绕它们展开:
- 数据难:真正好的训练题,必须“闭卷答不出、给了资料才能答对”,而且不能靠关键词匹配蒙对。自然产生的网页问题很少同时满足,人工出题又贵又难扩展。
- 训练难:长链路搜索里,少数超长轨迹会拖慢整个同步训练;而判分、摘要如果依赖外部 API,训练就会被卡在网络波动上。
- 评测难:搜索智能体的分数很容易被推理时的各种外部技巧抬高。只看最终成绩,会把“模型本身有多强”和“框架有多会取巧”混为一谈,难以对齐比较。
这三道坎——数据、训练、评测——共同决定了一个 Search Agent 的上限,Iris 的做法是把它们当成一个整体来解。
数据:从网页链接结构反向构造题目
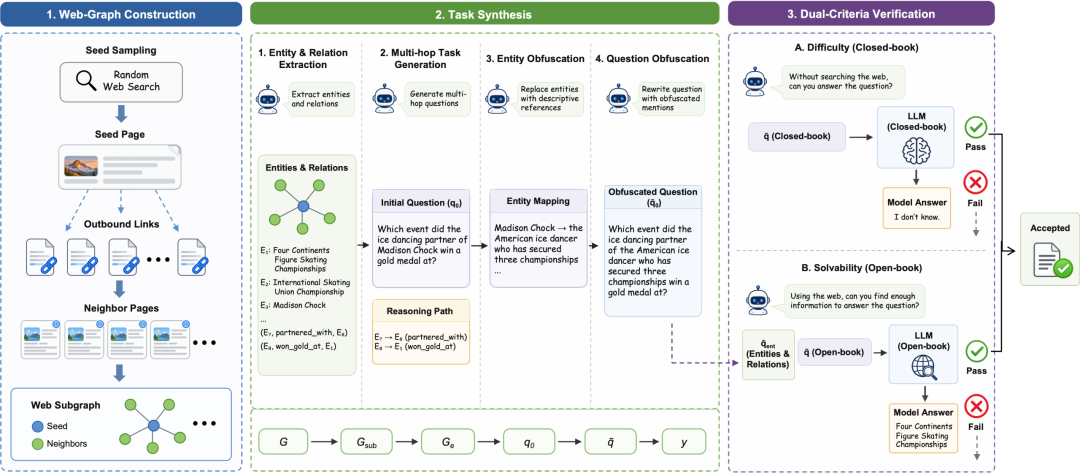
Iris 的训练题不是收集来的,而是从网页的超链接结构里反向“造”出来的。
流程分三步:先以某个种子页面作为答案,顺着它的出链把相关页面聚成一张小型实体图谱;再在这张图上编写一道必须跨多个页面、多步推理才能得到唯一答案的问题;最后是最关键的一步——把题面里除答案之外的每一个实体,都改写成一句描述性的指代。
这一步“抹掉线索”的改写,让题目没法再靠字符串匹配走捷径:模型不能把题干里的名字直接丢进搜索框,而必须真正理解、逐步锁定。
造完题还要双重筛选:用一个参考模型验证两件事——闭卷(不给资料)时它答不出,说明题够难;把证据作为上下文喂给它时它能答对且答案唯一,说明题确实可解。只有同时满足“够难”和“可解”的题才会被保留。这样得到的题,逼着模型靠推理而非匹配去消歧——这正是真实搜索场景最需要的能力。整个流程全自动、不依赖人工出题,因此能随网页语料规模持续扩展。
训练:SFT–RL Climbing 交替优化
有了题,Iris 用监督微调(SFT)与强化学习(RL)交替进行的方式训练,团队把这个过程叫做 SFT–RL Climbing。
SFT 阶段先让一个强教师模型在真实搜索工具上把题做一遍、得到完整轨迹,再经过两层过滤才用于训练:轨迹层看结果对不对、有没有陷入重复或乱码、搜索深度够不够;再由一个“判官”在单轮粒度上剔除那些看起来在瞎搜的步骤——而判官的评判标准不是人手写的,是从数据里归纳出来的。
RL 阶段让模型在真实网络上边搜边学。这里有两个关键工程决定:
- 判分和摘要都放进训练集群内部:用一个自建模型同时充当“奖励判官”和“检索内容摘要器”,训练全程不依赖任何外部 API,把网络波动挡在训练循环之外。
- 超长轨迹“断点续跑”:少数拖后腿的超长会话不再被整段丢弃,而是在请求级别中断、下一步从已提交的前缀继续,让 GPU 在同步调度下也能保持忙碌。
把判分与摘要收进集群内部还有一个额外好处:训练时用来压缩检索内容的那套摘要器,正是模型在评测和线上会用到的同一套,训练与使用不再错位。
每一轮 RL 之后,团队会把其中最难被做对的、以及最高效解出的轨迹回灌给下一轮 SFT。随着模型变强,筛选出来的题会自动变难,形成一条自适应的课程,也天然给出了停止的信号。
换句话说,模型每一轮都在“先自己探索、再把成功经验固化下来”。
评测:统一框架下的能力归因
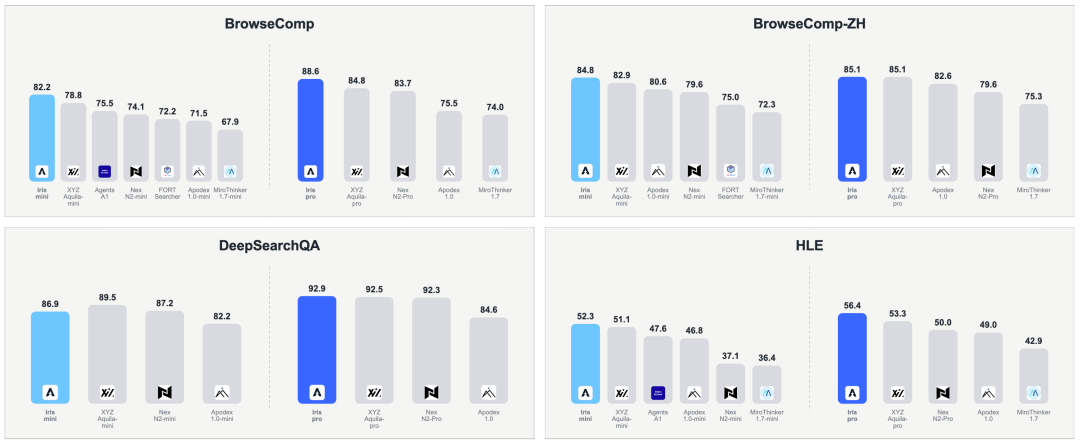
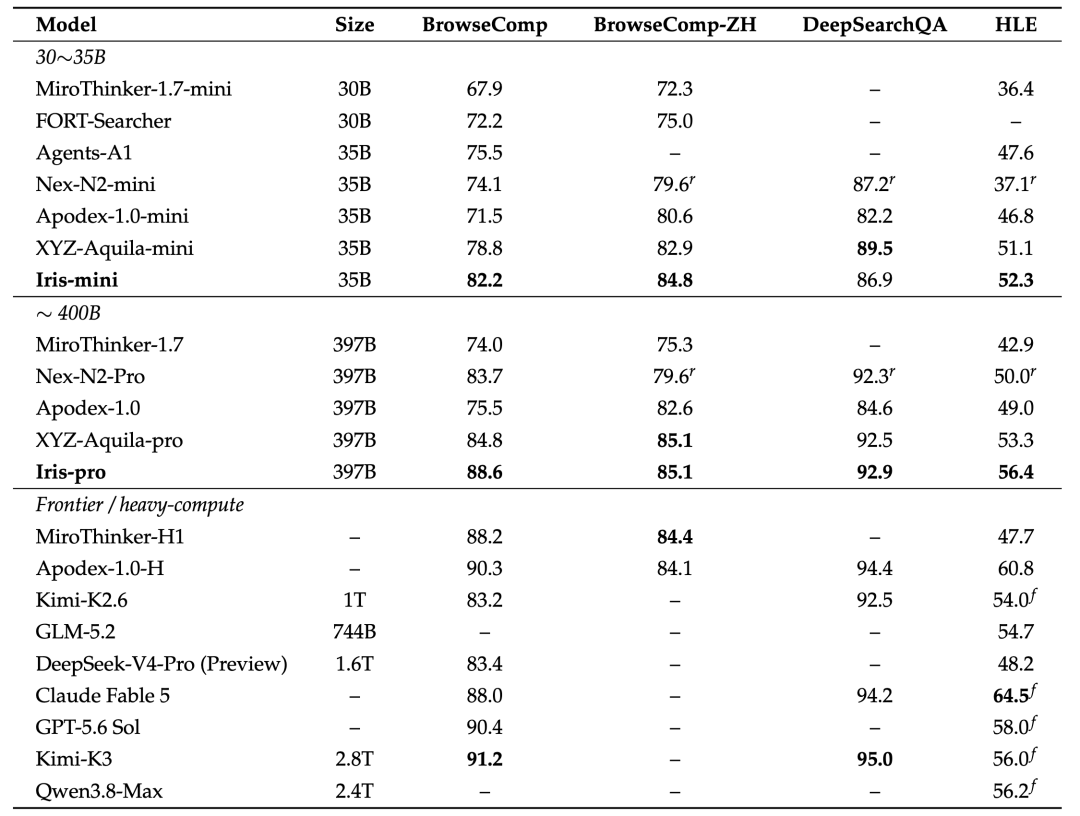
团队在 BrowseComp、BrowseComp-ZH、DeepSearchQA、HLE 四个 Benchmarks 上评测 Iris。这四个基准各有侧重:前两个考察中英文的复杂网页检索,DeepSearchQA 看答案对证据的覆盖是否完整,HLE 则是需要专家级推理的高难题。
为了让分数尽量反映模型本身、而非推理框架的取巧,所有系统都在相同的 Tool、Context 和 Judge Model 下比较、默认采用同一种上下文管理策略,并且只用单个 ReAct 智能体,不叠加多智能体、也不做测试时自我验证。
- Iris-mini(35B):四项成绩 82.2 / 84.8 / 86.9 / 52.3,在 BrowseComp、BrowseComp-ZH、HLE 三项上登顶同量级开源。更难得的是,它在 BrowseComp 上的 82.2 分已逼近 Kimi-K2.6 等万亿参数级模型——用 35B 的体量,摸到了数十倍参数模型的水平。
- Iris-pro(397B):四项成绩 88.6 / 85.1 / 92.9 / 56.4,在 BrowseComp、DeepSearchQA、HLE 上均为同量级最强开源,BrowseComp-ZH 上并列第一。
四个基准从中英文网页检索到专家级难题各不相同,能在其中同时领先,说明 Iris 的 Search 能力并非针对某类题的过拟合,而是较为通用的底层能力。团队也坦承,面对最顶尖的前沿系统,Iris 仍有差距,缩小这一差距是后续的重点之一。
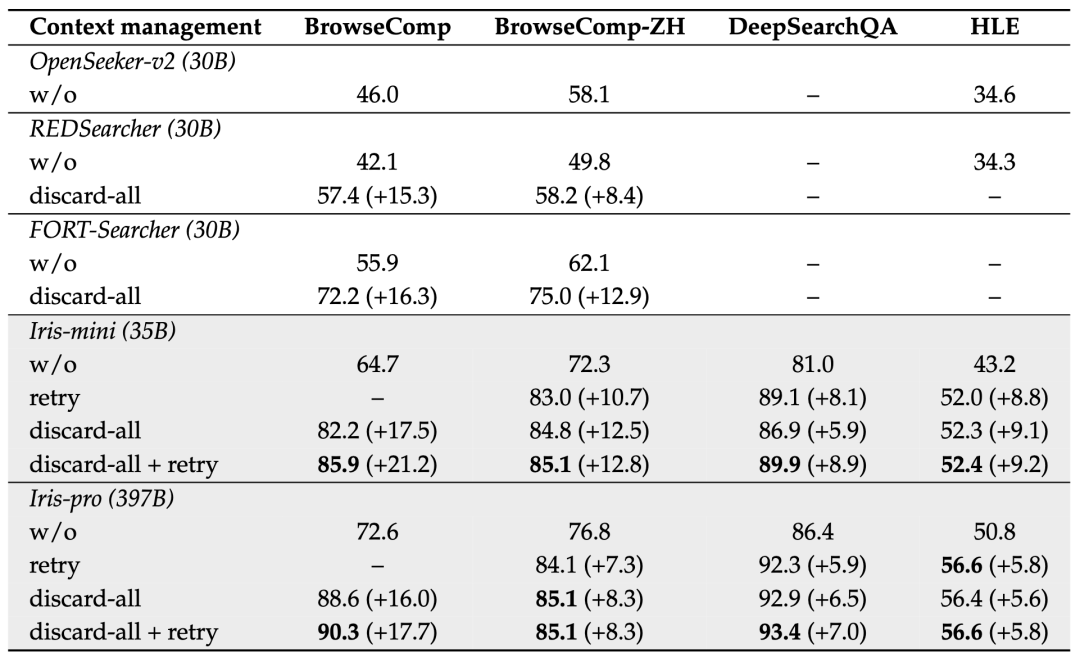
上下文管理(CM)是 Search Agent 常见的加分项——长链路搜索常在答完前就把上下文用光,截断、压缩或清空重来都能续上更多搜索,但是鲜有工作讨论过这一点。团队把它单独拉出来做了对照:即便完全不开 CM,Iris 也已领先同量级其他系统;开启后成绩进一步提升,且小模型的获益明显大于大模型——因为小模型解同样的题需要更多步骤、更容易触到上下文上限,可回收的空间也更大。
Search,但不止于 Search
团队在实验中发现了一个超出预期的现象:为 Search 合成的数据、以及专门训练出的专家模型,在没有专门训练过的任务上同样有效——包括 General Tool Use(BFCL、τ-bench)和 Cowork(OfficeQA、APEX)场景等。
背后的解释是:一方面,如今很多任务多少都会用到一些在线搜索或本地检索的工具;另一方面,Search 数据教会模型的,是在信息不完整时如何行动——而这种能力并不只属于网页浏览,任何需要“边做边找、边找边判断”的 Agent 任务都用得上。这也解释了为什么一个 Search 模型,会在从没专门训练过其他任务上有如此好的泛化性。
如果这个规律成立,那么 Search 或许更应该被看作一种可复用的原子能力,而不是一个孤立的垂直方向。Search 数据与模型的价值,也就不该只用“浏览网页做得多好”来衡量——过去被当作“垂类”投入的训练,很可能是一项能被反复使用的通用底座。
端到端开源与复用前景
Iris 给出的是一套端到端、可复现的 Search Agent 配方,团队计划开源模型权重,以及数据构造、训练、评测各环节的关键组件。比起单个基准上的分数,团队更看重两点:一是让相对小巧的模型在垂域上也能具备逼近超大模型的能力;二是 Search 能力“外溢”到更广的 Agent 任务——这意味着这套数据与模型有机会复用到更多智能体产品中,而不必为每个方向从零训练。这也是接下来要继续探索的方向。
技术报告、模型权重与配方开源:
- Paper:https://arxiv.org/abs/2609.04304
- GitHub:https://github.com/AllSpark-Research/Iris
- HuggingFace:https://huggingface.co/collections/AllSpark-Research/iris
JOTO 企业落地观察
- Search Agent 的数据构造方法论对企业 RAG 知识工程具有直接迁移价值:Iris 所采用的“从图谱中反向生成多跳推理题+描述性指代消歧”思路,可被复用于构建企业私域知识的高质量问答对,尤其适用于需跨文档、跨系统验证结论的合规与风控场景。
- 其 SFT–RL Climbing 训练范式提示企业智能体工程需重新定义“训练闭环”:当智能体行为不可控时,不应仅靠人工标注修正,而应建立“行为轨迹→自动判官→难例回流→课程升级”的内生反馈机制,这对金融、政务等高确定性要求领域尤为关键。
- 评测中剥离框架干扰的设计(统一 Tool/Context/Judge Model、禁用多智能体与自我验证)为企业 AI 安全治理提供了可操作标尺:它表明,评估一个智能体的真实能力,必须控制变量,否则所谓“性能提升”可能只是工程取巧,而非模型本质进步。
- Search 能力向 General Tool Use 与 Cowork 的泛化,印证了“行动推理”作为通用智能体底座的可能性;企业部署智能体时,可优先投入建设高质量的 Search 数据与训练基础设施,而非为每个业务动作单独建模。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们