25GB 内存的破电脑,跑起了 744B 大模型
Colibri 是一个纯 C 编写的推理引擎,通过将磁盘、内存、显存统一调度,使 744B 至 2.8T 参数的 MoE 模型可在仅 25GB 内存的消费级设备上运行。其核心基于 MoE 模型稀疏性(每 token 仅激活约 11GB 参数),采用专家分层驻留、硬盘镜像读取、OpenAI 兼容 API 等设计,已在 GitHub 获得 3w star。
很多时候,我们研究大模型的第一步,都是先算一笔账:想跑一个七八百亿参数、甚至上万亿参数的MoE模型,得先"投资"多少硬件?
几张A100、几十万显存预算...普通人和小团队基本就直接被劝退。
但周末在Github热榜上看到一个不一样的项目 - colibri,与其攒钱买显卡,不如把手头已有的硬盘、内存、显卡都利用起来,让它们协同工作,把一个744B甚至2.8T参数的模型,硬是塞进一台消费级机器里跑起来。
项目简介
colibri,意大利语里的蜂鸟。重几克,能悬停,一天能访上千朵花。
项目想做的事也一样朴素:让巨大的模型,靠一点点口粮活下来。
这是一个用纯 C 写的推理引擎,零引擎依赖,把磁盘、内存、显存当成同一套推理层级来调度。
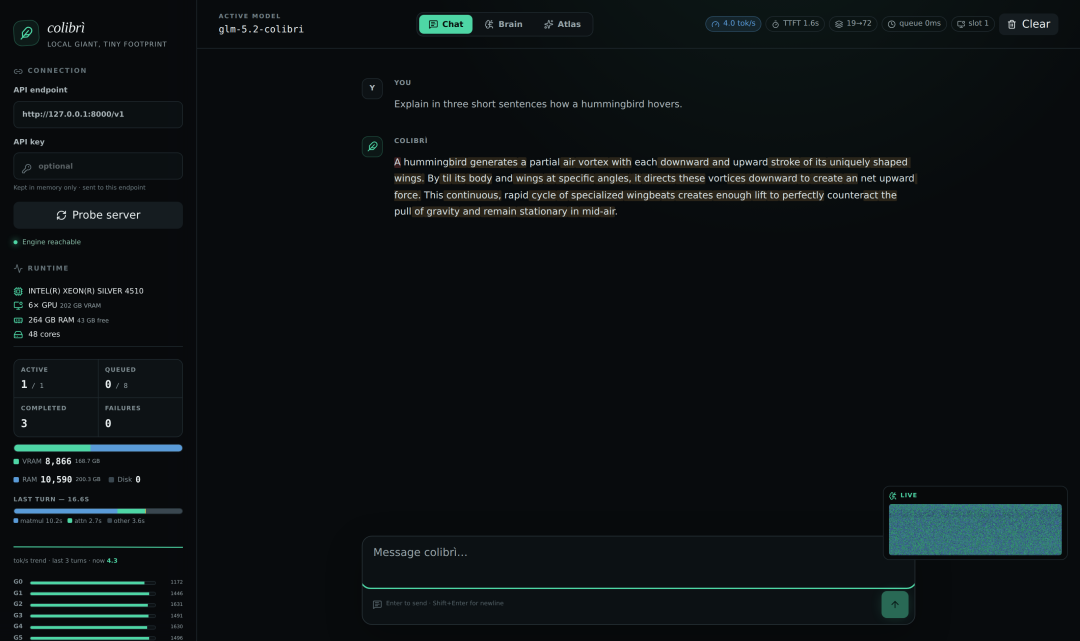
它让 744B 到 2.8T 参数的前沿 MoE 模型,跑在你已经有的硬件上——一台 25 GB 内存的笔记本也能跑,只是慢一点。
它凭什么做得到?因为 MoE 模型本身就很"稀疏":
一个 744B 参数的模型,每生成一个 token,真正激活的参数只有约 40B,其中还会随 token 变化的,只有约 11 GB。
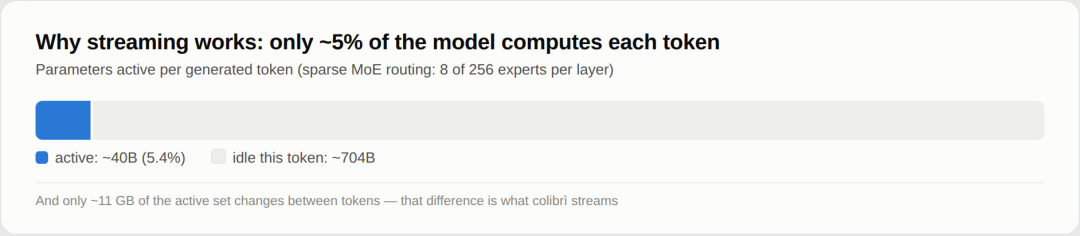
所以模型不是非得"装进"快内存,它只需要被摆放到正确的位置:
- 稠密部分(注意力、共享专家、词嵌入,约 17B 参数)常驻内存,int4 量化后约 9.9 GB;
- 19,456 个路由专家(75 层 MoE × 256 + MTP 头,int4 下每个约 19 MB)留在磁盘上,约 370 GB,谁被路由到,谁才按需流进来。
项目目前已经在GitHub收获 3w star,覆盖 GLM-5.2/5.3、Kimi K3、DeepSeek V4 Flash、Qwen3.6等模型家族。
功能特性
01 把硬盘当显存用,而且越用越快
这是 colibri 最核心的一件事。
它把显存、内存、NVMe 硬盘看成同一层级的三个位置:热门的专家放显存,常用的锁在内存(pinned RAM),剩下的全部留在硬盘上流式读取。
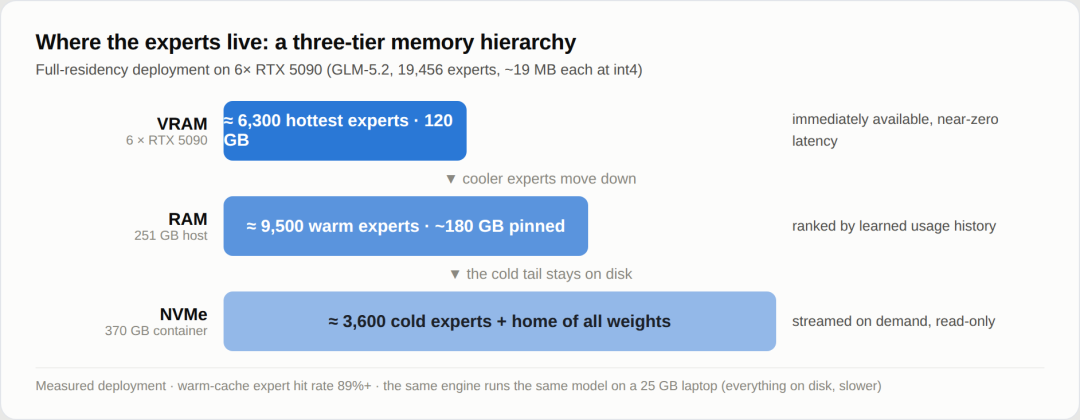
谁该放哪儿,它不靠猜。用久了,它会记住你的习惯,把最常打交道的专家挪到手边;还会提前一步猜下一个要用谁,趁等待的工夫先搬好。
02 能看见模型"在想什么"
这一条纯属好玩,但特别上头。
colibri 自带一个网页仪表盘,其中有个叫 Brain 的页面:把 GLM-5.2 的全部 19,456 个专家铺成一片活的皮层。颜色代表存储层级,亮度代表路由热度,某一轮被命中的专家会闪一下白光。
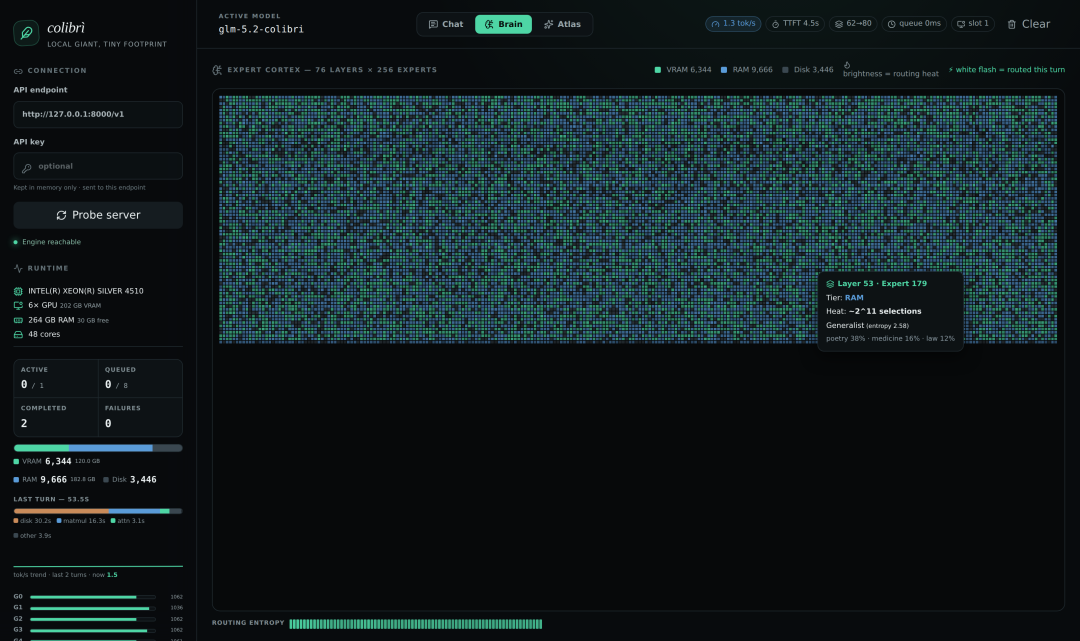
还有一个 Atlas 页面,把已经表征过的 13,260 个专家画成一片三维星系——位置不是学出来的嵌入向量,而是实测的路由亲和度。所以你会看到写诗的、做法律的、处理中文的、写 SQL 的,各自聚成一团,通才往中心漂。
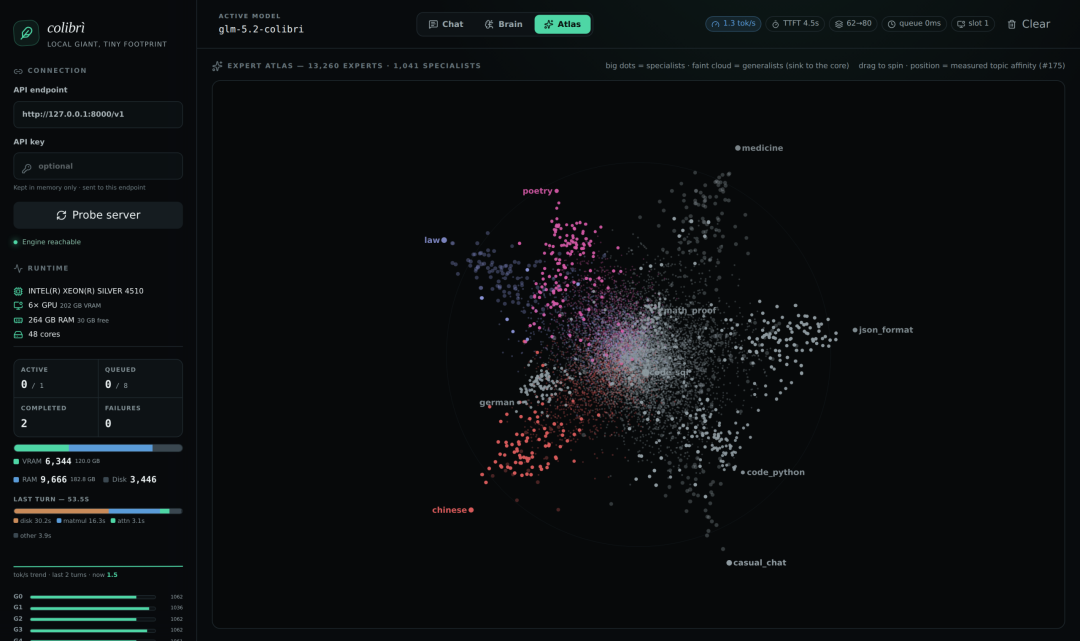
这是第一个在普通机器上画出来的 700B 级模型专家图谱。鼠标拖着转两圈,比读十页论文都直观。
03 多插一块 SSD,读取带宽直接翻倍
大部分机器上拖后腿的不是显卡,是硬盘。而模型这东西只读不写。
所以colibri办法很朴素:再插一块硬盘,放一份副本,两块盘一起读。
COLI_MODEL=/fast/glm52_i4 COLI_MODEL_MIRROR=/second/glm52_i4 ./coli chat
COLI_DISK_WEIGHTS=9,3 ...   # 可选:主盘/镜像盘的带宽配比
一块 9 GB/s 加一块 3 GB/s,读起来比只用快盘快约 33%。
副盘只读,装不下整个模型也没关系,放一部分就有一部分的提速;中途拔掉,它只会变慢,不会崩。
04 语义不打折,接口也现成
速度可以让步,精度不行。这是 colibri 划得很清楚的一条线。
对普通用户更友好的是接口。它自带 OpenAI 兼容的 HTTP 网关,一行命令就能把网页仪表盘和 API 一起拉起来:
./coli web   --model /nvme/glm52_i4    # API + 仪表盘,自动打开浏览器
./coli serve --model /nvme/glm52_i4    # 只起服务,不开浏览器
快速安装、使用
你只需要两样东西:程序(几百 KB)和模型(372 GB)。
第一步:拿到 colibri
从 Releases 下载对应平台的预编译包,Linux、macOS、Windows 都有,不需要编译器:
mkdir colibri && tar xzf colibri-v1.8.0-linux-x86_64.tar.gz -C colibri && cd colibri
python3 coli info                         # engine ready ✓
里面就是引擎、coli 启动器和几个 Python 辅助脚本。只需要装 Python 3——启动器和 API 网关是 Python 写的,引擎本身是纯 C,零依赖。
想从源码构建也行,准备带 OpenMP 的 gcc 或 clang:
git clone https://github.com/JustVugg/colibri && cd colibri/c
./setup.sh    # 检查 gcc/OpenMP,编译,自测
第二步:拿到模型
Hugging Face 上有转好的 GLM-5.2 int4 容器,约 372 GB,记得放在空间够、速度快的盘上:
https://huggingface.co/mastouri/GLM-5.2-colibri-int4-g64-with-int8-mtp
这里有两个坑,作者专门标了红:
- 一定要用 gs64 这个版本,旧的 per-row int4 镜像质量差大约 9 个百分点;
- MTP 头一定要是 int8,用 int4 的接受率会直接掉到 0。
不想下载现成的,也可以自己从 FP8 源转换,一条命令断点续传,不需要同时腾出 756 GB 空间:
./coli convert --model /nvme/glm52_i4 # 分片下载 + 转换(Python,一次性)
第三步:跑起来
COLI_MODEL=/nvme/glm52_i4 ./coli chat     # 直接开聊,缓存和 MTP 自动检测
COLI_MODEL=/nvme/glm52_i4 ./coli plan     # 先看看权重打算怎么摆
COLI_MODEL=/nvme/glm52_i4 ./coli doctor   # 只读体检,检查环境是否就绪
COLI_MODEL=/nvme/glm52_i4 ./coli tune     # 测出这台机器最快的安全配置并存下来
Windows 用户更省事,发布包里带一个 coli.cmd,双击就是快速开始,或者:
coli.cmd chat --model D:\glm52_i4
想换模型,比如Kimi K3、DeepSeek V4 Flash,命令行完全不用改,只需要编译对应引擎、指向对应目录就行。
实际跑起来能有多快?
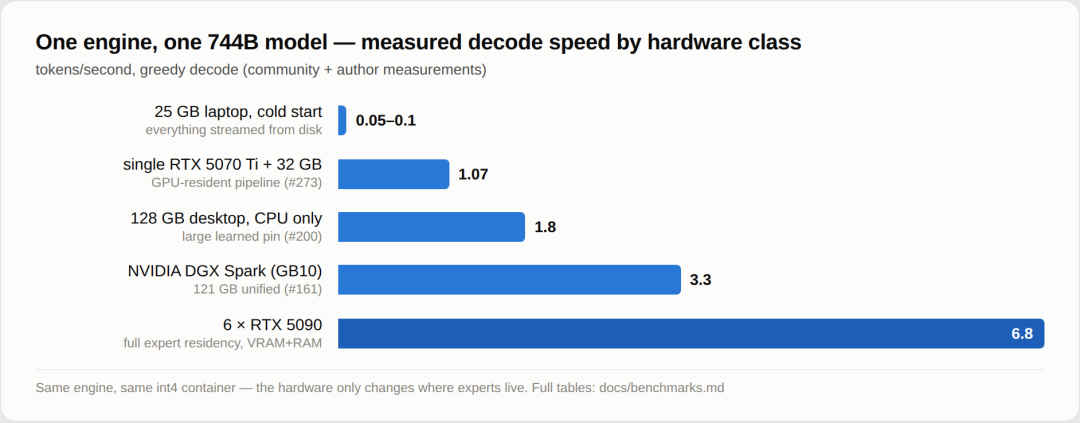
- 6× RTX 5090,专家全驻留:5.8–6.8 tok/s,TTFT 约 13 秒;
- 128 GB 纯 CPU 台式机,热缓存:约 1.8 tok/s;
- 单张 RTX 5070 Ti 的笔记本:1.07 tok/s;
- 25 GB 开发机,冷启动:0.05–0.1 tok/s——慢,但这是项目起步时的真实下限,作者的诚实也就体现在这儿。
开源君想说
colibri 用纯 C 加"把硬盘当显存"这一个思路,把原本要租算力才能碰的前沿 MoE 模型,还给了普通人。
如果你手里有台闲置的台式机、一块空着的 NVMe,或者只是单纯想在自己机器上跑一次 744B 的模型看看它怎么开口说话——不妨 clone 下来跑个 coli chat。
https://github.com/JustVugg/colibri
JOTO 企业落地观察
- 企业部署超大规模MoE模型时,若受限于GPU显存或预算,可将colibri类方案作为轻量级推理底座:它不改变模型语义,仅重构硬件资源调度逻辑,使CPU+NVMe组合成为可行的生产级推理节点,尤其适合知识密集型RAG场景中对长上下文与多专家路由的低频高精度调用。
- 这类系统在智能体工程中意味着新的架构权衡——放弃端到端GPU加速换取硬件普适性,要求团队重新设计Agent的执行链路:例如将专家路由决策前置为独立服务,或将冷热专家加载策略纳入Agent状态管理,而非依赖框架自动调度。
- 对RAG知识工程而言,colibri揭示了一种新范式:模型参数可按语义角色(如法律专家、SQL专家)物理隔离存储,这使得知识库更新可粒度至单个专家模块,无需全量重训或重部署,显著降低垂直领域模型迭代的运维成本。
- 在AI安全治理层面,该方案将模型权重分散至磁盘文件系统,天然支持基于文件权限、加密挂载与完整性校验的细粒度访问控制,但同时也要求企业建立配套的磁盘级模型资产台账与变更审计机制,以应对权重文件被篡改或误替换的风险。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们