1.5 TB 压到 214 GB,Hy4 preview 轻量版来了
腾讯混元发布 Hy4 preview 轻量版,通过 Sherry 稀疏三值量化(平均 1.25 比特)与 MIX-STQ1_0 混合精度策略,将原 1.5 TB 模型压缩至约 214 GB。压缩后模型在长文理解、检索、编码等主流任务上表现稳健,且支持异构设备联合推理,在笔记本+服务器组合下实现 1.02 token/s 推理速度。
Hy4 preview 轻量版正式发布
腾讯混元 Hy4 preview 正式发布并开源以来,凭借在代码、办公、科学等真实生产力任务上展现出卓越能力,受到广泛欢迎。这一模型权重接近 1.5 TB,上线后,开源社区也在呼吁一个更轻的版本,希望在配置有限的机器上运行。
为此,腾讯混元团队通过两项核心技术,把 Hy4 preview 的权重缩小到约 214 GB,大幅降低了运行模型的硬件门槛:
- Sherry 稀疏三值量化算法:把最激进一档权重压到平均 1.25 比特
- MIX-STQ1_0 混合精度策略:按校准数据逐层决定每层比特压到多低
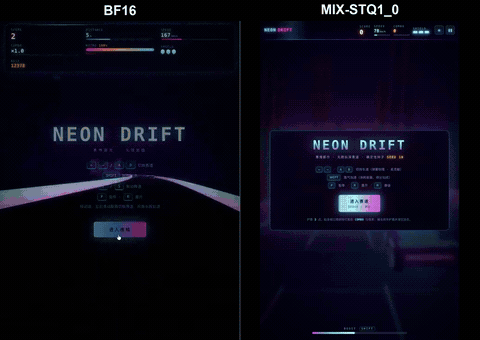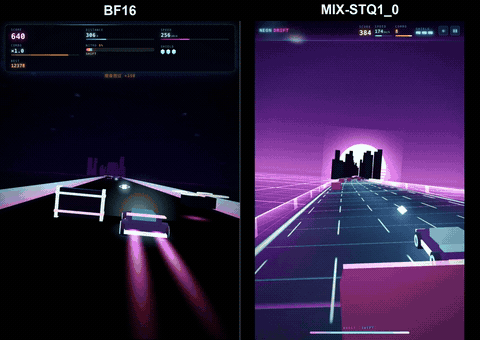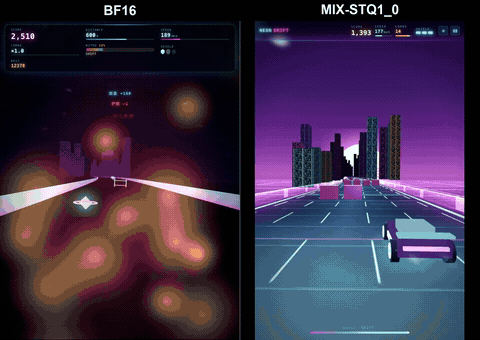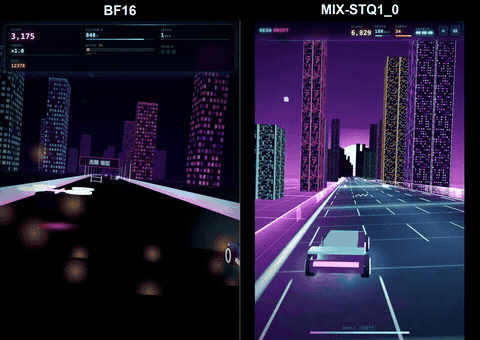
结果显示,模型从 1.5 TB 压缩到只有 214 GB,但是基本的任务也都能完成,这对于资源有限的开发者来说,无疑是一个好消息。
技术详解:1.25-bit 极限量化
要把模型压到极限,先得有一个足够低的比特格式,模型里占大头的是路由专家,六成以上的参数都在这里,最激进的压缩就落在这部分,用的是腾讯混元自研的 Sherry 稀疏量化算法。
Sherry 是一种又小又规整的三值量化方法,以四个权重为一组,一起量化成 {-1、0、+1},并强制每组恰好留一个零。这样一组只有 32 种组合,用 5 bit 就能编码,摊到每个权重平均 1.25 bit,算上分块共享的缩放系数等额外开销,落到文件里的实际开销约 1.31 bpw。基于 Sherry,腾讯混元在 llama.cpp 里实现了 STQ1_0 推理内核,把量化、推理到评测这条链路完整打通。
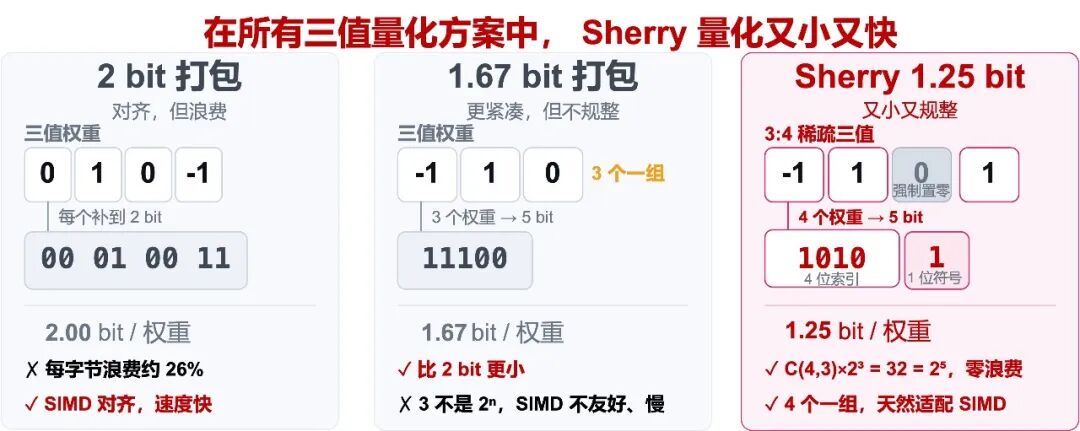
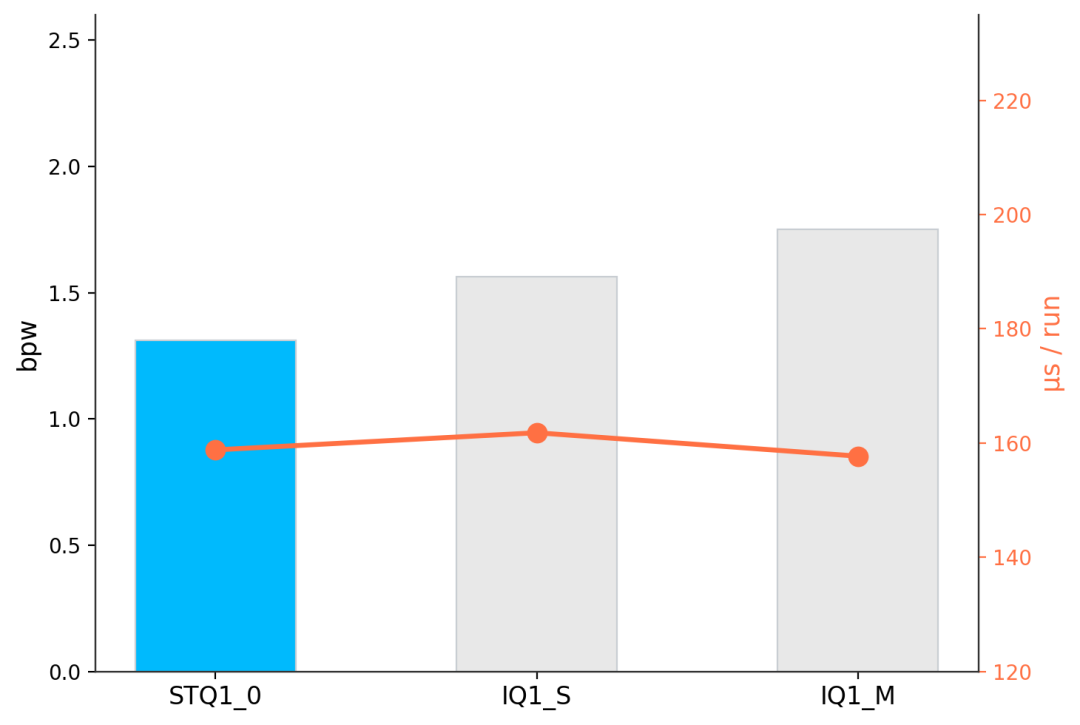
把 STQ1_0 和几种常见低比特格式放在同一算子上比,STQ1_0 在比特数最低的同时,速度和 IQ1_M 基本持平,明显快过同样想冲低比特的 IQ1_S。
比特压在哪,让数据说话
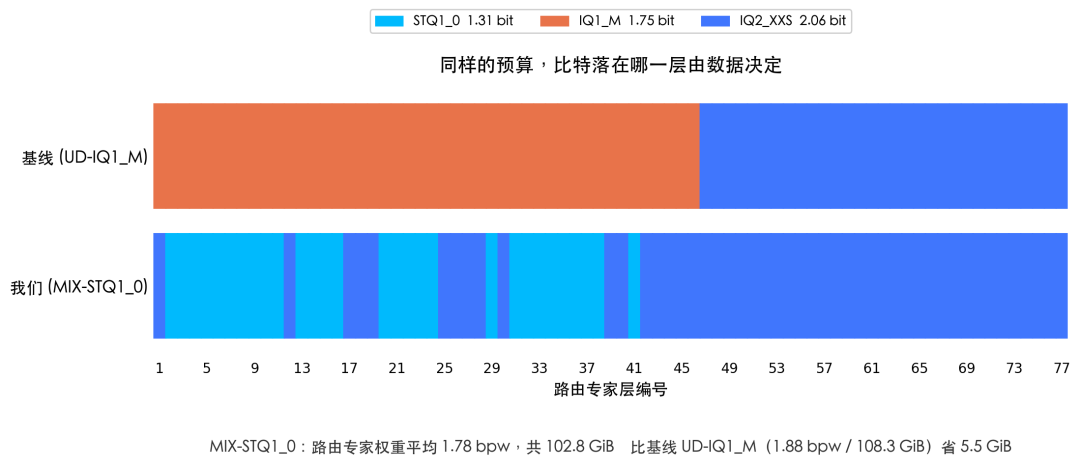
统一把每层压到同一档最省事,可各层对压缩的耐受度并不一样。社区常用的 UD-IQ1_M 方案,大部分路由专家层都用 IQ1_M(1.75 bpw)。腾讯混元在校准集上发现,与其让这些层统一用 IQ1_M,不如按敏感度逐层分档:敏感的层留 IQ2_XXS(2.06 bpw),不敏感的层用更激进的 STQ1_0(1.31 bpw)。这套逐层混合精度方案,就是 MIX-STQ1_0。
在不增加平均比特预算的前提下,这样逐层分档,整体量化误差反而更低。落到最终模型,MIX-STQ1_0 的路由专家权重不光评测表现更好,还比 UD-IQ1_M 少占了 5 个多 GiB。
模型大小压下去了,能力还在
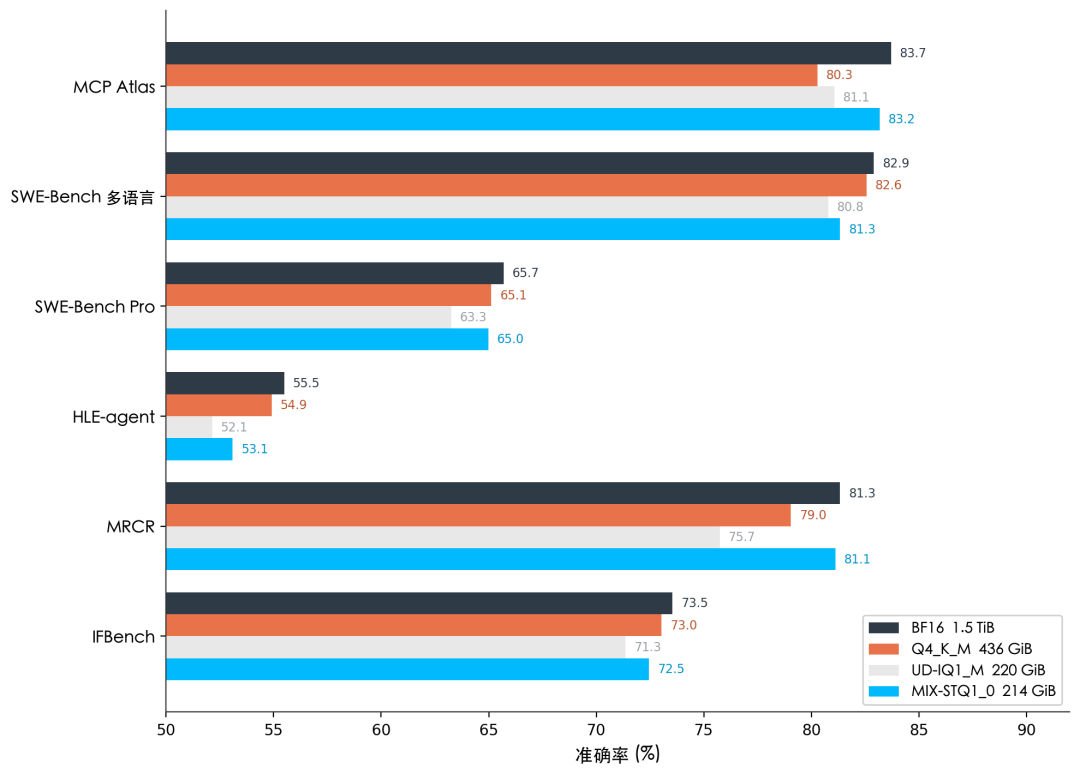
判断量化好坏,最直接的是看它和原始模型比掉了多少。压缩后的模型在主流任务上依然站得很稳。长文理解几乎和原始模型持平,多轮长上下文检索和原版基本在同一水平,数学只有小幅回落,整体都在可接受范围内。日常的编码辅助、工具调用、长文档处理和常规问答,它都能覆盖。
压小之后,异构设备进行联合推理
通过将模型压到两百多 GB,我们还解锁了一种新用法。
大多数人手里没有一整套同构的高端卡,却常有几台配置各异的机器。过去面对超大模型,问题总是这一台能不能跑,跑不动就只能再买一台更贵的。那么能不能把已有的设备拼起来联合推理?
腾讯混元和 prima.cpp 一起做了验证:在一台 4090 笔记本和一台四卡 A4000 服务器上,两端显存合计 80 GB,内存合计 64 GB,还分处两个局域网,靠 prima.cpp 的异构调度把 MoE 层拆开分配、让计算和权重读取彼此重叠,最终把这个 214 GB 的模型协同跑到了 1.02 token/s,比笔记本单机 offload 快了约 6 倍。如果加更多更好的设备还能大幅提升推理速度和性能。
实验验证了另一种思路:面对旗舰大模型,不是必须采购整套同构硬件,把手边现有的异构设备拼起来也能让它跑起来。
部署硬件 Laptop 4090 (32 GB RAM, 16 GB VRAM) + Server 4 x A4000 (32 GB RAM, 16 GB x 4 VRAM)
JOTO 企业落地观察
- 企业若计划在边缘或混合云环境中部署 MoE 类大模型,需重新评估量化策略与推理框架的协同设计能力——Sherry+MIX-STQ1_0 这类逐层敏感度驱动的压缩方案,要求知识工程团队具备模型结构级理解,而非仅依赖通用量化工具链。
- 异构联合推理的可行性,意味着企业无需一次性投入高配 GPU 集群即可启动 MoE 模型验证;但这也抬高了智能体工程中对分布式调度、跨设备内存管理及容错机制的设计门槛。
- 当模型权重压缩至 200 GB 级别,RAG 知识工程的本地化部署边界被显著拓宽——企业可在单台工作站级设备上同时承载轻量 MoE 推理引擎与千兆级私有知识库,降低对中心化向量数据库的强依赖。
- 该技术路径对 AI 安全治理提出新挑战:极低比特量化可能放大权重扰动对输出稳定性的影响,企业在将此类模型用于关键业务决策前,需建立面向量化模型的鲁棒性验证流程,而非沿用 BF16 模型的测试标准。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们