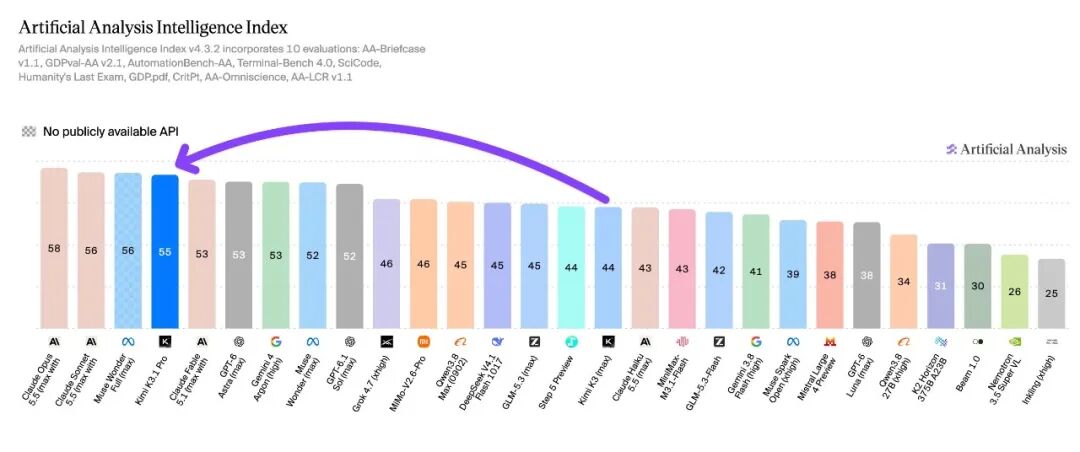
刚刚,月之暗面发布Kimi K3.1 Pro。这把超Astra了?!
月之暗面正式发布Kimi K3.1 Pro模型,基于K3后训练,在代码(Terminal Bench 4.0得分65.7)、3D建模(Bench CAD得分92.7)、金融(OfficeQA Pro v2得分64.4)、网络安全(自建Benchmark得分81)等多维度能力显著增强;幻觉率降至8.3%,API输入/输出价格下调,Kimi官网、Kimi Code及Kimi Work已全面上线。
等啊等,终于等到了Kimi K3.1 Pro。
我就这么说吧,月之暗面发布模型更新带来的关注度,在我看来一点儿也不比Anthropic 来得小。
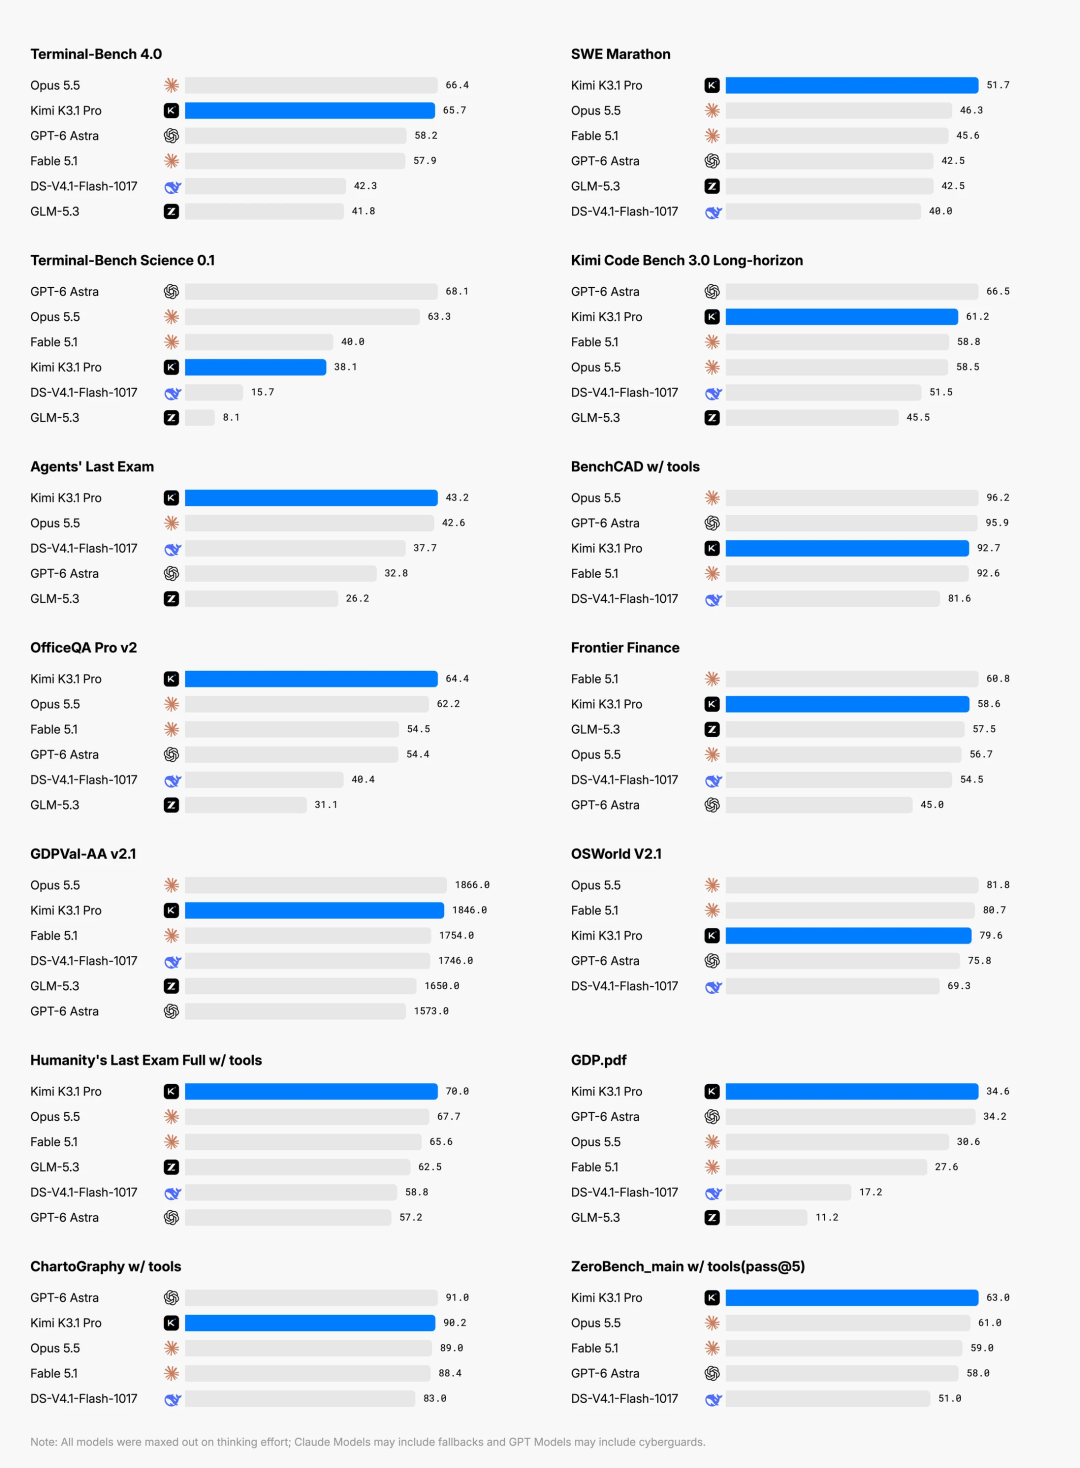
基于之前7月份发布的K3 做的后训练,这次K3.1 Pro 的能力在各个方面都得到了大幅度的增强。下面是官方放出的Benchmark:
代码
Kimi K3.1 Pro 是国产模型第一个能在Terminal Bench 4.0 这样的代码任务上做到仅次于Opus 5.5,分数提升到了65.7分,甚至超过了OpenAI 的GPT-6 Astra。
(OpenAI 你要不要看看你到底在干什么。。。)
除了性能之外,还有一件事儿是成本。
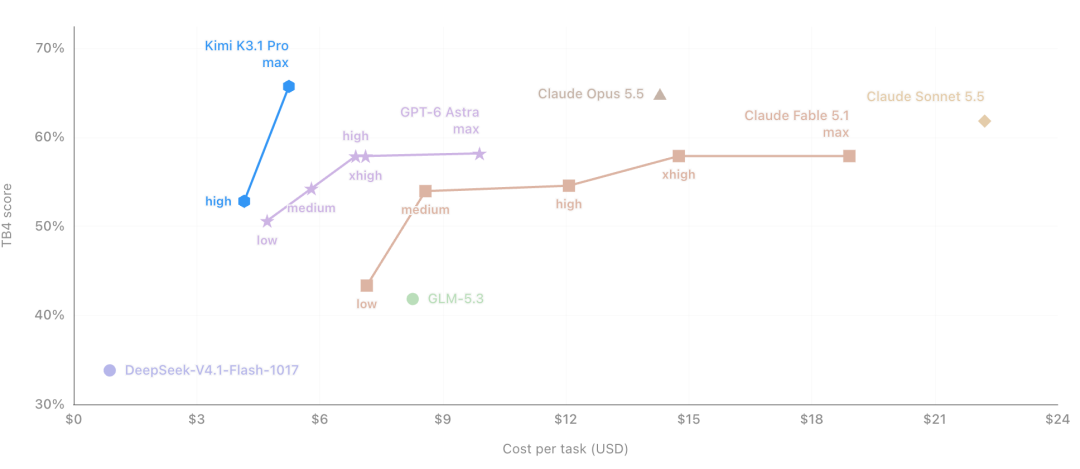
在官方的统计中,Kimi K3.1 Pro 是前沿模型里在Terminal Bench 4.0 上成本控制最出色的。
DeepSeek 刚更新的V4.1 Flash 成本是最低没错,但表现远不如Kimi K3.1 Pro。
3D 建模
在3D 建模领域,Kimi K3.1 Pro 这次的能力也得到了大幅度的增强,特别擅长3D创作和空间推理。
在Bench CAD测试中,Kimi K3.1 Pro 在依赖工具的情况下,得分能达到92.7分,仅略微低于GPT-6 Astra 的95.9 分,和Opus 5.5 的96.2 分,也是目前开源模型做到的最好成绩。
现在用Kimi K3.1 Pro 可以不用依赖MCP,直接通过编写Blender、CAD等专业建模工具的脚本,完成素材的搭建与细化,并调整布局、材质、几何等元素。
看几个官方放出的case吧:
一个是机场的室内森林建模:
还有一个是漩涡发动机建模:
还有一个是3D 打印台灯:
以及在Kimi 官网和APP已经同步上线了3D Make 功能,能在线预览和编辑3D模型,做好的模型可以直接下载3D打印,同时还能导出视频或者live照片随手分享。
金融
在金融领域,这次K3.1 Pro 也有很大提升。
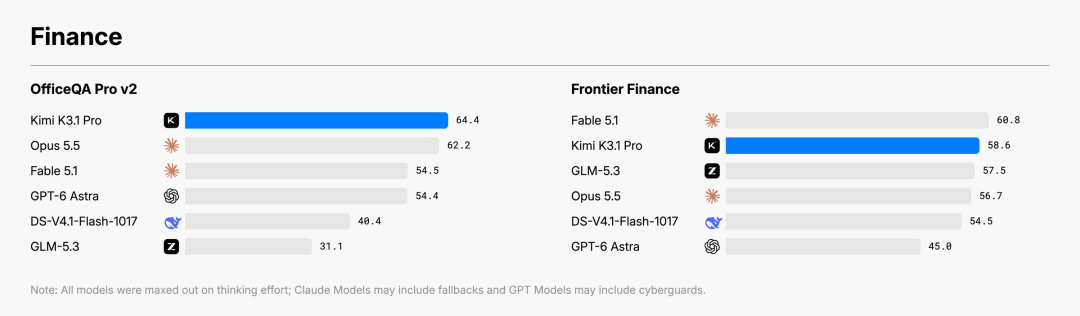
OfficeQA Pro v2 是一个考察基于真实金融文档的复杂财务数据分析、涉及检索、跨文档核对与多步数值推理的Benchmark。
在OfficeQA Pro v2上,得到了64.4分,领先当前所有的模型。而在Frontier Finance 这个考察模型对完整投资工作流的支持能力,覆盖从标的筛选到盈利分析的benchmark上,Kimi K3.1 Pro 相比于前一个版本也有很大提升,取得了58.6 分,仅次于Fable 5.1。
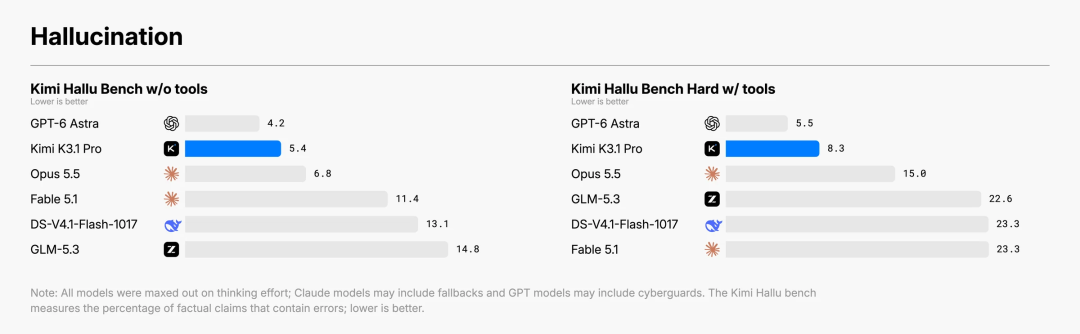
并且,在幻觉测试上,Kimi K3.1 Pro 同样非常出色。
在内部压力测试Kimi Hallu Bench Hard中,Kimi K3.1 Pro 的错误率从前一代的23.4%下降到8.3%,仅次于GPT-6 Astra。
网络安全
在网络安全能力上,官方发现,随着后训练规模的不断扩大,模型的漏洞研究能力持续提升。在自建的Benchmark 中,最终版Kimi K3.1 Pro 得分为81分。
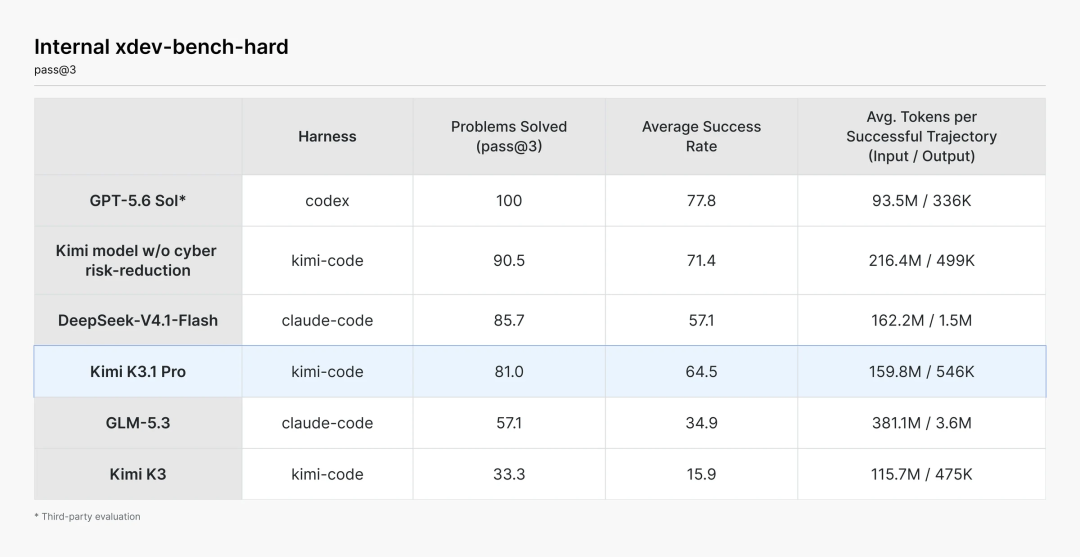
根据官方的描述,目前Kimi K3.1 Pro 的网络攻防能力仍然落后那些已公开发布至少三个月的前沿闭源模型。
价格与使用
目前在Kimi 官网以及Kimi Code 和 Kimi Work 都可以使用最新的Kimi K3.1 Pro 模型,而在API 使用价格上,相比于前代,价格也有所下降。
现在每百万tokens 输入是13元(未命中缓存),1.3元(命中缓存),每百万tokens输出是68元。高速版本的输出速度是正常版本的2-3倍,价格是现在的2倍。
(咱就是说,能不能再努力降点...)
一手简单实测
我自己本身是699套餐,在Kimi Code里简单做了几个好玩的case,分享给大家。
第一个是我让它自己搜索相关Kimi K3.1 Pro 的资料,然后用代码做一个老式新闻播报风格的视频给我;
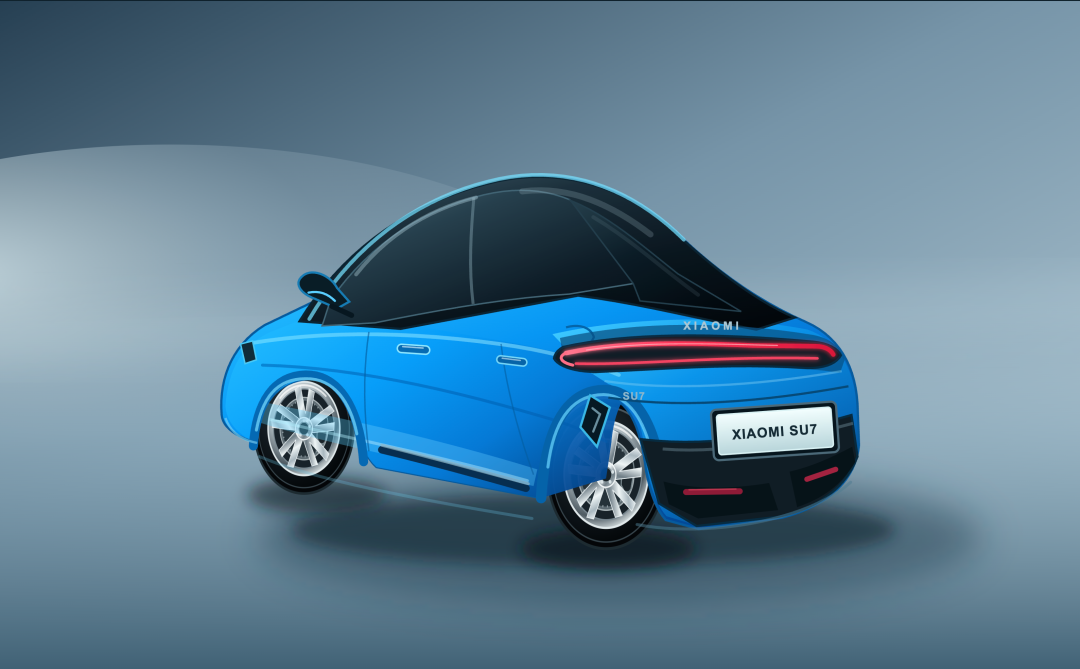
第二个是让它根据小米su7的参考图,通过svg 来复刻。
emm...是我的这个case太难了么? 目前除了Astra 和Opus 5.5 做的好点以外,其他看上去都不太行。
第三个是用p5.brush.js 画一条鱼:
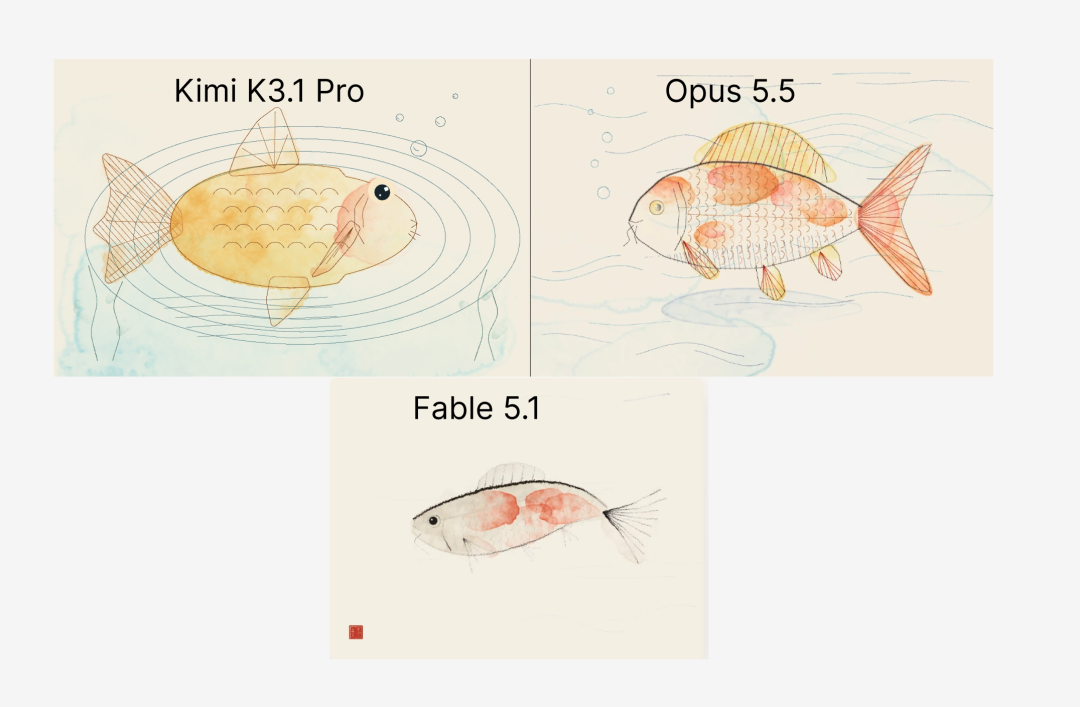
感觉还行吧,我个人觉得是没有Opus 5.5 好,但是感觉比Fable 5.1 样子上稍微好点,细节上能看到更多的东西,但美感上还是缺了点。
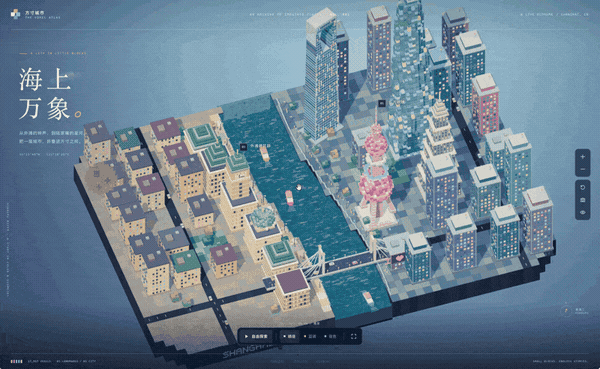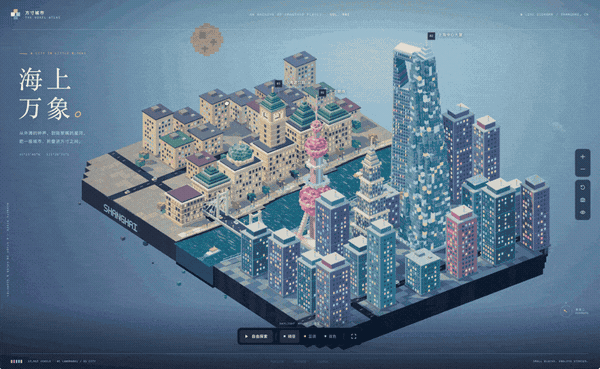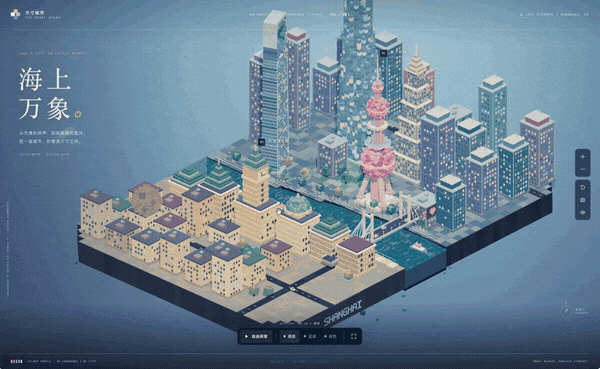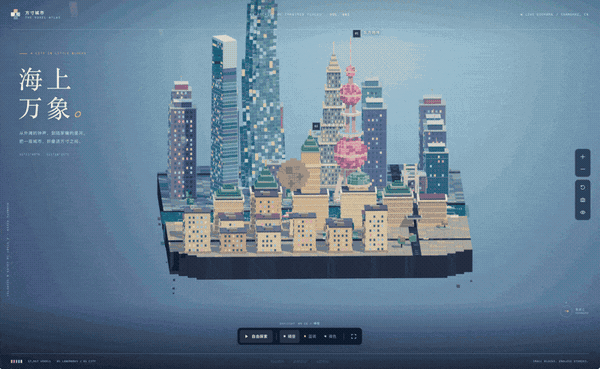
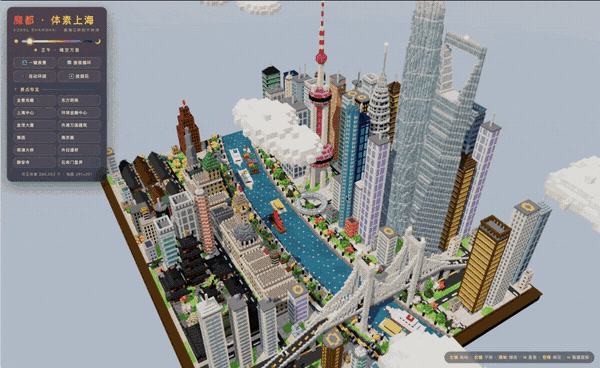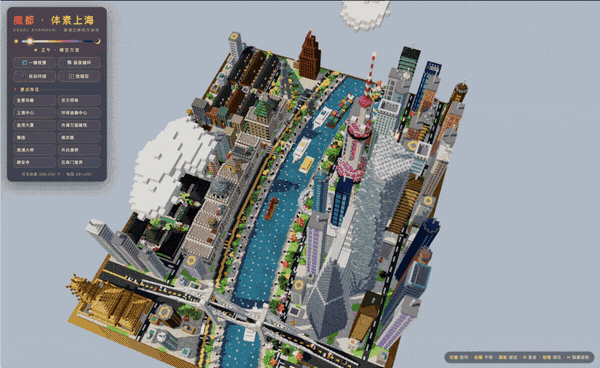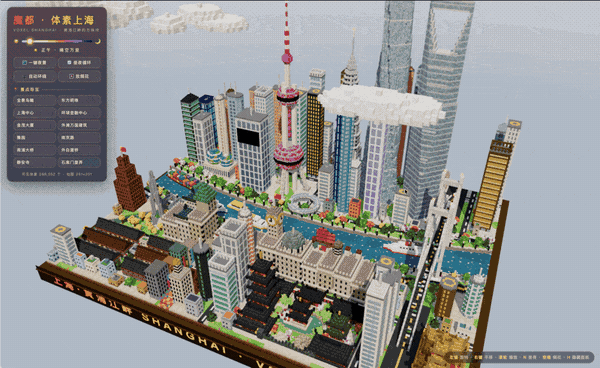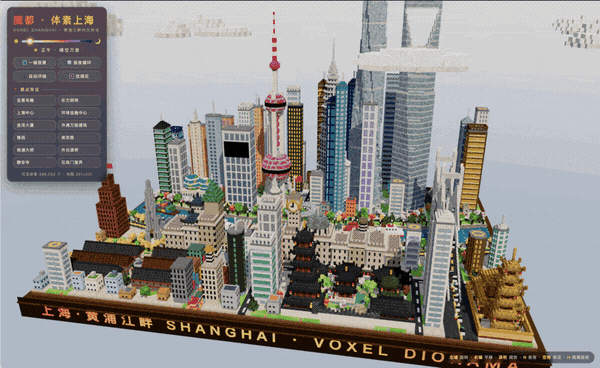
还有一个case 是画一个上海风景的体素艺术:
对比一下这是Opus 5.5 出来的时候,我测的效果:
最后写点
OKK,以上case并不能直接反应模型真实情况。
模型真实的表现仍然需要在实际的各项任务中大量使用之后才知道。
好啦,今天的分享就先到这儿了!等我有时间做了更多的测试再来跟大家反馈!
以上,
JOTO 企业落地观察
- 企业部署代码智能体时,Kimi K3.1 Pro在Terminal Bench 4.0取得65.7分且成本最优,意味着团队可在同等预算下获得更接近Opus 5.5的代码生成能力,尤其适合需高频调用、对延迟敏感的CI/CD集成场景。
- 3D建模能力突破至Bench CAD 92.7分,且支持直接生成Blender/CAD脚本,表明这类系统可实质性替代部分轻量级人工建模环节;但其仍依赖工具链配合,企业在构建端到端3D智能体时需同步规划工具注册、权限管控与执行沙箱。
- 网络安全能力得分为81分但明确落后于发布超三个月的闭源模型,反映出其漏洞推理尚处追赶阶段;企业若将此类模型用于红蓝对抗辅助或自动化渗透测试,必须将其置于严格的人机协同流程中,禁止独立决策输出。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们