Kimi K3.1 Pro:智能前沿,更进一步
月之暗面正式发布 Kimi K3.1 Pro,3 万亿参数模型,支持 100 万上下文。该模型在代码、3D 创作、金融研究及长程 Agent 能力上显著提升,在 Terminal-Bench 4.0 得分 65.7%,BenchCAD 得分 92.7%,OfficeQA Pro v2 达当前最优成绩(SoTA)。同步推出高速版 K3.1 Pro Highspeed,输出速度约快 2~3 倍。模型已开放 API 及多端使用,并将于 11 月 4 日前发布完整权重。
The only way of discovering the limits of the possible is to venture a little way past them into the impossible.
发现「可能」之极限的唯一方法,是向「不可能」的方向多走一小步。
阿瑟·C·克拉克《未来的轮廓》
Kimi K3.1 Pro 正式发布
今天,我们正式推出 Kimi K3.1 Pro,这是 Kimi K3.1 系列的第一个模型,也是我们迄今能力最强的 3 万亿级参数模型,支持 100 万上下文。Kimi K3.1 Pro 在代码、3D 创作、金融研究和其他长程 Agent 能力上的提升尤为显著。
我们同步推出高速版模型 Kimi K3.1 Pro Highspeed,同等智能,输出速度约 2~3 倍。
即日起,可通过 kimi.com、Kimi App、Kimi Work、Kimi Code 和 Kimi API (platform.kimi.com),使用 Kimi K3.1 Pro 和 Kimi K3.1 Pro Highspeed 模型。完整模型权重将于 11 月 4 日前发布。
持续突破前沿
Kimi K3.1 Pro 是 Kimi K3 的后训练版本,后训练算力大幅增加。为了支撑数百个下游领域的大规模联合训练,我们优化了技术栈的每一层,包括 RL 框架、长上下文推理、训练效率、沙箱基础设施、调度系统,以及用于环境质量检查的共享平台等,确保每一份新增的 RL 算力都能转化为稳定、高效的回报。最终,Kimi K3.1 Pro 模型在所有领域都获得了大规模 RL 带来的全面提升。
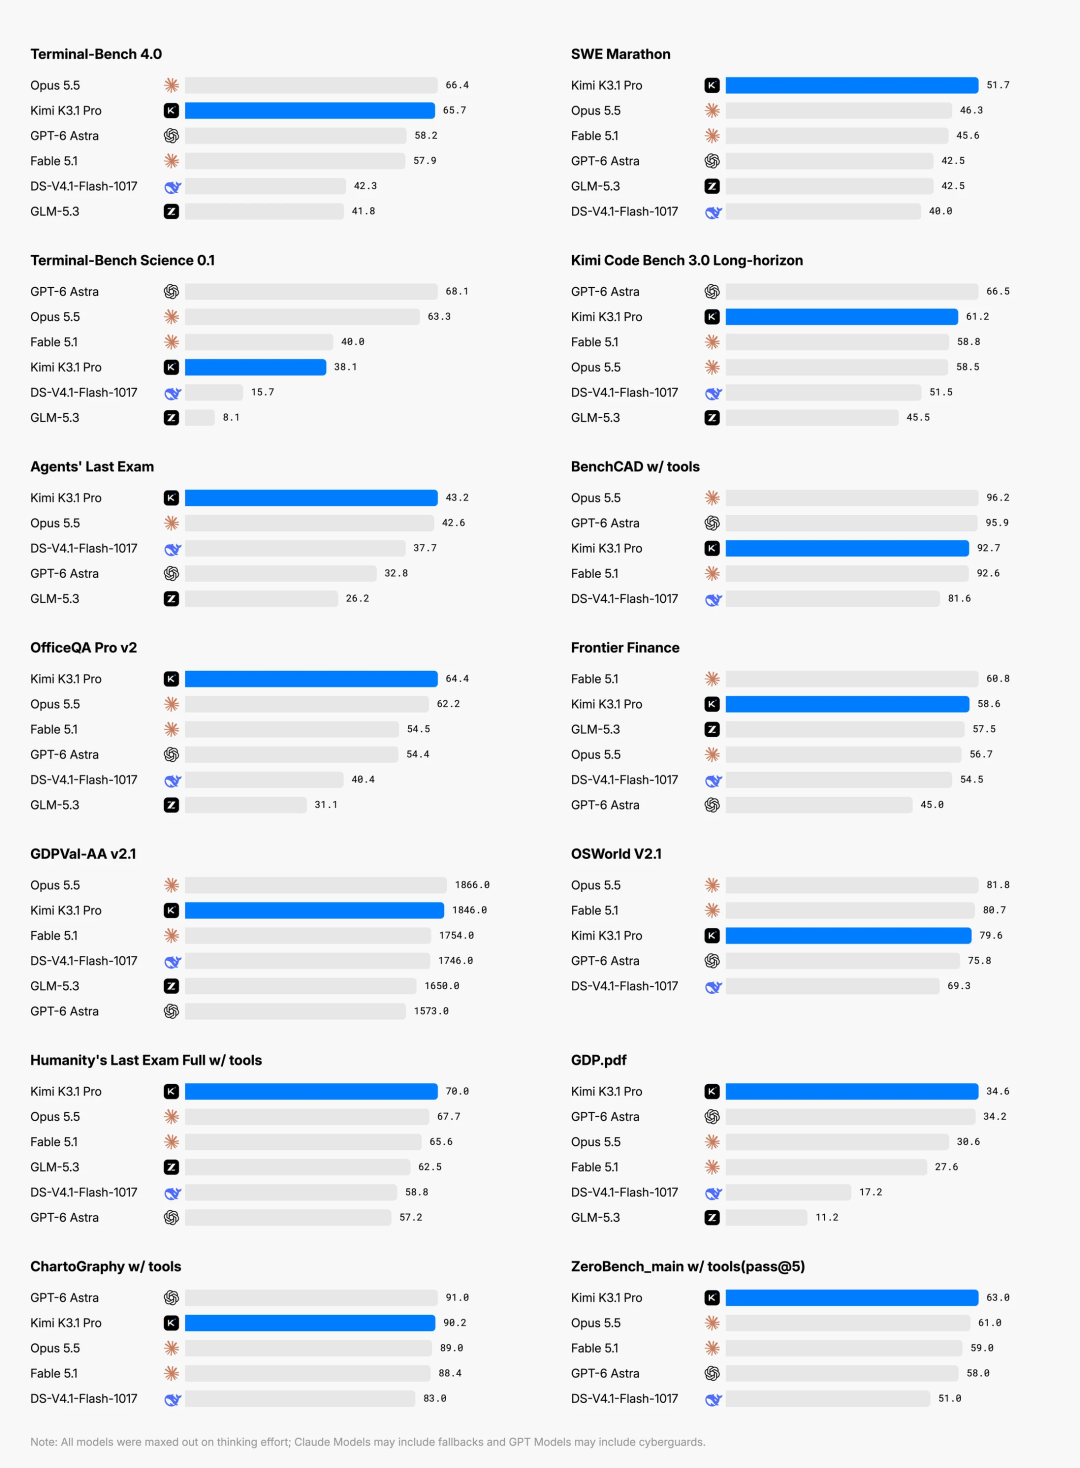
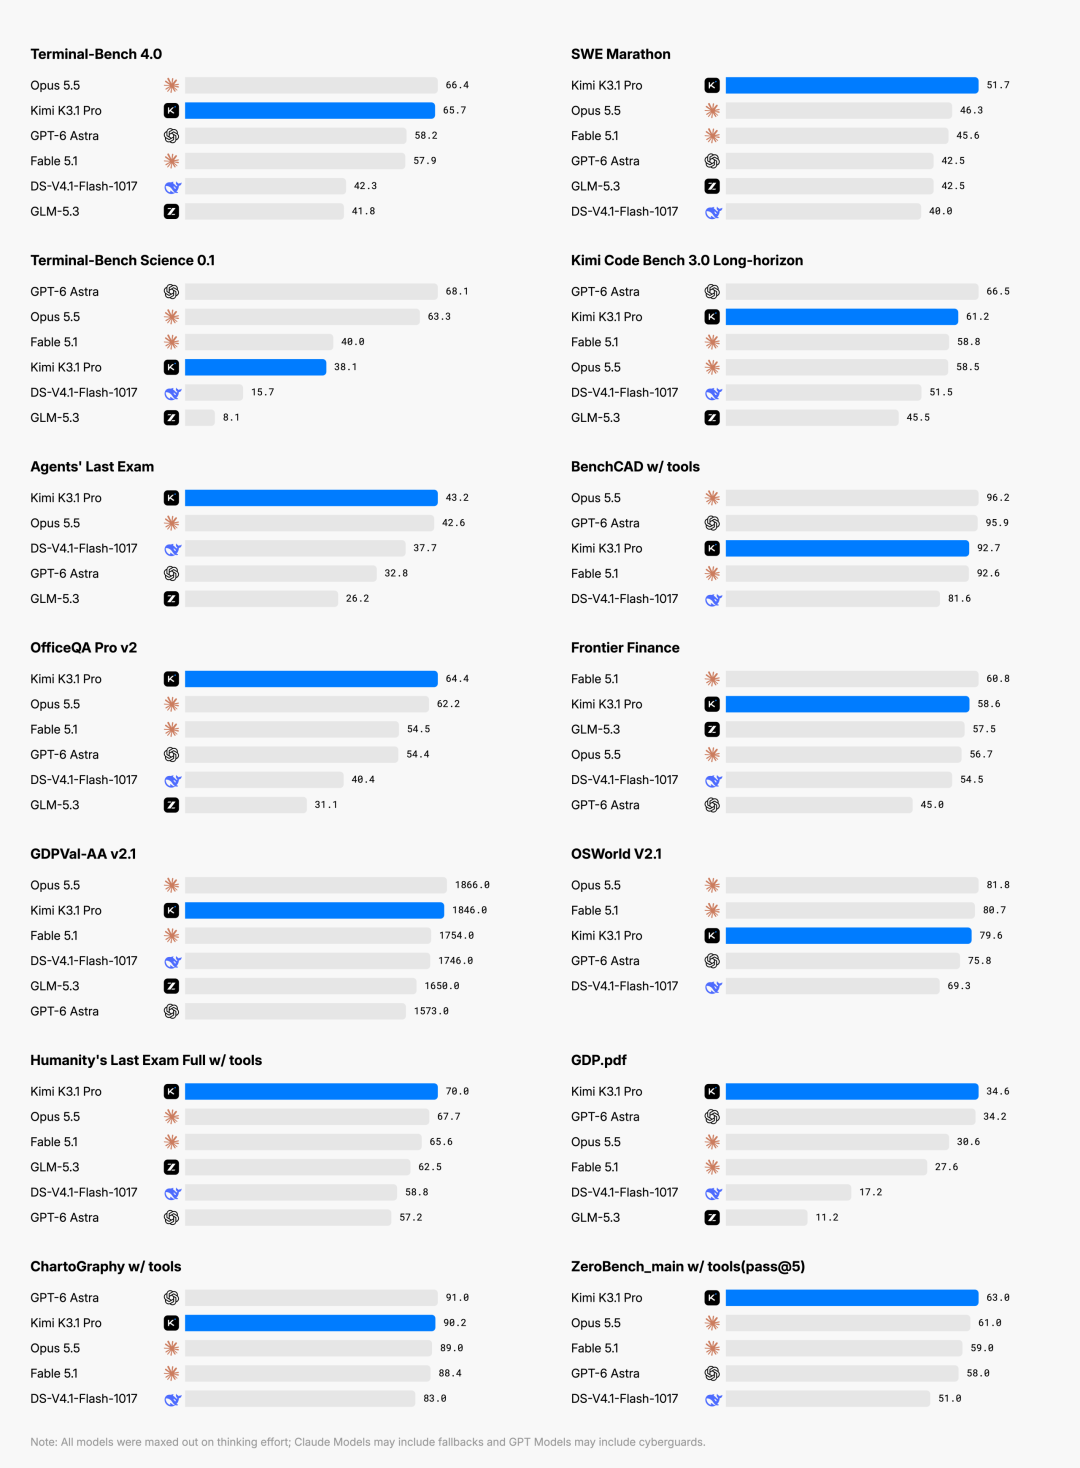
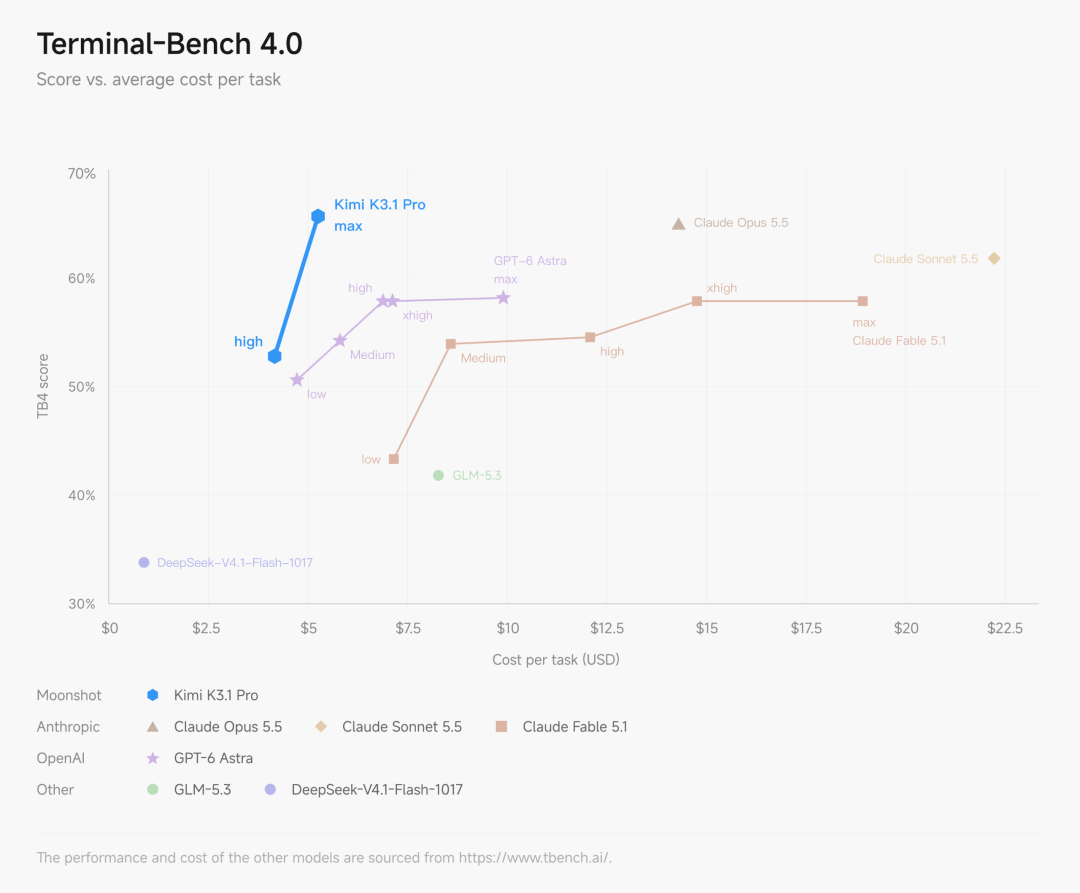
在代码、Agent 和知识类基准上,K3.1 Pro 达到或接近最强闭源模型的水平。Terminal-Bench 4.0 通过真实环境中资源受限的终端任务考察编程智能体的能力,每项任务均设有严格的专项测试。K3.1 Pro 在此项评估中得分 65.7%,超过 GPT-6 Astra(58.2%),与 Claude Opus 5.5(66.4%)仅有微弱差距。Kimi Code Bench 3.0 Long-horizon 是我们内部的基准测试,覆盖多种工程领域,重点考察编程智能体的多步执行、工具调用和端到端问题解决能力。K3.1 Pro 在这项测试中得分 61.2%,高于 K3 的 55.95%。
代码能力全面增强
Kimi K3.1 Pro 能胜任各种规模的编码任务:小到在真实代码库里修复一个问题,大到从零搭建一个完整项目。它也为游戏和网页体验带来更考究的视觉风格,并且知道如何用合适的外部专业工具把它们做出来。
K3.1 Pro 能熟练使用 Unity、Unreal Engine、Godot 等游戏引擎,并结合网络搜索与 3D 生成,做出完整的体验。它产出的前端页面、Three.js 交互场景和 3D 资产,在构图、排版、动效和细节打磨上都有明显提升。以下案例均由 K3.1 Pro 端到端完成:
- 基于虚幻引擎的天宫对战游戏:Kimi K3.1 Pro 在虚幻引擎 5.8 中建起一座云海之上的东方神话天宫:半径 1,750 米、36 开间的柱廊由 Blender 程序化建模,3,600 万源三角形经 Nanite 与 Lumen 渲染。外部素材:Cloud Forge VDB 云、Poly Haven/ambientCG 8K 材质、NASA LRO/LOLA 月球数据。
- Godot 3D 冒险游戏:Kimi K3.1 Pro 用 Godot 4.7.2 构建了一款风格化 3D 动作冒险游戏:五个可探索区域,包含程序化地形、道路、水系、植被与村庄布局,并有第三人称战斗、两阶段 Boss 战、采集、昼夜循环和篝火快速传送。外部素材:Quaternius 自然与村庄素材包、KayKit 角色及动画包、Kenney Survival Kit 等。
- 3D 机械臂展示落地页:Kimi K3.1 构建了一个浏览器内的 3D 机械臂展示页,包含分解视图、透明外壳与剖面效果;2,317 个零件和 268 条动态走线全部由代码生成。
通过大规模强化学习,K3.1 Pro 的长程编码能力也得到了充分的增强。在一项内部测试中,K3.1 Pro 基于包含 296 个骨骼组件(含软骨)和 402 个肌肉组件的开源人体解剖学模型,构建了一套集成训练与评估流程的人类行走动力学仿真器。在进行 167 项任务、420 次独立评审的过程中,它持续分析实验结果、定位问题并迭代优化行走控制器,推动仿真人体从最初几步内便倒地,进步到能够交替迈步、连续行走 11.2 秒。当调整奖励机制仍无法改善手臂运动时,K3.1 Pro 没有停留于此,而是转而对仿真器动力学进行开环探测,实现问题定位并修正了肩部肌肉力臂计算中的 36 处错误,随后重新训练了控制器。
3D 建模能力跃升
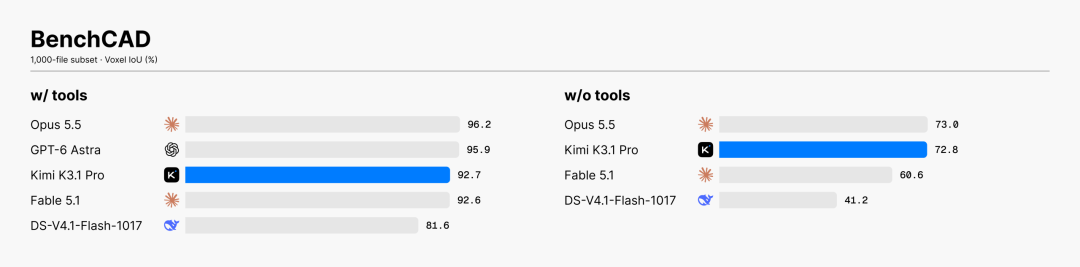
Kimi K3.1 Pro 模型擅长 3D 创作与空间推理。在 BenchCAD 基准测试中,K3.1 Pro 借助工具得分 92.7%,接近 Claude Opus 5.5 的 96.2% 和 GPT-6 Astra 的 95.9%。该基准考察通过生成 CAD 代码,从多视角渲染图重建 3D 模型的能力。给 K3.1 Pro 一段文字描述、一张草图或一张参考图,它能推断出物体的形状、比例和空间关系,并将其重建为可用的 3D 模型。它对现有素材库和模型库也有更强的理解。
K3.1 Pro 擅长参数化建模,例如机械零件、建筑模型、多参数可配置的产品和定制家具。无需依赖 MCP 连接器,它可以直接编写并运行 Blender、CAD 等专业建模工具的脚本,完成素材的构建与细化,修改单个部件,并调整几何、材质与场景布局。
以下案例均由 Kimi K3.1 Pro 端到端完成,可直接用于品牌宣传片、游戏和交互式网页体验:
- Blender 机场建模:Kimi K3.1 Pro 在 Blender 中搭建了一座机场的室内雨林谷,产出一段 17.5 秒、1920×1080、60 fps 的建模展示视频。使用工具:Blender、Python、Geometry Nodes、Cycles、Pillow、NumPy、FFmpeg。外部素材:Poly Haven 的「Kloofendal 48d Partly Cloudy (Pure Sky)」4K HDRI(作者 Greg Zaal 与 Jarod Guest,CC0 协议),用于天空光照与环境反射。
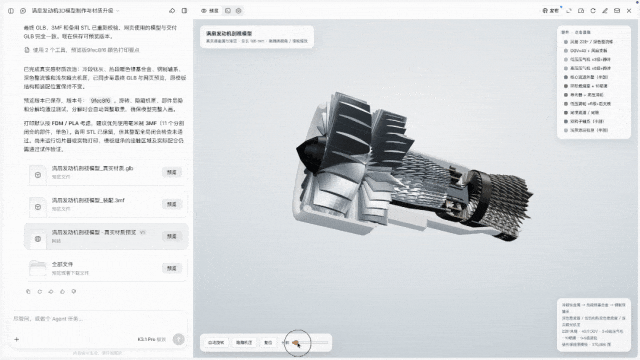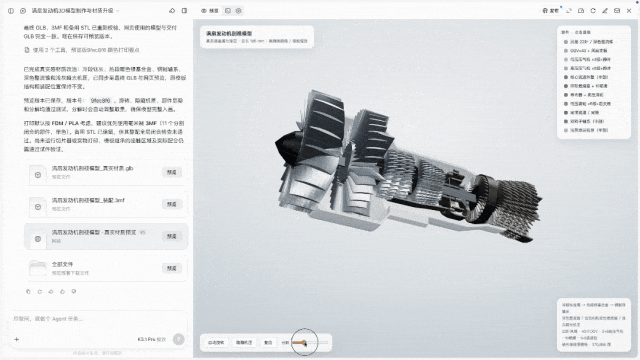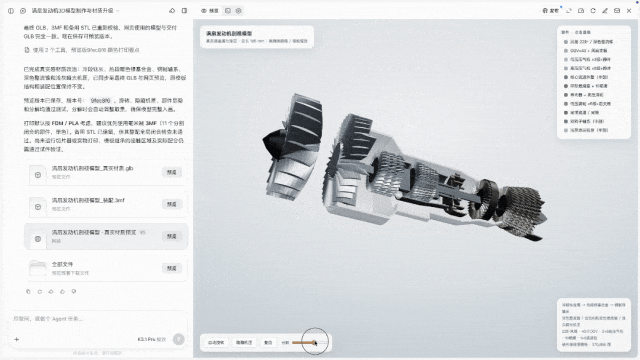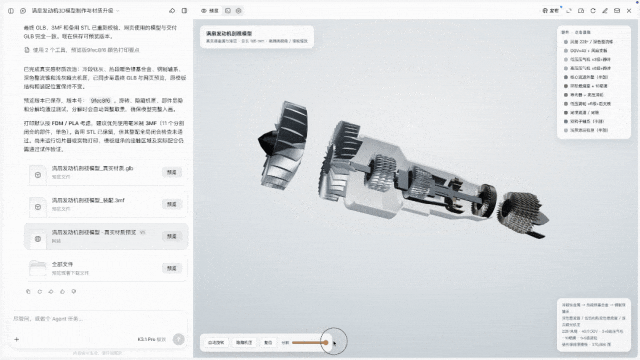
- FreeCAD 涡扇发动机建模:Kimi K3.1 Pro 用 Python 在 FreeCAD 中构建了一个精细的涡扇发动机模型,涵盖风扇、减速齿轮箱、压气机、燃烧室、涡轮与外部管路,共 2,100 个实体。模型支持分步装配和内部分解视图,并可演示风扇、低压转子、高压转子分别以 2,780、8,590、12,400 RPM 运转的旋转动画。
- Trimesh 3D 打印台灯:Kimi K3.1 Pro 用 trimesh 设计了一盏五部件、可直接 3D 打印的台灯,灵感取自福建土楼,将其标志性的圆形建筑形态重新演绎为精巧的镂空格栅。
kimi.com 和 Kimi app 已同步上线 3D Make 功能,支持在线预览和编辑 3D 模型,做好的模型可以直接下载去 3D 打印,也能导出视频或实况照片,随手分享到社交平台。
金融研究能力达当前最优
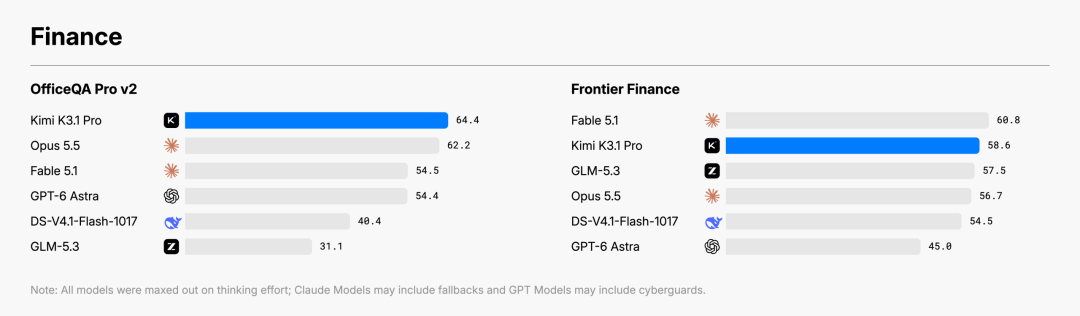
凭借更强的推理与工具调用能力,Kimi K3.1 Pro 能够端到端交付完整的金融工作流。在外部基准上,K3.1 Pro 在 OfficeQA Pro v2 基准测试中得分 64.4,取得当前最优成绩(SoTA)。OfficeQA Pro v2 考察基于真实金融文档的复杂财务数据分析,涉及检索、跨文档核对与多步数值推理。K3.1 Pro 在 Frontier Finance 上的表现也较 K3 进一步提升。该基准测试衡量模型对完整投资工作流的支持能力,覆盖从标的筛选到盈利分析的全过程。
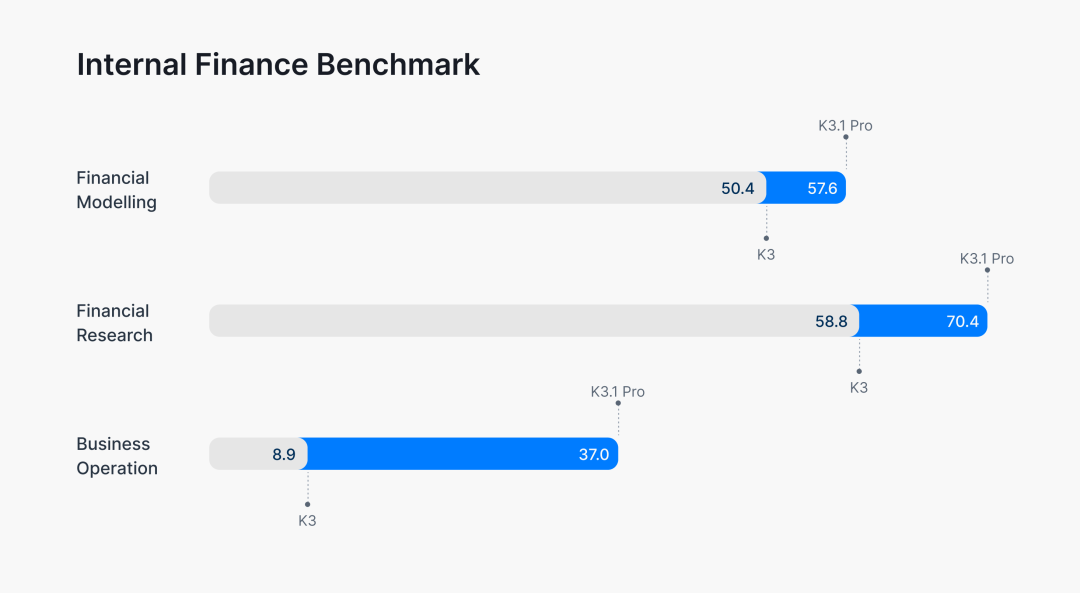
在 3 个内部金融基准上,K3.1 Pro 同样全面超过 K3:
- 财务建模基准 Financial Modelling 考察真实建模任务中的公式联动、财务逻辑与最终工作簿质量,K3.1 Pro 较 K3 提高 14%。
- 金融研究基准 Financial Research 用于检验模型能否完成真实场景下的金融研究工作,并在证据与截止条件约束下输出可核验的结果。K3.1 为较 K3 提升 20%。
- 商业运营基准 Business Operation 在模拟商业环境中考察长程经营管理与决策能力,K3.1 Pro 得分约为 K3 的 4.2 倍。
以下案例展示了 K3.1 Pro 在实践中如何处理财务建模、投资分析与基于真实来源的研究工作:
- 财务建模:Kimi K3.1 Pro 能端到端交付专业级英伟达(NVDA)财务模型,公式全部联动,每项假设都有充分依据。它像分析师做项目一样建模:经营驱动因子可随情景调整,敏感性分析直接呈现对估值的影响。
- 投研演示文稿:Kimi K3.1 Pro 制作了一份宁德时代的投委会报告,发现与市场一致预期的预期差,复盘财报表现,梳理未来路径。它按分析师论证观点的方式组织材料:故事线先行,对比呈现预期差,业绩对照指引复盘,前瞻梳理催化因素。
- 行业深度研究报告:Kimi K3.1 Pro 完成了一份量子计算行业报告,论证一致预期的偏差所在,对照指引复盘业绩,分析财报后的路径,所有引用均可溯源。它像分析师一样产出机构级深度研究:预期差有据可依,业绩复盘与前瞻分析齐备,每个数字和引用都可追溯至一手来源。
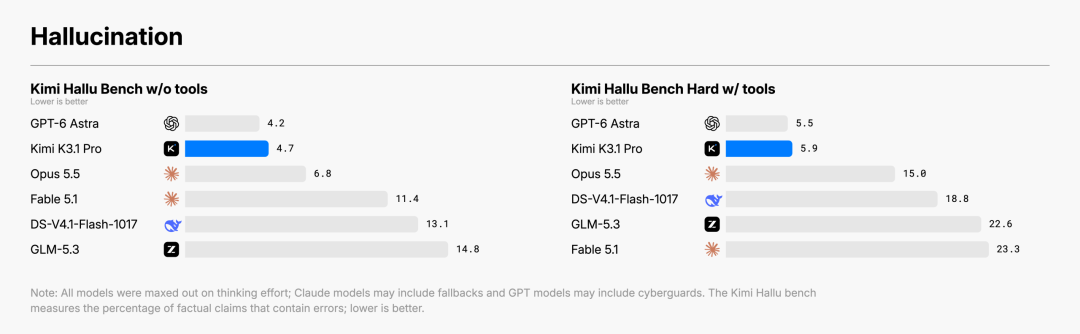
金融分析和投资研究对事实准确性有很高要求。为此,我们针对高难度真实工作场景和高难度提示词,对 K3.1 Pro 的事实准确性进行了专项优化。Kimi Hallu Bench Hard 是一项专门针对事实准确性开展的内部压力测试。在该测试中,新模型的单项事实陈述错误率从 K3 的 23.4% 降至 8.3%;包含至少一处事实错误的回答比例仅为前代的约 42.4%。(这是一项针对事实准确性的压力测试,样本刻意聚焦模型容易出错的情形,所报告的错误率不代表日常使用中的整体水平。)
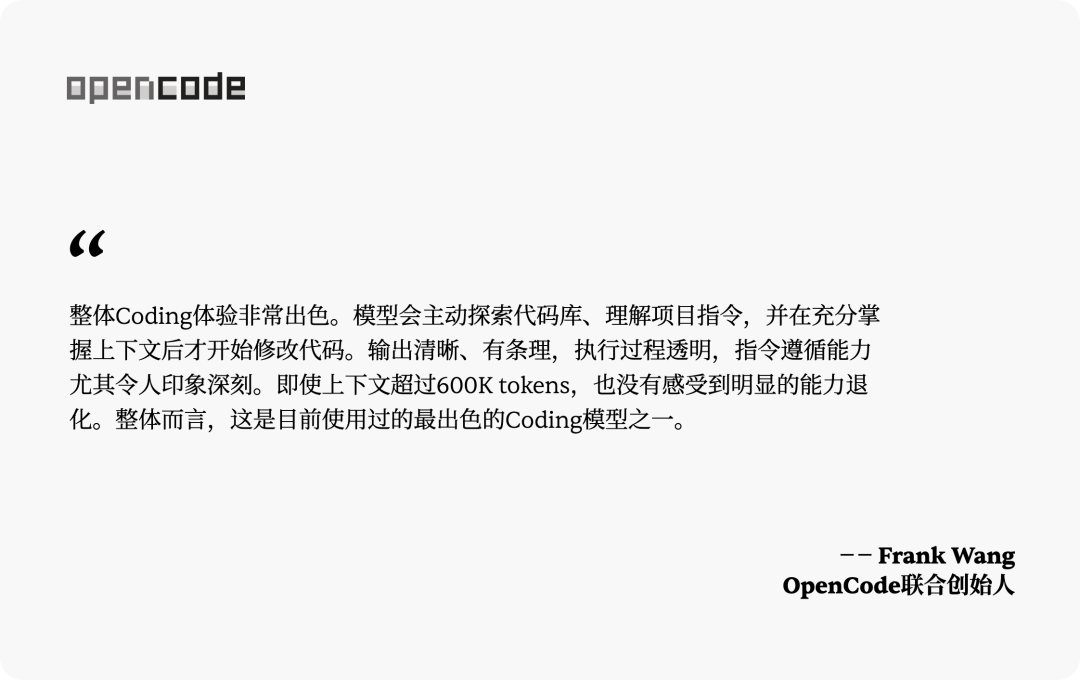
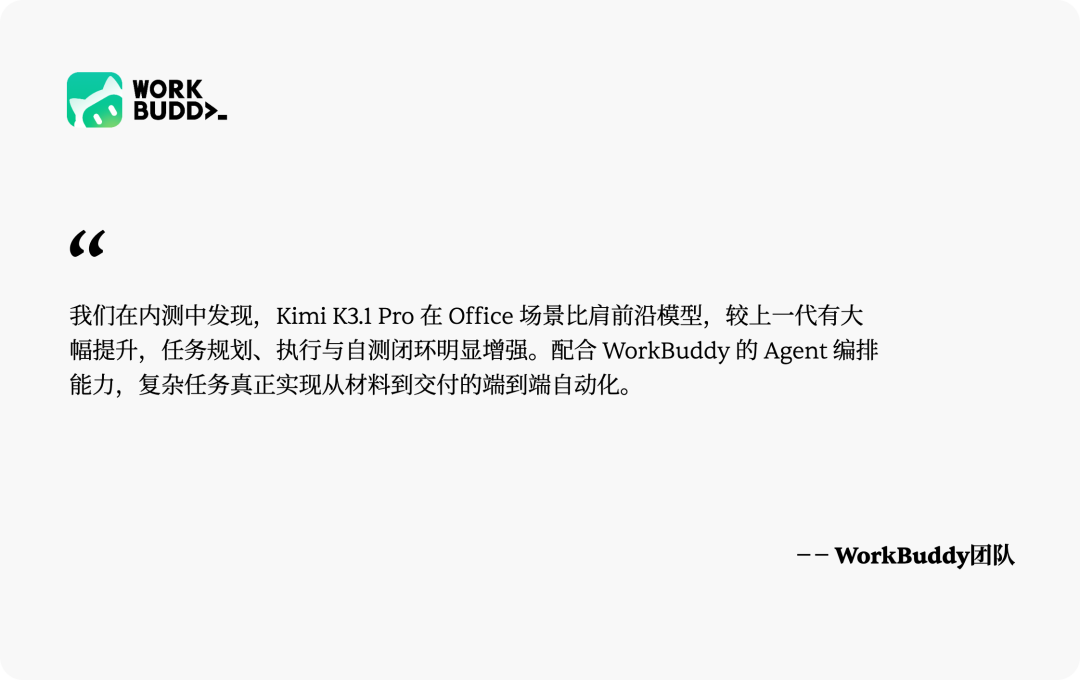
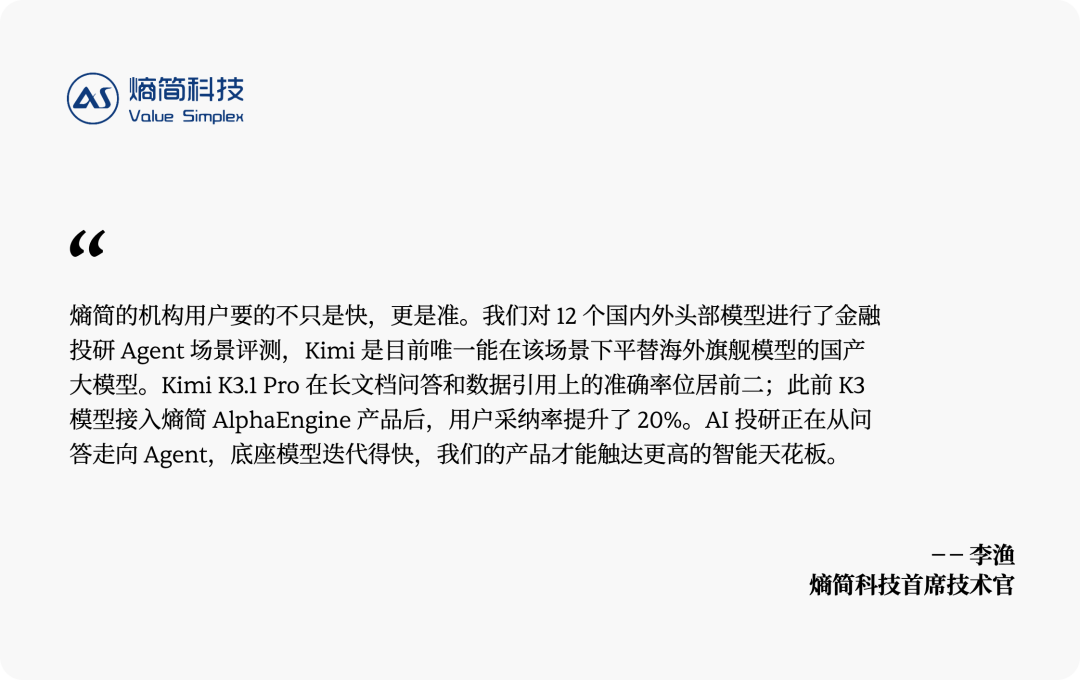
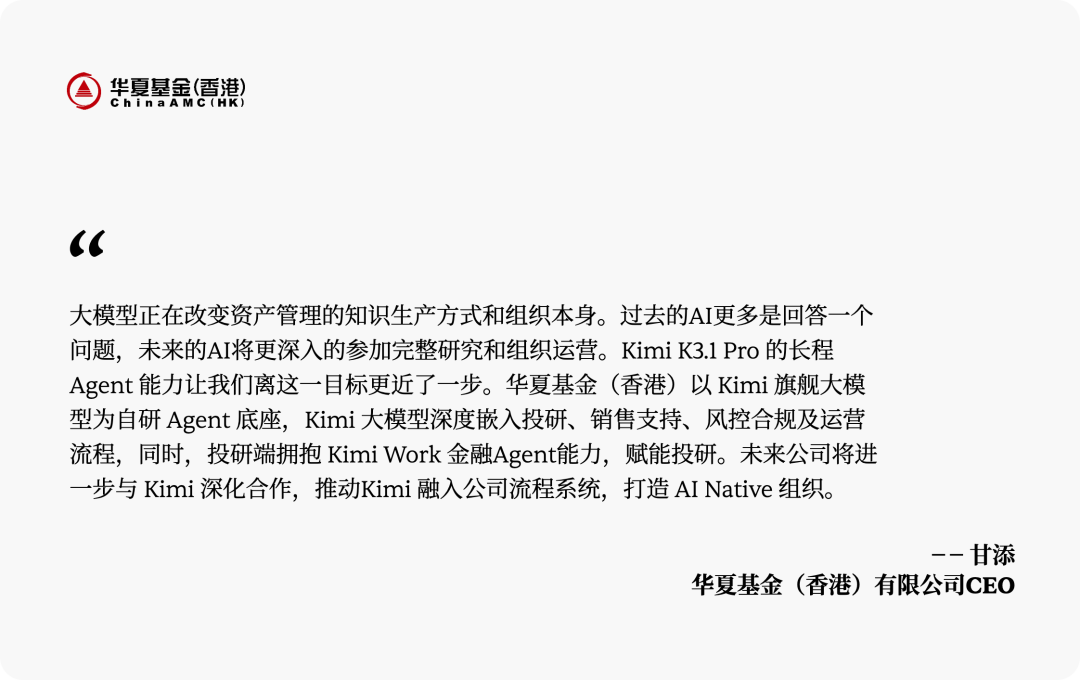
参与早期测试的伙伴发来了他们对 K3.1 Pro 金融能力的反馈:
网络安全能力可控演进
随着 K3.1 Pro 的能力不断提升,我们将更多精力投入到了解其网络安全能力的来源,以及我们能在多大程度上对其进行管控。为此,我们分析并评估了 K3.1 Pro 的漏洞研究能力,同时在训练过程中实施了针对性控制,在降低潜在滥用风险的同时,保留模型的通用实用性。
识别并移除网络攻防相关数据。在开发过程中,我们观察到随着后训练规模扩大,模型的漏洞研究性能持续提升。追溯这一趋势的来源,我们发现网络攻防相关内容嵌入了中期训练的通用语料中,网络攻防相关任务也存在于强化学习环境组合里。这是使用广泛数据进行训练带来的自然副产品。在内部模型的初步实验中,我们发现若在中期训练和强化学习阶段均不移除相关数据,下游网络攻防能力将大幅增强。这些发现为我们提供了具体的控制手段。在准备发布 K3.1 Pro 开放权重版本时,我们从两个训练阶段均识别并移除了网络攻防相关数据,同时保留了保障模型实用性所需的通用编程任务。我们未来将在每一训练阶段持续采取适当的控制措施,网络攻防相关数据的识别与限制便是其中之一。
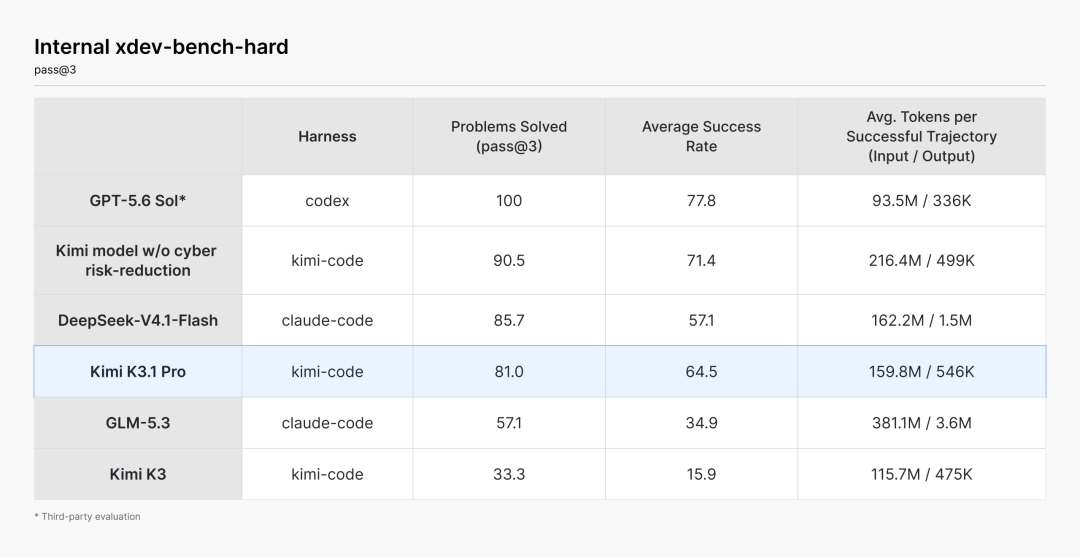
评估与结果。完成数据清理后,我们使用自研的 xdev-bench-hard 基准测试对 K3.1 Pro 进行了评估。该测试由专家策划,包含基于源代码的漏洞发现与利用任务,并经过校准以在当前能力水平上实现有效区分。多数任务真实复现了 Linux 内核、Node.js、JavaScriptCore、Exim 和 VirGL 等软件中近期披露的漏洞,且各项缓解措施均已启用。每项任务提供存在漏洞的源代码、简短提示以及对应的二进制文件。智能体需要开发出漏洞利用程序,在独立沙箱中实现任意代码执行,并获取密钥字符串以通过自动验证。我们报告了 pass@3 指标,未设置严格超时或输出 token 上限。
在 xdev-bench-hard 上,若中期训练和强化学习阶段均未对网络攻防相关数据进行移除或过滤,模型在 pass@3 指标上可解决 90.5% 的问题;最终版 K3.1 Pro 的得分则为 81.0%。对比表明,数据移除有效降低了漏洞研究能力,使其明显低于同一训练流程原本会产出的水平。与此同时,K3.1 Pro 仍较前代实现了大幅提升,说明即使在针对性移除相关数据后,更强的通用编程和长周期调试能力仍能泛化到此类任务上。K3.1 Pro 的网络攻防能力目前仍落后于那些已公开发布至少三个月的前沿闭源模型。我们将持续完善内部基准测试,确保在模型能力不断提升的同时,评估结果仍有参考价值。
开放权重原则。这些评估构成了我们发布开放权重版本的决策依据。首先,我们不希望发布推进网络攻防能力绝对前沿的开放权重。根据设计,K3.1 Pro 的攻击性安全能力低于原本训练流程会产出的水平,且仍低于前沿闭源模型。其次,我们计划渐进式提升开放权重中可用的网络攻防能力。我们相信,开放 K3.1 Pro 的权重,将更有益于出于防御目的而需要两用能力的群体。当能力强大的模型以开放形式提供,并能在用户可控的基础设施上运行时,更多团队将得以审查自身维护的代码,这其中包括那些极少接受专门安全审查的遗留系统。我们认为,让这一能力渐进式扩散,而非将其集中在少数闭源系统中,最终将使所有软件变得更加安全。
开始使用
使用 Kimi K3.1 Pro Agents:直接访问 kimi.com,或到手机应用商店搜索下载或升级到最新版 Kimi app,支持 iOS、Android 和鸿蒙系统。
与 Kimi K3.1 Pro 一起工作:下载最新版 Kimi Work 桌面客户端,支持 Windows 和 Apple 芯片的 Mac 电脑。
用 Kimi K3.1 Pro 辅助编程:Kimi Code 运行在你的电脑终端和桌面,选择 K3.1 Pro 模型即可开始体验。
接入 Kimi API 开发应用:访问 Kimi 开放平台(platform.kimi.com),模型选择 kimi-k3.1-pro,价格为每百万 Token 输入:1.3 元(命中缓存)和 13 元(未命中缓存),输出 68 元。高速版模型 kimi-k3.1-pro-highspeed,输出速度约 2~3 倍,价格 2 倍。
为员工提供 Kimi 订阅:Kimi 企业版支持企业级数据隐私保护、成员管理,个人账号与企业账号数据完全隔离。访问 kimi.com/membership/pricing 选择「企业版」标签页,即可在线为员工订阅 Kimi 会员。
快速搭建企业智能体应用:Kimi Hosted Agents(托管智能体)将支撑 Agent 运行的 Harness 作为云端服务提供。企业和开发者无需自行搭建和维护运行框架,即可获得 7×24 小时的托管环境,支持长程任务执行与多智能体高效协作。访问这里(platform.kimi.com/docs/hosted-agents/overview)了解更多。
加入企业合作伙伴计划:欢迎各行各业的 IT 服务商、集成商伙伴与 Kimi 共建前线部署工程师(Forward Deployed Engineer,FDE)队伍,深入客户现场,帮助企业把 AI 真正部署到核心业务中。
JOTO 企业落地观察
- K3.1 Pro 主动移除网络攻防数据的策略,为企业 AI 安全治理提供了可借鉴范式:能力封控不应仅靠推理时过滤,而应前置到训练数据清洗阶段,并辅以 xdev-bench-hard 类专用基准持续度量残留风险。
- 其 100 万上下文与长程 Agent 能力,对企业部署意味着需重构传统 RAG 架构——不再依赖“切块-检索-拼接”,而转向“长上下文+结构化记忆索引”混合模式,这对向量数据库选型与 prompt 工程提出新要求。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们