OpenAI 的新界面,41 小时就被人复刻完了
OpenAI 于10月7日发布 Intelligent UI(DIL),一种让模型生成可执行前端程序的交互范式;41小时内,开发者完成协议级逆向、开源复刻并上架DSH插件。该方案采用沙箱执行模型生成的代码,实现本地实时响应,与传统‘模型写组件清单’方案有本质差异。复刻虽快,但组件能力层(如机票卡、医疗计算器等283个产品级组件)依赖私有资产,无法同步复制。
我让人把 OpenAI 刚发布的东西装到自己机器上跑了一遍。它跑起来了,而且我当场找到了一颗雷。
一件让我改口的事
10 月 7 日,OpenAI 给 ChatGPT 推了一个叫 Intelligent UI 的东西。简单说:回答不再是一段文字,而是一个能操作的界面。你问"帮我算房贷",它给你的不是一个数字,是三个滑块加一张对比图,你拖滑块,月供当场变。
我第一反应是去看开源有没有跟上。看完第一轮,我给了个结论:没有,DSH 这边一条都没有。
这个结论是错的。错因很具体:我只检索了 DSH 的主库,没检索它的插件生态。插件本来就不在主库里,用主库查不到就推"生态没有",这是无效推理。
被打回来之后,我重新查了一遍。结论完全反转——不是没有,是早就有了,而且快得离谱。
41 小时
从 OpenAI 发布,到有人在 DSH 上把这条路复刻出来,中间隔了41 个小时。
时间线是这样的:
- 10 月 7 日:OpenAI 发布 Intelligent UI,内部代号 DIL。
- 10 月 8 日 09:21:一个叫
intelligent-ui-demo的仓库上线。它不是"看着像",是协议级逆向——作者抓了自己账号的一次真实对话,1515 条抓包记录,把整套协议拆了出来:模型写什么、服务端怎么编译、客户端在什么沙箱里跑、状态怎么回传。仓库里有 36KB 的分析文档、可运行的复刻、98 个测试。 - 10 月 9 日 00:43:
dsh-intelligent-ui挂上 npm。它把上面那份复刻 vendor 进来,做成了 DSH 插件。
从发布到插件上架,41 小时。
这还只是台面上那一份。同一时间窗口里冒出来的同类仓库有19 个。其中一个建仓 22 小时内推了49 次提交,另一个 14 小时32 次。
两条路,不是好坏之别
真正值得说的,是这两条路根本不是一回事。
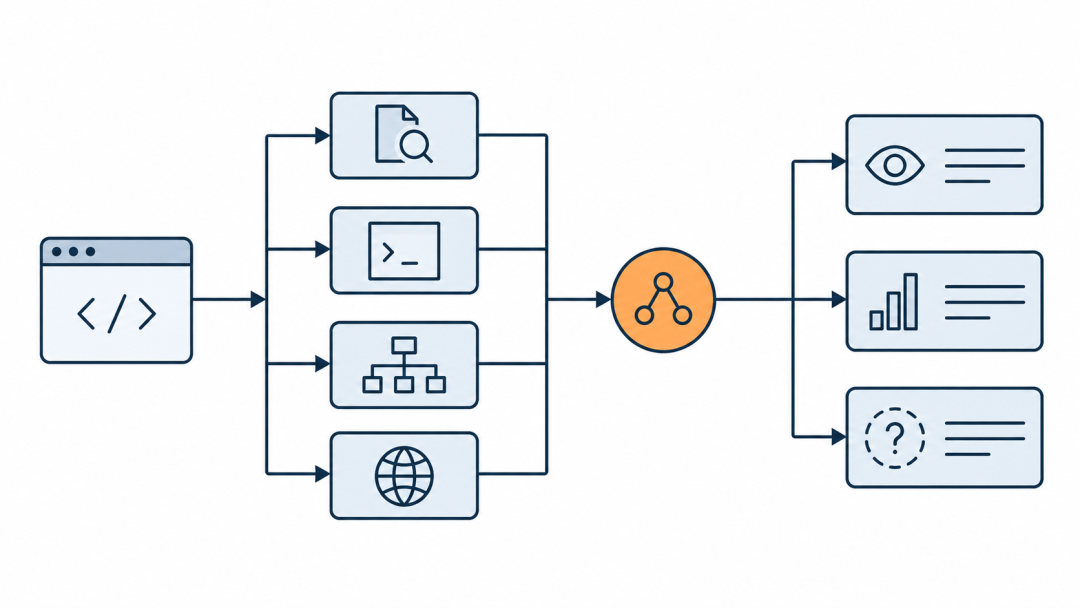
我原本用的那套生成式界面(DSH 上的 genui 插件),走的是"让模型写数据":模型吐一份组件清单——"这里放一个滑块,叫贷款金额,范围 10 到 500;那里放一行文字,显示月供"。宿主拿到清单,用自己已有的组件拼出来。
问题在哪?清单里只有"要什么",没有"怎么算"。你想把金额从 100 万改成 300 万?那个数字是模型算好写死的,你得回去再问它一轮。
OpenAI 走的是另一条:让模型写程序。模型写的是一段带变量的程序——"有个变量叫金额,有个叫年限,月供等于这个公式"。客户端拿到后真的执行它。
差别立刻就出来了:你拖滑块,浏览器本地当场重算,不经过模型。
更妙的是安全模型:那段程序跑在一个没有 DOM 的 Worker 沙箱里。它能让宿主帮忙画出界面,但没有任何路径去碰你真实页面上的元素。作者那句总结很精辟——沙箱是执行容器,不是显示容器。
我把它跑起来了
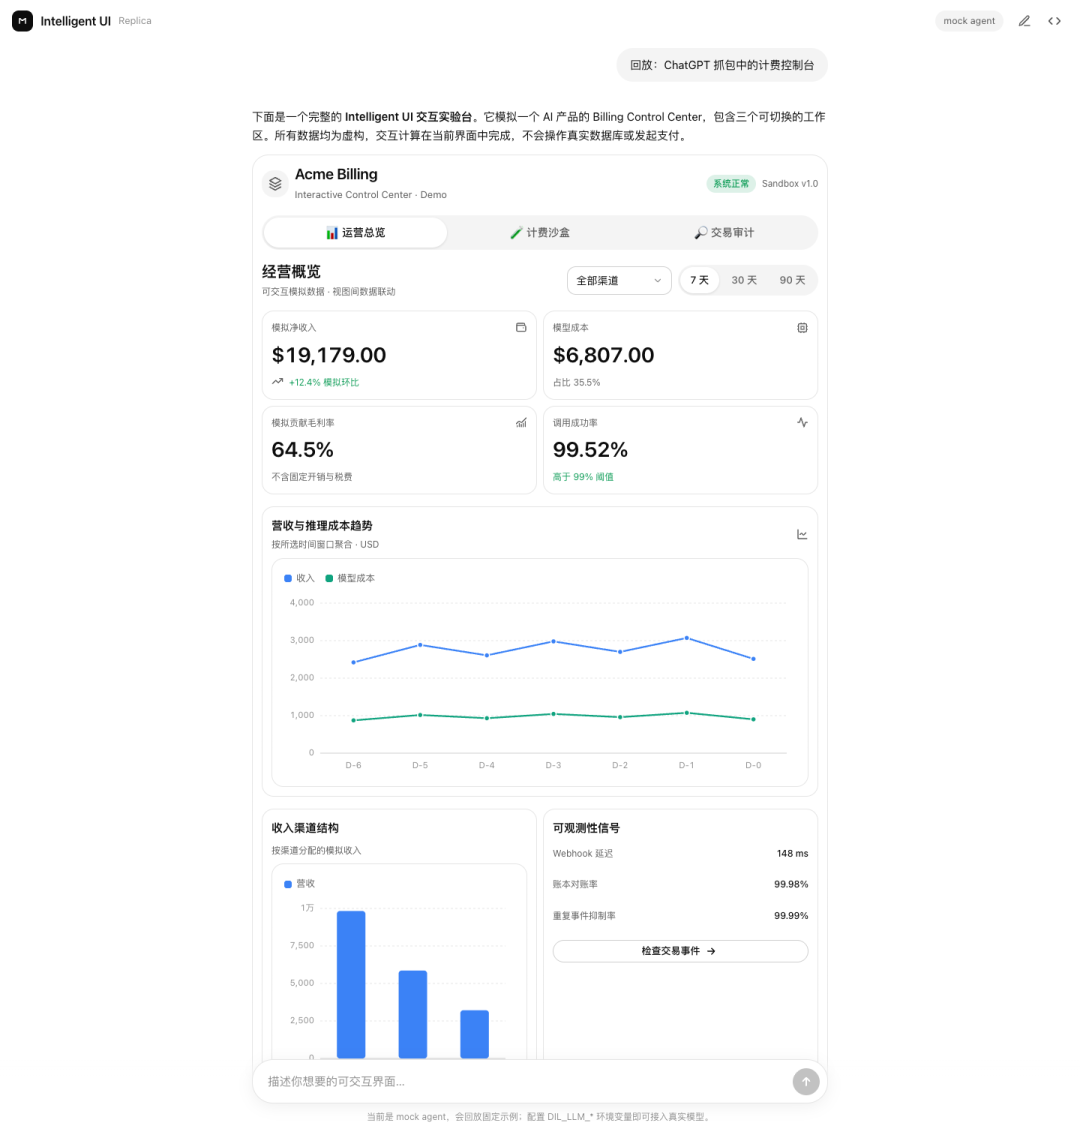
先看东西。这是抓包里ChatGPT 原版 DIL 源码在本地复刻上跑出来的画面——源码 23427 个字符,73 次流式编译,4.9 秒出画面:
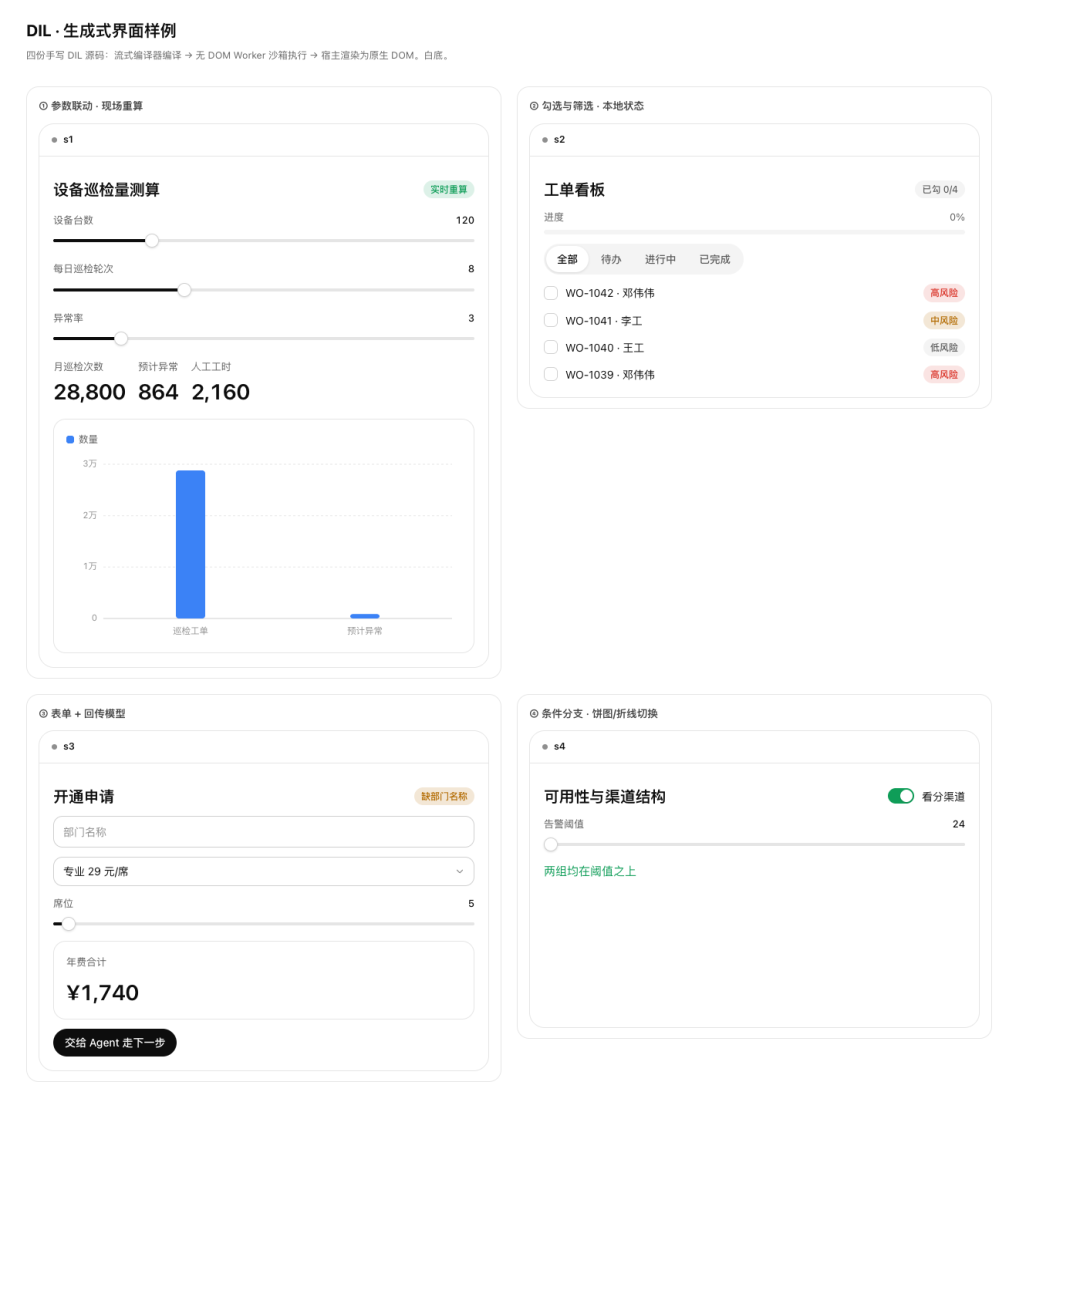
然后是我自己手写的四份 DIL 源码,覆盖四种典型交互:参数联动的测算器、带筛选的勾选看板、能填的表单、带条件分支的图表切换。四份全部编译零诊断、渲染成功,同屏长这样:
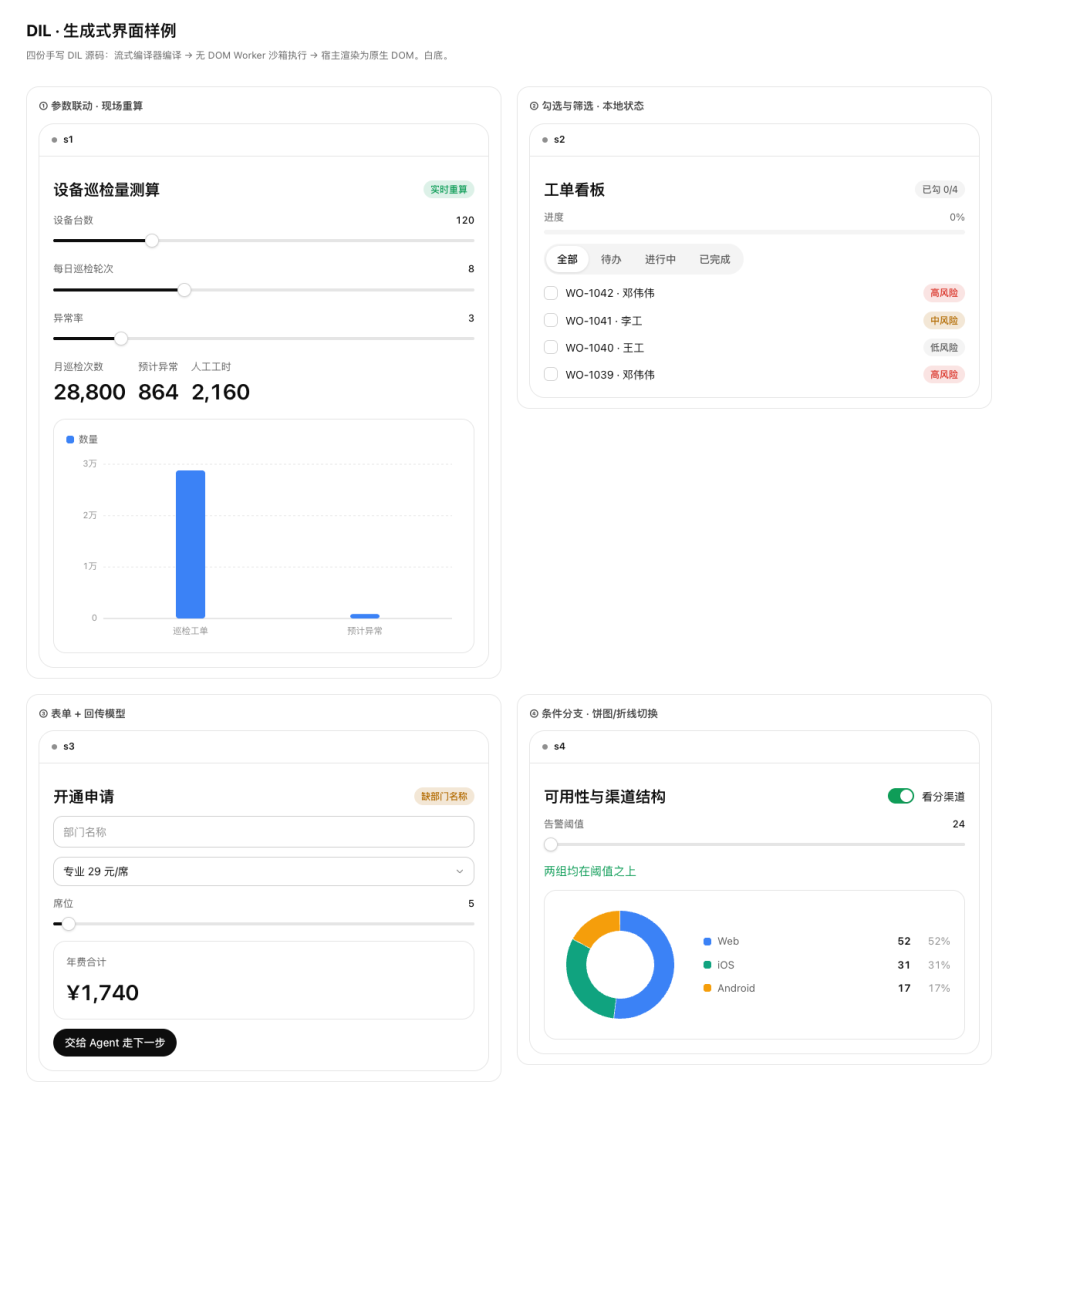
左上那个测算器,三个滑块拖一下,下面三个数字和柱状图当场重算;右上那个看板,勾选、筛选、进度条全在这一块界面里完成。这不是我给的设计稿,是引擎跑出来的真实渲染。
然后我踩到一颗雷
最后一份里我要画个饼图,出来的是一块空白。这就是当时的现场:
注意右下那块——图例老老实实列着 Web 52、iOS 31、Android 17,圆环里却一个扇形都没有。我打开 DOM 看,那个svg是挂出来了的,但childElementCount = 0:壳在,内容没有。
我第一反应是"可能视口不对"。换了写法,还是空的。又换成另一个标签,还是空的。
三次都失败之后,我停下来想:我是不是在拿"换个姿势再试试"掩盖问题?于是我直接写了个单测驱动那个渲染函数,把入参和产出打出来。真相一秒就出来了——
是这个复刻自己的 bug。饼图函数取分类名的那段逻辑,判断条件写反了:它先去取xAxis,取不到就回落到name键;而编译器生成的明明是value键。两边对不上,它就渲染出一堆零。
更值得说的是:它那 98 个测试,一个都没覆盖到饼图。测试全绿,功能哑掉。
这就是"测试通过"和"功能正确"之间的距离。
差在哪,我数了
我也顺手把"差距"量化了一下:
| 组件数 | |
|---|---|
| ChatGPT 的宿主组件库 | 313(30 个常驻 + 283 个按需) |
| 开源复刻 | 37 |
ChatGPT 那 283 个是什么,抓包文档列得很清楚:机票卡、天气卡、股票热力图、NBA 比分卡、餐厅菜单卡、学习闪卡、大约 50 个医疗计算器……
这份名单本身就是产品情报。它说明 OpenAI 干的事是:把过去两年做过的所有卡片组件,全部收编成了"生成式界面"的宿主组件库。
所以"能不能追平"这个问题,要分两层看:
- 协议层:模型写程序、沙箱执行、宿主渲染——这部分是纯代码,社区一周内能打磨得很顺。已经追上了。
- 能力层:那 283 个组件不是代码,是产品资产。机票卡背后是航司数据,股票热力图背后是行情源,医疗计算器背后是临床口径。这部分抄不走。
还有一条硬约束:这个复刻的 README 自己写明,它是对 ChatGPT协议版本 14的快照,上游随时会变。也就是说它是跟着别人的协议跑,不是自己定的标准。
我把这件事做进了闭环
光看一次不够。上游在快速演进,我看一次就下结论,跟前面那次翻车没区别。
所以我做了三件事:
第一,装。顺手修了一个拦路的问题——我本机 profile 里有个插件依赖指向了空目录,导致所有插件命令全线报错。修完之后把插件装进去了。
(这里也踩了个坑:装完后我 grep 配置文件,查不到插件名,我一度以为"没写进去"。后来才发现,那份配置根本不在磁盘上,是每次启动时现生成的——我一开始找错了地方。差一点又报一个错误的结论。)
第二,立单。走唯一立项口,给了工单号和验收标准。
第三,挂定时观测。在河源 1 号上装了两个定时任务:3 天后一次,一周后一次。到点自动去查上游有没有新版本、同生态仓库走到了哪、又新冒出来几个仓。查完自己出报告、自己推到飞书汇报我、自己写回项目台账。
我还给它做了正负控:
- 正控:正常跑,确认能出报告、能汇报、能记账。
- 负控:故意把上游地址改成一个不存在的包,它必须判UNVERIFIED(读不到),绝不能判成"无变化"。
为什么这条负控重要?因为"读不到"和"没变化"是两回事。机器读不到的时候如果默默报个"正常",那就是假绿灯——这种事我踩过不止一次。
最后
回头看这件事,让我印象最深的不是 OpenAI 做得有多好,是那个速度。
一个产品发布 41 小时之后,协议被拆开、复刻被写出来、插件被装上 npm、还有人连夜加了 49 次提交。而这件事发生的时候,我还在用着一套"让模型写数据"的方案,以为它就是这个形态的天花板。
代码框架级别的复刻,现在的速度是以小时计的。这不是一句感慨,这是我这次实测出来的数字。
(数据来自抓包文档、npm registry 时间戳、GitHub API 与机器留痕,非人工统计。)
JOTO 企业落地观察
- 对企业部署意味着,智能体前端交互能力的构建周期正从「月级」压缩至「小时级」,但企业若仅复刻协议层,将面临宿主组件库严重缺失的风险——313个官方组件中仅37个可开源复用,其余283个需对接真实业务系统与数据源,无法脱离产品化沉淀单独移植。
- 这类系统的取舍在于:是否接受「协议跟随型」架构。开源复刻明确标注为协议v14快照,上游变更即失效;企业若选择自建标准,需承担协议设计、沙箱安全加固、组件生命周期治理三重工程负担,但可规避对外部迭代节奏的被动依赖。
- 对RAG知识工程提出新要求:当模型输出从文本转向可执行代码,知识库需结构化存储组件语义契约(如'房贷计算器需输入金额/年限/利率,输出月供/总息/还款计划表'),而非仅存UI描述。否则RAG无法支撑模型生成符合宿主环境约束的可执行片段。
- AI安全治理需覆盖「执行态」风险。OpenAI方案将代码置于无DOM Worker沙箱,但企业自建时若简化沙箱机制(如仅做字符串白名单),可能使生成代码获得真实DOM访问权。此时传统内容安全策略失效,必须引入代码静态分析与运行时行为监控双校验。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们