当环境中同时存在鸣笛、交谈、脚步与背景噪声时,人类通常可以凭借双耳听觉,迅速判断“我想听的声音是什么”,以及“它来自哪个方向”。对机器而言,这仍然是一个同时涉及语义理解、声音分离与空间感知的复杂问题。
阿里 Qwen Audio 团队在语音顶会 ICASSP 2026 发表的论文 “LuSeeL: Language-queried Binaural Universal Sound Event Extraction and Localization”中提出一种自然语言驱动的双耳通用声事件提取与定位框架。核心思路可以概括为:让模型根据自然语言指令找到目标声音,同时利用双耳信号判断它来自哪里,并通过联合学习提升目标声音提取效果。
▎从“听出是什么”到“听出来自哪里”
通用声事件提取的目标,是从复杂混合音频中提取用户指定的声音。用户可以输入一个关键词、一组关键词,或一段自然语言描述,例如 “car horns”,模型就尝试从混合音频中分离出汽车喇叭声。
过去不少方法主要处理单通道音频,并依赖文本、视觉或音频提示来寻找目标事件。但在真实环境中,声音不仅有内容,也有空间位置:不同声源到达左右耳的时间和强度不同,这些差异携带着重要的方向信息。
因此,LuSeeL 关注的不是单纯的“声音分离”,而是一个更完整的空间听觉任务:
根据语言描述识别目标声事件;
从双耳混合信号中提取目标声音;
预测目标声源的到达方向(Direction of Arrival, DoA)。
这三个环节并不是彼此独立的。知道声音可能来自哪个方向,有助于模型在多个重叠声源中锁定目标;而更准确的目标提取,也能为方向估计提供更清晰的声学线索。
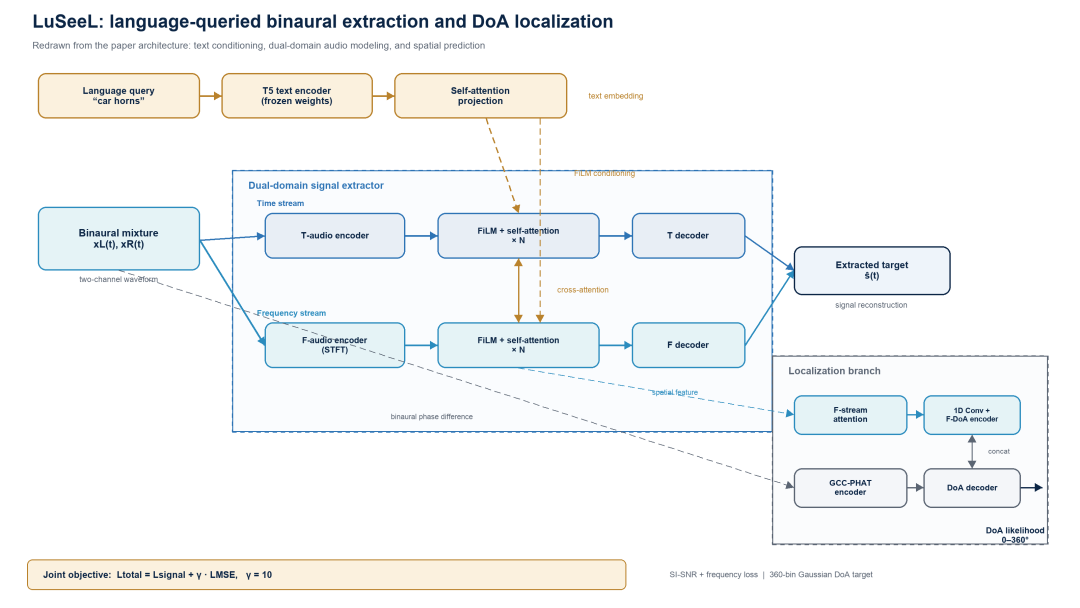
(图 1:LuSeeL 整体架构)
(图 1:LuSeeL 整体架构)
在模型结构设计上,LuSeeL 将“目标声音提取”作为主干,将“方向估计”作为共享表示之上的空间分支:文本查询先经过 T5 编码与注意力投影,再通过 FiLM 调制时域和频域音频流;频域注意力特征与 GCC-PHAT 双耳相位差共同进入 DoA 分支,最终输出 0~360° 的方向似然分布。
LuSeeL 的整体架构包含三个关键部分。
1. 用语言描述目标声音
模型使用 T5 文本编码器,将用户输入的关键词或描述转换为语义表示。随后,文本特征经过可训练的注意力层,与音频特征映射到适合跨模态融合的共享空间。
这意味着,模型不必局限于固定的声事件类别,而是可以通过自然语言指定目标,具备更灵活的“按描述听音”能力。
2. 在时间域与频率域同时分析双耳音频
音频部分采用双域混合 Transformer-Demucs 架构:一条路径在时间域处理波形,另一条路径在频率域处理短时傅里叶变换得到的谱表示。
两条路径之间通过交叉注意力交换信息,文本特征则通过 Feature-wise Linear Modulation(FiLM)注入到音频处理过程中。这样,模型既能关注声音随时间的变化,也能利用频谱结构和语言条件定位目标事件。
3. 联合完成声音提取与方向估计
在提取目标音频的同时,LuSeeL 还从频率域表示中提取空间相关特征,并结合 GCC-PHAT 特征,预测目标声音在 360° 方位范围内的方向分布。
训练时,声音提取任务与方向定位任务共同优化。声音提取部分同时考虑波形保真度与多分辨率频谱变化;定位部分则将方位角离散为 360 个角度区间,以回归目标方向的概率分布。
换句话说,LuSeeL 并不是在一个系统里简单叠加两个任务,而是让两个任务共享并共同塑造空间声学表示。
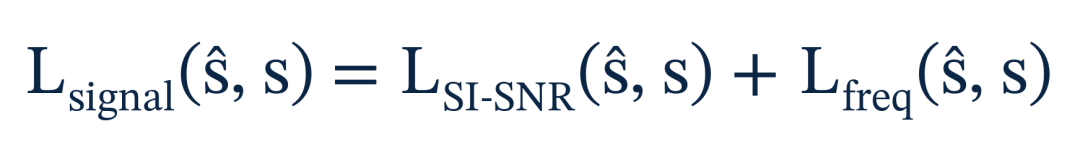
其中,LSI-SNR 约束波形层面的信噪比表现,Lfreq 约束频谱结构。这样的组合能够减少仅在时域优化时可能出现的频谱失真,使提取结果在波形与听感相关的频率结构上都更稳定。
方向分支不直接只回归一个角度,而是输出 360 个离散方位 bin 上的分布 d̂。给定真实方位角 d,论文使用以真实角度为中心的高斯分布作为软标签 y,并采用均方误差进行监督:
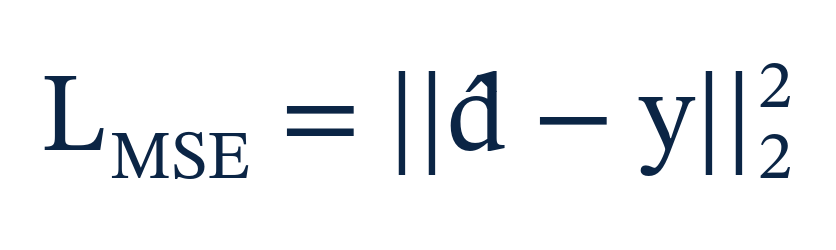
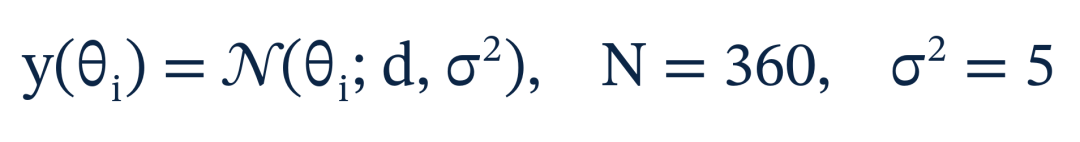
这种软标签比 one-hot 角度标签更符合空间定位的连续性:预测到相邻角度时,惩罚应当小于预测到完全相反的方向。最终的联合目标为:
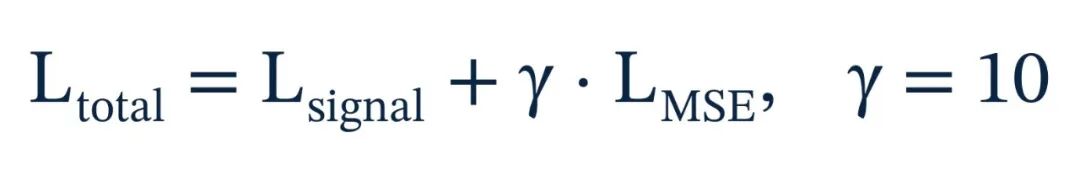
论文中的 γ=10 表明,训练时需要对定位误差施加明确权重,使模型不仅学会“把声音分出来”,也必须保留足够可用于空间判断的双耳线索。
▎实验:双耳输入带来显著收益
模型在 AudioCaps 数据集上进行实验,该数据集包含约 4.6 万段带有人类文本描述的音频。实验中,研究者动态构造两源和三源混合场景:为每个声音随机分配方位角,通过头相关传递函数模拟双耳录音,再将不同声源叠加形成混合信号。评价指标包括:
SI-SNRi / SDRi:衡量目标声音提取质量,数值越高越好;
方向识别准确率:预测方向落在真实方向 ±5° 范围内的比例,越高越好;
MAE:方向估计的平均绝对误差,越低越好。
两源混合:提取与定位同时提升
在两源混合场景中,单通道提取基线 T-HTDemucs 的 SI-SNRi 为 7.7 dB。加入双耳输入后,LuSeeL 的 SI-SNRi 达到 20.3 dB,同时方向识别准确率达到 89.9%,方向平均绝对误差降至 7.0°。
与只做声音提取的双耳单任务版本相比,联合训练还带来了 2.7 dB 的 SI-SNRi 提升,说明定位任务提供的空间约束确实能够帮助模型分离目标声音。
两源混合 |
SI-SNRi |
SDRi |
方向准确率(±5°) |
MAE |
单通道提取基线 T-HTDemucs |
7.7 dB |
8.7 dB |
— |
— |
LuSeeL(双耳、联合提取与定位) |
20.3 dB |
21.6 dB |
89.9% |
7.0° |
三源混合:复杂场景下仍保持空间感知能力
在更复杂的三源混合场景中,LuSeeL 的 SI-SNRi 为 12.9 dB,方向识别准确率为 77.8%,MAE 为 15.5°。相较单通道基线,双耳与联合建模依然带来明显优势。
值得注意的是,消融实验显示:在三源场景中,去掉 GCC-PHAT 后声音提取指标可反超完整版约 0.4 dB,但代价是方向识别精度明显下滑;完整版 LuSeeL 用这 0.4 dB 换来了更准的方位判断和更小的角度误差。这表明,显式的双耳空间线索在更拥挤的声学环境中仍具有不可替代的补充价值。
▎一个重要发现:提取与定位并非对称依赖
论文中的可视化结果还揭示了两个任务之间更细致的关系:
目标声音提取得越差,方向定位通常也越容易出错;
但即使方向估计不够准确,模型仍可能较好地提取出目标声音。
这说明,声音提取更像是定位任务的强前置支撑,而定位信息回馈给提取端的,则是一层空间约束。对未来的空间音频系统而言,这种非对称依赖关系值得在模型设计与误差分析中单独考量。
▎这项工作意味着什么?
LuSeeL 的意义不只是把两个评价指标放到同一张表里,而是推动通用声事件理解从“听懂内容”走向“理解内容与空间的联合关系”。
对于增强现实和虚拟现实系统,AI 模型可以根据用户的语言指令提取特定声源,并将其与正确的空间位置对应起来;对于机器人,空间化的声音理解有助于感知周围环境、识别交互对象;对于辅助技术,语言驱动的目标声音选择也可能提供更自然的交互方式。
更进一步看,自然语言为用户提供了灵活的查询接口,双耳信号提供了现实环境中的空间线索,而联合学习则把这两类信息组织成统一的听觉表示。这种“语言查询 + 空间感知”的范式,也为后续的音频生成、空间对话和多模态大模型提供了值得探索的方向。
▎仍需正视的边界
这项工作展示了清晰的技术收益,但实验设置也限定了结论的适用范围:论文使用 AudioCaps 音频动态构造双耳混合信号,双耳效果来自头相关传递函数仿真;主要评测覆盖 2 源和 3 源场景,输入采样率为 16 kHz,片段长度为 10 秒。LuSeeL 在论文所设定的双耳混合实验中,验证了语言查询、空间线索与联合训练相结合的有效性。它距离真实开放环境中的长期、连续、多人多声源听觉理解,还需要更多实录双耳数据、跨设备测试与更复杂场景验证。
▎写在最后
人类听觉的优势,从来不只是“听见声音”,还包括判断声音来自哪里、与谁有关、是否值得关注。LuSeeL 的探索,将自然语言、双耳听觉和通用声事件提取连接起来,让机器开始以更接近真实听觉的方式理解复杂声场。
从“请找出汽车喇叭声”,到“它来自我的左前方”,再到“只关注正在靠近的那一个声源”,空间化、可查询的机器听觉或许正在形成新的交互入口。
相关文献参考:
[1] Pan, Z., Zhao, S., Ma, Y., Wang, H., Jiang, Y., Tian, B., & Ma, B. LuSeeL: Language-queried Binaural Universal Sound Event Extraction and Localization. arXiv preprint arXiv:2601.19153, 2026. ICASSP 2026.
[2] Liu, X., Liu, H., Kong, Q., Mei, X., Zhao, J., Huang, Q., Plumbley, M. D., & Wang, W. Separate What You Describe: Language-Queried Audio Source Separation. Interspeech 2022, pp. 1801–1805. DOI: 10.21437/Interspeech.2022-10894.
[3] Raffel, C., Shazeer, N., Roberts, A., Lee, K., Narang, S., Matena, M., Zhou, Y., Li, W., & Liu, P. J. Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer. Journal of Machine Learning Research, 21(140), 1–67, 2020.
[4] Kim, C. D., Kim, B., Lee, H., & Kim, G. AudioCaps: Generating Captions for Audios in the Wild. In Proceedings of NAACL-HLT 2019, pp. 119–132. DOI: 10.18653/v1/N19-1011.
[5] Défossez, A. Hybrid Spectrogram and Waveform Source Separation. arXiv preprint arXiv:2111.03600, 2021. ISMIR 2021 MDX Workshop.
[6] Perez, E., Strub, F., de Vries, H., Dumoulin, V., & Courville, A. FiLM: Visual Reasoning with a General Conditioning Layer. Proceedings of the AAAI Conference on Artificial Intelligence, 32(1), 3942–3951, 2018. DOI: 10.1609/aaai.v32i1.11671.
[7] Knapp, C. H., & Carter, G. C. The Generalized Correlation Method for Estimation of Time Delay. IEEE Transactions on Acoustics, Speech, and Signal Processing, 24(4), 320–327, 1976. DOI: 10.1109/TASSP.1976.1162830.
[8] Adavanne, S., Politis, A., Nikunen, J., & Virtanen, T. Sound Event Localization and Detection of Overlapping Sources Using Convolutional Recurrent Neural Networks. IEEE Journal of Selected Topics in Signal Processing, 13(1), 34–48, 2019. DOI: 10.1109/JSTSP.2018.2885636.