微软发布 Microsoft-Decision-1:专做选择题的小模型,85 毫秒给答案
微软推出专用决策模型 Microsoft-Decision-1,专为结构化选择题任务设计,不生成文本、仅输出校准概率。其在36项测试中平均准确率83.5%居首,中位延迟85毫秒,比GPT-6 Sol快35倍。模型基于Qwen3.5-9B后训练,输入纯文本(最长32K token),输出JSON格式概率,已上线Microsoft Foundry。
专为结构化决策而生
北京时间 10 月 10 日凌晨 2 点 37 分,微软 CEO 纳德拉发帖:微软有了一个新模型,叫 Microsoft-Decision-1。
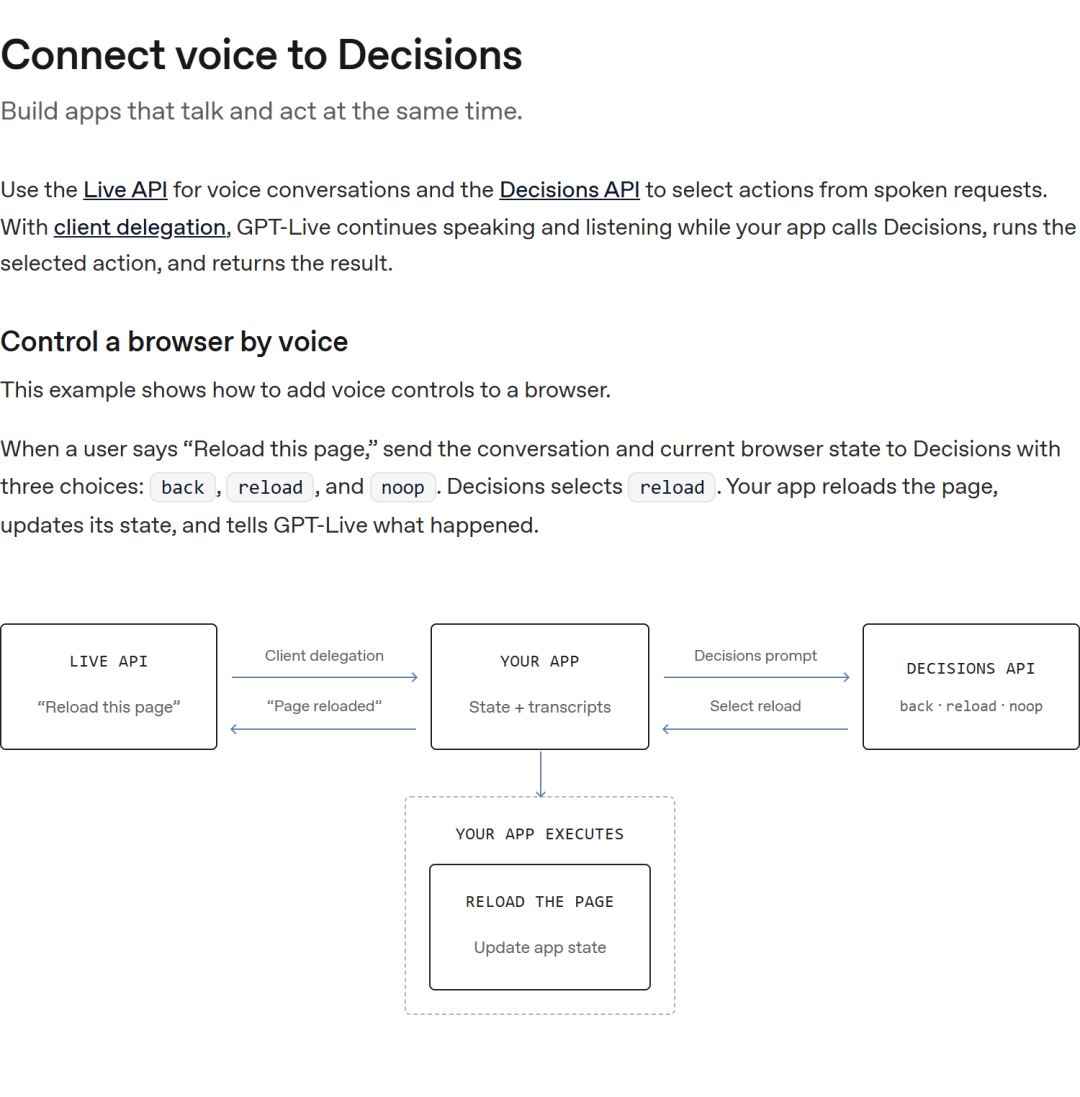
它不写文章,不聊天。你给它一道选择题,它告诉你每个选项有几成把握。
官方说,它在 36 项测试里平均准确率排第一,中位延迟 85 毫秒,比 GPT-6 Sol 快 35 倍。
Microsoft-Decision-1 来了。这是我们做的快速决策模型,在结构化决策任务上,延迟和质量都是顶级,表现超过大语言模型和其他决策模型。
「决策模型」是什么
先打个比方。大模型像一个会写作文的专家,你问什么他都能洋洋洒洒写一篇。
决策模型更像医院的分诊台护士。她不给你写病历长文,只问几句,然后说:去急诊 90%,去内科 8%,去皮肤科 2%。
答案是固定选项里的一个,后面跟着一个把握程度。程序拿到这个数,就能直接往下走:把握高的自动处理,把握低的转人工。
这类活很多:给客服工单分类、判断一个搜索结果相不相关、让 AI 给另一个 AI 的回答打分、决定智能体下一步该继续还是停下。
单次不难,难在量大、链条长。官方算过一笔账:每个决策多等 100 毫秒,连着做 20 个,整个流程就多等 2 秒。
它是怎么做出来的
官方页面写得比较清楚:
- 基座:阿里的开放权重模型 Qwen3.5-9B,微软做了后训练
- 输出:给每个选项一个校准过的概率,一次调用算完,不生成文字
- 题型:是非题、多选题、打分题,也能按评分标准给 AI 的回答和智能体的动作打分
- 输入:纯文本,最长 32K token;输出是 JSON
- 训练数据:公开数据集(过了微软的开放数据审核)加团队自己合成的数据
微软还说,之后会把它换到别的基座上重做,包括微软自家的 MAI 和 OpenAI 的模型。
它有几个明确不做的事:不生成文字,不聊天,不翻译,不做总结,也不解释为什么选这个。
成绩单
官方做了一张对比图,放在纳德拉的帖子里,是个 10 秒的动画。下面是它的最后一帧:
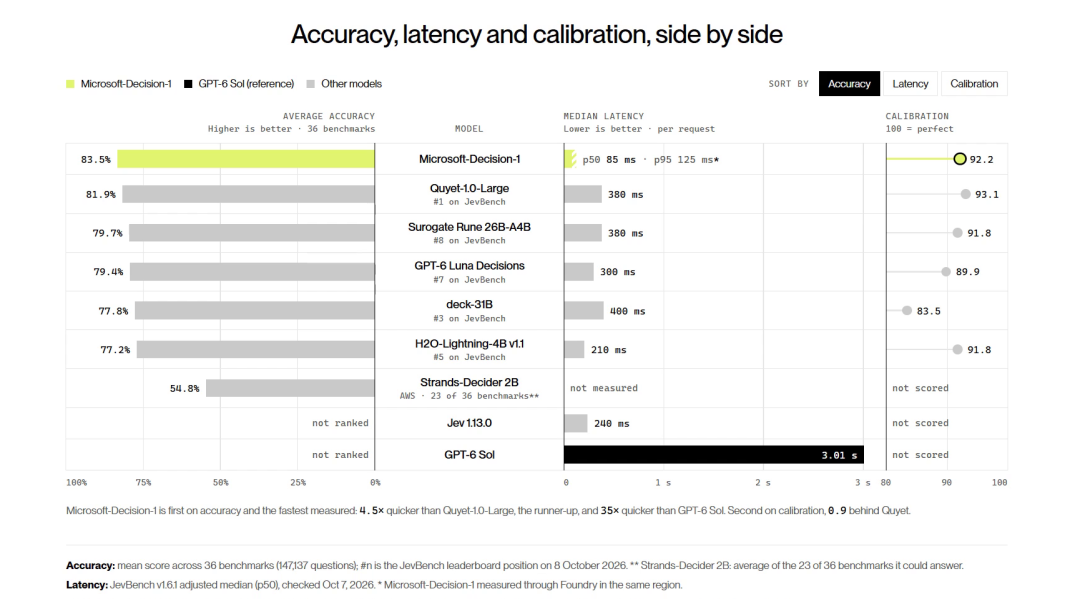
官方拿了 36 个测试集,共 147,137 道题,说这些都是训练时没见过的。里面有公开的,也有私有的,覆盖路由、排序、长上下文、多语言、推理、安全等。
准确率(36 项平均):
- Microsoft-Decision-1:83.5%
- Quyet-1.0-Large:81.9%(JevBench 榜单第 1)
- Surogate Rune 26B-A4B:79.7%
- GPT-6 Luna Decisions:79.4%
- deck-31B:77.8%
- H2O-Lightning-4B v1.1:77.2%
- Strands-Decider 2B:54.8%(只跑了 36 项里的 23 项)
中位延迟(越低越好):
- Microsoft-Decision-1:85 毫秒(p95 为 125 毫秒)
- H2O-Lightning-4B v1.1:210 毫秒
- Jev 1.13.0:240 毫秒
- GPT-6 Luna Decisions:300 毫秒
- Quyet-1.0-Large:380 毫秒
- Surogate Rune 26B-A4B:380 毫秒
- deck-31B:400 毫秒
- GPT-6 Sol:3.01 秒
官方的算法是:比 Quyet-1.0-Large(亚军)快 4.5 倍,比 GPT-6 Sol 快 35 倍。
校准度(100 分为满分,指「说有 90% 把握时,真的对九成」):
- Quyet-1.0-Large:93.1
- Microsoft-Decision-1:92.2,排第二,差 0.9 分
- Surogate Rune 26B-A4B 和 H2O-Lightning-4B:都是 91.8
- GPT-6 Luna Decisions:89.9;deck-31B:83.5
所以更准确的说法是:准确率第一、速度最快,校准度第二。
看数字时有一点要留意。图注写明,对手的延迟取自 JevBench 的校正后中位数(10 月 7 日),Microsoft-Decision-1 则是微软自己在 Foundry 同区域实测的。两边测法不完全一样。
另外两项自测:
- 稳定性:同一个请求换 8 种方式扰动(改写、换选项描述、调顺序、改字段名、加格式噪音等),决策平均只翻转 1.3%。改写选项描述、颠倒或打乱选项这两类,一次都没翻
- 安全:在 11 个测试集、5,250 个请求上测有害内容、越狱和提示词注入,官方说能拒绝有害请求,同时不误伤正常请求,没给具体数字
微软内部先用了什么
官方列了 4 个内部试用,数字都是微软自己报的:
- Xbox 研究团队:把问卷、Steam 和推特上 1 万多条玩家反馈,分进研究员定好的主题。质量和 GPT-6 Sol 相当,快 14 倍多,便宜 200 倍
- Copilot 团队:给聊天和智能体的回答打质量分。和 GPT5.6 Luna(官方原文写法)相当,快 100 倍
- 值班工程师:出故障时检索日志、工单等资料,比大模型更好也更快,没给数字
- Microsoft Discovery:科研智能体评估上一轮实验、再调整方案。评分一致性是大模型打分的 46 倍,速度 3 倍,自适应重规划整体快近 4 倍
纳德拉的帖子也提到,微软内部在各处测试它。
怎么用,多少钱
- 在哪用:Microsoft Foundry 已上线,目录页标的是正式可用。OpenRouter 官方说「即将」上线
- 价格:输入每百万 token 0.042 美元,输出免费
按这个价格粗算:1 万条各 500 token 的请求,一共 500 万 token,约 0.21 美元。这是我们的算术,不是官方案例。
官方还写了一些限制:不能把它当作信贷、就业、住房、保险、教育、医疗、法律权利这类重大决定的唯一依据,也不能用来监控或给个人画像。
开源吗?官方没说
官方页面只说它基于开放权重的 Qwen3.5-9B,没说 Microsoft-Decision-1 自己的权重会不会放出来。
我们在 Hugging Face 上搜了名字,也没找到。目前能确认的用法只有上面的 Foundry。
这些官方没说
- 最终模型的参数量。只知道基座是 9B 的 Qwen3.5
- 训练方法和数据规模。只知道是后训练,数据来自公开数据集加合成数据
- 36 个测试集的完整名单
- GPT-6 Sol 的具体规格
- 支持哪些语言。测试里有多语言类,但没给分语种的成绩
以上成绩都来自微软自己的测试,我们没有独立复现。
JOTO 企业落地观察
- 企业部署决策模型需重新评估服务链路中的“等待成本”——当单次决策延迟从 300 毫秒降至 85 毫秒,20 步串联决策的整体响应时间可压缩近 4 秒,这对实时性敏感场景(如客服路由、风控拦截)构成实质性工程阈值突破。
- 该模型放弃通用能力换取确定性输出,意味着企业在构建智能体工作流时,可将“判断节点”标准化为轻量级、高吞吐、低延迟的专用服务,降低对大模型 API 的依赖强度与调用频次,从而优化整体系统稳定性与成本结构。
- 输出为 JSON 格式校准概率、不生成解释文本,契合 RAG 知识工程中“可信度驱动决策”的需求——下游系统可直接消费置信度数值,用于动态触发知识召回、人工复核或 fallback 路由,无需额外解析不可控的自然语言输出。
- 模型明确禁止用于信贷、医疗等高风险领域,且未披露多语言细粒度性能,表明其当前定位是“受控环境下的结构化辅助决策”,企业若计划将其嵌入关键业务流程,需自行完成领域适配验证与合规边界界定。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们