从页面渲染到智能体:ARMS Node.js 探针解锁 SSR + AI 全链路可观测
阿里云 ARMS Node.js 探针支持 SSR 与 AI 智能体应用,自动串联页面渲染、模型调用、工具执行及下游服务,形成统一调用链(Trace)。通过云监控 2.0 的「应用监控」与「AI Agent 可观测」双视角,研发可沿同一次请求下钻定位慢环节,区分页面渲染、Agent 执行、工具调用与业务服务延迟,还原包含输入输出、Token 消耗与首 Token 时间的完整执行现场。
页面迟迟不返回,问题在哪一层?
页面迟迟不返回,是渲染慢、模型慢,还是工具背后的业务服务慢?沿一条真实链路找到排查方向。
(适合使用 SSR 或正在为 Node.js 应用接入 AI 的研发与 SRE)
“退款到哪一步了,什么时候到账?”
用户在售后页面发起查询,等待一个回答。接入智能体后,这个页面背后多了一段工作:理解问题、选择工具、查询订单,再把结果组织成用户能读懂的回复。
如果页面迟迟没有返回,研发团队该从哪里查起?
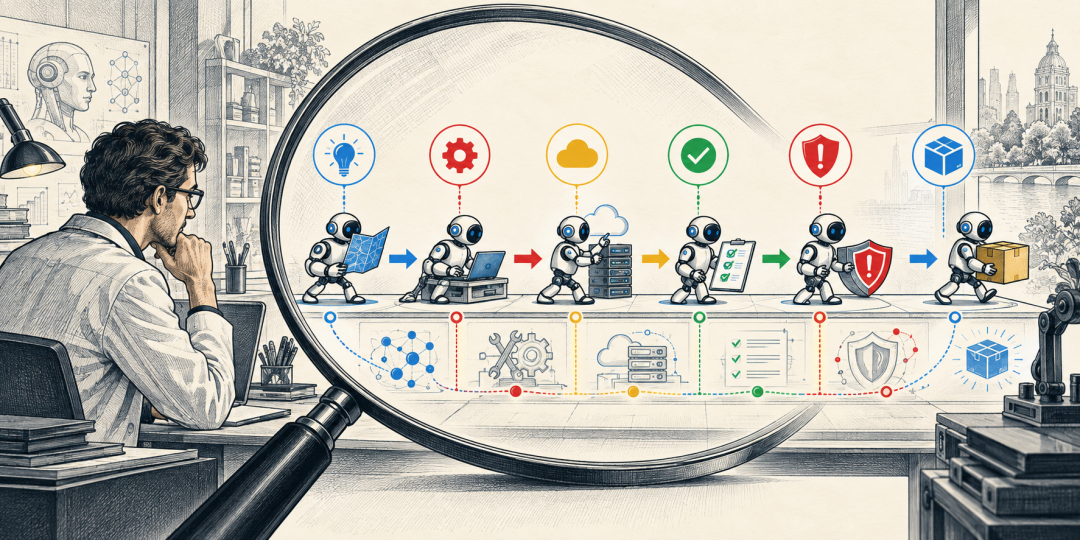
只看到入口请求耗时,很难判断等待发生在哪一层;只看模型调用,又可能漏掉工具背后的业务服务。阿里云 ARMS Node.js 探针 把服务端渲染、智能体执行与下游调用连接到同一条调用链(Trace),让排查从用户访问的那个页面开始,一路向下。
阿里云 ARMS Node.js 探针面向 SSR 与 AI 智能体应用,自动串联页面渲染、模型调用、工具执行及下游服务,形成统一链路。研发可快速定位慢请求、错误参数与业务瓶颈,结合日志、指标和 Token 消耗还原现场,提升排障效率。
SSR + AI:一条请求,两段逻辑
使用 Next.js、Nuxt 构建服务端渲染(SSR)应用,页面内容的生成发生在 Node.js 服务端。渲染要等待的数据、接口和业务处理,都会影响页面返回速度。
当智能体也进入这段服务端逻辑,页面可能还要等待模型生成、工具查询和多轮调用。用户眼中是一次页面访问,研发面对的则是一条连接 Web 框架、AI 框架和业务系统的执行路径。
这正是 Node.js 探针在 SSR + AI 场景中的价值:同时看见页面如何生成,以及智能体如何完成任务。对于既做全栈应用、又在接入 AI 的团队,两部分可以沿同一次请求排查。
下面通过一个实际运行的售后查询演示,看看这个过程。本文聚焦服务端链路,浏览器加载与交互体验可结合用户体验监控(RUM)观察。
从售后页面,一路追到订单服务
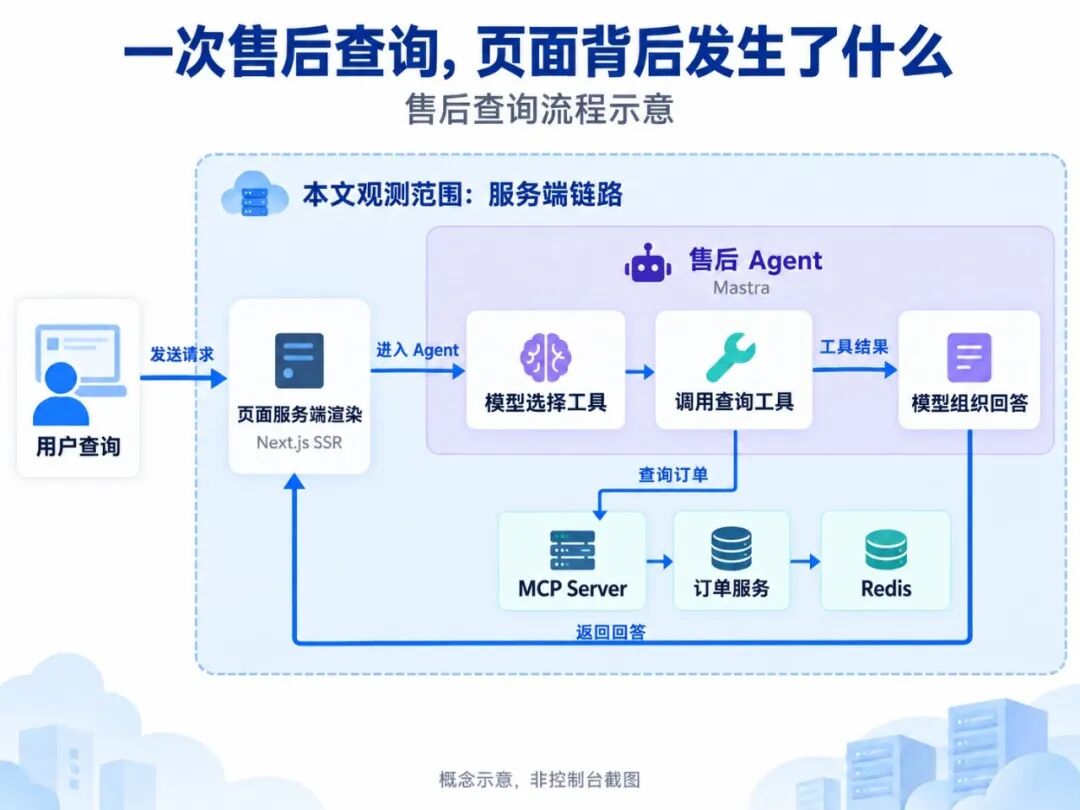
演示应用由 Next.js 提供售后页面,Mastra 编排售后 Agent,通过阿里云百炼调用 qwen-plus。Agent 选择订单查询工具后,经由模型上下文协议(MCP)访问 MCP Server,再调用订单服务、读写 Redis,最后生成售后进度回答。
页面会等待 Agent 的结果后返回。组件实际运行,订单与售后内容均为演示数据。
打开云监控 2.0「应用监控」,同一次请求的执行过程就能展开:
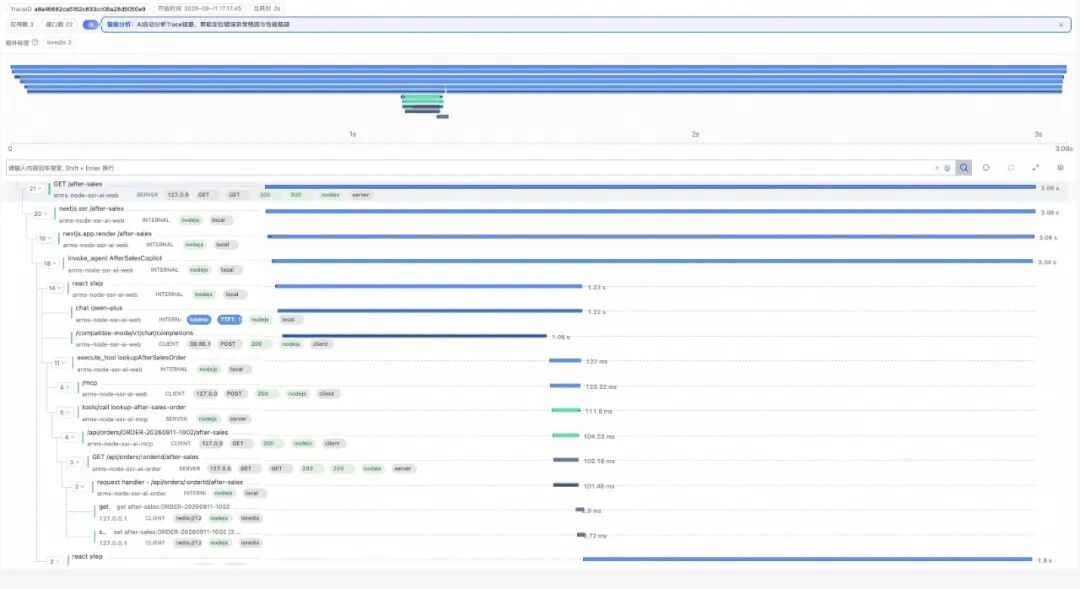
从页面入口下钻,既能看到 Next.js 的渲染阶段,也能继续找到 Agent、模型与工具节点。工具访问了哪个服务、服务是否继续查询 Redis,都在这条链路中。
对研发来说,排查不必停在“售后接口慢”这个结论上。页面等待的工作有了具体位置,跨服务调用也有了上下文,可以顺着同一条请求继续找,而不必先在不同系统里反复比对时间。
模型收到了什么,又调用了什么工具
链路连起来后,还需要看清 AI 这部分到底做了什么。
切换到云监控 2.0「AI Agent 可观测」,沿用同一个 Trace ID,可以看到这次售后查询经历了两轮模型调用:第一轮根据问题生成订单查询工具的调用和订单号参数;工具返回后,第二轮模型给出退款状态、金额、到账方式与预计到账时间。
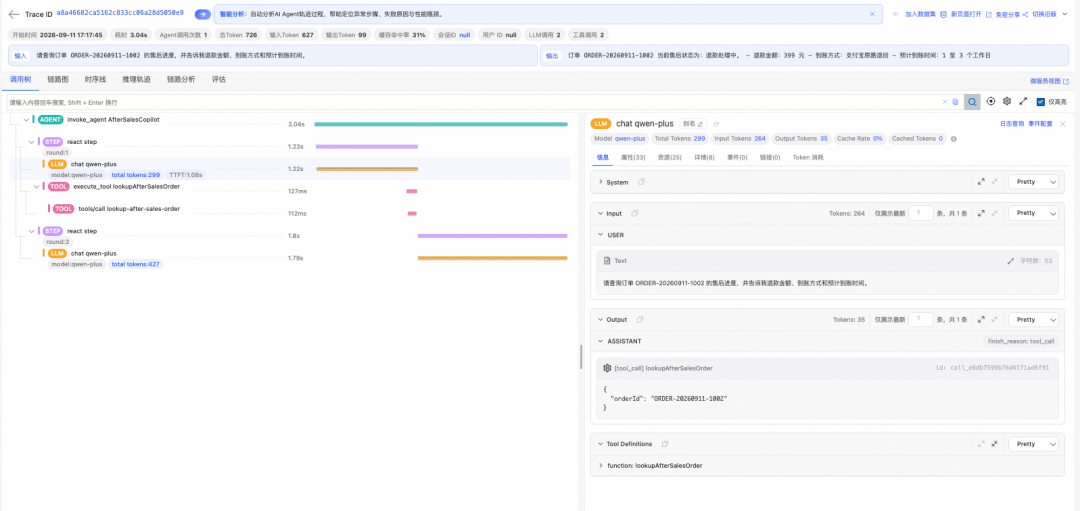
如果用户反馈“回答不对”,研发可以先核对模型实际收到的问题、生成的工具参数,以及工具返回的数据。模型有没有拿到正确的业务信息,不再只能靠猜测。
如果回复变慢,可以结合模型调用轮次、首 Token 时间和工具耗时继续判断;如果 Token 用量升高,也可以回到具体请求,查看它经过了怎样的调用过程。首 Token 时间在框架与调用方式提供相应流式数据时展示。
输入输出、执行步骤与调用消耗放在一起,AI 排障才有了可核对的业务现场。这里呈现的是可观测执行过程;生产环境采集用户问题、回答和工具内容时,需要按数据安全要求确定采集范围。
工具慢了,继续下钻到业务服务
再看另一条请求。我们人为给订单服务增加了约 1.3 秒的业务延迟,模拟售后查询等待下游的情况。
从 Agent 看过去,订单查询工具约耗时 1.32 秒。继续沿 MCP 下钻,订单接口约耗时 1.31 秒,而 Redis 操作只有数毫秒。
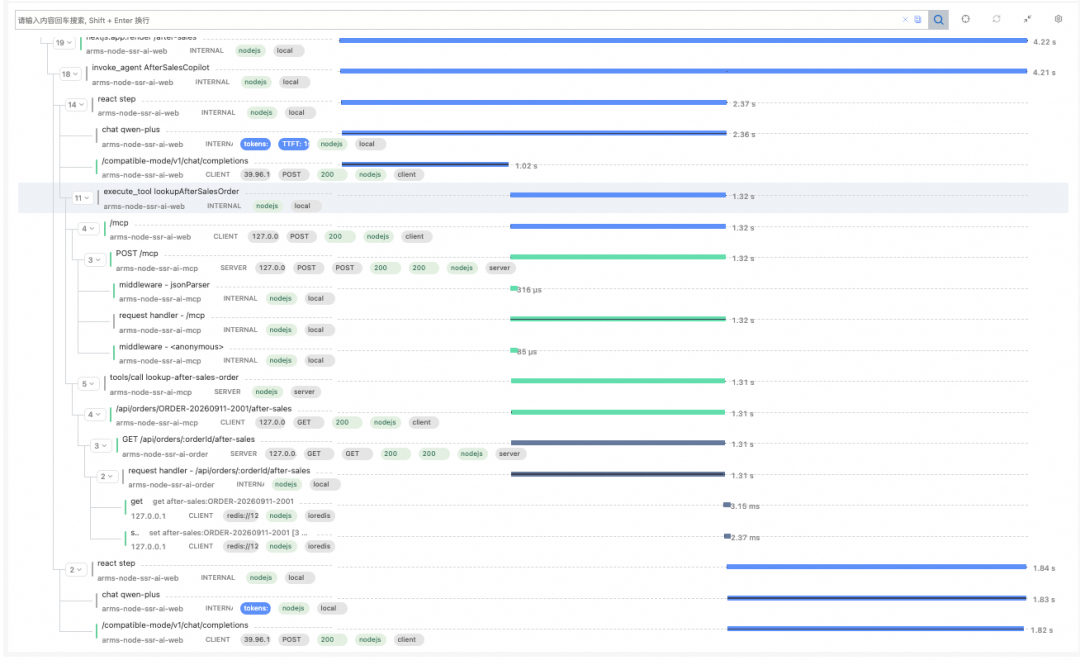
这时,下一步排查可以收敛到订单服务的处理过程。更换模型或调整缓存,不必成为未经验证的第一反应;沿着链路,再结合服务日志与代码,就能进一步确认业务等待的原因。
回到用户的问题,页面迟迟不返回,并不一定意味着模型生成太慢。页面在等 Agent,Agent 在等工具,而工具的等待可以继续追到业务服务。
这也是全链路观测的实际意义:把一句笼统的“AI 好慢”,转化为有位置、有上下游关系的排查线索。
业务持续演进,观测不必逐层重做
售后查询只是一个入口。同样的需求,也会出现在商品推荐、内部知识助手,以及其他把 AI 接入页面的应用中。
这次演示采用 Next.js 与 Mastra。如果应用使用 Nuxt,探针同样支持相应的 SSR 和服务端接口观测;如果 AI 能力采用 Genkit 构建,也能采集 Flow、模型、工具和检索等执行过程。已适配 MCP Server SDK 的工具调用,则把视角继续延伸到业务系统。
随着页面、流程和工具不断增加,为每个节点手工维护埋点,意味着持续维护调用关系与采集逻辑。框架级自动插桩能够减少这部分重复工作,团队仍可按需补充业务属性,让观测跟随业务扩展。
AI 之外,受支持的 HTTP、数据库、缓存、消息等依赖调用,以及 Node.js 运行时指标,继续提供业务服务侧的线索。Trace 与日志关联单次请求现场,指标提供应用、实例和时间窗口维度的趋势对照。团队既能追踪一条慢请求,也能结合整体变化继续排查。
从您的一个页面开始
如果您的团队正在使用 SSR,或准备把智能体接入 Node.js 应用,不妨先选一个明确的业务入口,让请求真实经过页面、模型和工具,看看等待与异常能否沿链路找到对应位置。
进入云监控 2.0 控制台[1][1],从接入中心接入 ARMS Node.js 探针。接入后,在「应用监控」与「AI Agent 可观测」中查看服务端调用和智能体执行。
具体步骤请参阅手动安装 Node.js 探针[2][2],适配组件与版本请查看官方支持列表[3][3]。
接入时,请确保探针先于业务框架加载。本文的“全链路”指受支持组件、上下文正常传播且采样保留范围内的服务端链路。对于模型与工具的输入输出,不同插件的采集、截断和脱敏能力存在差异,应逐项核对,遵循最小必要原则,必要时预先脱敏或关闭相应内容采集。
从页面渲染到智能体执行,用户等待的是一项业务的完成。看清这条路径,研发才能把排查真正落到影响这次请求的环节上。
您在 SSR 或 Agent 链路上遇到过最难定位的问题是什么?欢迎在评论区分享。
JOTO 企业落地观察
- 企业部署 AI 智能体时,SSR 页面与 Agent 执行混在同一 Node.js 进程,传统 APM 工具难以区分渲染耗时与模型推理耗时。ARMS 探针将两者纳入同一 Trace,使团队无需改造架构即可获得分层耗时归因,降低了可观测性建设的准入门槛。
- 智能体工程中,工具调用(Tool Calling)常作为业务服务的代理层,其性能瓶颈易被误判为模型问题。该方案通过 MCP 协议透传与链路下钻,使工具调用耗时可直接映射至下游订单服务等真实业务接口,避免排障方向性偏差。
- RAG 知识工程依赖外部检索服务,其响应延迟直接影响 Agent 整体 SLA。本方案支持将检索调用嵌入主链路,使 RAG 的向量库查询、重排序、摘要生成等环节与页面渲染并列呈现,便于识别知识召回环节的性能拐点。
- AI 安全治理要求对敏感输入输出进行审计,但全量采集存在合规风险。探针支持按字段粒度配置采集策略,结合 Token 消耗与首 Token 时间指标,可在不暴露原始内容前提下,评估提示词工程有效性与模型响应稳定性。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们