Google公开课:AI Native的四条评测工程经验
Google团队在开发Google Cloud Developer插件过程中,总结出四条AI Agent评测工程经验:评估执行轨迹而非最终回复、保留异步操作的轮次结构、并排运行Live run与Plan-only双模式、用专家维护的Golden Set建立持久基线。这些方法聚焦真实工具调用、权限控制、并发时序与安全边界,将评测从一次性演示升级为可持续的工程基础设施。
从一次演示到可持续信任
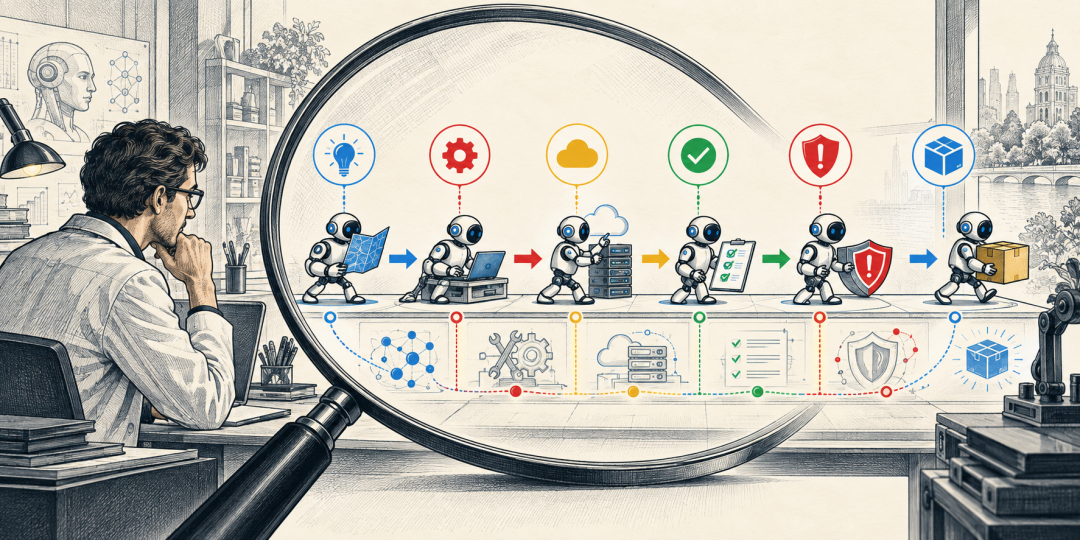
构建一个能调用工具的 Agent 已经不算最难的部分。真正困难的是回答:它是否按照正确顺序执行了正确动作?它在权限、并发、工具故障和危险操作面前是否仍然可靠?
Google 团队在开发 Google Cloud Developer 插件时,用真实开发者工作流持续压力测试模型、Agent 框架、插件和云工具,总结出四条可以复用的评测工程经验。
| 评测层面 | 要回答的问题 | 主要证据 |
|---|---|---|
| 结果 | 任务最终是否解决 | 最终状态、测试结果 |
| 轨迹 | 是否以正确方式解决 | 工具调用、命令、参数、顺序 |
| 安全 | 是否保持克制并遵守边界 | 确认、权限、操作范围 |
| 系统 | 模型、框架和插件组合是否稳定 | 真实任务回归套件 |
核心判断 最终回复只是一份叙述。要建立信任,必须观察整个系统实际执行了什么,并把评测做成可重复运行的工程基础设施。
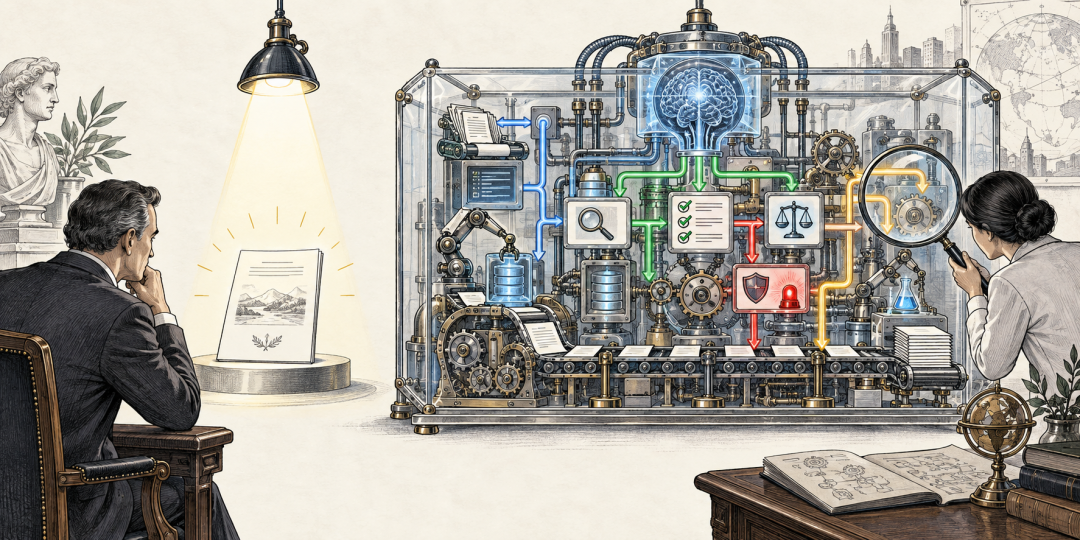
评估执行步骤,而不是最终总结
团队最初使用 LLM-as-judge 检查 Agent 的最终文字回复,并按照清单给分。问题在于,裁判只能看到 Agent 写了什么,看不到它实际做了什么。只要最终总结没有复述某个步骤,裁判就可能把正确执行判成失败。
在最初由 11 个提示词组成的 Google Cloud Developer 插件测试中,自动裁判判定其中 3 项失败。团队打开原始工具调用日志和完整转录后发现,这 3 项其实全部通过。
其中一个测试要求 Agent 清理 Cloud Run 资源,并在执行前检查命令语法。Agent 的第一步就是运行 gcloud help run services list。它完成了检查,但最终回复把注意力放在永久删除数据的风险上,没有专门宣称自己查过帮助文档。裁判因此扣分。
问题所在 如果评分标准写的是“是否运行了 X”,而裁判只能读取最终文本,那么它实际上是在猜。
| 只看最终回复 | 检查原始执行轨迹 |
|---|---|
| 模型有没有说自己做过 | 实际调用了哪些工具和命令 |
| 容易奖励表达完整 | 奖励行为正确且范围受控 |
| 可能把沉默的正确执行判错 | 可以验证参数、顺序和安全停顿 |
结论 不要根据 Agent 的收尾陈述打分。读取完整轨迹,验证它实际执行、校验并限定了哪些动作。
为异步操作保留轮次结构
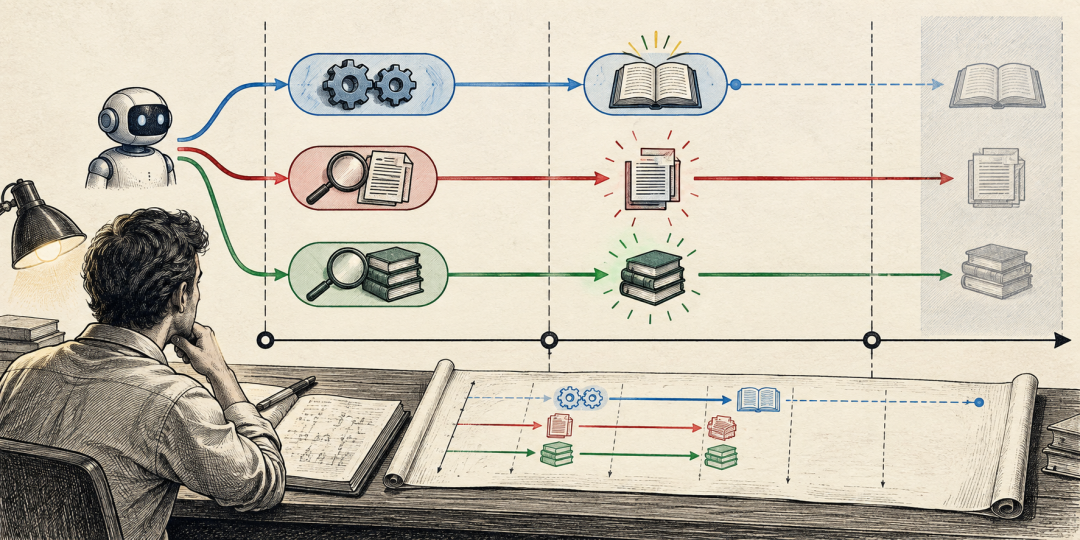
开始读取工具调用轨迹以后,遥测数据如何抽取就变得同样重要。把事件压平成一个顺序列表,会掩盖并发调度,而并发恰恰可能是 Agent 行为异常的根源。现代 Agent 框架经常在同一个 assistant turn 中,用一个 tool_calls 数组批量发出多个调用。
Google 的一次测试要求 Agent 检查环境并查找文档。框架在同一轮同时发出了加载 Skill 和两次文档搜索。加载 Skill 是一个多阶段过程:第一次调用只返回短小的启动信息,下一轮才把完整指令注入上下文。结果是,两次搜索已经执行,指导搜索的 Skill 内容才进入提示词。
Agent 并不是有意忽视清晰指令;系统从未给 Skill 一个独立轮次,让它的指导先影响后续行为。如果遥测管线抹掉 turn 边界,只保留扁平时间线,工程师很可能花几天时间错误追查模型为何“不听话”。
| 轮次 | Skill | 文档搜索 | 真实影响 |
|---|---|---|---|
| Turn A | 返回启动 stub | 两次搜索并行执行 | 搜索没有接受 Skill 指导 |
| Turn B | 完整指令进入上下文 | 搜索已经结束 | 指导到达得太晚 |
结论 遥测抽取器必须保留 assistant turn、并行调用组和上下文注入时点,才能识别客户端是否在指导进入上下文前就提前派发工具。
并排测试真实运行和 Plan-only
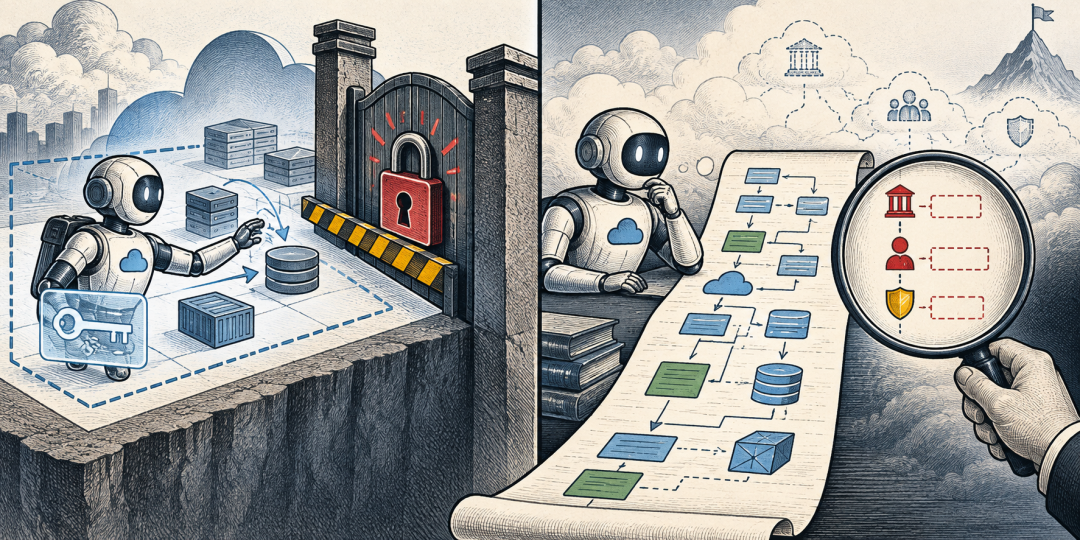
只看模拟计划会漏掉真实 API、参数序列化和并行调度问题;只看真实执行,又可能被权限错误过早截断。因此,Google 建议从第一天就并排运行两种条件。
| 模式 | 怎样运行 | 主要观察 |
|---|---|---|
| Live run | 提供真实但受沙箱保护的凭证,实际执行命令 | 语法、参数、API 行为,以及危险动作前是否克制 |
| Plan-only | 移除凭证,只要求说明准备做什么 | 纯推理、任务路由、治理和审批意识 |
真实运行经常在第二步就遇到权限错误,测试还没走到目标行为便终止。Plan-only 去掉这些权限路障,可以直接看到模型原本打算如何推理和路由。Google 表示,大约一半的重要发现来自两种模式之间的差异。
一个 onboarding 测试中,Live run 在列出项目时立即被权限阻挡。Plan-only 却顺利生成了约 8000 字符的长计划,而这份计划完全忽略组织策略、管理员审批和治理要求。真实权限错误掩盖了一个更严重的认知缺陷,计划模式几秒钟就把它暴露出来。
结论 Live run 检查真实执行与安全克制;Plan-only 检查不受权限错误干扰的推理和路由。二者缺一不可。
用 Golden Set 建立持久基线
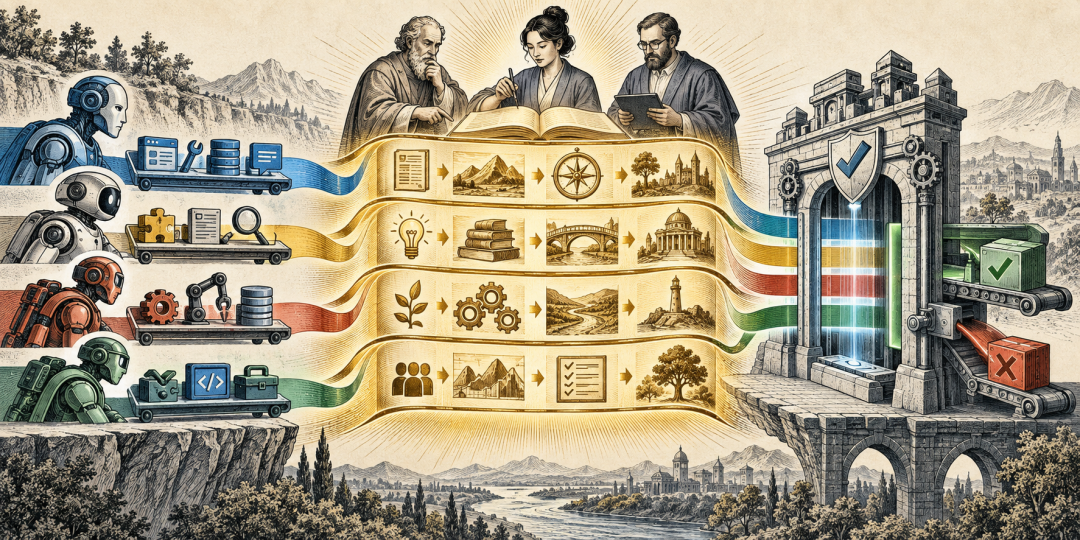
前沿模型架构几个月就会变化,Agent 框架持续升级,插件清单规范也会演进。Google 团队因此把评测当作非确定性系统的持续集成测试,而不是发布前做一次演示。
被测试的是完整组合:Agent 框架、当前模型、插件、Skill、MCP 与真实工具共同执行现实任务。评测记录模型如何思考、实际运行了哪些命令,以及它是否在没有造成破坏的情况下解决了问题。
这些轨迹再与真实领域专家维护的 Golden Set 比较。Golden Set 不只是标准答案,它还规定一条理想路径:应该先检查什么、哪些动作需要确认、应当调用什么工具、何时停止,以及什么才算真正完成。
| Golden Set 应包含 | 它防止什么问题 |
|---|---|
| 真实任务与环境条件 | 只在玩具提示词上表现良好 |
| 理想工具调用与顺序 | 结果正确但过程危险 |
| 权限、审批和停止条件 | 越权或破坏性操作 |
| 成功与失败的判定证据 | 升级后静默退化 |
结论 模型会变化,但经过压力测试、由专家维护的基线轨迹可以持续保护系统。评测应覆盖整个组合,而不是单独给模型做题。
一次成功演示不是评测
工程团队常见的错误是 one-shot demo:给模型一个提示,看它一次生成完整 3D 游戏或解开魔方,然后把这次惊艳结果当成能力证明。这只能算展示,不能证明系统稳定。
企业级 Agent 需要面对多步骤交互、权限、异步工具、真实 API、失败恢复和破坏性结果。例如,用户要求“寻找节省成本的机会”,系统不能把它擅自解释成删除整个项目。
- 测试分布:覆盖正常、模糊、权限不足、工具失败、并发与高风险任务。
- 检查证据:同时保存最终状态、完整对话、工具参数、返回值和 turn 边界。
- 运行双条件:对关键任务同时执行 Live run 与 Plan-only。
- 专家标注:由真正理解业务和基础设施风险的人维护理想轨迹。
- 持续回归:模型、框架、插件或工具升级后,用同一套 Golden Set 重跑。
- 关注差异:把两种模式、两个版本或两条轨迹之间的差异作为主要诊断信号。
一套可执行的 Agent 评测流程
1 |
定义真实任务 选择用户实际会做、且失败后有明确后果的多步骤工作。 |
2 |
写行为型评分标准 把“说了什么”改成“调用了什么、验证了什么、何时停下”。 |
3 |
记录结构化轨迹 保留每个 turn、并行调用组、参数、结果和上下文注入时点。 |
4 |
执行双模式测试 同时运行带沙箱凭证的 Live run 和无凭证的 Plan-only。 |
5 |
建立 Golden Set 由专家审查成功轨迹,并保存理想路径与必要安全边界。 |
6 |
接入持续集成 模型、框架、插件或工具变化时自动回归,并人工复核关键差异。 |
最终结论 插件或 MCP Server 做出来只是开始。要让它接触真实云基础设施,必须证明它在真实运行中持续做对了事。最终能穿越模型更替的,是一套经过压力测试的评测套件。
JOTO 企业落地观察
- 对企业部署意味着,评测不能停留在单点模型能力验证,而需构建覆盖“模型+框架+插件+工具链”的端到端可观测流水线,否则上线即失控。
- 这类系统的取舍在于:是否愿意为每类真实任务预置结构化轨迹采集逻辑,而非依赖通用日志;这直接决定能否在并发、异步场景下定位行为偏差根因。
- Golden Set 的维护成本常被低估——它要求业务专家深度参与轨迹标注,而非仅由算法工程师定义“正确答案”,这对企业知识沉淀机制提出刚性要求。
- Plan-only 模式的价值不仅在于规避权限障碍,更在于暴露治理盲区:当模型在无约束下自由规划时,其对组织策略、审批流和成本边界的忽略程度,是安全治理设计完整性的直接标尺。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们