27B 的“小模型”,跑不动怎么办?英特尔® Thunderbolt™ 5 给显存请来了外援
阿里 Qwen3.8-27B 模型虽仅 270 亿参数,但 FP16 加载需约 54GB 显存,4-bit 量化后仍需约 14GB,远超主流笔记本显存容量。传统 CPU 卸载方案因硬盘带宽瓶颈(NVMe 仅 3.5–7GB/s)导致首 token 延迟高、生成如挤牙膏。OWC Stack AI 借助群联 aiDAPTIV 平台与英特尔® Thunderbolt™ 5(64Gbps 带宽),通过固件专优化、预加载调度与高速外置通道,将 gpt-oss-20b 首 token 延迟从 6.5 秒降至 0.6 秒,使 27B 模型在笔记本上实现可用级本地推理。
27B 是“小模型”,但显存胃口不小
最近,阿里官宣的 Qwen3.8-27B 又在开发者圈子里掀起了一波本地部署的热情。作为 Qwen3.6-27B 的继任者,这款参数仅 270 亿的“小模型”,在编程、推理等核心能力上足以和体积大十几倍的旗舰模型掰手腕,官方预告的开源节点也近在眼前。
本地跑大模型的好处不必多说,数据不出门、不按 token 付费、断网也能用。可当大家兴冲冲准备下载权重时,大概率会卡在同一个地方:显存。
27B 听起来是个“小模型”,但对显存的胃口一点都不小。以 FP16 精度加载需要约 54GB 显存,即便用 4-bit 量化压缩到约 14GB,也还是装不进主流笔记本那 8GB 到 16GB 的显存——这还没算推理过程中不断增长的缓存开销。
于是不少人的本地 AI 计划陷入了两头受气的境地:跑 7B、14B 这类更小的模型,编程和推理能力确实不够用;想上云,数据要传出去,对敏感项目来说不安全,而且订阅费还一路看涨。显存就像一只行李箱,而模型是冬天的全套行李,箱子小了,拉链都拉不上,这和部署技术好于不好没有关系。
小显存如何“硬跑”大模型?
不过你可能会问:既然显存放不下,网上为什么还有人用普通电脑“跑动”大模型?这就要说到大模型推理的一个特点了。
做一个粗浅的比方,大模型是几十层网络一层一层堆叠起来的,生成文字时,数据要逐层顺序经过,任何一瞬间,GPU 真正在计算的其实只有当前这一层,其余层的权重此刻用不到。于是就有了一个钻空子的思路:显存里只保留正在计算的那一层,把其余层的权重放在系统内存甚至硬盘上,算到哪一层就搬哪一层。这就是所谓的“换页”,也就是卸载,llama.cpp、Ollama 等工具的 CPU 卸载干的就是这件事。
思路没问题,但速度通常会被严重拖慢。生成文字是逐字进行的,每生成一个 token,每一层的权重都要被读取一遍。拿 27B 模型量化后约 14GB 的权重来算,想达到每秒 20 个 token 的流畅水平,就需要约 280GB/s 的持续带宽;而硬盘到显存之间的搬运通道,NVMe 通常只有 3.5GB/s到7GB/s,差了几十倍。搬运速度跟不上消耗速度,GPU 大半时间都在等数据,而通用软件并不了解模型的结构,没法提前准备,等 GPU 真的需要某一层时才开始搬运,GPU空有算力而使不上劲儿。
所以这种方法带来的效果是能跑,但只能跑一点点。首token往往要等上十几秒,生成速度如同挤牙膏,对于 27B 这个体量,基本告别日常使用,只能获得个参与感。
OWC Stack AI:把搬运做到快、做到聪明
那么,有没有办法让“换页”这条出路变得顺畅?今年5月,OWC 发布的 Stack AI 给出了一个新答案——这是全球首款采用英特尔® Thunderbolt™ 5技术的 AI 加速器兼存储扩展坞,基于群联的 aiDAPTIV 平台,首发支持 Windows 和 Linux,预计今年第四季度发售。
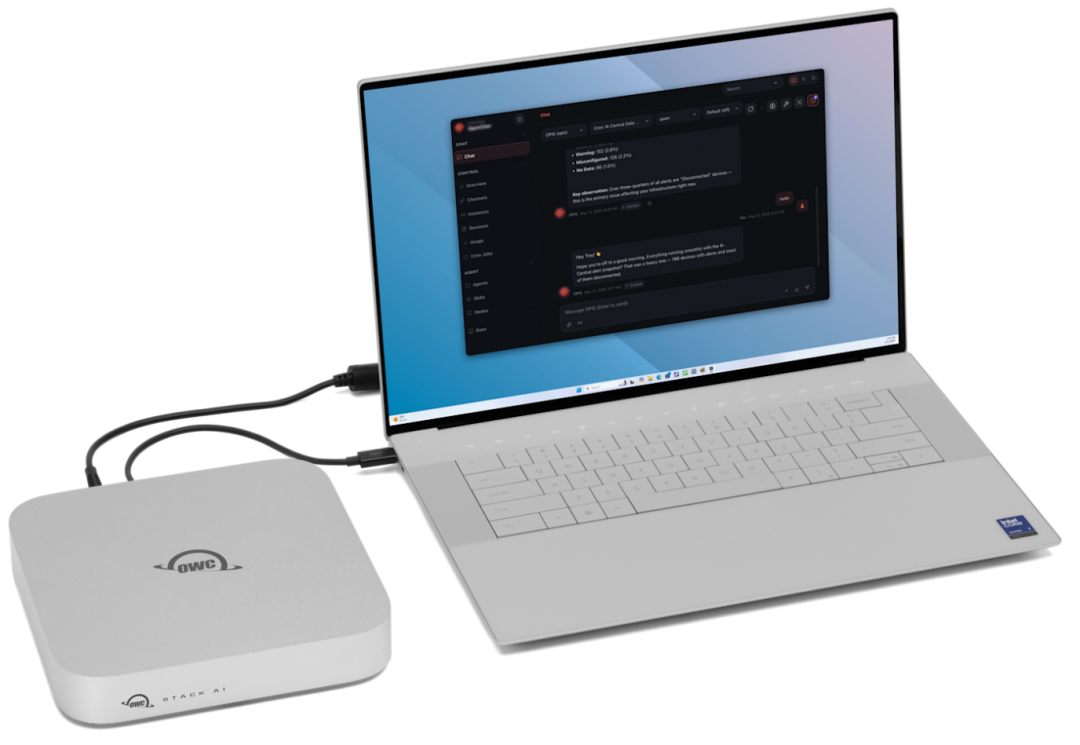
它的思路依然是把权重放闪存,边算边搬,但在三个环节上做了关键升级。首先是仓库升级。普通固态硬盘的固件按“混合负载”优化,持续高强度读取时会掉速、延迟抖动;而 aiDAPTIV 平台为“反复、大批量搬运权重”这个场景做了专门调校,能提供稳定、可预测的持续吞吐。
其次是调度升级。大模型推理逐层顺序执行,下一步计算哪一层完全可预知。Stack AI 新增的软件层“认识”模型的结构,会提前把下一层的权重搬进显存,当GPU 算完第 N 层时,第 N+1 层已经“搬运”完成了,等待的时间被藏进了计算时间里,GPU不再空等。
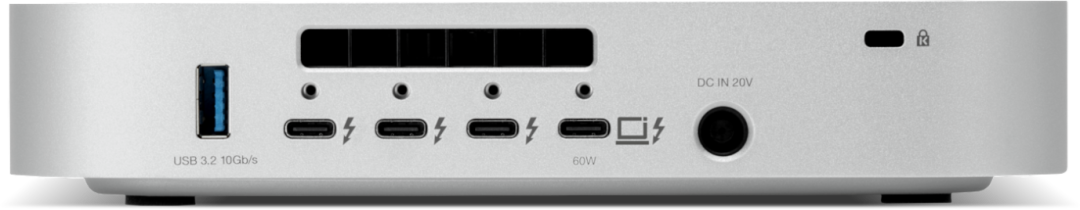
最后是通道升级。搬运数据的通道,就英特尔® Thunderbolt™ 5 的主场了,英特尔® Thunderbolt™ 5的数据传输带宽达到 64Gbps,相比英特尔® Thunderbolt™ 4的 32Gbps 直接翻倍,而独立的专用通道也不会占用系统盘带宽,电脑的系统盘不用一边扛着系统,一边扛着几十 GB 的模型权重读写。
在 COMPUTEX 2026 的现场演示中,同一台笔记本运行 gpt-oss-20b 模型,接上 Stack AI 后首个 token 的延迟从约 6.5 秒降到了约 0.6 秒。当然,它并不会让显存翻倍,物理规律依然起作用,但依然可以实现让“理论上能跑”变成“现实中可用”。
英特尔® Thunderbolt™ 5:把内置插槽的通道“平移”到机箱外
英特尔® Thunderbolt™ 5在这套方案中的角色至关重要。此前,aiDAPTIV 这类方案只能做成内置 PCIe 扩展卡,装进台式机箱里,而英特尔® Thunderbolt™ 5 提供的 64Gbps 数据传输带宽,恰好相当于 PCIe 4.0 x4插槽的速率,等于把一条内置高速通道“平移”到了机箱外面。
因此,英特尔® Thunderbolt™ 5的加入,让笔记本和miniPC等没有空余PCIe插槽的设备也能够轻松使用这套方案,而这类紧凑型/便携设备也恰恰是显存最紧张,又最没法扩展显存的设备。
当 27B 这类“小尺寸”模型已经足够能打,本地部署方案就开始具备越来越高的可用性和主流价值。换页方案让消费级显卡的显存装不下有了出路,而OWC Stack AI 做的,是把这条出路的坑洼填平,在英特尔® Thunderbolt™ 技术的加持下,让本地大模型从尝鲜变成可以投入实际生产的实用工具,不断扩展AI应用场景的外延。
JOTO 企业落地观察
- 企业若计划在终端侧部署 20B 级别模型用于知识问答或代码辅助,需同步评估 Thunderbolt™ 5 接口兼容性与外置加速器的运维成本,而非仅聚焦 GPU 显存规格。
- 该方案本质是将“显存不足”问题转化为“高速 I/O 工程问题”,对企业智能体工程意味着:模型选型可向更高参数量倾斜,但需配套重构推理服务的资源编排逻辑,尤其在多用户并发场景下需保障带宽隔离。
- RAG 知识工程中若引入本地大模型做 query 重写或结果精排,Stack AI 类设备可降低硬件门槛,但需验证其与现有 embedding 模型、向量数据库的协同延迟是否满足 SLA 要求。
- AI 安全治理需关注外置设备引入的新攻击面:Thunderbolt™ 设备驱动权限、固件更新机制、权重文件在主机内存与外置闪存间的传输完整性保护。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们