Qwen4 27B官宣暗示:阿里大模型全都要,单卡本地部署迎王炸
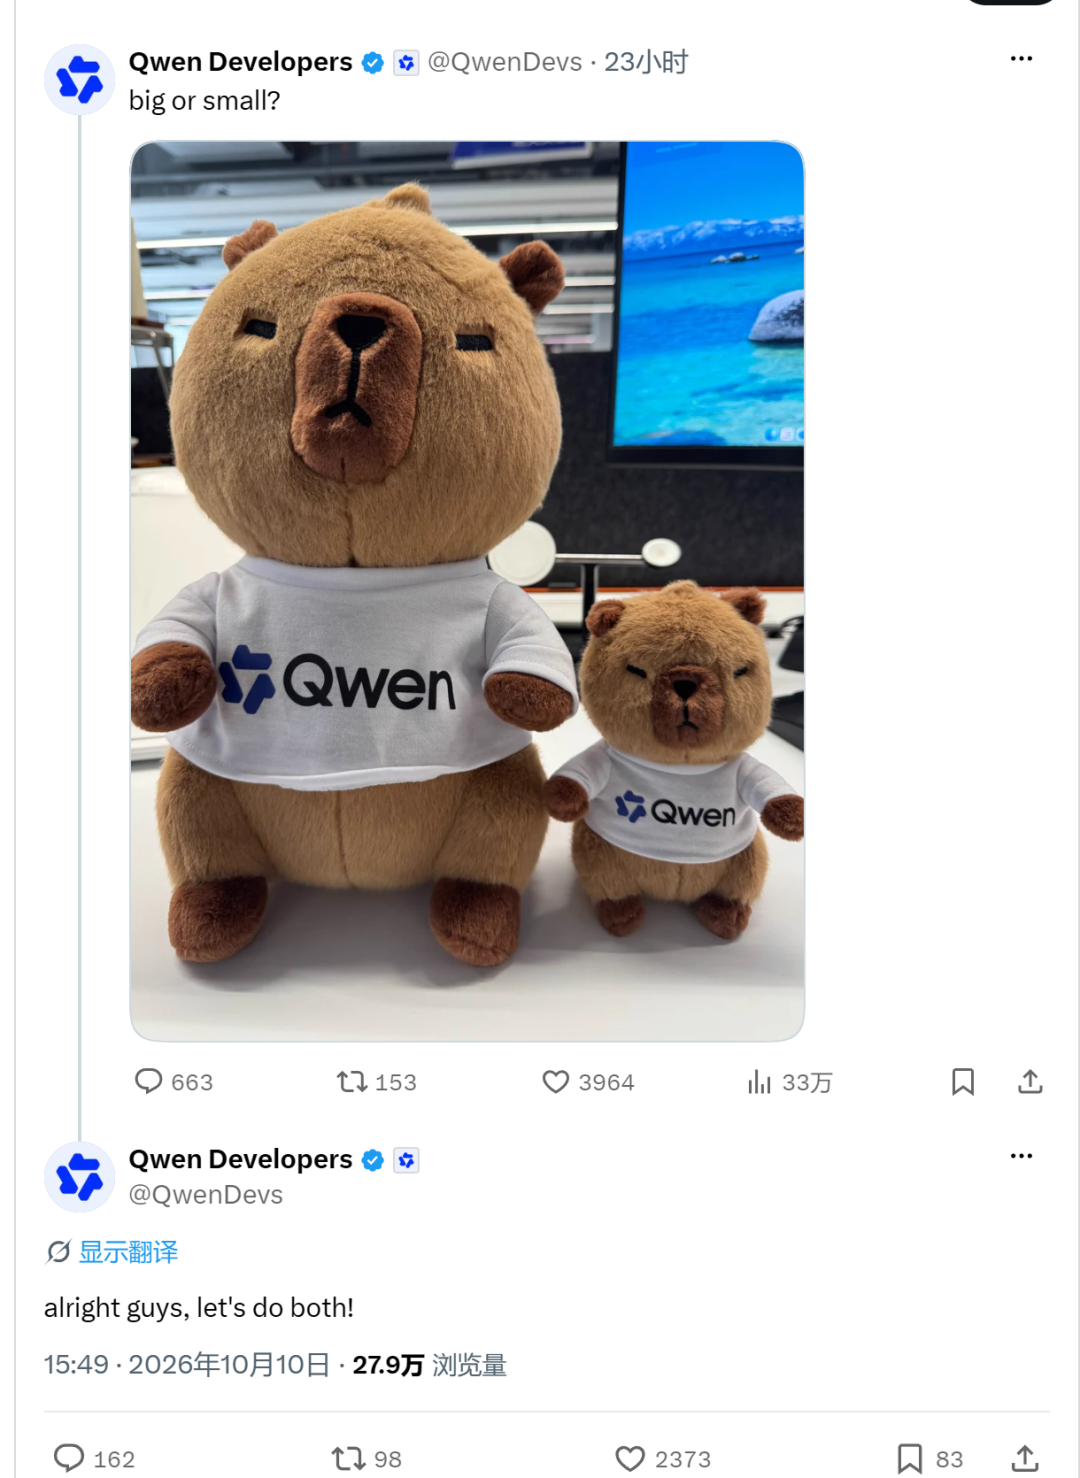
通义千问官方推特以水豚公仔抛出“big or small”之问,随后回应“alright guys, let's do both!”,并泄露出Qwen4 27B官方视觉物料。27B模型在4-bit量化下显存占用约15~17GB,适配单张RTX 3090/4090/5090等24G–32G消费级显卡,成为本地部署的‘黄金甜点位’,兼顾推理性能与私有数据安全。
Qwen4 27B官方物料曝光,‘全都要’战略落地
开源社区彻底炸锅。通义千问官方推特 @QwenDevs 先是晒出一大一小两只水豚公仔,发帖发问:“big or small?”(大模型还是小模型?)。就在全球开发者热议究竟该冲超大旗舰还是轻量小模型时,官方在数小时后霸气追评:“alright guys, let's do both!”——不用争了,我们全都要!
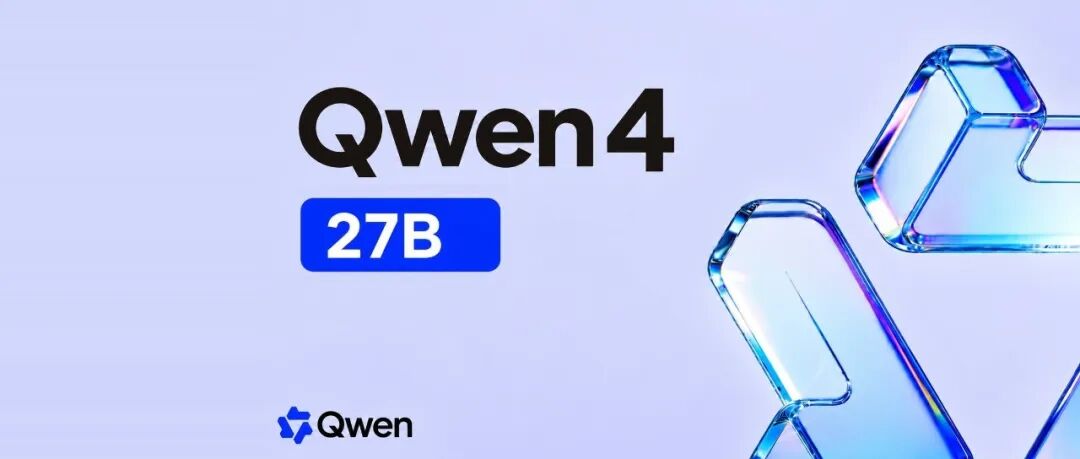
随后,社区迅速流出官方视觉物料,正中央清晰标注:Qwen 4 27B。
27B是单卡本地部署的‘神级甜点位’
官方这句“全都要”,绝非单纯的营销玩梗,而是对当下算力生态的精准打击。在本地部署圈,70B 是典型的“双卡门槛”,至少需要双张 3090/4090 或昂贵工作站;而 7B/14B 虽轻,但在深度 Coding 和长逻辑推理上往往后劲不足。27B,恰恰是单张消费级显卡的“神级甜点位”。
💡 直观理解 / 形象比喻:单卡 24G 甜点位,家用中产跑车装下超跑引擎
在 4-bit 量化加持下,27B 模型的显存占用刚好卡在 15~17GB 左右。无论是极客手里的单张 RTX 3090、4090 还是新一代 5090,都能在单卡 24G/32G 显存内塞下满血模型,同时给长上下文留出充足的安全余量。这就好比一台能轻松停进普通家用标准车位、又拥有顶级超跑赛道动力的性能怪兽,单卡即可爆发几十甚至上百 tok/s 的极速吞吐。
⚡ 算力生态解密:工位离线拔网线,0 API 账单与私有数据自主
官方暗示的“全都要”,意味着阿里很可能同步推出顶配旗舰与单卡甜点版,甚至同时打通深度思考与日常极速推理双模式。在北京中关村、后厂村、上海张江和深圳高新园,那些对数据泄密极其敏感、追求零 API 账单的工程师与研发团队,终于要迎来工位单卡断网即用的最强主力模型。
成年开发者不做选择题:云端巨无霸负责秀肌肉,单卡27B才是每天断网干活的真生产力。
JOTO 企业落地观察
- 27B 规模模型在单卡部署下的确定性表现,显著降低了 RAG 知识工程中对 GPU 集群的依赖门槛。
- 该规格模型在 4-bit 量化后稳定运行于 24G 显存设备,使 FDE 驻场共创团队可在客户现场快速搭建可验证的 AI 原型环境,无需协调云资源审批流程。
- 单卡离线运行能力强化了 AI 安全治理的物理边界控制,尤其适用于金融、政务等对网络隔离与数据不出域有刚性要求的场景。
- 当企业需在推理延迟与模型能力间做取舍时,27B 提供了一条中间路径:它不追求 70B 级别的极致复杂推理,但足以支撑多数业务场景下的结构化任务生成与知识召回。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们