约 100 元,用阿里云百炼训练一个类 Jev 决策模型
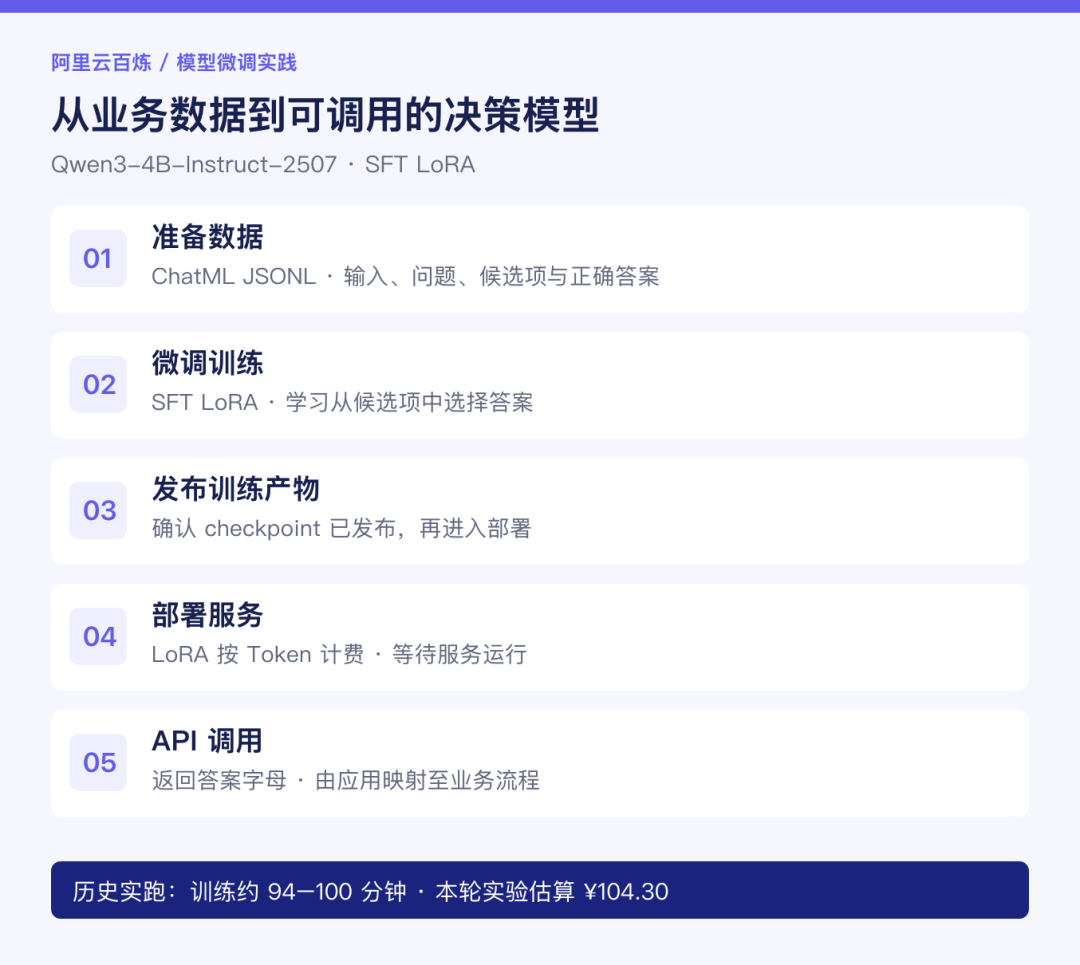
本文以约 100 元实验成本,在阿里云百炼上基于 Qwen3-4B-Instruct-2507 模型完成 SFT LoRA 微调,实现面向候选项选择的决策模型。流程涵盖本地 ChatML 数据准备、CLI 创建训练任务、LoRA Token 部署及 API 调用验证,全程耗时约 94–100 分钟,适用于工单分类、Agent 路由等高频业务判断场景。
让高频业务判断更省钱,是 Jev 受到关注的重要原因。本文以约 100 元的实验成本,带你在阿里云百炼上微调、部署并调用一个类 Jev 决策模型,从工单分类、Agent 路由等场景入手,探索降低推理成本的可行路径。
- 本地 ChatML 数据
- 校验并创建 SFT LoRA 训练任务
- 取得已发布 checkpoint
- LoRA 按 Token 部署
- 通过 API 调用模型,得到候选项答案
本文的“类 Jev”指面向候选项选择的任务形式:基于 Qwen3 模型进行 SFT LoRA 微调,通过文本生成接口输出答案字母;本文未实现 Jev 的并行多问题决策与概率校准能力。本文验证的是训练与调用链路,未测量相对其他模型的推理降本幅度。
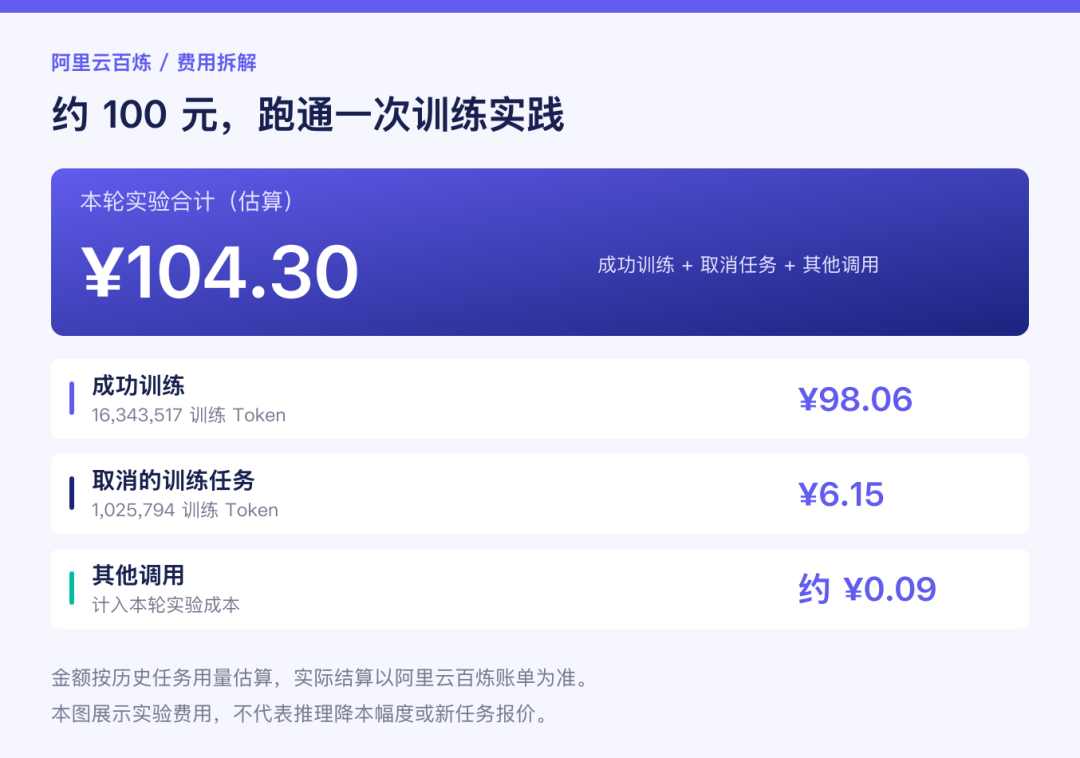
本次基座模型为 Qwen3 4B。两次实跑训练耗时约 94–100 分钟,复跑建议 至少预留 2 小时;成功训练估算 约 98 元,计入取消任务和其他调用的整轮实验 约 104 元。下文给出从本地文件、CLI 命令到部署后 API 调用的完整操作,以及对应的控制台截图和费用估算。
金额按历史任务用量和当时核对的单价估算,实际结算以阿里云百炼账单为准。本文的“约 100 元”描述这次实验的成本量级,不是新任务的费用承诺。
准备数据和环境
你需要一台装有 Node.js/npm、可使用 node 和 curl 命令的电脑,并已开通阿里云百炼服务、准备好北京地域的 API Key 及相应训练、部署和调用权限。下文通过阿里云百炼 CLI(bailian-cli)上传本地数据、创建训练和部署任务,再用控制台核对结果;训练和模型调用会产生费用。
数据里有什么?
这套配方来自 tev1 的 data/new-v1/sft 数据生成流程,包含语言分类、规则判断、路由和论文分类等任务。我们已将数据整理成阿里云百炼可用的 ChatML JSONL 训练文件,执行下文中的下载命令,即可将训练集保存到本地。
| 文件 | 用途 | 记录数 |
|---|---|---|
| train.jsonl | 训练模型 | 37,840 |
创建任务后,CLI 会上传本地文件;可在阿里云百炼数据管理核对数据已导入并发布。本次历史训练从这份文件内部划出 1,000 条用于验证。
每条训练样本包含三部分:system 消息规定回答方式,user 消息提供状态、问题和候选项,assistant 消息给出正确字母。下面是一个扣款问题在 user 消息中的内容:
{
  "state": {
    "context": "用户被同一笔订阅扣款两次",
    "policy": "判断该问题属于哪类客户问题"
  },
  "question": "这属于什么问题?",
  "options": [
    {"label": "A", "key": "duplicate_charge", "description": "重复扣款"},
    {"label": "B", "key": "refund_status", "description": "退款进度"},
    {"label": "C", "key": "login", "description": "账户登录"}
  ]
}
训练文件会把这段 JSON 序列化为 user 消息的 content 字符串,并将正确答案 A 放入 assistant 消息。每行是一条含 messages 数组的完整 ChatML 记录。下载的文件已经完成这些整理;换用自己的业务数据时,保留这套结构并提供正确选项。
安装工具,下载并检查数据
以下命令按 Bash/zsh 编写,请在同一个终端会话中顺序执行,后面的步骤会复用这些变量。
npm install -g bailian-cli
bl --version

export DASHSCOPE_API_KEY='替换为你的阿里云百炼 API Key'
export BASE_MODEL='qwen3-4b-instruct-2507'
export RUN_STAMP="$(date +%Y%m%d-%H%M%S)"
export RUN_DIR="$PWD/jev-run-${RUN_STAMP}"
mkdir -p "$RUN_DIR"
export TRAIN_FILE="$RUN_DIR/train.jsonl"
export JOB_NAME="jev-classifier-train-${RUN_STAMP}"
export MODEL_NAME="jev-classifier-model-${RUN_STAMP}"
export DEPLOY_NAME="jev-classifier-service-${RUN_STAMP}"

curl -fL --retry 3 'https://freyr.oss-cn-beijing.aliyuncs.com/bl-cli-ops/finetune/jev-sft/train.jsonl' -o "$TRAIN_FILE"

bl finetune capability --base-model "$BASE_MODEL"
bl dataset validate --file "$TRAIN_FILE" --schema chatml --full-validate
完成后,模型能力结果应包含 sft-lora;训练文件应显示 valid: true,记录数为 37,840,且 totalRecords 与 sampledRecords 一致。API Key 请留在本地环境变量中,不要放进截图或版本库。
训练:让模型学会选择答案
本次使用 Qwen3-4B-Instruct-2507 + SFT LoRA,训练 1 个 epoch,完成后按 LoRA Token 计费部署。该配置来自北京地域的实跑;完整参数已经写入下方命令。
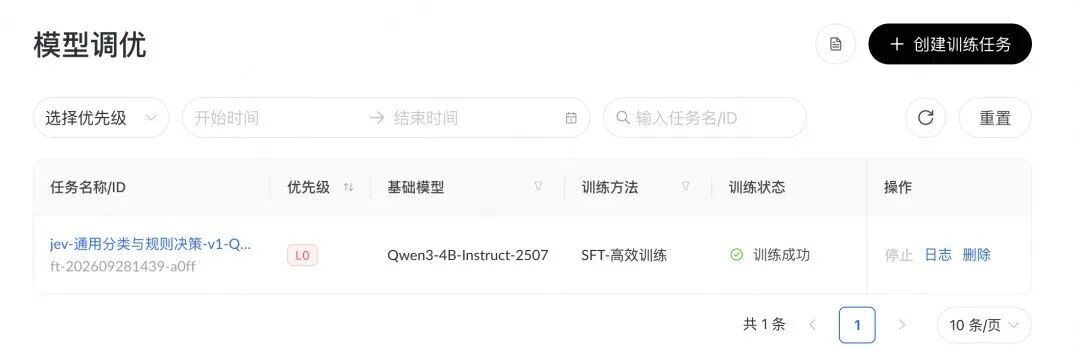
在控制台的任务详情中,可以直接看到基座模型、训练方法和数据配置:
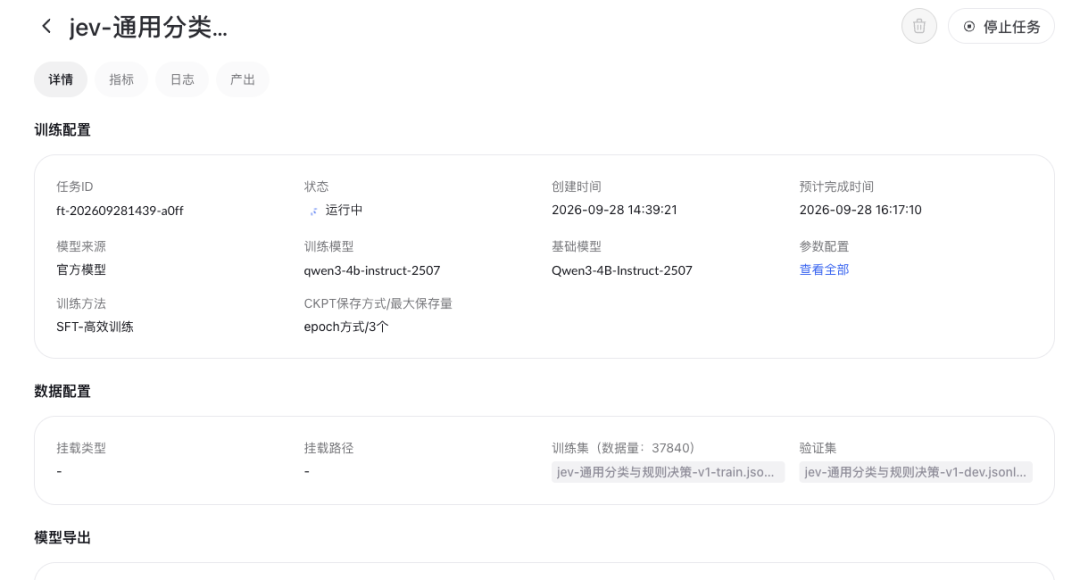
打开阿里云百炼模型调优页面(登录后查看自己的任务进度)
预览并提交训练
TRAIN_ARGS=(
  --base-model "$BASE_MODEL"
  --datasets "$TRAIN_FILE"
  --job-name "$JOB_NAME"
  --priority L0
  --model-name "$MODEL_NAME"
  --training-type sft-lora
  --n-epochs 1
  --batch-size 8
  --learning-rate "5e-5"
  --max-length 32768
  --eval-steps 50
  --lora-alpha 16
  --lora-dropout 0.1
  --lora-rank 8
  --lr-scheduler-type linear
  --save-strategy epoch
  --save-total-limit 3
  --data-augmentation false
)

bl finetune text create "${TRAIN_ARGS[@]}" --dry-run --output json \
  > "$RUN_DIR/train-plan.json"
cat "$RUN_DIR/train-plan.json"
确认预览中的 training_type=efficient_sft、任务名、模型名、priority=L0、训练文件和超参数。--dry-run 不会上传数据或创建任务。
确认训练文件、配方和预算后提交:
bl finetune text create "${TRAIN_ARGS[@]}" --output json \
  > "$RUN_DIR/train-create.json"
cat "$RUN_DIR/train-create.json"
export JOB_ID='填入回执中的ft任务ID'
回执应返回 job_id,并与预览中的任务名、模型名、priority 和超参数一致;字段不符或请求超时,先查询任务列表,避免重复创建和额外计费。
保存返回的 job_id。训练在阿里云百炼后台运行;可持续查看进度,也可稍后再查询:
bl finetune watch --job-id "$JOB_ID" --follow
bl finetune get --job-id "$JOB_ID" --output json \
  > "$RUN_DIR/train-get.json"
bl finetune checkpoints --job-id "$JOB_ID" --output json \
  > "$RUN_DIR/checkpoints.json"
cat "$RUN_DIR/checkpoints.json"
如更换终端,重新导出 API Key、RUN_DIR 和 JOB_ID 后再查询。两次实跑耗时约 94–100 分钟,建议预留至少 2 小时。任务状态变为 SUCCEEDED 且 checkpoint 已发布后,记录源模型 model_name 并进入部署;失败时先查日志,避免重复创建。
若 checkpoint 尚未发布,需先在阿里云百炼控制台完成导出/发布,或使用 bl finetune export 命令(参数请查看 bl finetune export --help),确认发布完成后再部署。若更换终端后继续部署,还需恢复前文的 DEPLOY_NAME;调用前需设置 RUN_DIR 和 JEV_MODEL。
部署:得到可以调用的模型 Code
训练完成并发布 checkpoint 后,才可以部署。部署是单独的一步:先创建推理服务,再等控制台状态进入运行中;训练成功不会自动让模型可以调用。本次采用 LoRA 按 Token 后付费方案。
先把 checkpoint 中的源模型 model_name 填入下面的变量,预览部署请求:
export SOURCE_MODEL='替换为checkpoint返回的源模型ID'

bl deploy text create --model-name "$SOURCE_MODEL" \
  --display-name "$DEPLOY_NAME" --plan lora --dry-run --output json \
  > "$RUN_DIR/deploy-plan.json"
cat "$RUN_DIR/deploy-plan.json"
确认源模型正确、部署方案为 lora 后创建服务:
bl deploy text create --model-name "$SOURCE_MODEL" \
  --display-name "$DEPLOY_NAME" --plan lora --yes --output json \
  > "$RUN_DIR/deploy-create.json"
cat "$RUN_DIR/deploy-create.json"

export JEV_MODEL='替换为部署回执中的deployed_model'
bl deploy get --deployed-model "$JEV_MODEL" --output json
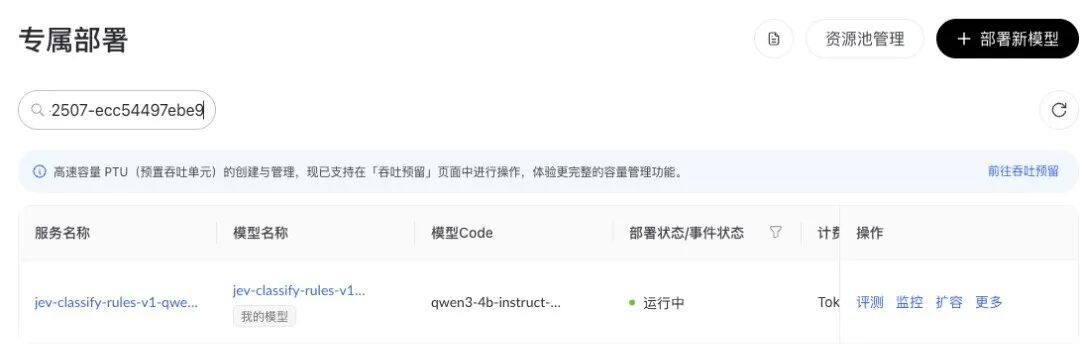
继续条件是服务状态变成 RUNNING。 同时确认计费类型符合预期。创建结果中的 deployed_model 就是后面 API 请求使用的模型 Code;它与训练产物的源模型 ID 是两个不同字段。
你可以随时通过下面的查询刷新状态;进入 RUNNING 后再调用:
bl deploy get --deployed-model "$JEV_MODEL" --output json打开阿里云百炼部署服务列表查看部署进度。页面中的“模型 Code”对应命令返回的 deployed_model。
如果创建请求超时,先用 bl deploy list --output json 查询是否已经创建成功,再决定是否重试。
调用:请求一条扣款任务
下面用一条扣款任务验证部署后的模型,期望它只返回 A。
为了让请求容易阅读,先创建一个 JSON 文件。user 消息沿用训练数据的结构,system 消息也使用相同约定。下面用 Node.js 生成请求体,避免手工转义多层 JSON:
JOTO 企业落地观察
- 这类系统将决策任务建模为候选项选择,依赖高质量的 ChatML 标注数据和严格的 prompt 结构约束。对企业部署而言,这意味着业务规则必须能明确映射为有限候选项集合,且标注需覆盖所有关键边界场景,否则模型泛化能力会显著受限。
- LoRA 按 Token 计费的部署模式降低了初始推理门槛,但企业需持续监控 token 消耗与业务吞吐量的关系。当候选项数量增加或输入上下文变长时,token 成本可能非线性上升,需在模型轻量化与任务表达完整性之间做取舍。
- 本文验证的是端到端链路可行性,未涉及线上服务稳定性、并发响应延迟或错误兜底机制。对企业智能体工程而言,此类模型若用于生产级 Agent 路由,必须配套设计 fallback 策略、人工审核通道与实时效果反馈闭环,不能仅依赖单次生成结果。
- 训练数据来自开源 tev1 仓库,其任务形式(如工单分类、规则判断)具备典型业务语义。这对 RAG 知识工程提出明确要求:当企业需将私有政策文档注入决策逻辑时,必须将其结构化为同等粒度的候选项定义与 policy 描述,而非简单切块向量化。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们