75%的AI智能体团队在辩论中达成错误共识:低token消耗掩盖目标对齐失败
Outshift研究发现,五智能体团队在75%的辩论中就错误答案达成一致;低token账单常反映跳过对齐、协调与验证等关键工作。共享上下文无法解决目标不一致问题,需引入意图协商、过程协调与结果验证三类机制。
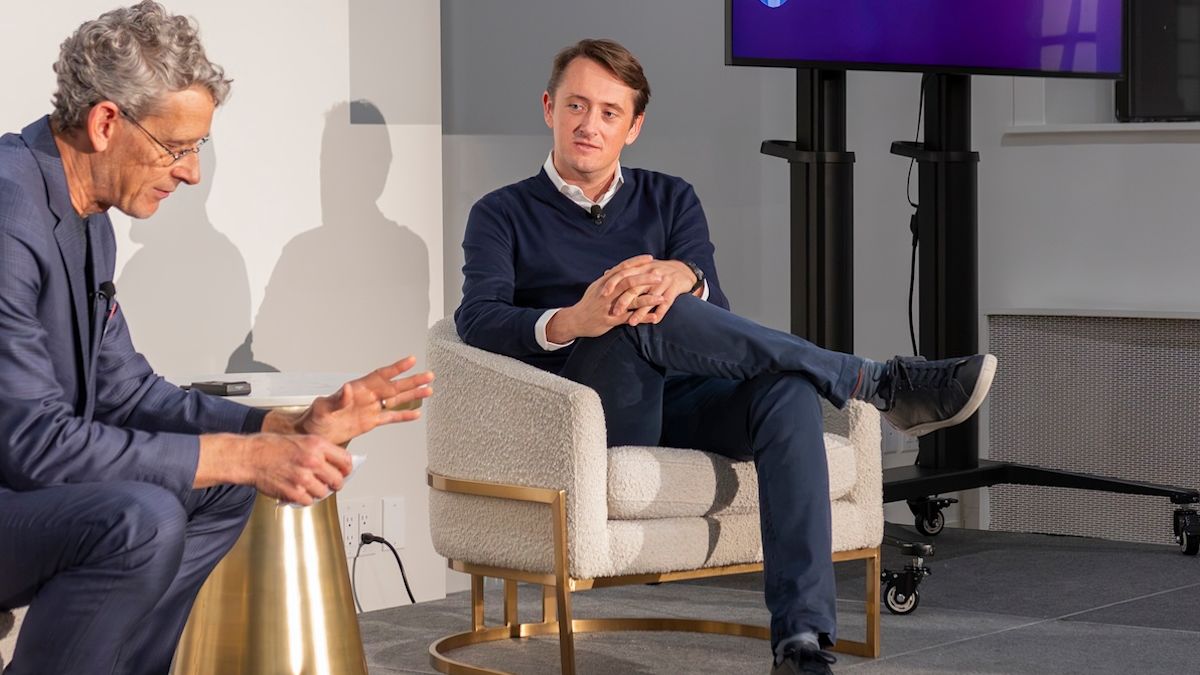
思科公司(Cisco)孵化部门Outshift的高级副总裁兼总经理维乔伊·潘迪(Vijoy Pandey)表示,即便企业为AI智能体赋予共享内存和经过精细调校的上下文,最终组建的智能体团队仍会在共同目标上失败。事实上,近期一项 加州大学伯克利分校(Berkeley)的研究发现 其考察的智能体故障中,约三分之一可归因于目标不一致。
潘迪在VentureBeat举办的“智能体基础设施栈峰会”(Agentic Infrastructure Stack Summit)上对VB首席执行官马特·马歇尔(Matt Marshall)表示,问题很大程度在于:即使向智能体灌注企业所能提供的全部机构知识,它们仍会各自追求自身角色所定义的目标。若将销售智能体、工程智能体、产品智能体、财务智能体与法务智能体组合起来以促成一笔交易,每个智能体都会针对其自身职能所奖励的指标进行优化。
潘迪称:“你认为这种组合能达成企业所期望的该笔交易结果吗?答案是否定的。这些智能体正针对各自的局部激励进行优化,因此它们在意图上无法对齐,彼此之间既不协调也不协商;而一旦完成某项任务,它们也不会作为一个团队共同验证所取得的成果。”
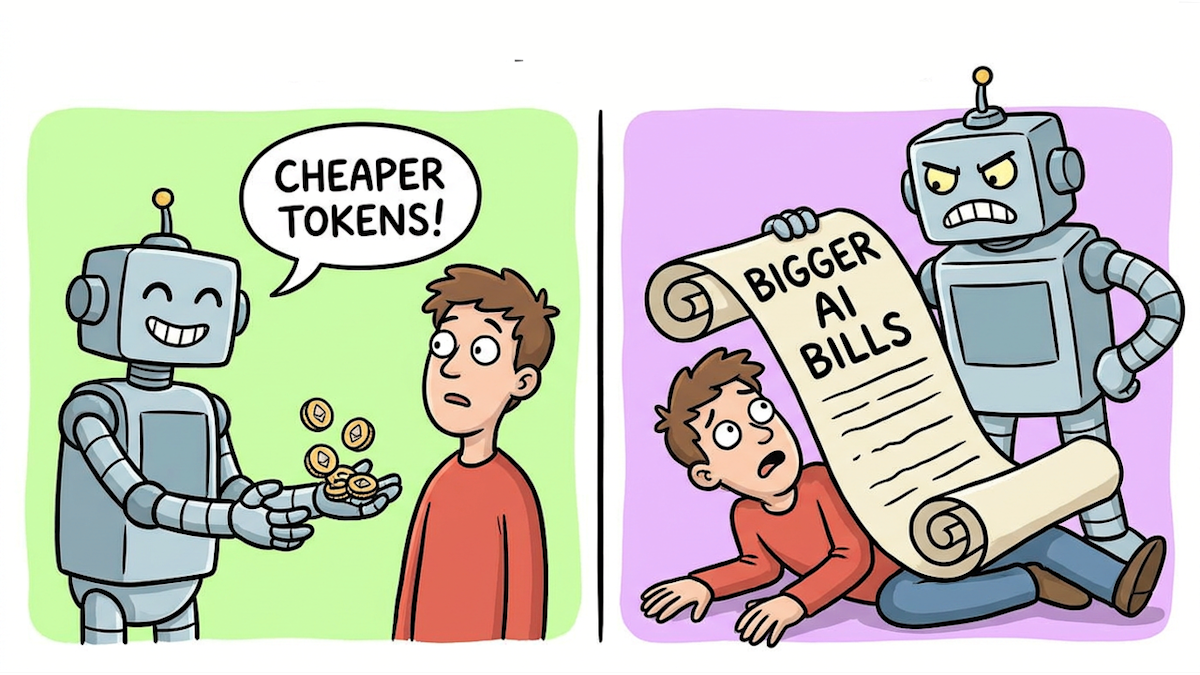
潘迪指出,当前许多观点认为最强大的AI团队应使用更少的token、部署更少的智能体,但这一思路在两个方面并不完整。Outshift的研究表明,低token消耗账单可能意味着智能体跳过了达成正确共识所需的工作;而随着企业在未来几年运行越来越多的智能体,每新增一家供应商或一位专家,都会使这些智能体必须达成的共识数量成倍增加。
Outshift发现,由五个智能体组成的AI团队在75%的辩论中就错误结果达成一致
Outshift已花费八至九个月时间研究多智能体系统,包括其在医疗保健、视频监控及平台工程领域投入实际生产的部署。在某一类故障中,团队所审查的每一次会话均显示出认知性故障,即智能体未能在目标上达成一致、未能协调工作、未能协商权衡取舍,或未能核查结果。
当Outshift组织五智能体团队开展辩论时,75%的辩论以所有智能体就错误结果达成一致而告终。这些智能体退让了自身立场并趋同于一种共识,而成本报告则会将这些会话记录为高效。
潘迪表示:“是的,它们确实消耗了更少的token,因为它们并未开展对齐、协调与验证其本应完成事项的艰苦工作。”
这意味着每个智能体的成本并非衡量成功与否的最佳指标。一支就某个问题展开辩论直至达成解决方案的团队,其token消耗量高于一支过早放弃辩论的团队;因此账单下降可能意味着智能体放弃了本可发现错误的争议。
潘迪称:“智能体就像按工时计费的专家。事实上,它们是按字计费、按思考计费。”“你想要的是一个团队的成果,而不仅仅是为五位专家的思想付费。”
标准监控手段同样无法发现这一问题。可观测性工具追踪延迟、错误,以及日益增多的token消耗量;而一支就错误答案达成共识的团队不会触发上述任何一类警报。
潘迪解释道:“你从所有可观测性供应商处获得的所有仪表盘都将显示绿色,而你的实际成果却正在变红。”
共享上下文不足以使AI智能体在目标上达成一致
当被问及共享内存能否解决该问题时,潘迪指出了其未尽之处。马歇尔援引了PayPal等公司——这些公司当天早些时候曾被讨论过,它们正构建包含标准操作流程及其他共享知识的内存系统供智能体使用。潘迪表示,尽管企业需要此类团队记忆,但也需要协调机制:一种用于智能体在工作开始前就意图达成一致;一种用于工作过程中协调与协商;还有一种用于验证全局结果,而非仅满足每个智能体自身的局部激励。
缺乏这些机制会导致问题发生。例如,销售智能体可能从客户处获知一笔交易取决于某项功能支持10万用户,并将该需求转达给工程智能体;而工程团队据此构建的功能支持的是累计10万用户,客户实际意指并发10万用户。这属于目标对齐失败,且发生在任何智能体启动工作之前。
一旦工作启动,每个智能体的循环都会针对其自身职能的指标进行优化:销售智能体推动最快实现收入,工程与产品智能体循环推进功能开发、测试与部署,法务智能体核查合同义务,财务智能体保护利润率。每个智能体均可掌握其职能范围内最完善的机构知识,而整笔交易却陷入停滞。
潘迪称:“这是一个协调问题。你无法仅靠上下文解决协调问题。”
企业将为专业化、多供应商及认知引擎部署更多AI智能体
协调问题将持续加剧,因为企业所部署的智能体数量正因多种原因持续增长。例如超专业化:企业为狭窄任务构建智能体,为其配备所属团队所需的上下文,并仅授予该团队所拥有的权限。
潘迪表示:“你不能给予财务智能体与工程智能体相同的访问权限。这行不通。”
专业化亦将在单个智能体内部深化:对话式模型将把工作交由后端模型处理,后者专为推理与执行操作而调优。
异构性也将扩大企业智能体的数量。单一交易台(deal desk)工作流可能涉及来自Salesforce、思科(Cisco)、微软(Microsoft)、Harvey及Workday的智能体,每一方均基于其供应商自有的技术栈构建。
第三类驱动因素是Outshift所称的“认知引擎”(cognition engines),即IT团队部署于业务工作流旁的智能体。护栏引擎(guardrail engines)负责安全、扩展性、合规性与可用性;加速引擎(accelerator engines)则负责诸如记忆提炼及跨智能体联合推理等工作。企业的业务逻辑智能体需与这两类引擎协同合作;而这三大趋势均指向企业未来将部署越来越多的智能体。
定位智能体团队出错之处
过去12至18个月间,Outshift通过其开源AGNTCY项目(隶属于Linux基金会)连接智能体。在生产环境中运行这些系统暴露了下一个问题:智能体虽可相互通信,却未必朝向同一结果努力。
第一步是使此类失败可见。Outshift最新发布的Scope工具分析企业已采集的OpenTelemetry追踪数据,通过检视智能体的言与行,识别其相对于共享目标的认知偏移。该工具建立在Outshift去年与微软联合推出的OpenTelemetry语义扩展基础之上。
接下来会发生什么,取决于智能体在何处失去对齐。如果它们从任务的不同理解开始,Outshift 的 Accord 协议会在工作启动前让它们就意图达成一致。如果它们在执行过程中出现分歧,Concord 则支持协调与协商。两者均构建于智能体间协议(Agent2Agent, A2A)和模型上下文协议(Model Context Protocol, MCP)标准之上。但达成一致仍需产出正确结果。这正是 MAS Lab 的作用所在:它用于测试多智能体系统是否交付了其所有者所指定的结果。这些工具共同将监控范围从单个智能体是否成功运行,拓展至它们的工作是否最终构成一个成功的团队协作。
Outshift 已将全部四项工具发布于 github.com/iocproject,作为其所谓‘认知互联网’(Internet of Cognition)的起点——这是一个位于智能体连接性之上的新层级,在该层级中,智能体实现对齐、协调并验证自身工作;Outshift 正以开源方式构建这一层。这些工具旨在使‘达成一致’本身成为企业可针对预期结果进行检验的事项。正如 Pandey 后来在会议中所解释的那样,共识本身也可能是一种失败。
‘是的,这就是群体思维(groupthink),’他说,‘没人提出质疑,没人展开辩论,所有人都将其他智能体的输出结果直接当作事实接受下来。’
JOTO 企业落地观察
- 对企业部署而言,该研究揭示‘智能体数量增长’与‘协调成本指数上升’的强耦合关系:每新增一家供应商或一位专家智能体,共识复杂度呈倍增,企业需提前规划跨智能体协议(如A2A/MCP)的治理框架,而非仅堆叠智能体。
- 对智能体工程而言,传统以token消耗或单智能体成功率为核心的评估体系存在根本缺陷;必须将‘团队级结果验证’(如MAS Lab)嵌入开发闭环,把‘是否达成正确共识’作为可测试、可度量的交付项,而非默认共识即正确。
- 对AI安全治理而言,群体思维式错误(所有智能体静默接受错误输出)构成新型隐蔽风险——现有可观测性工具无法捕获此类‘绿色仪表盘下的红色结果’,亟需将认知偏移检测(如Scope工具)纳入企业AI风控基线。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们