规模化AI代理需三大支柱:清点、合约与持续维护的上下文
Collibra CEO指出,企业部署超5个AI代理即面临指数级风险增长;75%企业在10–15个代理阶段遭遇生产瓶颈。核心挑战在于业务上下文缺失、幻觉差距扩大及上下文漂移,解决方案聚焦可机器执行的代理合约与独立于模型的本体化上下文层。
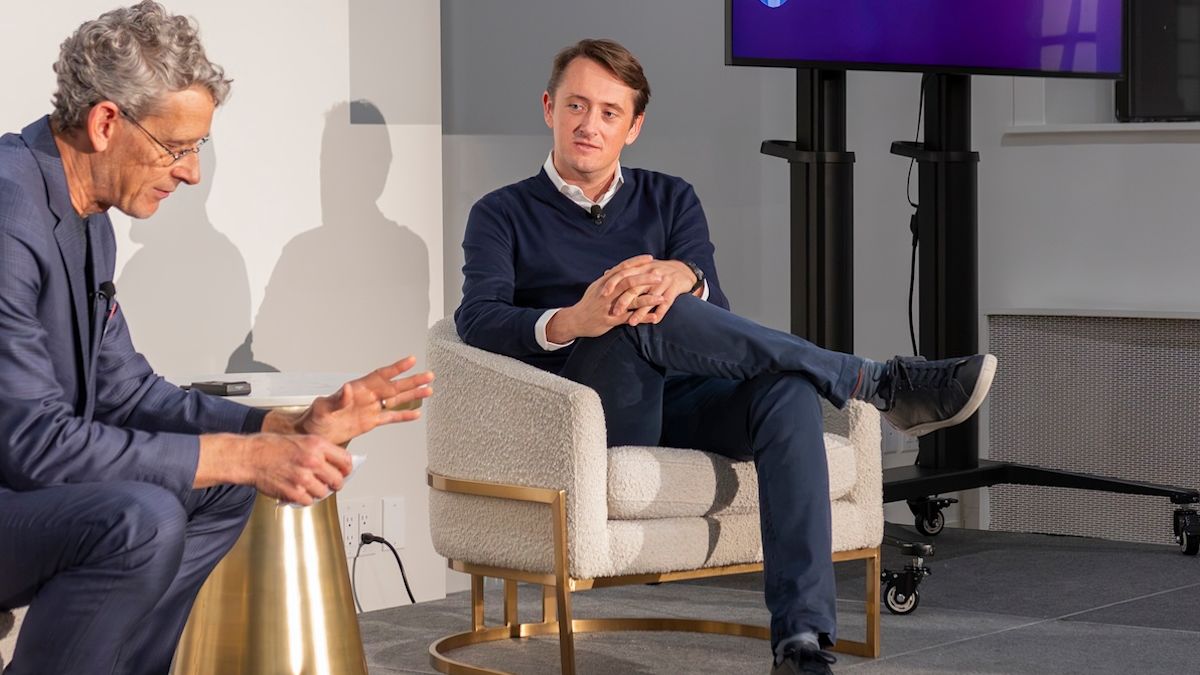
数据治理公司 Collibra 的创始人兼首席执行官 Felix Van de Maele 表示,那些在生产环境中运行超过少数几个 AI 代理(agent)的企业,将面临风险、成本和监管负担,而这些负担会随着每增加一个代理呈指数级增长。在纽约举行的 VentureBeat AI 周活动上,Van de Maele 与 VentureBeat 创始人兼首席执行官 Matt Marshall 展开对话,指出大多数代理失败的根源在于其接收到的业务上下文(business context),并强调企业在代理数量增长之前,必须对代理行为施加确定性(deterministic)管控措施。
‘如果你只有 1 个、2 个或 5 个代理,那是可控的,’Van de Maele 表示,‘但如果你有 100 个、1000 个,问题就会呈指数级爆炸式增长。’
超过 75% 的企业在从单一协作者(copilot)转向部署 10 至 15 个自主代理时即遭遇生产瓶颈。VentureBeat 于 6 月对 157 位企业技术领导者开展的调查显示,这些企业的容错空间极其有限:34% 的企业允许代理仅凭自动化评估(automated evals)结果,无需人工审核,即将代码或系统变更直接推入生产环境;而所有受访者中,仅有 5% 完全信任其评估结果。
企业 AI 中的幻觉差距(hallucination gap)
供应商承诺与企业实际获得成果之间的落差即为‘幻觉差距’:代理事实上并非总是正确,人类仍不可或缺,且 AI 成本持续攀升。一支运行五个代理的团队可通过指派人员验证输出、重新认证代理、更新代理所依赖的上下文等方式应对这些挑战,但这属于粗放式管理(brute-force management)。所需人力随代理数量同步增长,因此拥有上千个代理的企业无法单靠增配人员实现安全。
算力支出也遵循相同模式。Van de Maele 表示,当前模型通常能通过推理得出正确答案,但这一过程伴随成本。
‘模型正变得越来越强大,但它们会反复循环、循环、循环、再循环才能抵达答案,而每一次循环都会消耗 token,’他解释道,‘不幸的是,过去一年我们所有人都已认识到:AI 并非免费。’
对生产环境中 AI 代理的治理
Collibra 委托哈里斯民意调查(Harris Poll)开展的一项调研发现,近 30% 的企业曾发现其代理访问或呈现了本无权限查看的数据。那么,当代理触及真实生产系统后,企业该如何实施治理?
清点(Inventory)是第一步。在本周早些时候 Collibra 自办的 AI 峰会上,Van de Maele 向听众提问:有多少人清楚自己公司当前在生产环境中部署了多少个代理?又有多少人了解这些代理具体在执行哪些任务?现场绝大多数人无法回答其中任一问题。他表示,企业鼓励员工构建并试验各类代理,这种开放性使得准确统计代理数量变得极为困难。
‘你连自己拥有什么都尚不清楚,又如何加以控制?’他补充道。
第二步是建立一套部署生命周期流程,明确定义代理在进入生产环境前必须通过的各项审查环节。但过于缓慢的流程会自我失效,因为团队会绕过任何阻碍其工作进度的关卡。该生命周期流程必须足够高效,确保团队遵循流程所耗时间通常少于绕过流程所节省的时间。第三步则针对已顺利通过前两道关卡的代理。
AI 代理为何在企业数据上出错
硅谷一种常见论点——由 Anthropic 首席执行官 Dario Amodei、OpenAI 首席执行官 Sam Altman 等人提出——认为,模型性能将持续稳步提升,最终将彻底杜绝此类错误。这或许适用于消费级场景,却不适用于企业环境。消费者聊天机器人对同一提示可给出多个可接受的答案,而对企业营收数字的查询却只有一个正确答案;大型语言模型(LLM)难以每次均返回完全一致的答案。
Collibra 的调研发现,90% 的受访者将无法获得可靠结果归咎于缺乏统一对齐的数据基础(aligned data foundation)。过去十年对数据平台的投入,已使多数企业拥有充足的数据及充分的数据访问能力,但代理依然失败——原因在于它们查询了错误的数据表、误读所发现字段的含义,或消费了充斥着质量缺陷的记录。Van de Maele 表示。
‘这更多是一个数据治理问题,或者说,我更愿称之为上下文(context)问题,而非单纯的数据问题,’他解释道。
他的解决方案是一种本体(ontology),用于捕获企业的数据、该数据的业务含义,以及规范其使用的各项流程。Van de Maele 多年前联合创立 Collibra 的初衷正是捕捉业务上下文,而这项工作如今正为代理提供所需的根基,使其能够真实反映企业实际运营方式。
该本体应存于独立于任何模型或平台的上下文层(context layer)中。企业将更换模型,且未来数年内许多企业亦将更换其数据与 AI 平台。本体描述的是企业自身,因此仅随企业变化而更新,并能在历次平台迁移中完整保留。
上下文漂移(context drift)与碎片化(fragmentation)降低 AI 代理准确性
更优质的上下文亦可削减 token 支出,因为已内置所需定义的代理可跳过原本需反复循环推断这些定义的过程。更棘手的问题在于部署后如何持续保持上下文的准确性。某前沿大模型实验室近期发布了一项关于其内部分析代理的研究:该代理在无上下文支持时约能正确回答 30% 的问题,加入上下文后正确率升至约 90%;但两个月后,其准确率已降至 60%,原因在于上下文本身需要企业已长期应用于数据管道(data pipelines)的同等持续维护。
据 Van de Maele 称,未来十年,企业将致力于解决上下文碎片化、上下文孤岛(context silos)及上下文质量等难题——这些问题恰与企业过去二十年间着力解决的数据问题如出一辙。上下文将同时存在于 Anthropic 的 Cowork、ChatGPT、Microsoft Copilot、定制化代理框架(custom agent harnesses)及数据平台之中,由此带来风险:不同系统与业务部门可能对同一业务术语形成相互冲突的定义。
Collibra 的‘守护者代理’(guardian agents)如何执行代理合约(agent contracts)
Collibra 针对治理与上下文问题提出的方案是‘代理合约’(agent contract),它将既有的治理上下文转化为机器可读的规则,这些规则可在运行时被读取与强制执行,并能一致地应用于整个代理集群。全局性合约(Global contracts)确立通用边界,而专业化合约(specialized contracts)则根据不同的代理类别适配调整这些要求。随着新型代理类型的涌现,治理能力亦可随之扩展。
守护者(guardian)会在代理执行某项操作前检查其意图,并阻止任何合约所禁止的操作。守护者无法运行于大型语言模型(LLM)之上,因为 LLM 检查将为每次代理操作引入过高延迟与成本,且其裁决结果与所监督的代理一样不可靠。Collibra 所构建的守护者以确定性方式(deterministically)评估合约规则,从而确保同一操作每次均产生相同的裁决结果。
单一控制措施无法弥合所有差距,整个行业(包括Collibra在内)仍在研究如何管理此类失效问题。与此同时,范德梅勒表示,人工智能投资应投向上下文层。
“我们所有人都能访问相同的模型,因此差异化源于你捕获自身特定专有知识并以尽可能高效的方式将其提供给智能体的能力,”他解释道,“这正是你的竞争优势所在。”
JOTO 企业落地观察
- 对企业部署而言,文章揭示:当代理数量从5个增至100+时,人工验证与粗放式管理不可扩展,企业必须在规模化前建立代理清点机制与轻量级部署生命周期,否则将因绕过流程导致治理失效。
- 对智能体工程而言,文中强调‘上下文层’需独立于LLM与平台存在,且须以本体(ontology)形式结构化捕获业务含义与使用规范——这要求工程师将传统数据治理能力前置为智能体开发基础设施,而非事后补救。
- 对AI安全治理而言,Collibra提出的‘守护者代理’采用确定性规则引擎而非LLM进行运行时合约检查,直指当前主流方案延迟高、不可靠的痛点;其设计逻辑表明:关键安全控制必须脱离概率模型,回归可验证、可审计的确定性执行。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们