← AI 智库
大语言模型
马斯克深夜放大招,新模型Grok 4.7上线!
2026 年 9 月 22 日
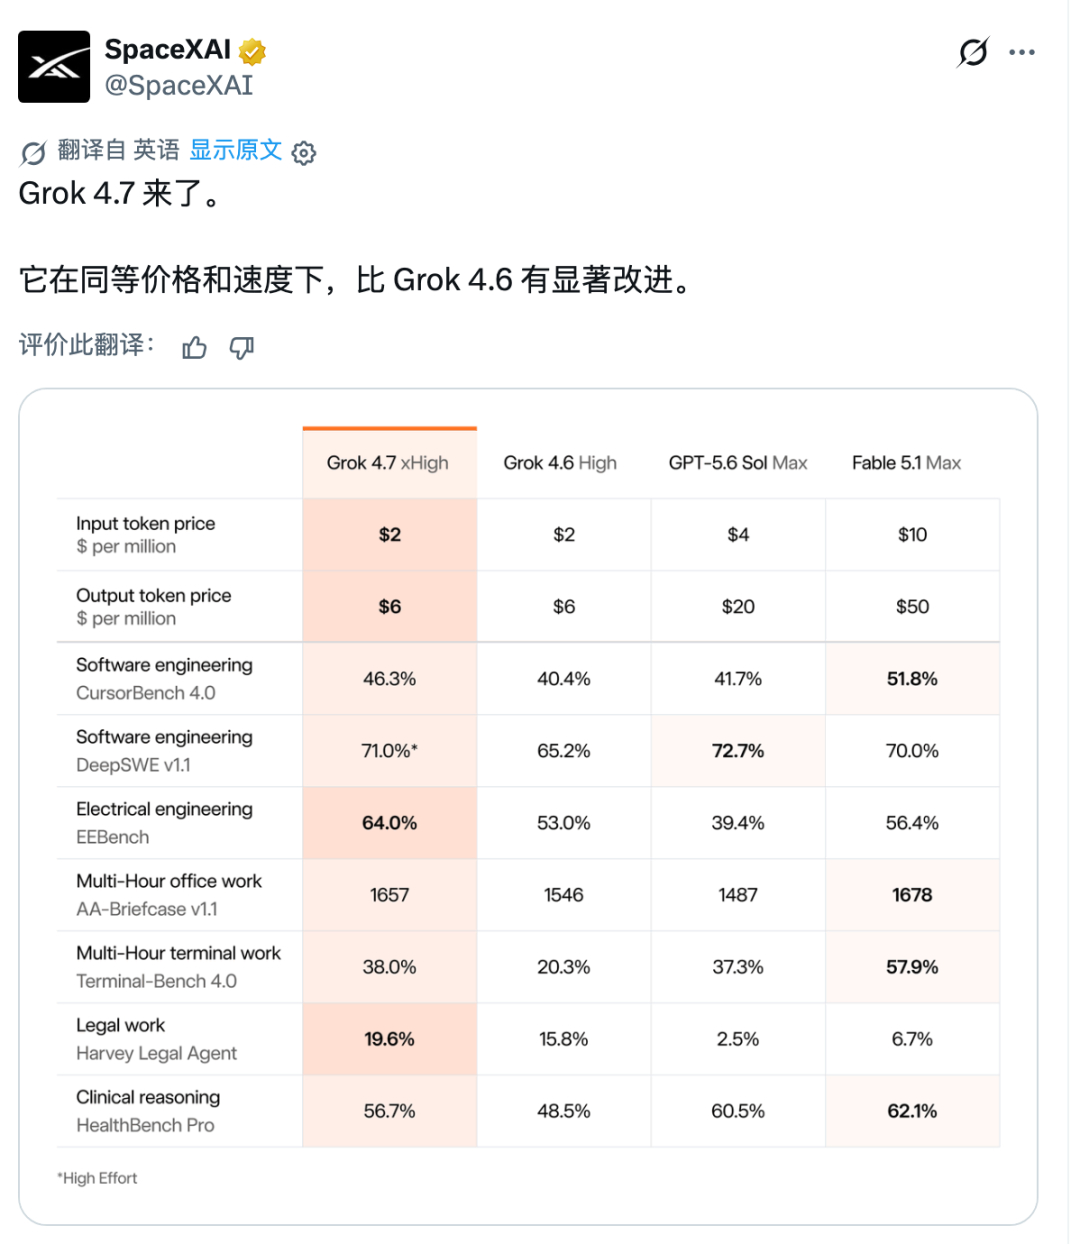
SpaceXAI发布Grok 4.7模型,主打编码与知识工作场景。相比4.6版,其在CursorBench、DeepSWE等7项基准测试中全面领先,安全指标显著提升,如HackerBench高风险提示通过率仅3.3%。输入/输出令牌定价分别为2美元/百万和6美元/百万,与前代持平,现已接入Cursor、Grok Build及API平台。
SpaceXAI发布Grok 4.7:面向编码与知识工作的最强模型
SpaceXAI刚刚发布Grok 4.7——用于编码和知识工作的最强大模型。
主要改进方向
Grok 4.7在多个技术维度实现升级:
- 使用了一个新的、更大的基础模型
- 在更难的、多小时任务上训练更长时间
- 更好地验证自己的答案
- 改进了长上下文性能
- 在文档和演示文稿方面更好
- 原生理解Grok Bot系统
- 更强的安全性和越狱保护
基准测试结果全面领先
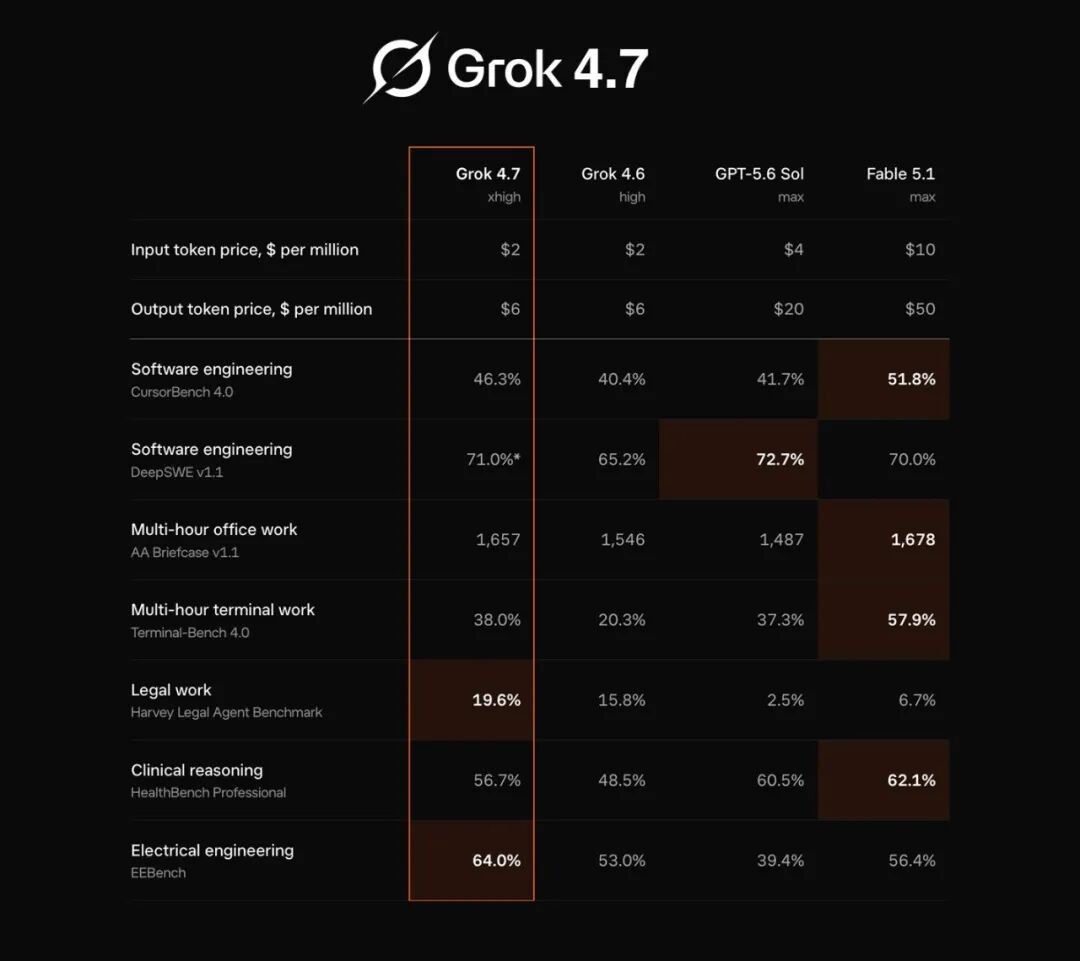
Grok 4.7在多项专业基准测试中均优于Grok 4.6:
| 基准测试 | Grok 4.7 | Grok 4.6 |
|---|---|---|
| CursorBench 4.0 | 46.3% | 40.4% |
| DeepSWE v1.1 | 71.0% | 65.2% |
| AA Briefcase v1.1 | 1,657 | 1,546 |
| Terminal-Bench 4.0 | 38.0% | 20.3% |
| Harvey Legal Benchmark | 19.6% | 15.8% |
| HealthBench Professional | 56.7% | 48.5% |
| EEBench | 64.0% | 53.0% |
Grok 4.7在列出的法律和电气工程基准测试中,得分也高于GPT-5.6 Sol和Fable 5.1。
安全能力显著增强
Grok 4.7在安全专项测试中表现突出:
- 在LatchBio的生物安全基准测试中得分为62.4%
- 在HackerBench上,只有3.3%的高风险网络提示通过
- SpaceXAI迄今为止拒绝危险请求的最强模型
- 很少阻止合法的网络安全工作
- 选定的安全合作伙伴正在获得仅邀请的红队访问权限
定价与可用性保持稳定
与Grok 4.6相同的基础价格;快速版本以双倍价格提供双倍输出速度。
| 计费项 | 价格 |
|---|---|
| 每百万输入令牌 | $2 |
| 每百万输出令牌 | $6 |
现在可在Cursor、Grok Build和Grok API中使用,也可通过编码工具、模型路由器和云平台使用。
性能与成本优势明确
SpaceXAI表示,Grok 4.7的速度是类似模型的两倍,价格是一半。
它在每个列出的基准测试中都击败了Grok 4.6,同时保持相同的API基础价格。更智能、更安全、更强大,而且仍然令人难以置信的实惠。SpaceXAI正在以令人难以置信的速度前进。
JOTO 企业落地观察
- 企业部署编码类智能体时,需权衡长上下文能力与实际任务链长度——Grok 4.7虽强化长上下文,但AA Briefcase等测试未体现超长文档处理极限,团队应结合自身代码库规模做实测验证。
- 安全越狱防护增强对RAG知识工程构成双重影响:一方面降低恶意提示导致知识泄露风险,另一方面可能误拦含专业术语的合法查询,需在检索层预设术语白名单机制。
- 输入/输出令牌差异化定价(1:3)意味着企业若依赖大量外部文档注入,需严格控制RAG检索粒度与摘要压缩率,否则输出成本将快速攀升。
- 红队访问权限仅限“选定安全合作伙伴”,表明该模型尚未开放通用安全审计接口,企业在金融、医疗等强监管领域部署前,须自行构建第三方可验证的对抗测试流程。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们