一个字都不会写的 Jev,凭什么成为 ChatGPT 之后最火的模型?
Jev 是 TypeSafe AI 推出的新型「系统一(System One)模型」,专为高频、确定性语义决策设计。它不生成文本,仅输出强类型选项与置信概率,端到端延迟 70–500 毫秒,价格低至每百万输入 Token 0.042 美元,输出 Token 免费。实测速度达传统大模型工作流的 200 倍,成本降低近 400 倍。
Jev 的本质:不做生成,只做决策
Jev 没有任何文本生成能力。但发布至今,它引发的讨论热度几乎是 ChatGPT 以来最高的一次。
过去两年,大家习惯了把所有需求都丢给通用大模型。但现实业务里,软件系统每天面对的大量请求,根本不需要写一篇洋洋洒洒的长文。系统真正需要的,往往只是一个个极小的确定性判断:
- 这封工单紧不紧急?
- 这个指令该分发给哪个下游模型?
- 用户输入的终端命令有没有删库风险?
- 刚刚检索出的这段知识到底能不能回答用户的问题?
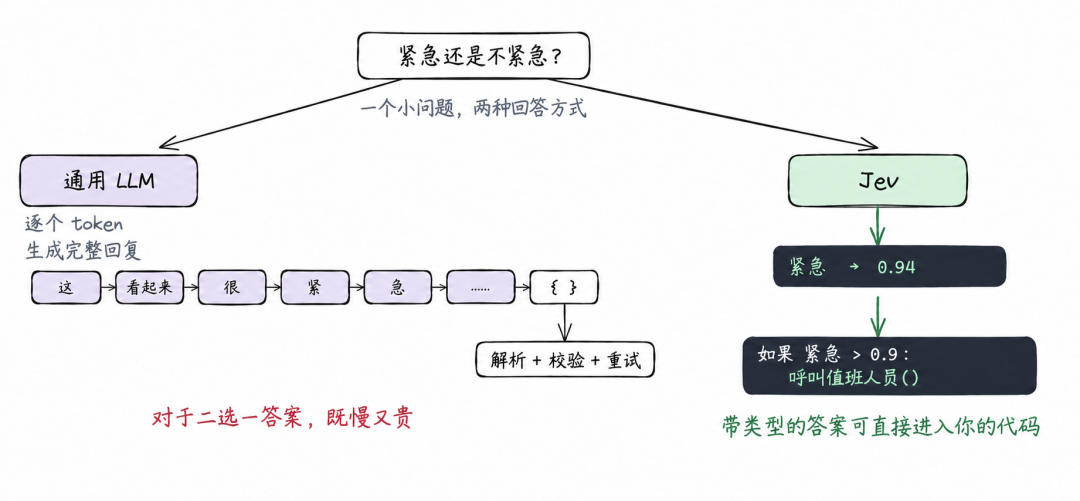
以前做这些判断,开发者必须让大模型逐字生成回答,再用代码去解析 JSON,遇到格式报错还得重试。这不仅速度慢,而且费用昂贵。TypeSafe AI 推出的 Jev,就是专门为了解决这批决策需求而设计的。
他们把 Jev 称为“系统一(System One)模型”:输入一段非结构化数据,直接输出强类型的选项和精准的置信概率。
传统大模型做判断为何太重?
在典型的 Agent(智能体)循环里,系统每走一步都要做决策:
while not done:
    action = llm(context)
    result = run_tool(action)
    context += result
在这个循环中,模型要选工具、要检查执行结果、要判断有没有风险、要决定任务是否完成。哪怕最终的决策只有一个单词,比如“finance”,传统生成式模型也是一个 Token 一个 Token 地往外吐。你既要为输入付钱,也要为生成等待。
Jev 的核心逻辑非常直接:当代码已经知道全部可能出现的答案时,使用逐字文本生成就是一种巨大的资源浪费。
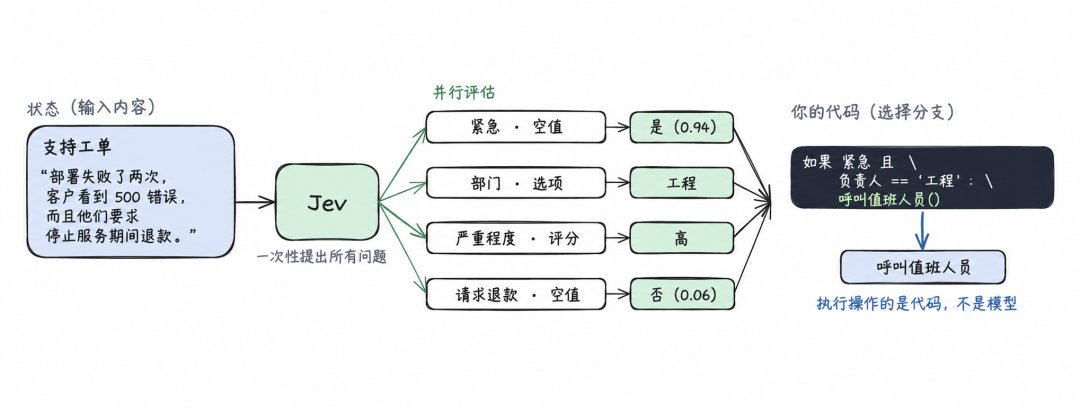
Jev 的工作方式:语义决策引擎
Jev 的本质是一个语义决策引擎。调用 Jev 时,你只需要给它两样东西:
- State(状态):描述当前情况的文本或 JSON。
- Questions(问题):你希望它基于这个状态做出的决策。
每个问题在提交前就必须固定输出类型。Jev 原生支持三种基础数据类型:
- Choice:从你定义的列表中挑选一个选项,并返回所有选项的概率分布。
- Score:把输入映射到你定义的有序等级上,比如低、中、高。
- Noul:布尔判断,返回该命题为真的概率值(0 到 1 之间的小数)。
一个典型的请求长这样:
{
  "model": "jev-latest",
  "state": "部署失败了两次,用户端开始出现大量 500 错误。",
  "questions": {
    "urgent": {
      "type": "noul",
      "instructions": "这个问题是否需要立即处理?"
    },
    "owner": {
      "type": "choice",
      "instructions": "这个问题应该分派给哪个团队?",
      "criteria": {
        "engineering": "产品故障与服务宕机",
        "billing": "扣费、发票与退款问题",
        "sales": "定价咨询与新客户开户"
      }
    }
  }
}
Jev 返回的不是一段解释,而是一个确定的概率值和一个团队概率分布。没有任何多余废话,它也不会凭空编造出第四个不存在的团队。业务代码直接接管逻辑控制:
if urgent > 0.9 and owner == "engineering":
    page_on_call()
elif confidence
很多工程师把它形容成“带语义理解能力的 switch 语句”。业务分支仍然牢牢掌握在传统代码手中,Jev 只负责提供代码本身算不出来的语义判断。
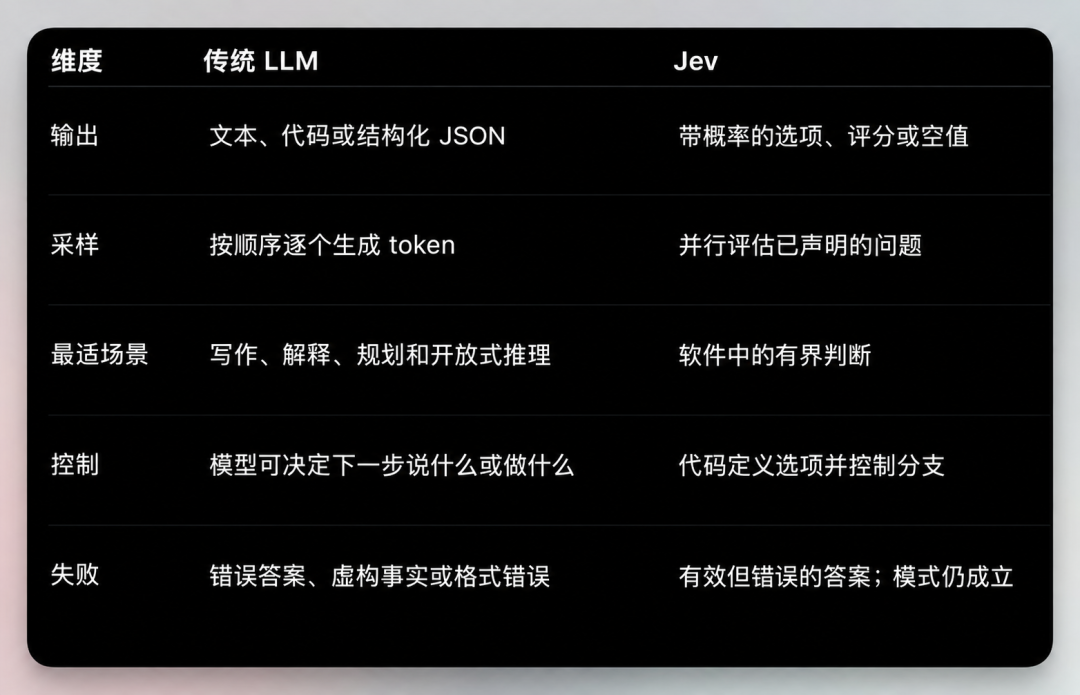
性能指标:快 200 倍,便宜 400 倍
Jev 支持在单次请求中并行评估所有问题。这意味着你不必串行提问,可以把针对同一段内容的所有独立判断一次性发过去。
官方公布的实测数据:
- • 端到端延迟:70 到 500 毫秒。
- • 价格:每百万输入 Token 仅需 0.042 美元,输出 Token 完全免费。
在官方给出的多项工作流实测对比中,它的综合执行速度大约是传统大模型工作流的 200 倍,综合成本降低了接近 400 倍。即便在复杂业务环境下把这些数据当成理论上限来看,它所带来的效率提升也是数量级维度的。
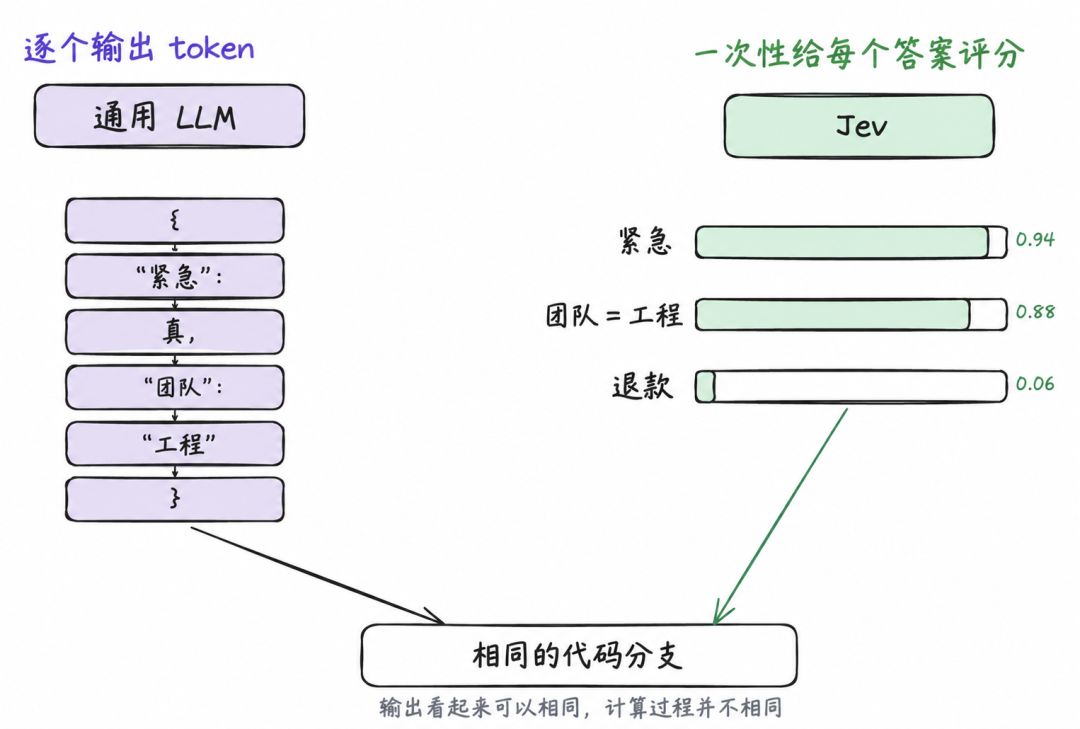
概率与置信度:关键设计价值
只给一个分类标签,往往不够安全。假设 Jev 判定一个工单属于“财务团队”,返回结果如下:
{
  "choice": "billing",
  "probabilities": {
    "billing": 0.52,
    "technical": 0.46,
    "sales": 0.02
  },
  "confidence": 0.18
}
财务获得了最高票,但技术支持拿到了 46% 的概率,整体置信度只有 0.18。如果系统直接自动分配,极易出错。
有了这层概率分布,开发者就可以在代码里明确划线:
- • 高置信度:自动执行低风险逻辑。
- • 中置信度:调用更强的大模型复核,或要求用户二次确认。
- • 低置信度:直接转入人工审核队列。
Jev 采用了“基于校准决策的强化学习(RLCD)”训练方法。当模型给出 90% 的概率判定时,其真实准确率也能高度收敛在 90% 左右。
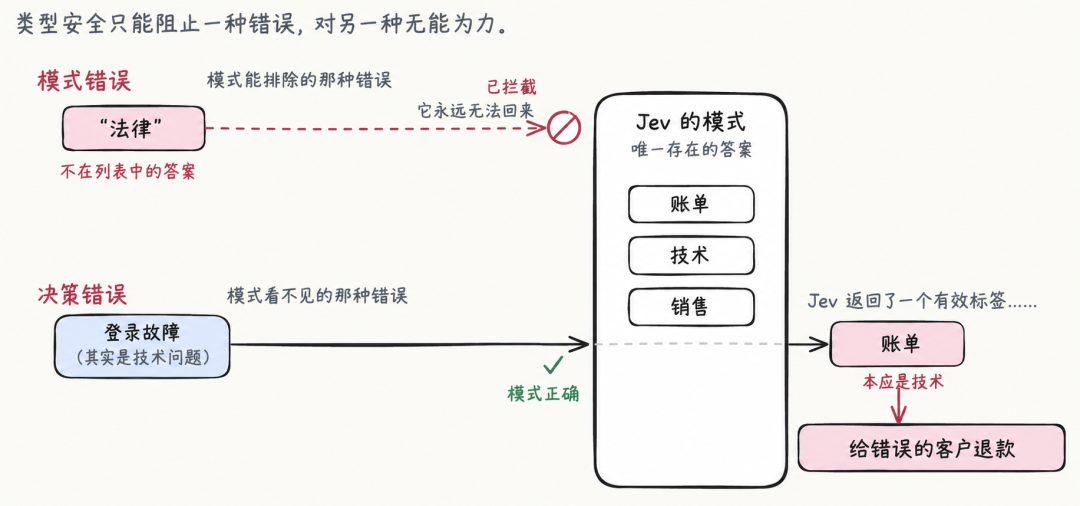
关于“不幻觉”的严格前提
官方宣传中提到“Jev 不会产生幻觉”。这个说法成立的前提非常严格。
Jev 绝不会跳出你给定的 Schema 返回格式之外的内容。如果你定义了 A、B、C 三个选项,它绝对不会返回 D,更不会输出乱码 JSON。
但这绝不代表它的判断永远正确。类型安全保证的是输出结构不崩溃,并不保证业务判断不出错。一个符合类型定义的错误判断,依然可能错误地退款、错误地分发故障工单。准确的理解应该是:Jev 保证不会破坏代码契约,但它依然有概率选错选项。
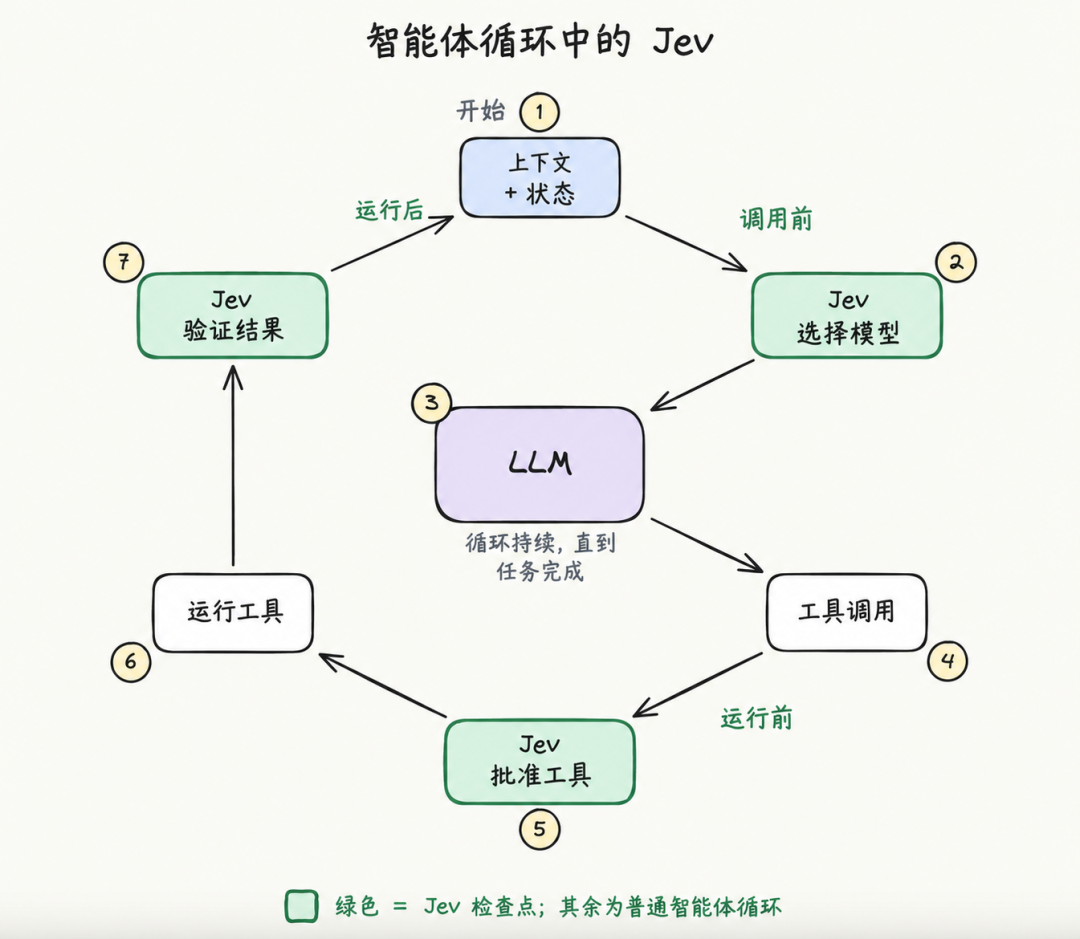
Jev 的典型落地位置
Jev 的定位非常清晰:它设计出来是配合大模型,不打算取代大模型。大模型负责写代码、写方案、做长文本推理与沟通。Jev 负责围绕在它周围,做高频、快速的边界控制。
目前最成熟的落地场景有三个:
1. 模型路由(Model Routing)
面对用户请求,先由 Jev 判断任务难度。简单的检索和改写直接分派给廉价小模型,高难度的架构设计再路由给昂贵的推理模型。
2. 工具执行风控(Tool Risk Gating)
在 Agent 调用终端命令前,用 Jev 判断命令是只读、可逆还是破坏性的。破坏性操作自动暂停,等待人工授权。
3. 结果校验与监管(Verification)
在任务结束前,让 Jev 快速检查:测试用例跑通了吗?Agent 是否陷入了重复调用的死循环?输出是否违背了预设规则?
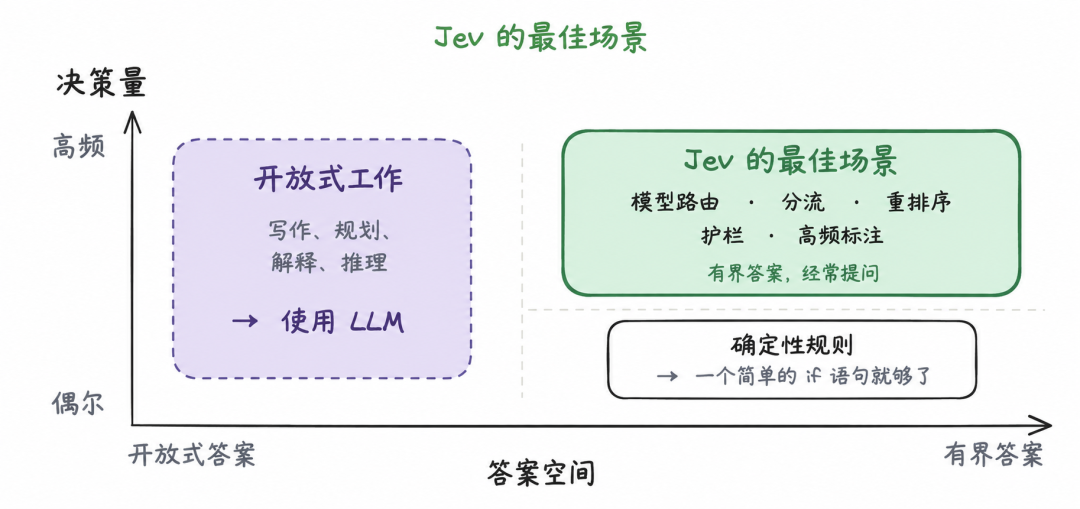
适用边界:何时绝对不要用 Jev?
任何不需要它的地方,都不要强行引入:
- 答案空间不确定时:如果要写文章、做总结、生成代码,必须使用传统大模型。
- 确定性逻辑运算:数学计算、字符计数、日期对比,直接用纯代码实现,纯代码永远比模型更便宜、更快、更可靠。
- 需要复杂长链条推理时:多步骤逻辑推演应该交给具备思维链能力的推理模型,或者把大问题拆解成多个离散的小问题再交给 Jev。
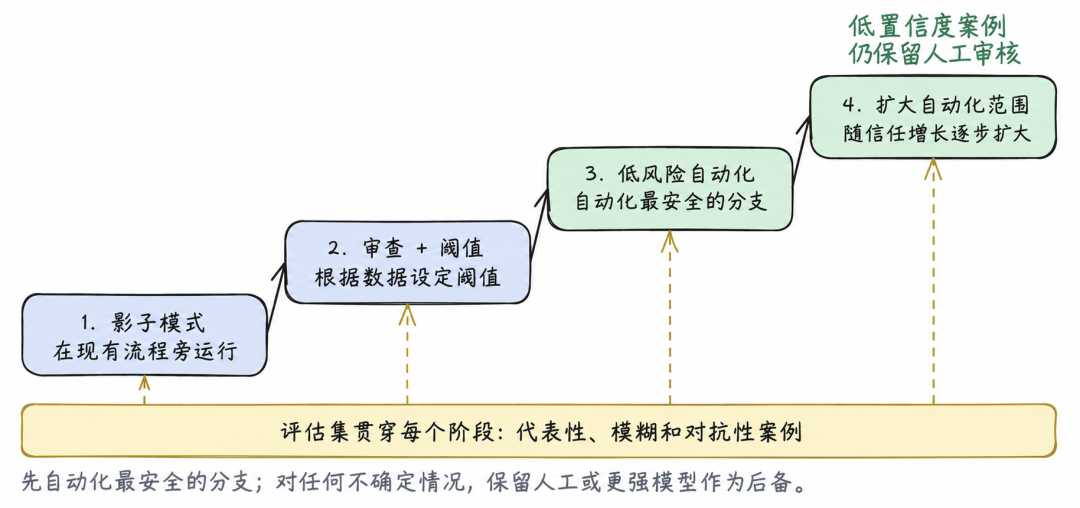
如何开始接入?
不要一上来就重构核心业务。最稳妥的接入方式是:
- 挑一个目前维护成本最高、容易出错的正则规则,或者一个调用大模型只为拿到是非判断的节点。
- 明确写出这个节点所有可能的选项定义。
- 开启 Shadow 模式(影子模式),让 Jev 和现有逻辑并行运行,收集数据并校准置信度阈值。
- 确认准确率达标后,再正式切换流量。
目前 TypeSafe 已经完全放开访问,无需等待名单。注册赠送 5 美金额度,相当于可以直接测试约 1.2 亿个 Token 的输入量。
整个行业在过去几年里,习惯了用文字生成去解决一切问题。但在很多工程系统里,代码需要的往往不是更多优美的文字,而是一个毫秒级响应、不破坏格式、成本极低的准确判断。这也是 Jev 能够迅速引爆开发者圈子的根本原因。
JOTO 企业落地观察
- 企业部署智能体系统时,Jev 这类专用决策模型可显著降低推理成本与延迟,尤其适合嵌入在 LLM 周边执行高频、轻量、确定性判断,避免将简单决策交由昂贵大模型承担。
- 在 RAG 知识工程中,Jev 可用于实时校验检索片段与用户问题的相关性,替代传统关键词匹配或轻量分类器,提升召回质量的同时保持低延迟与强可控性。
- AI 安全治理环节,Jev 的 Schema 强约束与置信度输出,为企业提供了可审计、可阈值干预的自动化风控支点,例如对工具调用、敏感操作、输出合规性进行细粒度拦截。
- FDE 驻场共创中,Jev 的接口简洁性与 Shadow 模式支持,使其成为一线工程师快速验证、渐进替换旧有规则引擎的理想切入点,降低 AI 工程化落地门槛。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们