端侧智能体时代加速落地:锐龙AI Max+ PRO 495强势领跑新一代AI智能体主机
AMD发布锐龙AI Max+ PRO 495处理器,全球首款可在本地运行3000亿参数模型的x86客户端芯片,支持192GB统一内存与CPU+GPU+NPU三引擎异构计算。首发即联合9家厂商推出新品,覆盖迷你主机、工作站、笔记本等全形态;生态层面通过春雷/春雨/春笋计划及创新大赛推动行业方案、高校科研与开发者落地。当前AI智能体Token消耗占总量约80%,端侧算力回流已成为企业降本与数据安全刚需。
三引擎异构+192GB统一内存:把3000亿参数模型放到桌面
锐龙AI Max PRO 400系列最颠覆的叙事,是“把云端级模型装进本地设备”。它是全球首款能够在本地运行3000亿参数模型的x86客户端处理器,而在这一能力背后,是架构、内存与评测标准的三重升级。
首先,三引擎各司其职,实现异构算力满血释放。旗舰款锐龙AI Max+ PRO 495基于Zen 5架构,具备16核32线程,最高加速频率可达5.2GHz,配备80MB总缓存;内部集成RDNA 3.5架构的Radeon 8065S显卡(拥有40个图形计算单元)和最高55 TOPS算力的NPU,形成CPU、GPU与NPU三重引擎异构计算平台。CPU应对复杂调度、GPU搞定批量推理、NPU跑常驻轻任务,相比没有独立NPU的同类竞品,这种“三驾马车”式的分工协作,正是AI智能体工作流最需要的算力形态。
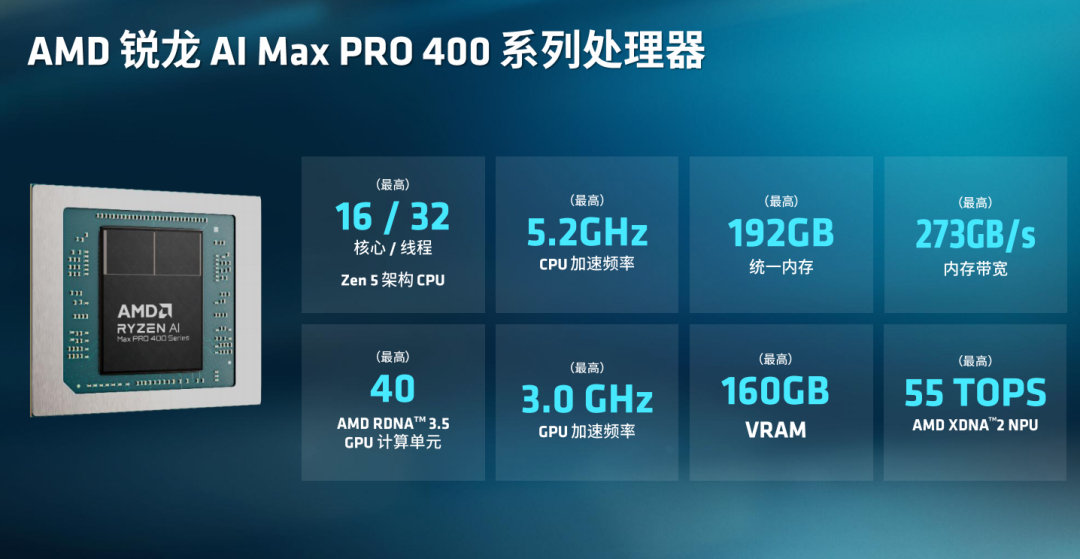
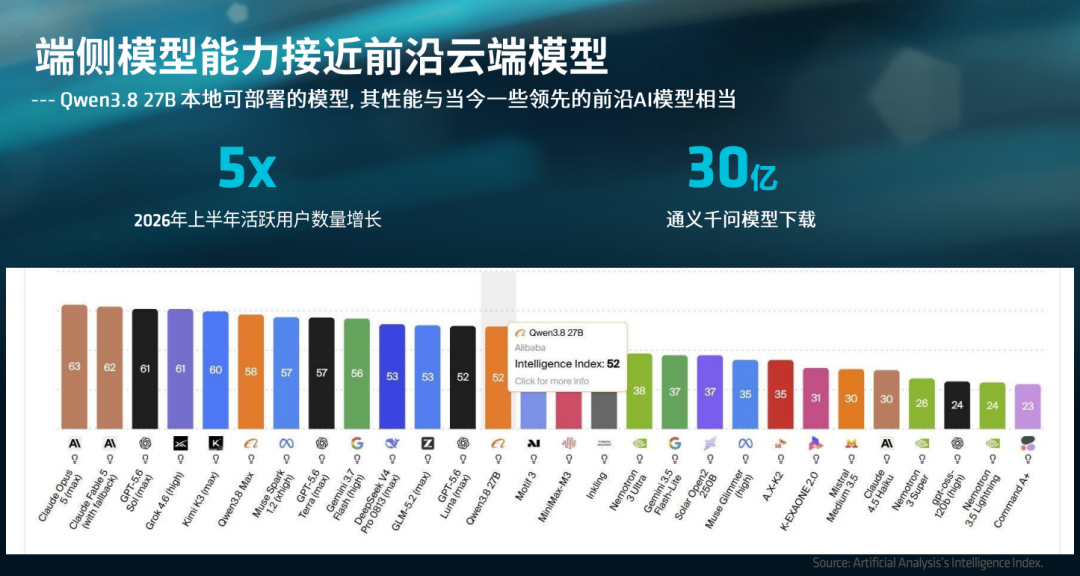
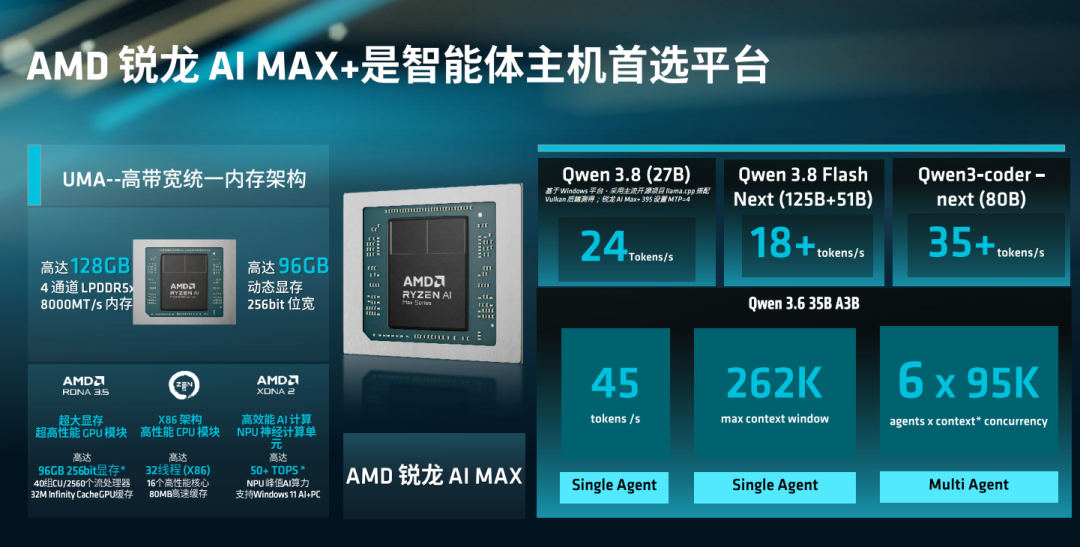
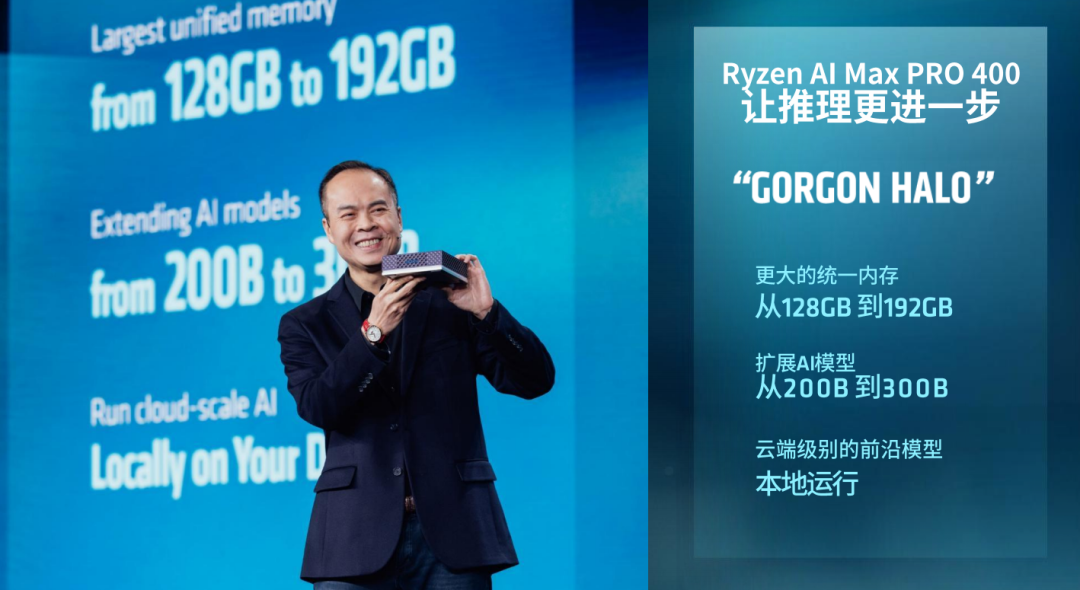
其次,AMD的前代平台已用实测验证了这条路线的优越性。例如锐龙AI Max+ 395,搭载了128GB统一内存,支持最高分配96GB显存,可稳定运行27B参数的千问3.8模型,速度达到24 tokens/s,运行千问3.8 Flashnext 125B可达到18 tokens/s,同时运行6个智能体仍可达45 tokens/s。正是由于这代平台在实战中的扎实表现,才让AMD敢于在锐龙AI Max PRO 400系列上把统一内存最高推至192GB、带宽拉高到约273GB/s,支持最高设置160GB显存,让4-bit量化跑300B参数模型绰绰有余,多智能体并发、长上下文RAG、多模态生成这些“内存墙”重灾区,都有了从容的本地资源池。
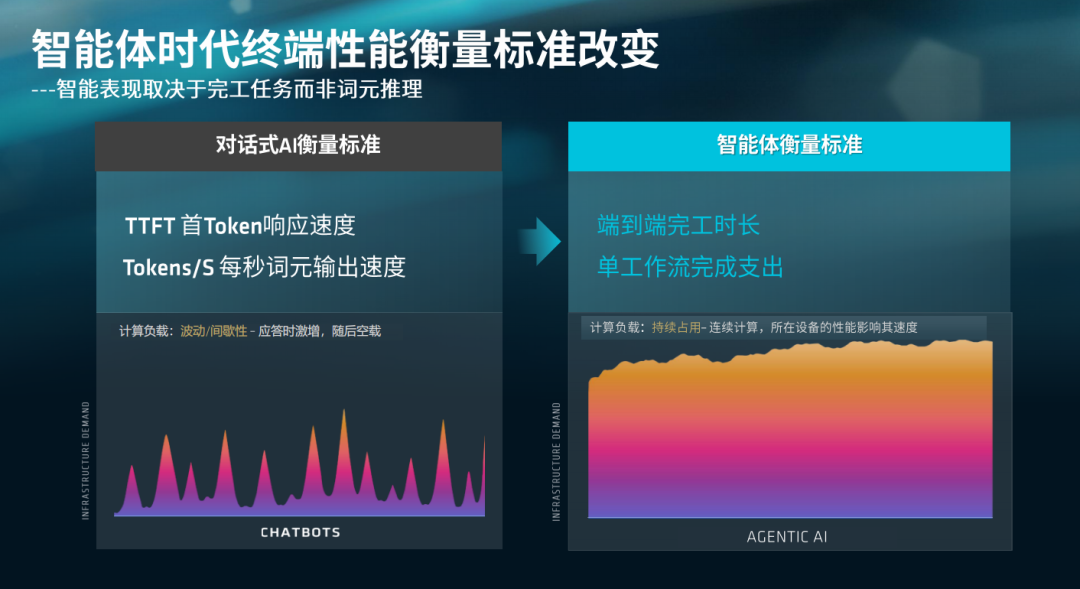
此外,评测标准正在被智能体改写。传统“首Token响应时间、每秒Token输出量”的指标,已不再适配以端到端任务执行为核心的智能体场景。AMD已通过官方博客发布以端到端任务完成时长为核心的基准测试框架,为行业提供智能体主机性能评估的参考方向,这也意味着锐龙AI Max PRO 400系列的性能优势不再只是“跑分”,而是“干活”更快。
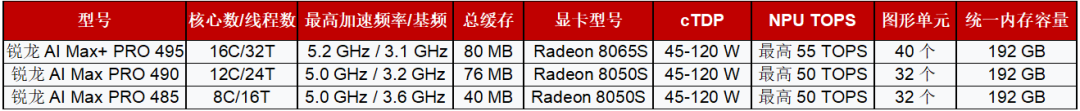
最后,产品线三档齐发,生命周期更有底气。首发登场的锐龙AI Max+ PRO 495/490/485全部支持192GB统一内存,可配置功耗范围(cTDP)为45~120W,从紧凑型桌面到移动桌面工作站皆可适配;AMD PRO技术更是提供了企业级的安全与管理能力;通用x86架构兼容性强,叠加模型轻量化与统一内存架构及AMD VGM可变显存技术,可支撑长期的模型迭代需求。因此,锐龙AI Max PRO 400系列不是简单的参数堆叠,而是把“本地算力+统一内存+开放软件栈”打包成了一套面向AI智能体时代的计算范式和版本答案。
九款新品齐亮相:锐龙AI Max+ PRO 495成为AI智能体主机领跑者
这次AMD Gorgon Halo产品首秀即登场九款,全部围绕锐龙AI Max+ PRO 495展开,很显然它已经是AI智能体主机的领跑者。
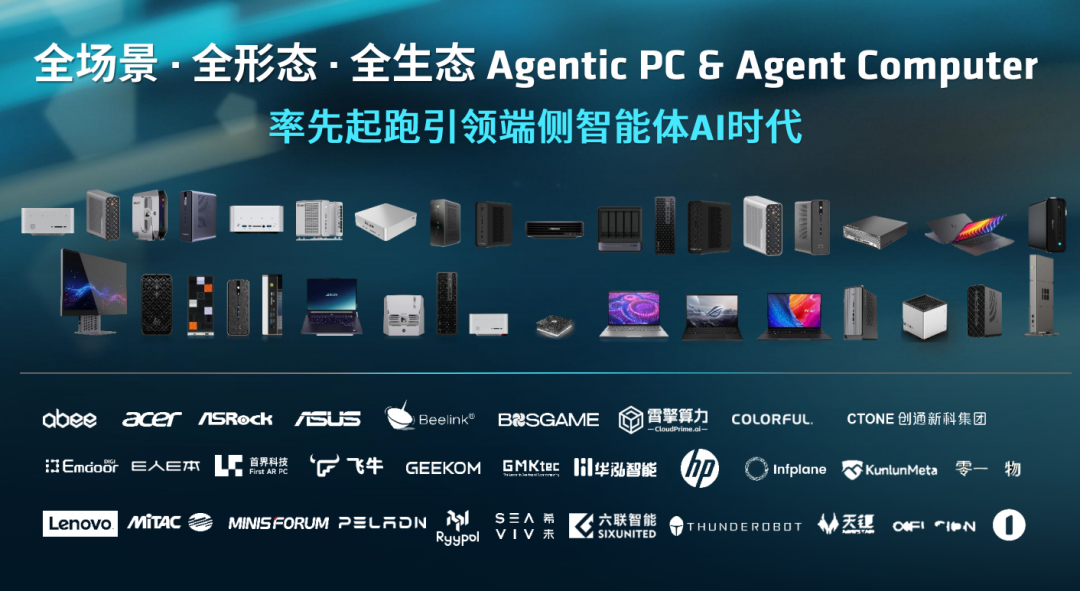
联想ThinkCentre X Ultra以1.6L机身打造桌面AI集群;超聚变FusionXpark M系列桌面AI超算将于9月21日在郑州国际探索者大会上全球发布;铭凡MS-S1 MAX-P495主攻边缘AI;极摩客EVO X5 Pro、亿道AS113-SM-ACH27、七彩虹灵创Mini Pro、阿迈奇F9A各展所长;六联智能则带来1升AI工作站AXB88P-02与2L迷你AI主机AXB35-03。此外,联想、惠普、宏碁等伙伴也已陆续发布对应机型,全系列产品将于9月底10月初面向消费与行业市场集中上市。
硬件伙伴中,六联智能的落子格外抢眼。作为核心ODM/OEM伙伴,AMD相关产品出货量已占其总出货量70%以上,实现Halo全系列产品的全球首发与量产;此次推出的两款基于锐龙AI Max+ PRO 495的小型化工作站,体积甚至小于常规书籍,支持多机串联与定制化开发。加上IFA上亮相的宏碁Aspire G系列,锐龙AI Max+ PRO 495已全面搭建了迷你主机、1L/2L工作站、笔记本、平板、一体机、AI NAS的全形态矩阵。
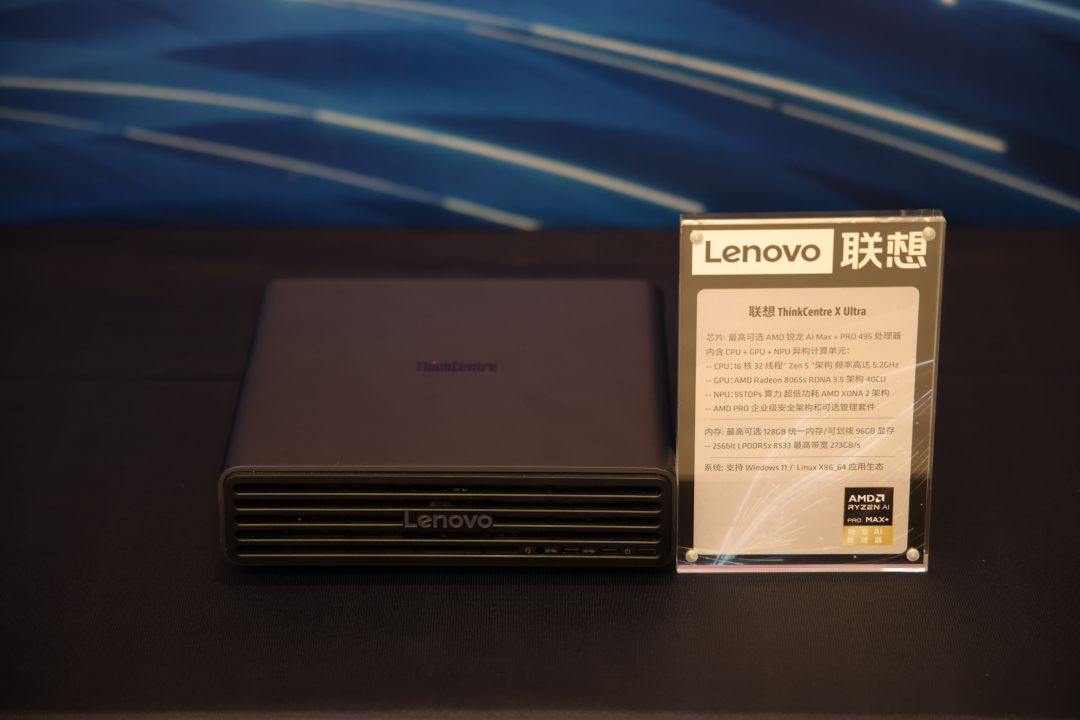
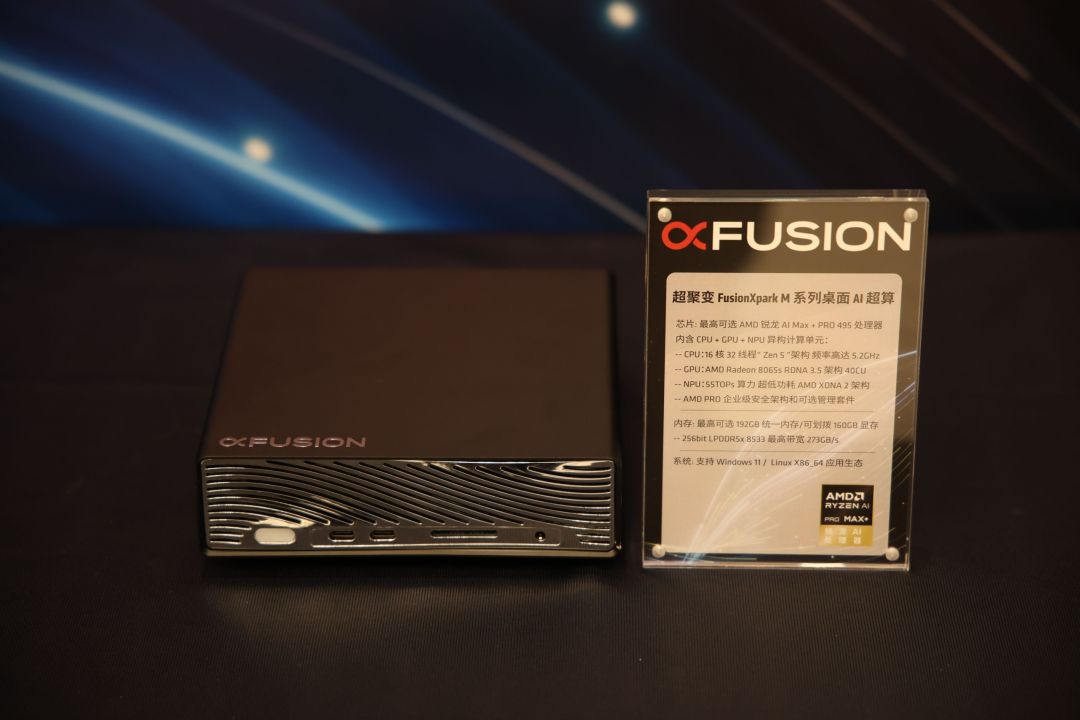
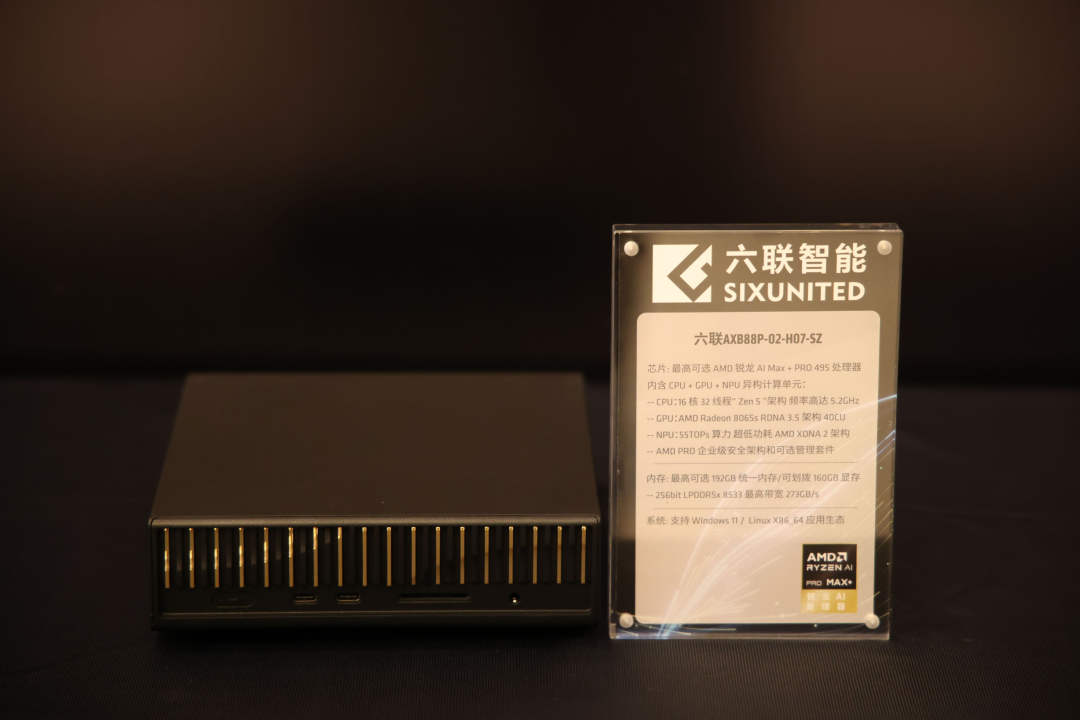
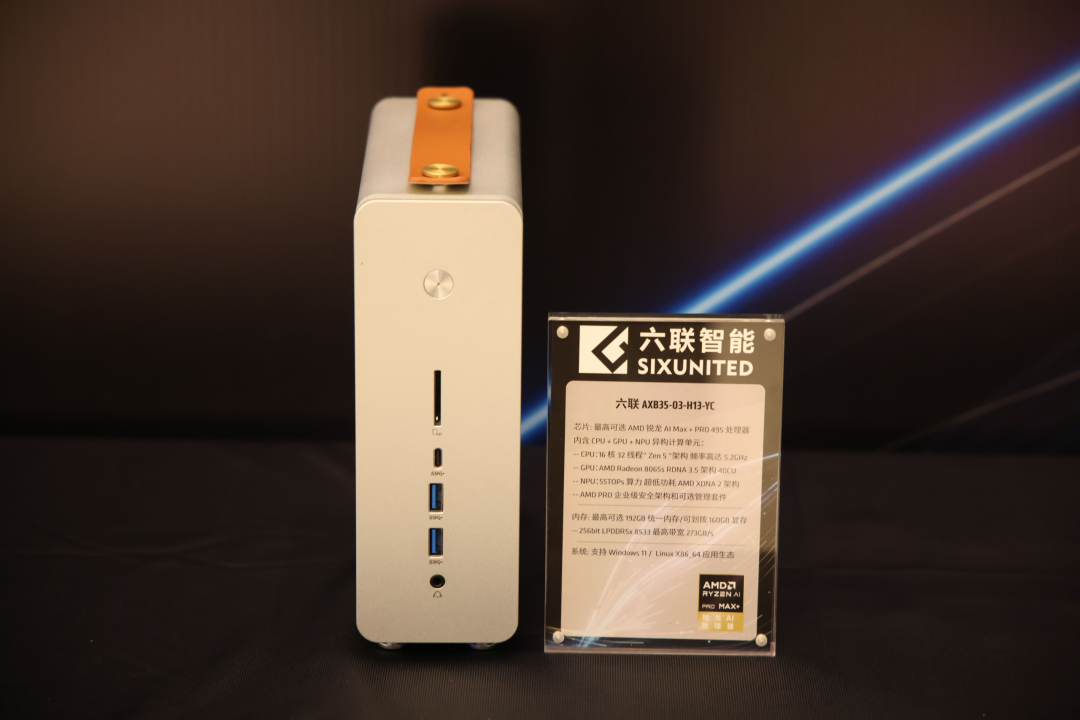
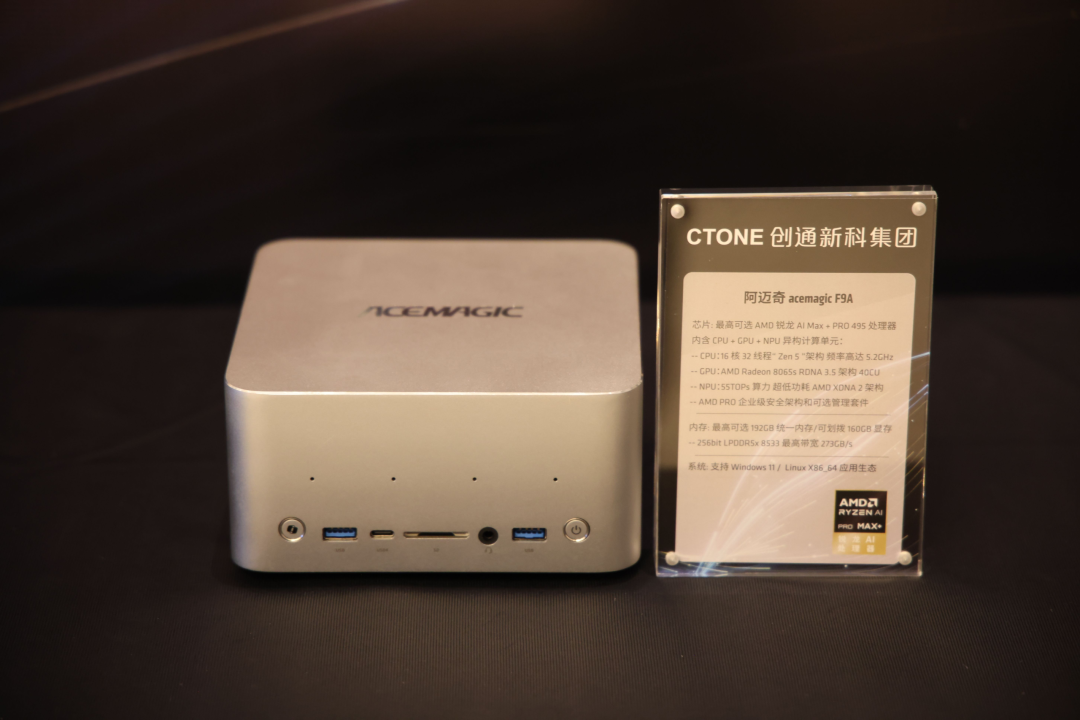
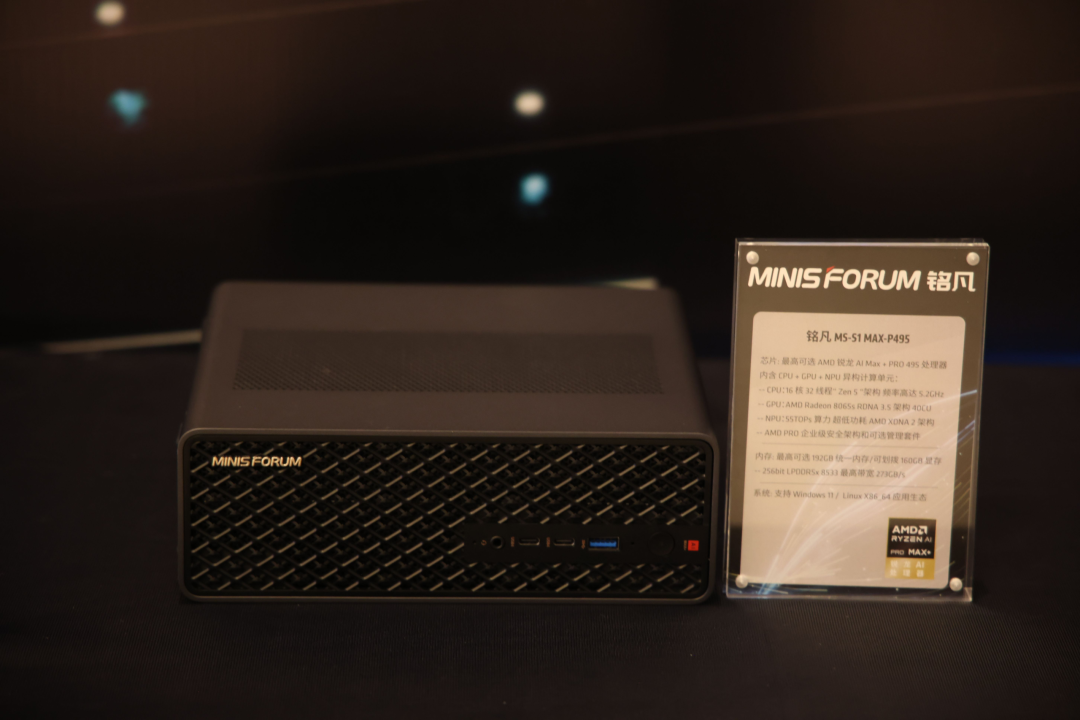
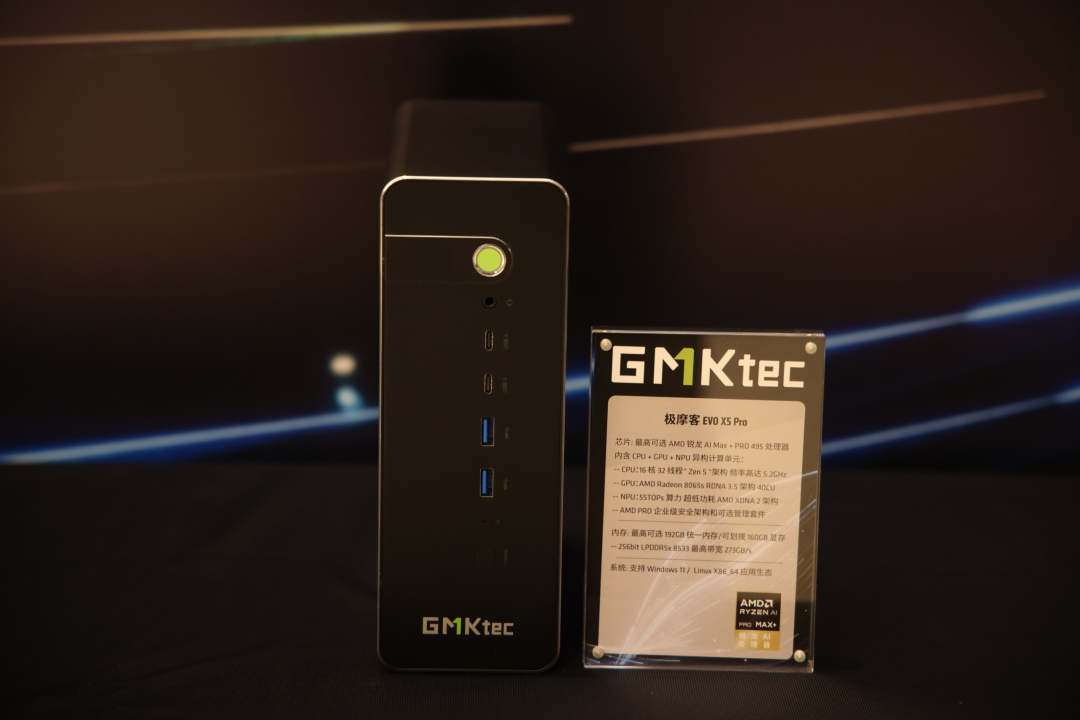
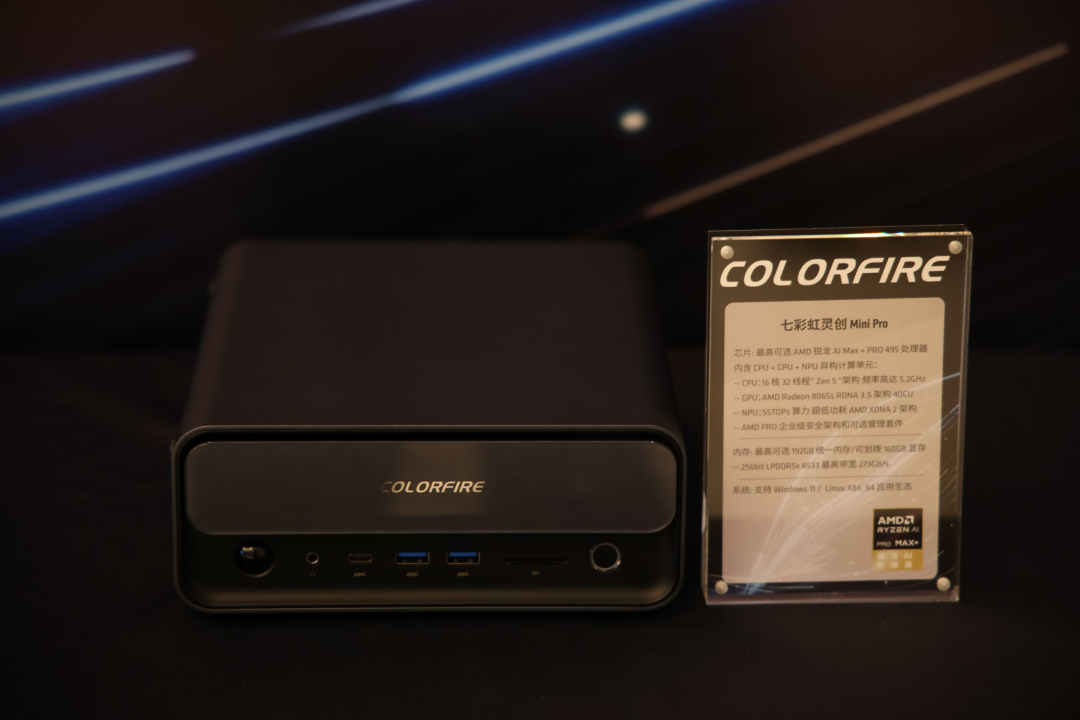
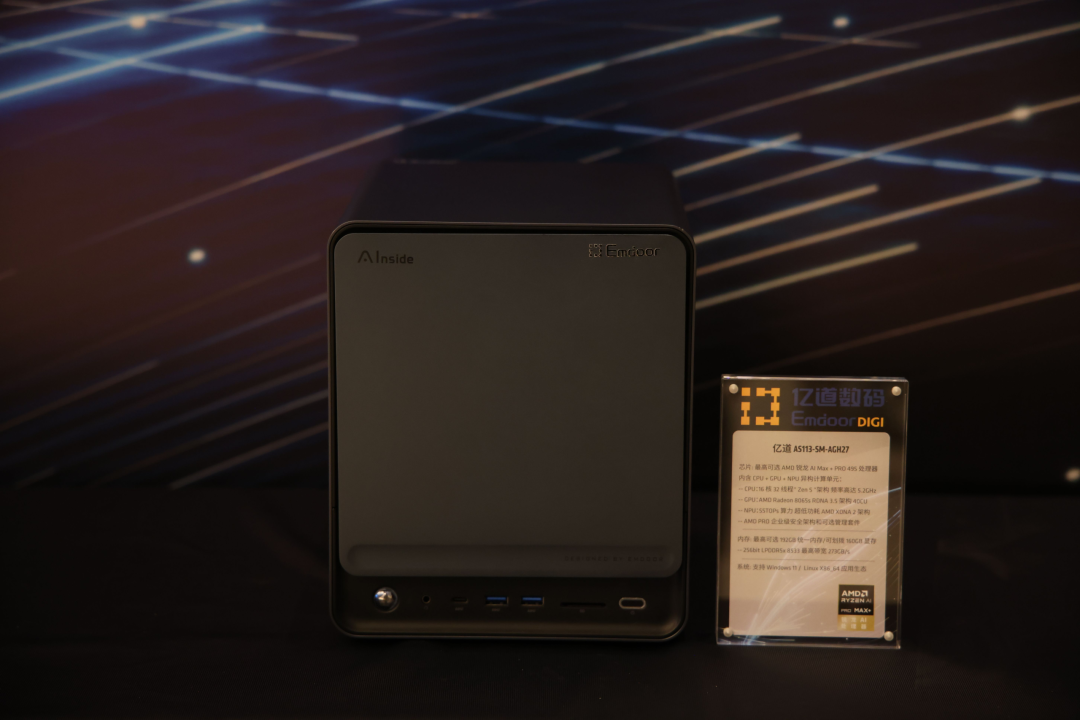
其实我们不难发现两个信号:其一,OEM厂商对锐龙AI Max+ PRO 495的开发周期短、认可度高,它已在事实上成为新一代AI智能体主机的标准底座;其二,AMD透露近期共有超过20款锐龙AI Max+ PRO 495新品上市,很明显其供给端爆发节奏明显快于同类竞品。由此可见,工作站级AI正在以更低的门槛走向桌面,这对开发者与企业用户都是实打实的利好。
从开发到方案:全链条生态按下落地加速键
芯片只是入场券,生态才是胜负手。AMD的“春雷”“春雨”“春笋”三大AI创始项目与锐龙AI智能体创新应用大赛,分别聚焦行业方案、高校科研、开发者社区三条线。春雷计划已联合伙伴编制20余个垂直行业解决方案白皮书,推动AI从“赋能千行百业”走向“一行一业”的深度落地;春雨计划推进AI新型人才培养,落地高校AI课程与实训教室;春笋计划重点建设ROCm开源生态的中国开发者社区;而创新应用大赛则挖掘优秀落地案例与AI赋能的超级个体。
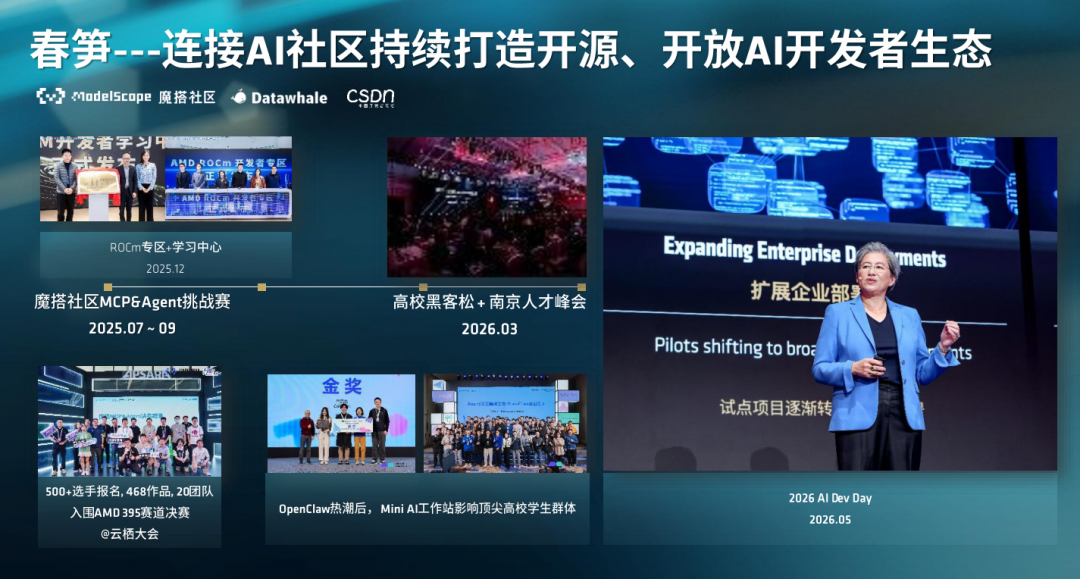
在开发者端,多方正在共同降低门槛。CSDN创始人蒋涛提出,本地算力普及是AI应用爆发的核心前提,当前端侧模型能力已追平去年云端头部模型,CSDN将推出AMD适配的开发者AI工具集;首界科技推出NovaStudio平台,预置适配锐龙AI Max+ 395的ROCm环境与模型量化版本、硬件优先供给开发者,并首期投入1.5亿元自建算力中心,为开发者提供最低至官方1/32价格的Token服务;星漪科技以AISSD显存卸载技术,在锐龙AI Max+ 395硬件上稳定运行千问3.8 Flashnext 176B模型,端到端推理速度达24token/s,其产品Flowy AI PC则以Agentic PC架构统一大模型调度与工具调用。软件侧,ROCm虽起步晚于同类闭源框架,但适配效率已大幅提升,Anthropic相关基础适配仅用3个工作日完成,叠加锐龙AI Halo开发者平台开箱即用的Playbook(由5套扩充至15套),开发者的环境配置成本被显著压低。
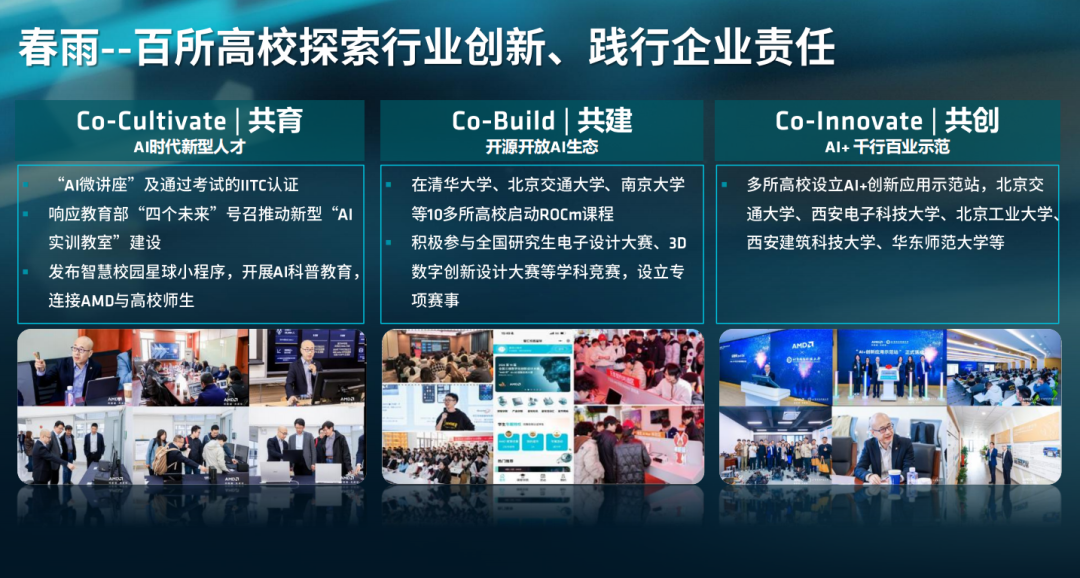
科研与教育端的落地同样扎实。生寰未来基于锐龙AI Max+ 395搭建的蛋白质设计智能体平台,实现从需求理解到序列输出的全流程自动化,已落地华东师范大学AI for Science教学场景,9月19日将举行联合揭牌仪式,后续覆盖上海多所985高校生科院;昆仑元联合上海财经大学打造金融智能体体系,通过自研推理引擎优化,可在锐龙AI Max+ 395上运行300B以上模型,首字响应延迟最高降低93%。据测算,单台锐龙AI Max+ 395主机每年可为金融科研小组节省约50万元算力成本,相关方案将复制至全国49所财经类高校联盟。
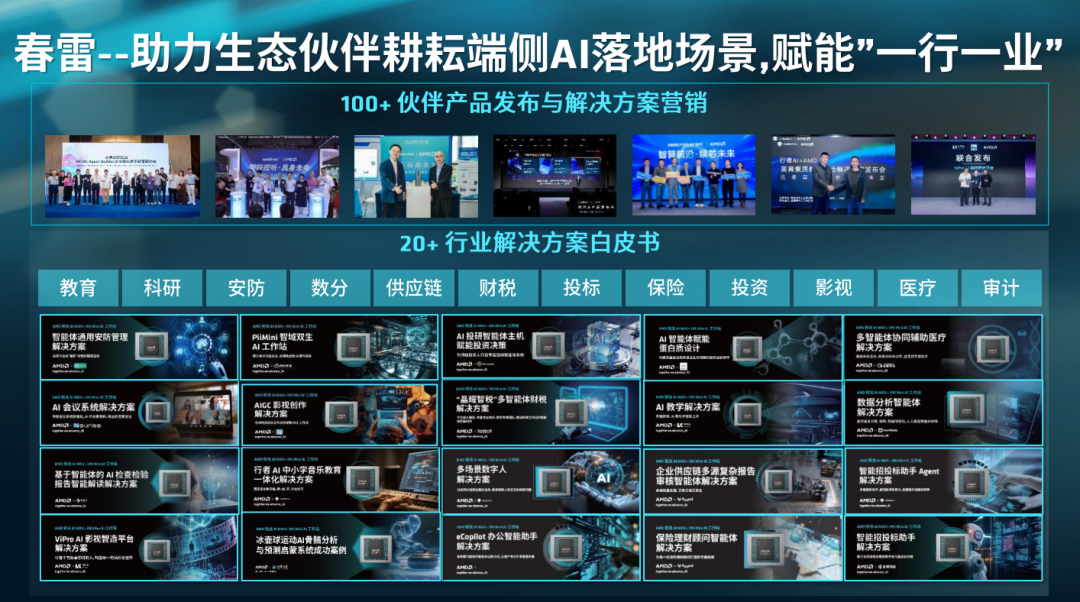
行业端,AI智能体已开始在一线场景创造真金白银的收益:基于锐龙AI Max+ 395的影视全流程智能体,实现剧本创作、资产生成、分镜制作全流程本地化,已支撑多部合计播放超20亿的短剧制作;车管所业务审核方案落地后,单任务处理时长从15分钟缩短至3~5分钟,整体审核效率提升40%,数据全程本地存储;法律AI工具集覆盖本地知识库、文书起草、会议纪要等高频需求,适配中小律师团队的低成本算力诉求;赛博物联的智能投标助手嵌入招投标全流程,支持离线运行;创造进化的智能VC工作站可实现5分钟项目初筛、半小时生成90页深度研报,已服务十余家头部投资机构。
从开发、工具到解决方案,AMD的全链条布局正在回答一个关键问题:应用大爆发不发生在模型最强的时候,而是发生在“能力过可用线+成本掉一个量级+分发就位”之后。当前AI智能体落地渗透率尚不足10%,而AMD联合全生态伙伴共同做大端侧AI市场,正是要把这条曲线加速拉满,接下来全面升级的锐龙AI Max PRO 400系列则将对这个过程进一步提速。
市场风口已至:端侧智能体主机进入放量前夜
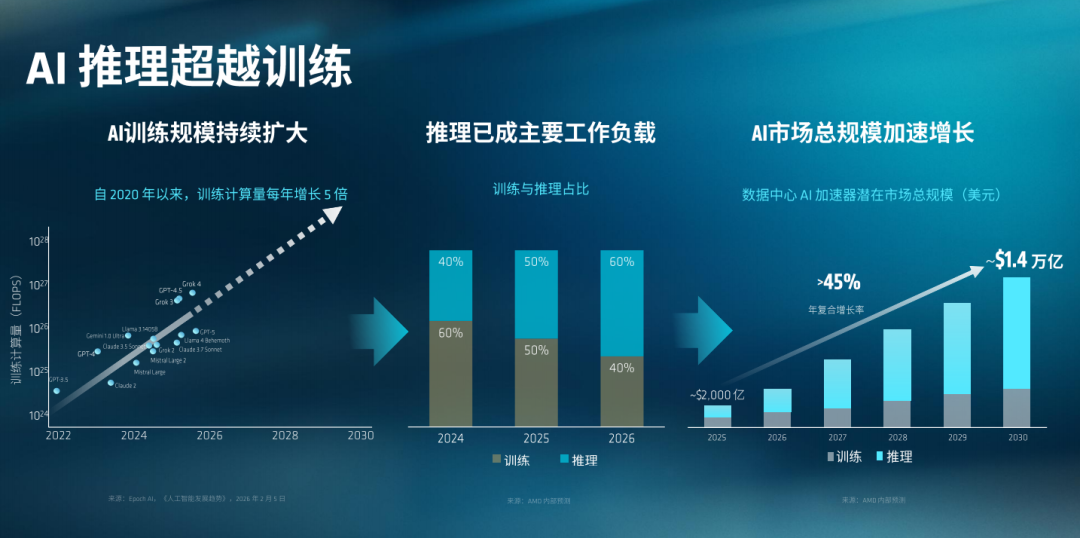
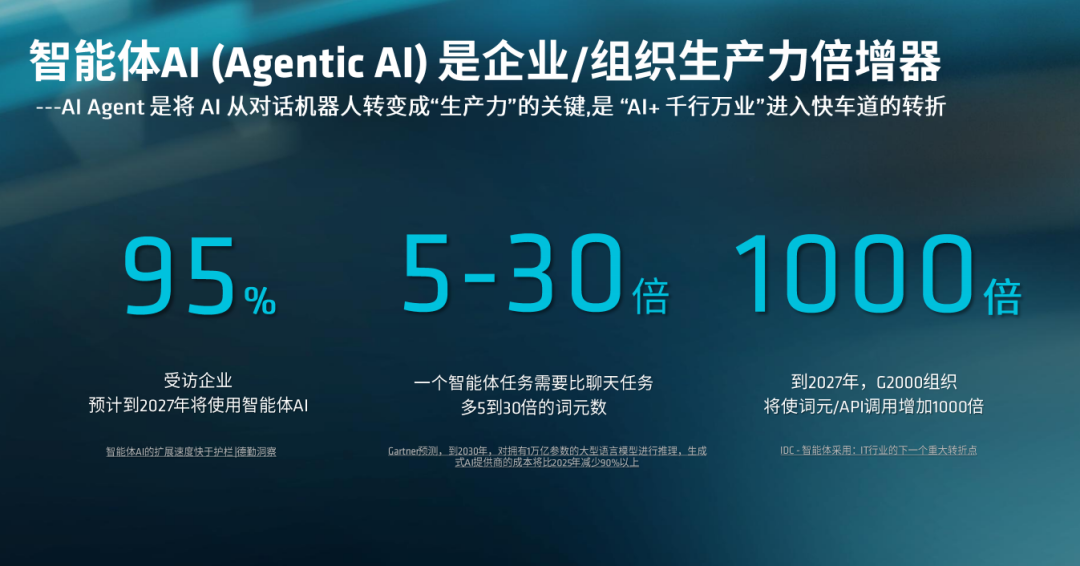
我们可以看到,当前AI智能体正在改写算力的流向。根据相关数据,当前约80%的Token消耗来自AI智能体;至2030年全球月度Token产出将达到10²⁸级别,企业规模化部署云端智能体的成本动辄每月数千万美元。叠加AI推理市场占比已超训练达60%、智能体Token需求为传统对话机器人5至30倍的大背景,在“Token成本暴涨+数据安全诉求”双重挤压下,本地算力成了刚需。
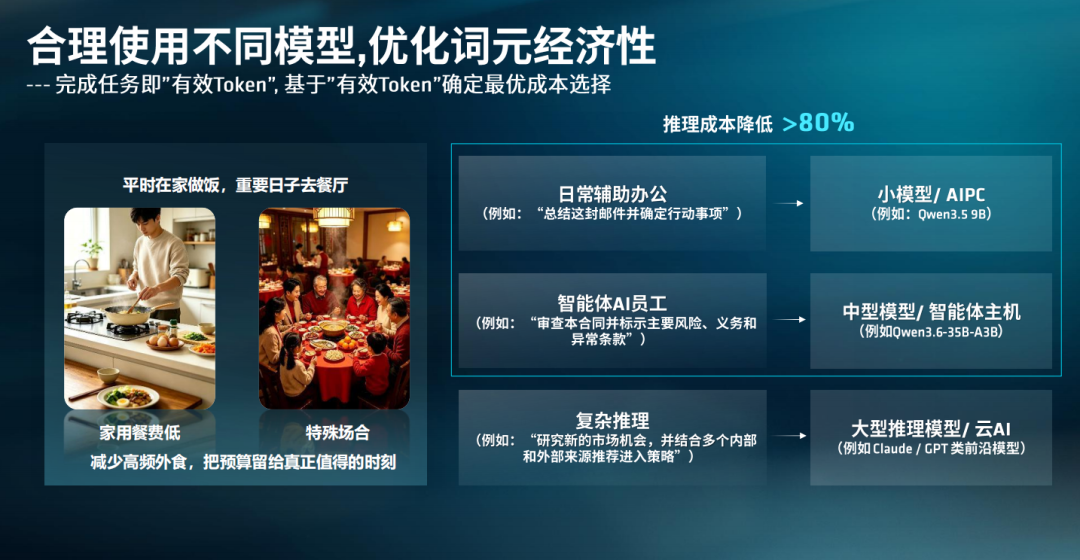
大盘数据同样乐观:高盛预计2026年全球AI PC出货量将达1.5亿台、同比增长39%,占全部PC的59%;Canalys预计到2027年AI PC出货量超1.75亿台、渗透率超过60%。IDC与联想联合发布的AI主机白皮书:2026年为品类导入元年,出货量约40万台、对应约50亿元市场规模;2029—2030年进入加速爬坡期,出货量从约350万台跃升至约700万台,市场规模从约460亿元增至约770亿元。TCO测算显示,月消耗6亿Token的场景约10个月回本,五年总拥有成本最高可降低67%。
更值得关注的是需求端的真实反馈:当前锐龙AI Max+ 395的产品市场需求旺盛,二手价格甚至都较首发价大幅上涨,叠加云端Token成本节省,具备较强的长期使用价值;AMD品牌价值也随端侧AI叙事水涨船高,位列Kantar BrandZ全球品牌榜第28位,较去年的47位大幅跃升。对于新登场的锐龙AI Max+ PRO 495而言,窗口期红利清晰:作为当前唯一能在本地运行300B模型的x86平台,它在“AI原生计算架构、常驻智能体闭环、端边云调度、物理级安全、自进化”五大AI主机特性上均有强大的硬件兜底,且先发一年多、产品供给充足。可以判断,端侧智能体主机将从2026年的品类导入期进入快速放量期,而锐龙AI Max+ PRO 495正卡在供给端的最佳身位,可谓天时地利人和优势全部占齐,迎来销量爆发是必然的事。
与RTX Spark同台:x86全兼容与生态先发优势凸显
竞品方面,10月即将上市的NVIDIA RTX Spark,是锐龙AI Max+ PRO 495绕不开的对手。RTX Spark以1 Petaflop(FP4精度)AI算力、Blackwell RTX GPU(6144个CUDA核心)与20核Grace CPU的异构融合、128GB统一内存入局,并借CUDA、Adobe合作与DLSS生态在创作与游戏领域拥有独特号召力,确实是一位值得尊重的强大对手。
但把两款旗舰放到同一把尺子上,锐龙AI Max+ PRO 495的综合优势更为突出(见表1)。
算力上限更高。锐龙AI Max+ PRO 495支持192GB统一内存、最高可分配160GB显存,本地可运行300B参数模型;RTX Spark最高搭载128GB统一内存,本地模型的上限约为120B参数。
异构更完整。锐龙AI Max+ PRO 495拥有最高55 TOPS的NPU,实现CPU+GPU+NPU三引擎协同;RTX Spark未搭载独立NPU。
兼容性更省心。锐龙AI Max+ PRO 495基于x86架构,原生支持Windows 11与Linux x86_64,存量软件零成本迁移;RTX Spark采用Arm架构,需依赖Windows on Arm及转译层,部分工业软件与外设驱动仍存在兼容风险。
落地更早支持更广。AMD自2025年CES率先布局,一年多来已联合OEM落地超过35款终端产品;锐龙AI Max+ PRO 495中国首秀即登场9款、有20余款在途,9月底10月初全面上市。RTX Spark首批产品10月才上市,端侧生态仍在从零搭建。
实测性能占优。在120B GPT OSS、122B Qwen3.5、35B Qwen3.6、30B GLM4.7 Flash等主流开源模型上,锐龙AI Max平台(基于395)的推理速度较DGX Spark分别领先7%、12%、4%、14%。
评测体系更贴合智能体场景。AMD已推出以端到端任务完成时长为核心的基准框架,与“能力过可用线、成本可负担”的智能体落地逻辑同频;RTX Spark仍以传统单点算力指标为主战场。
产品矩阵更完整。AMD以同一x86平台覆盖从锐龙AI 200到400系列的全价位段,配合“瀑布式下沉”战略,可同时吃下消费级与工作站市场;RTX Spark则聚焦高端创作者与开发者。
当然,竞争的另一面是共赢。AMD和NVIDIA两大巨头同台,既验证了端侧AI赛道的真实价值,也让开发者获得更多选择:x86与Arm、ROCm与CUDA、统一内存与异构融合,不同技术路线正在共同推动应用端与开发端的繁荣。良性竞争带来的多样性与进步,正是AI智能体时代最好的礼物。
表1 锐龙AI Max+ PRO 495与NVIDIA RTX Spark核心对比
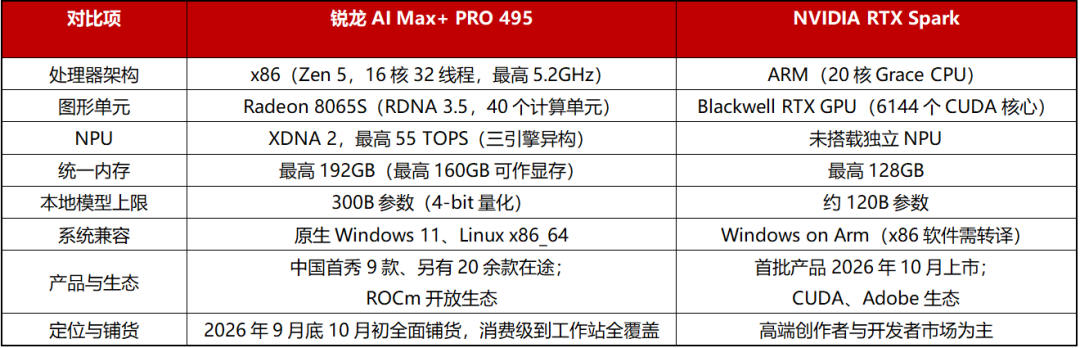
注:AI算力口径两者不同(异构混合算力 vs FP4精度GPU算力),仅列示厂商宣传口径。数据来源:AMD、NVIDIA官方资料、AMD端侧AI生态伙伴成果分享会及公开报道整理,2026年9月。
总结:先发、全栈与生态,锐龙AI Max PRO 400 系列再次领军端侧 AI 市场
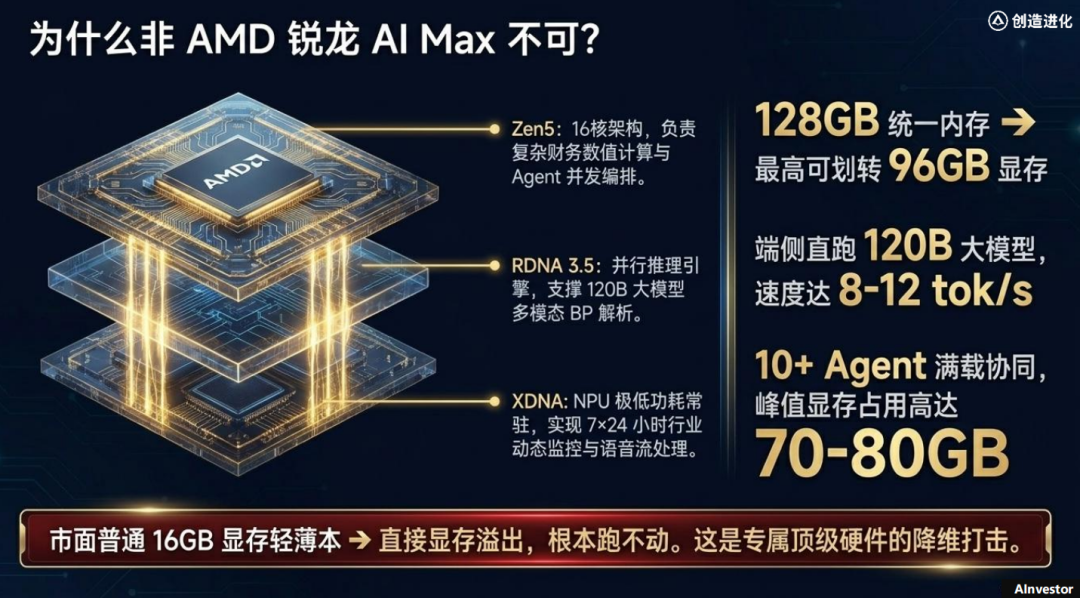
最后简单总结一下。锐龙AI Max+ PRO 495 的意义,不止于一颗更强的芯片,而是为端侧智能体时代重新划定了三条起跑线。它用 192GB 统一内存与 300B 本地模型能力,把“个人算力” 的边界推到了云端门口。作为全球首款能在本地运行 3000 亿参数模型的 x86 客户端处理器,锐龙 AI Max+ PRO 495搭配约 273GB/s 的统一内存带宽,让“内存墙” 不再卡住智能体的脖子:多智能体并发、长上下文 RAG、多模态内容生成这些最耗资源的场景,从此有了随取随用的本地资源池,也顺势解决了企业最头疼的 Token 成本与数据出域两大难题。
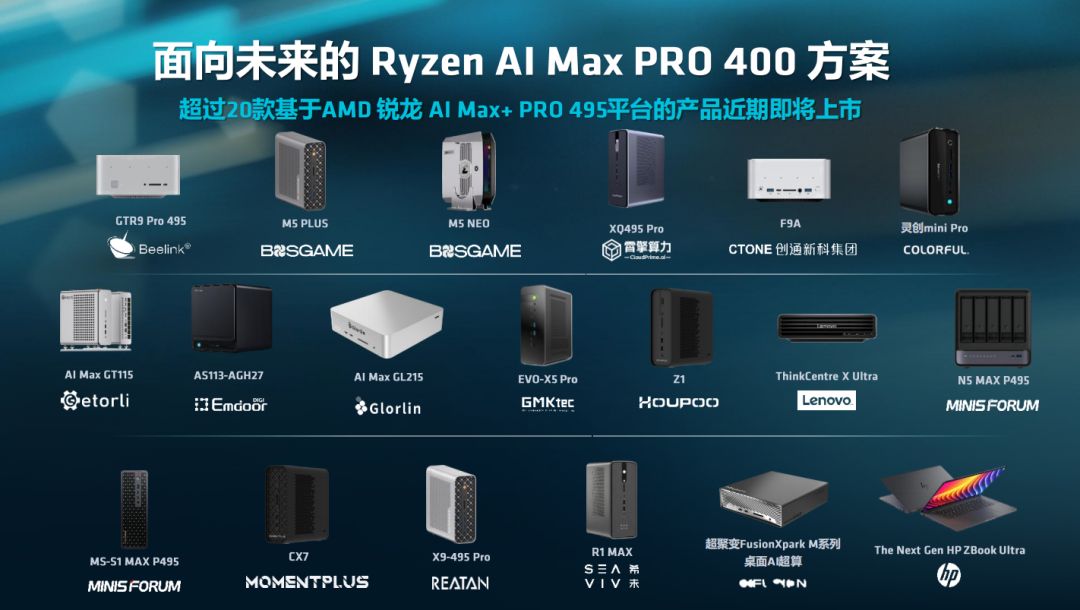
它用9 款首秀新品与 20 余款在途产品、9 月底 10 月初的全面上市节奏,宣告端侧智能体主机正式进入供给爆发期。从联想 1.6 升桌面 AI 集群到六联智能体积小于常规书籍的小型化工作站,从迷你主机到笔记本、平板、一体机与 AI NAS,锐龙 AI Max+ PRO 495几乎同步铺满了消费与行业市场的每一个形态;联想、惠普、宏碁等伙伴的快速跟进,更印证了 OEM 对这条技术路线的高度认可。
它用从“赋能千行百业” 到“一行一业”的全链条生态,回答了“算力本地化”如何从理念走向落地。开发者侧,首界科技1.5亿元算力中心把 Token 成本压到官方价的 1/32,星漪科技以显存卸载技术让 176B 模型在 锐龙 AI Max+ 395上跑出 24token/s,ROCm 对 Anthropic 的基础适配仅用 3 个工作日;行业侧,蛋白质设计、金融投研、影视短剧、政务审核、法律与招投标,一个个真实场景已经跑通并产生真金白银的收益。芯片、工具、方案三级接力,可以预见锐龙 AI Max+ PRO 495 不是卖完即止的硬件,而是可以持续创造价值的平台。
目前AI智能体规模化落地渗透率尚不足 10%,意味着这一赛道的增长才刚刚开始。AI 智能体的下半场,比拼的不再只是模型参数,而是平台、工具、数据与业务流程的系统级协同。在这一进程中,以锐龙 AI Max+ PRO 495 为代表的 AMD 锐龙 AI Max 400 系列已占据先发、全栈与生态的领军地位:先发,是自 2025 年 CES 率先落子、一年多时间沉淀出的产品与案例积累;全栈,是 CPU、GPU、NPU 三引擎协同与端到端评测标准的定义权;生态,是“春雷”“ 春雨”“春笋”与创新大赛织就的开发者与行业伙伴网络。而它与 RTX Spark 的良性竞逐,正在让 x86 与 Arm、ROCm 与 CUDA 各展所长,共同把端侧 AI 智能体时代推向更广阔的天地——对开发者来说是更多选择,对企业意味着更低门槛,对每一个普通用户,则是 AI 真正“存在于本地设备里”的开始。
JOTO 企业落地观察
- 企业部署端侧AI主机时,需重新评估“统一内存容量”与“NPU常驻能力”的权重:当多智能体并发与RAG长上下文成为标配,192GB统一内存不再是冗余配置,而是保障推理稳定性与任务隔离性的基础设施底线。
- AI智能体工程中,“端到端任务完成时长”正取代传统token吞吐指标,成为衡量系统交付质量的核心KPI;企业选型时应要求供应商提供真实业务场景下的端到端基准测试报告,而非仅展示单点算力峰值。
- RAG知识工程的本地化落地,高度依赖内存带宽与显存弹性分配能力;锐龙AI Max PRO 400系列支持160GB显存动态划分,使企业可在同一台主机上并行运行多个知识库检索+多模态生成任务,无需拆分部署或引入额外GPU服务器。
- AI安全治理视角下,x86全栈兼容性降低了企业旧有IT资产淘汰率;Windows/Linux原生支持意味着现有身份认证、加密策略与审计日志体系可无缝复用,避免因Arm架构转译层引入新的攻击面或合规盲区。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们