DGX Spark实测:本地AI硬刚云端AI,四大模型搭建Minecraft Server大对决
本文实测英伟达DGX Spark本地AI设备性能,对比Qwen 3.8 Next、Fable 5.1、Grok 4.6与GPT Codex Astra四大模型在20分钟内从零搭建《我的世界》服务器的表现。重点揭示本地AI在隐私安全、无配额限制、长期成本优势上的不可替代性,以及云端AI在速度与创意上的领先但受限于算力配额与使用成本。
本地AI崛起:隐私、自由与长期成本的三重刚需
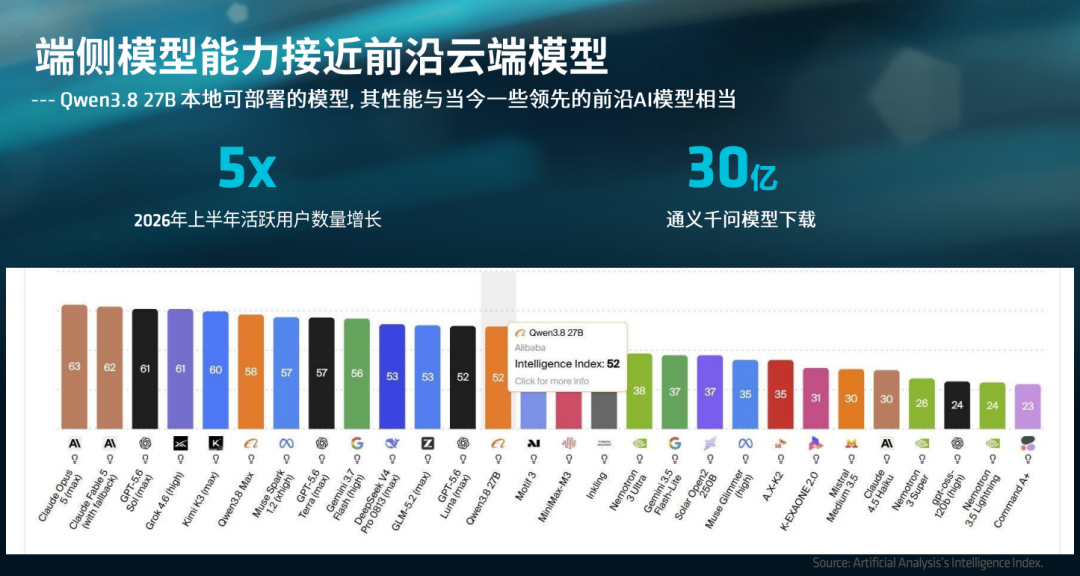
如今的AI圈,简直卷得比春运抢票还要疯狂。短短几周时间,AI模型迭代如同坐火箭一般,Anthropic的Fable 5.1、SpaceX的Grok 4.6、OpenAI的GPT Astra轮番登场,刷屏整个科技圈。不止云端大厂发力,开源本地模型也迎来爆发期,Qwen系列3.8、Qwen 3.8 Next、GLM 5.3等模型强势出圈,各项跑分数据亮眼,直接让普通玩家也能解锁昔日只有云端顶级AI才有的强悍能力。
在这场轰轰烈烈的AI内卷浪潮中,越来越多人开始偏爱本地AI部署。日常使用云端AI固然方便,搭建网页应用、快速生成内容都不在话下,但隐私是个问题。不少人每周会收到大量账单、私密文件等邮件素材,这些私人数据一旦上传云端,难免存在泄露风险。而本地AI完美解决了这个痛点,所有数据、文件都在本地设备处理,存储在私人NAS中,既能自动整理归类私密资料,又能守住隐私底线。如今本地大模型社区空前活跃,各类可微调、可适配不同设备内存的模型层出不穷,玩法自由度直接吊打固定规格的云端AI。
DGX Spark:为高强度本地AI运算而生的硬件方案
为了玩转极致流畅、隐私无忧的本地AI,一位科技爱好者LinuxBTW直接硬核升级装备,入手了两台英伟达DGX Sparks设备。
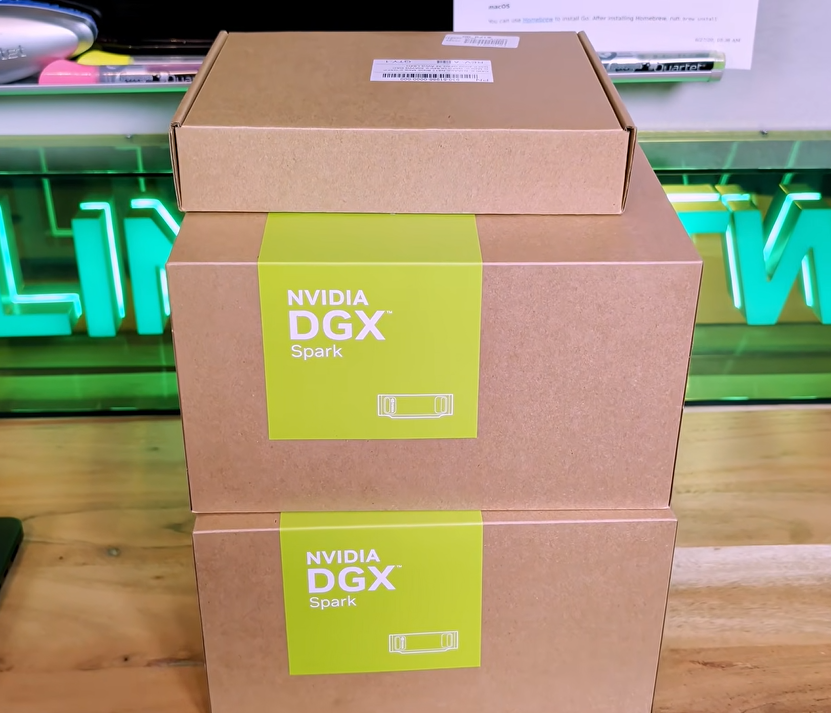
很多人疑惑,新款苹果M5 Ultra系列内存拉满、带宽出众,为何偏偏舍弃热门苹果设备,重金选择英伟达?看看这位博主是怎么认为的。
他此前使用的M4 Max 128G版本,体验堪称“槽点满满”。长时间运行大模型时,机身发热严重、风扇疯狂轰鸣,不仅设备寿命堪忧,更致命的是预填充速度拉胯。对于经常用AI写代码、读取海量文件、加载大模型的用户来说,预填充速度远比单纯的token生成速度重要。
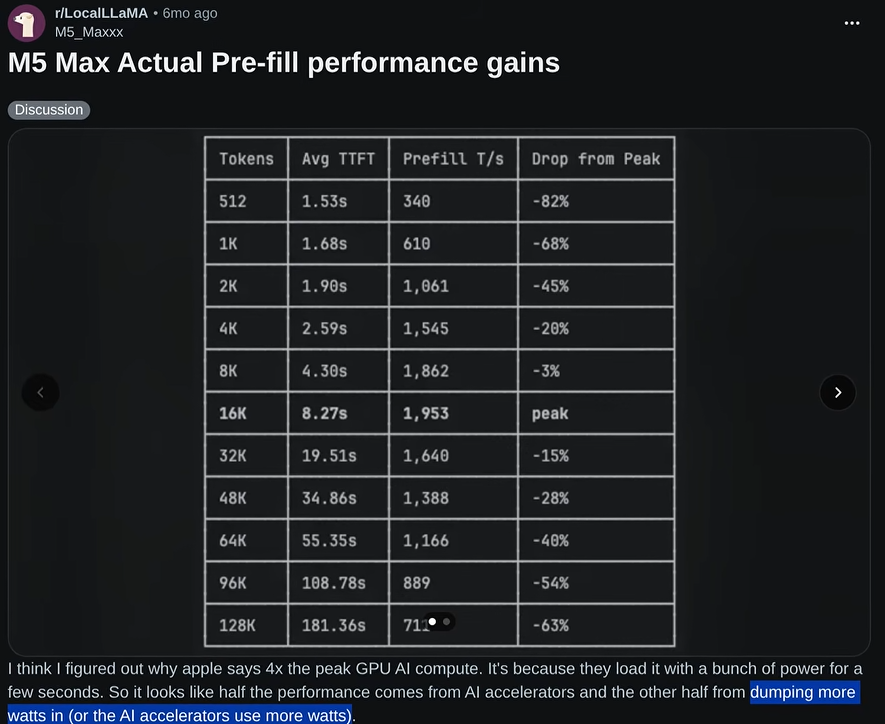
网上很多跑分数据看似亮眼,动辄每秒生成500token,但大多是简单短句生成的虚假数据。真正的硬核场景,需要AI读取、梳理海量信息后再输出内容,苹果设备的短板瞬间暴露,而英伟达DGX Sparks的核心优势就是全域拉满的预填充速度,完美适配高强度本地AI运算。
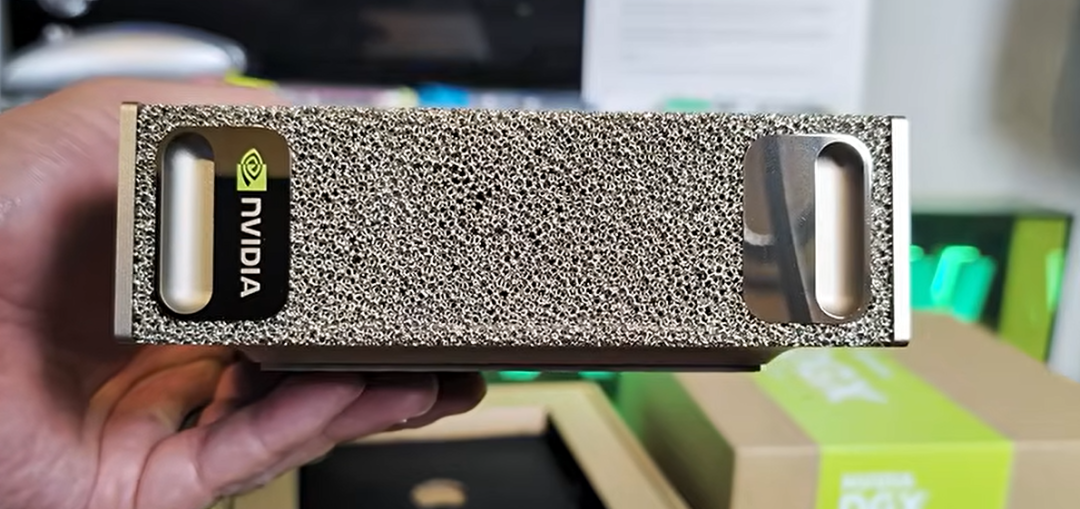
这款英伟达专属AI设备堪称“私人AI超级终端”,搭载基于BlackWell 架构的GB10超算芯片,专属NVFP4动态优化技术,告别死板的固定精度,性能与内存适配做到极致。标配128G统一连贯内存,可流畅运行最高2000亿参数的超大模型,搭配4TB高速硬盘,能批量存储各类专用本地模型。最硬核的是,两台设备可通过专属高速线缆连接,实现200GB超高速互联,内存直接翻倍,可撬动4000亿参数模型的算力,两台设备协同发力,算力、内存无缝联动,大型模型运行丝滑不卡顿。
成本与可持续性:一次性投入 vs 持续订阅
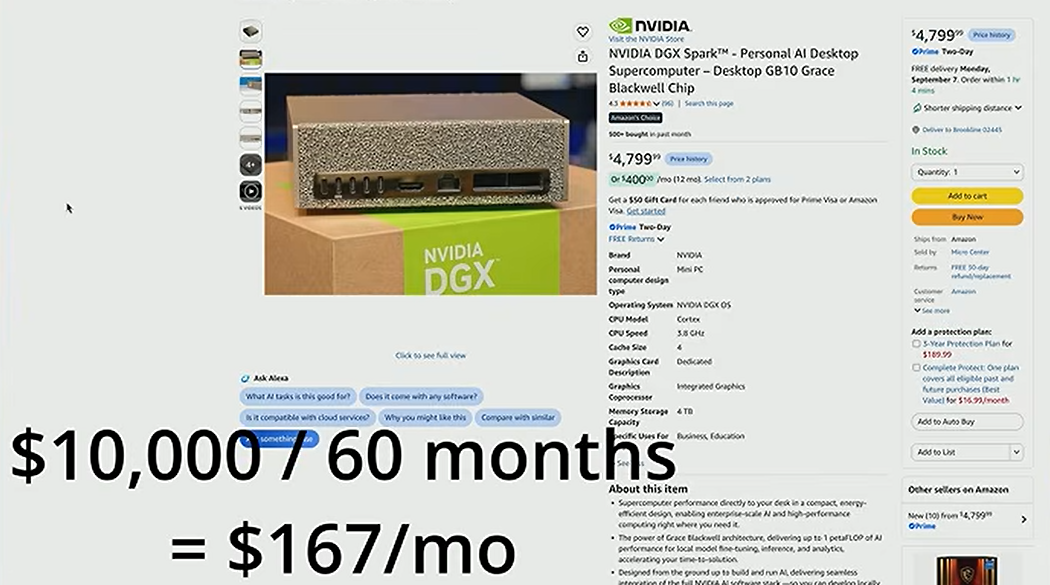
很多人觉得单台4500至4700美元的定价偏高,两套设备总价近万美元,性价比堪忧。但细细算账就会发现真香!常年使用多款云端AI订阅服务,Claude、Codeex、Cursor、Grok等会员年费累加下来,开销十分惊人。而DGX Sparks属于一次性投入,分摊到五年使用周期中,成本远低于持续充值云端会员。更关键的是,本地部署无调用次数、无token配额限制,不用频繁担心额度耗尽,还能独享隐私安全。更惊喜的是,这套设备功耗不足200瓦,玩家直接用屋顶太阳能供电,低碳环保,轻松实现“免费算力自由”。
开箱即用与灵活调度:本地模型工程化落地的关键
设备搭建门槛也十分友好,联网登录网页后台、重置密码即可直接使用,各类代码工具、AI脚本完美适配,无需复杂调试就能切换不同模型。日常可按需分工,Qwen 3.8 Next处理日常轻量任务,GLM 5.3负责深度思考分析,DeepSec专攻OCR校对,小型模型可多开并行运行,大型模型独占满配算力,灵活度拉满。
Minecraft Server挑战赛:速度、创意与稳定性的三维较量
为了直观对比本地开源模型与顶级云端AI的真实实力,这位玩家策划了一场趣味十足的硬核挑战赛:让四大主流AI模型——Qwen 3.8 Next(本地部署)、Fable 5.1、Grok 4.6、GPT Codeex Astra,在20分钟限时内,从零搭建专属《我的世界》服务器。统一要求:搭建专属网页控制面板、打造带瀑布、远山景观的特色趣味建筑,最终以可玩性、创意度、完成度定胜负,一场神仙打架的AI对决正式拉开帷幕。
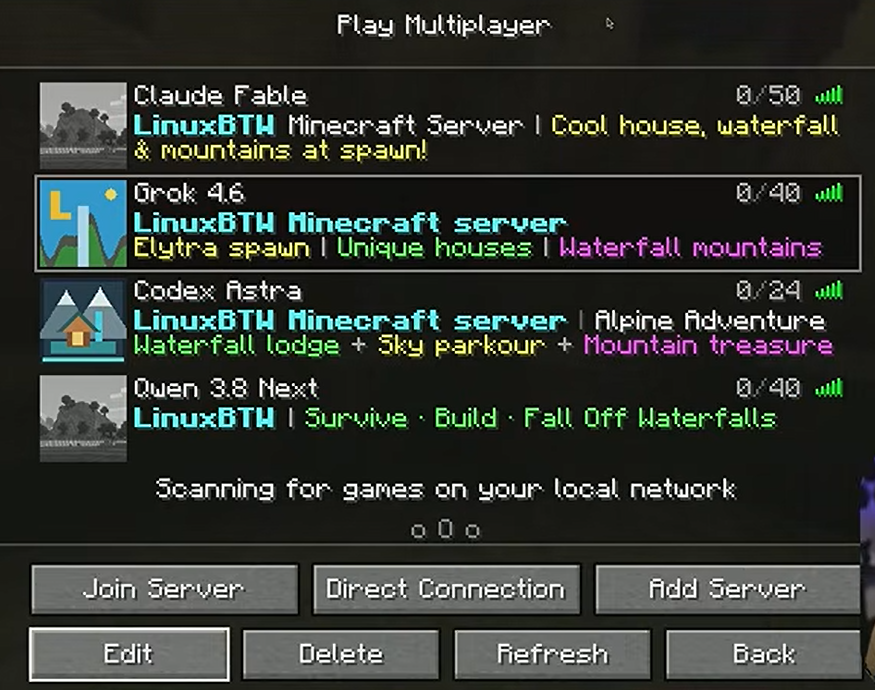
比赛开局就爆出戏剧性差距,速度王者Fable 5.1实力碾压,仅用9分钟就宣称完成全部搭建任务,效率遥遥领先。紧随其后的是Grok 4.6,18分钟完成搭建。GPT Astra开局就遭遇云端AI通病,运算消耗过快,直接耗尽初始配额,不得不重置额度、重启任务才勉强完成。而全程本地运行的Qwen 3.8 Next,没有任何配额限制,慢悠悠稳步推进,足足耗时一个半小时才完工,速度垫底,但胜在全程无中断、无额外成本。
速度不代表实力,四大模型的成品效果差距悬殊,槽点和亮点都十分鲜明,各有优劣:
Fable 5.1:极致速通,敷衍摆烂。作为最快完成任务的选手,它的成品只能用“中规中矩”形容。精准复刻了远山瀑布的基础场景,搭建了基础小屋,还贴心设置了游戏规则提示牌。但细节漏洞百出,房屋地板高度错位导致房门无法正常打开,整体设计毫无新意,可玩性极低。更离谱的是,仅4G运行内存的服务器,它盲目设置50人玩家上限,完全不考虑硬件承载力,妥妥的“只求快、不求好”,综合评分仅5分。最尴尬的是,看似极速完工,最终却没能成功激活网页控制面板,属于典型的“表面完工”。
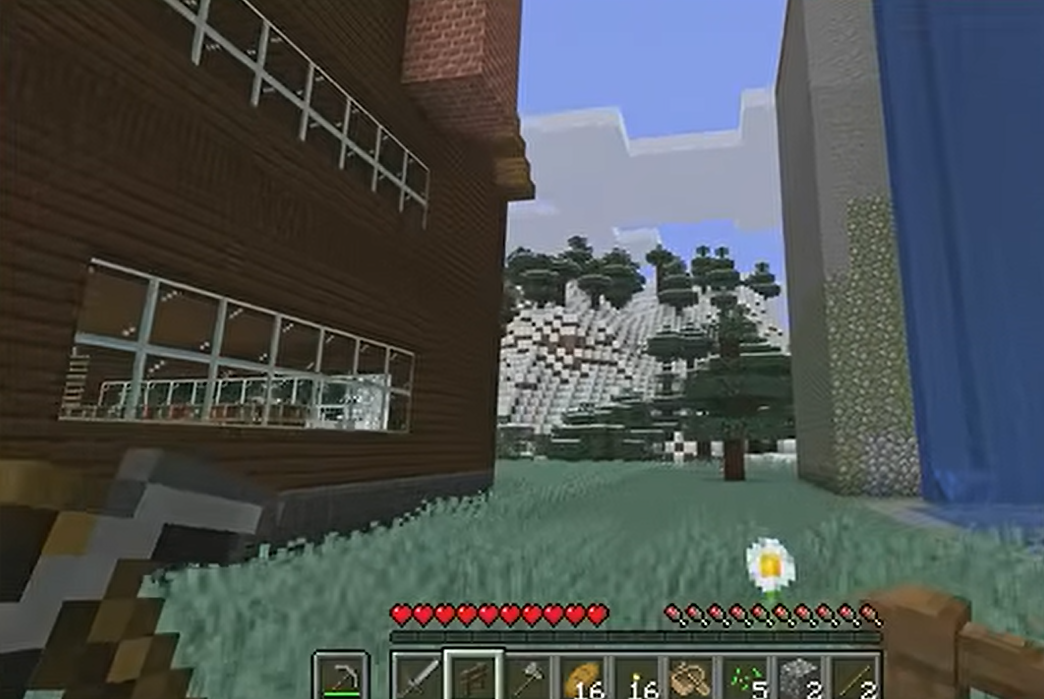
Grok 4.6:脑洞拉满,颜值担当。这款模型主打视觉冲击和趣味性,审美直接碾压Fable 5.1。搭建了巨型立体“Linux”山体地标,多层瀑布错落分布,场景层次感十足。地图中散落着多间特色小屋,宝箱、附魔道具、不死图腾等趣味物资一应俱全,玩法丰富。唯一短板是山体造型过于方正,略显生硬,但胜在创意十足、氛围感拉满,综合评分7.5分。可惜同样翻车在控制面板,功能无法正常使用。
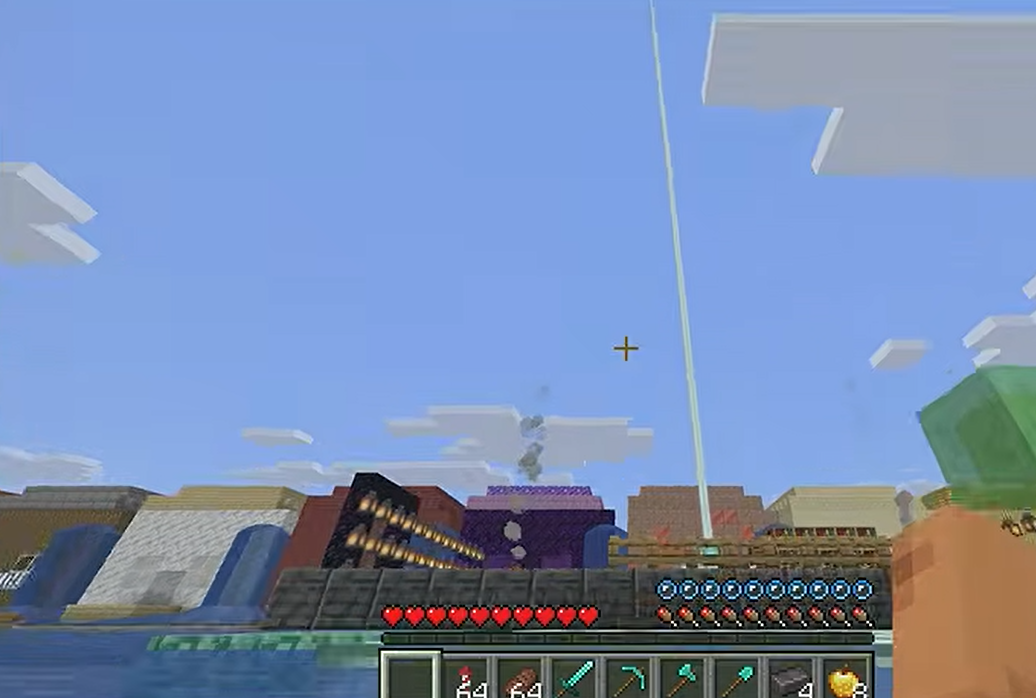
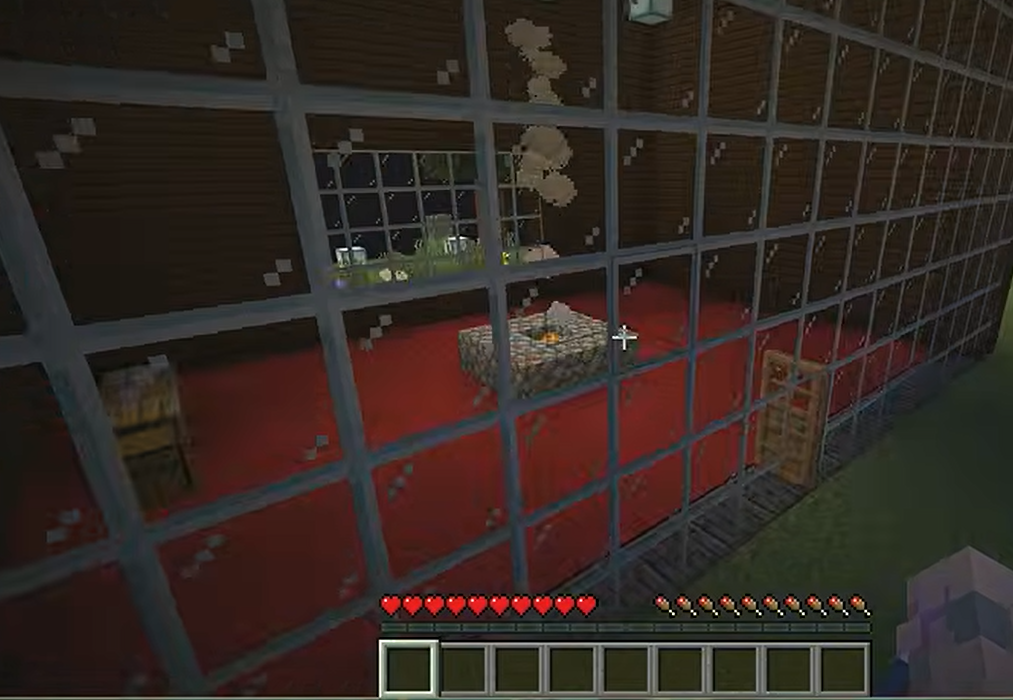
GPT Codex Astra:细节封神,创意天花板。作为全场综合实力最强的选手,Astra彻底跳出基础搭建框架,主打“沉浸式游戏体验”。亲手雕琢错落有致的连绵山峰,打造出可穿行的幕后水晶瀑布,设计感十足。搭建的玻璃轻奢别墅自带观景步道、休闲就餐区、壁炉景观,还创新性加入跑酷闯关、探索成就等专属小游戏,细节精致、玩法丰富。唯一小瑕疵是二楼地板存在轻微缺损,但整体质感、创意度全程领跑,综合评分8.5分,也是全场唯一一次性搞定控制面板的模型,实用性拉满。当然,代价也很明显,超高算力消耗频繁触发配额限制,使用成本居高不下。
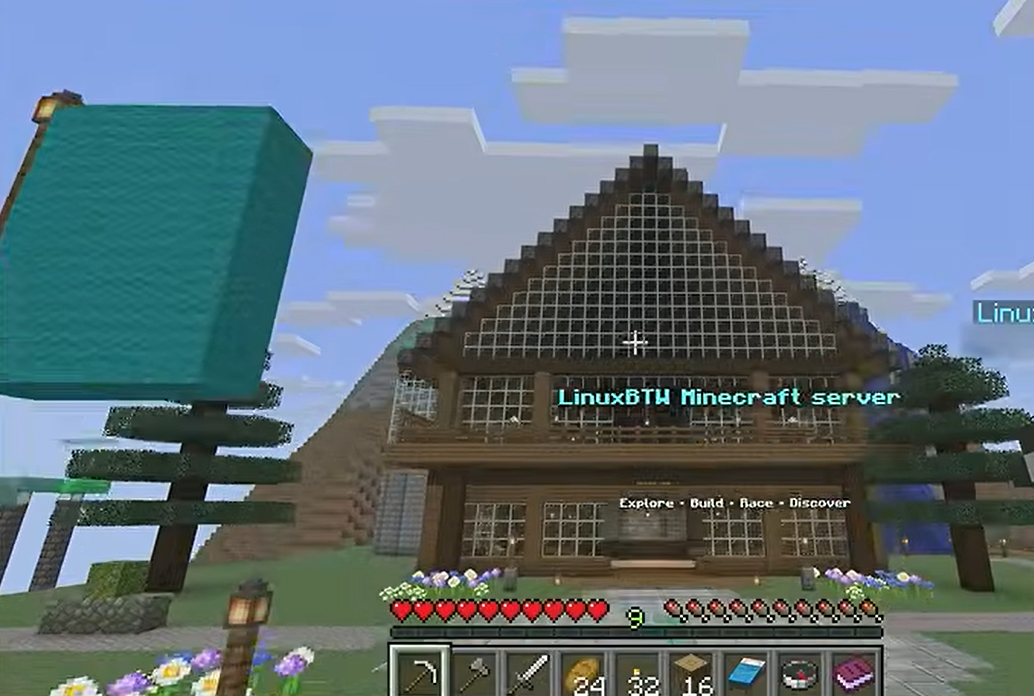
Qwen 3.8 Next(本地模型):稳扎稳打,质感出众。全程本地运行的它,虽然速度最慢,但审美和细节把控十分在线。精准选址高原宝地,依托自然地形打造悬浮瀑布与花海景观,别墅采光、布局合理,灯光装饰精致细腻,整体风格清新高级,氛围感十足。没有花哨的小游戏设计,但场景完整、建筑精致、无明显bug,质感比肩Grok,略逊于Astra,综合评分7.8分。唯一小问题是默认开启TLS证书验证,需要手动关闭才能激活控制面板,但胜在无配额限制、可无限迭代优化、零额外使用成本,性价比直接拉满。
结论:没有完美模型,只有适配场景的最优解
整场挑战赛下来,四大模型的短板暴露无遗:顶级云端AI速度快、创意强、精度高,但算力配额有限、使用成本高昂,极易受平台规则限制;新晋本地开源模型速度稍慢、迭代耗时久,但无使用上限、隐私安全、成本可控,稳定性和自由度远超云端AI。
不得不说,当下的AI行业早已不是云端一家独大。云端AI适合追求极致效率、短期高频的轻量化创作场景,而本地AI凭借隐私安全、自由无限制、长期低成本的优势,在私人数据处理、深度定制化开发、长期迭代测试等场景中站稳脚跟。
这场趣味对决也印证了一个真相:AI技术仍在高速成长,没有完美的模型,只有适配不同场景的最优选择。云端AI的高光优势依旧存在,但本地AI的崛起,正在打破大厂算力垄断,让普通玩家也能低成本解锁专属、安全、可自由折腾的私人AI算力,这或许就是当下AI内卷最有价值的进步。
JOTO 企业落地观察
- 企业部署本地AI时,硬件选型需超越单卡推理吞吐,关注内存带宽与跨设备互联能力。DGX Spark的200GB/s互联与统一内存架构,使RAG知识工程中高频向量检索与多跳推理的实时性成为可能,而非仅满足单文档摘要类轻量任务。
- 在智能体工程实践中,任务闭环稳定性比单次响应速度更关键。Qwen 3.8 Next虽耗时长,但无配额中断、支持无限次迭代调试,这对需反复验证逻辑链的业务场景(如金融合规报告生成)具备更高工程适配性。
- FDE驻场共创模式下,本地AI的‘零配额限制’直接转化为可预测的交付节奏。团队无需协调云端资源审批或应对突发限流,能将全部精力聚焦于业务规则对齐、领域Prompt调优与真实环境联调。
- 四大模型在控制面板激活环节的集体失效,揭示当前AI系统普遍缺乏对目标运行环境(如服务端权限、TLS策略、依赖服务状态)的自主感知与自适应配置能力。这正是企业级智能体工程中亟待构建的基础设施抽象层。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们