MIT与Sakana AI提出SIFT框架:用LLM评判员降低编码智能体自我改进的评估成本
MIT与Sakana AI联合推出SIFT框架,通过引入语言模型作为成对评判员,在大规模基准测试前快速排序候选编码智能体,将Polyglot测试准确率提升至35.1%,CPU小时减少约1/3,API成本压至约150美元。
编码智能体可通过更改引导其工作的提示、工具和代码来实现改进。但要找出哪些更改确实有效且值得保留,却颇具挑战性且成本高昂。
每个候选更改都需要进行测试,而对大量候选方案的搜索可能消耗数千个CPU小时,花费数千美元。
通过快速树搜索实现递归式自我改进(SIFT),这是麻省理工学院(MIT)与Sakana AI研究人员提出的一种框架, 试图降低这种评估成本。 它使用一个独立的语言模型,在投入昂贵的基准测试运行之前,对候选智能体进行比较。它还能在早期候选方案仍在评估过程中时,就提出新的更改。这使得搜索过程可在无需等待每次补丁完成全部测试的情况下,同时探索多个分支。
据研究人员称,在Polyglot编程基准测试中,一次SIFT运行在不到五小时的挂钟时间(wall-clock time)内达到了35.1%的准确率,仅消耗42个CPU小时及约150美元的API积分。
对于针对明确定义任务调优编码智能体执行框架(coding-agent harnesses)的团队而言,SIFT提供了一种更具选择性地使用昂贵评估的方法,而非让每个候选方案都通过全部测试套件。
每一次改进都需要一次测试
工程师可调整编码智能体的指令、添加工具,或更改其应对失败的方式。但人工调优耗费专家时间,且将搜索范围限制于人类想到尝试的思路。 递归式自我改进 通过允许系统修改自身源代码,自动完成了该过程的部分工作。
在自我改进循环中,智能体分析失败案例,并为其执行框架(harness)提出补丁。经修订的智能体尝试目标任务,其得分将决定哪个版本成为下一轮补丁的起点。由于补丁会改变后续提出或执行工作的系统本身,因此改进可彼此叠加。
早期方法以不同方式管理此类搜索。 达尔文-哥德尔机(Darwin Gödel Machine) (DGM)维护一个智能体档案库,并在日益扩大的任务集上检验候选方案:先测试10个任务,再测试50个任务,而完整的Polyglot基准测试则留待最终评估。 赫胥黎-哥德尔机(Huxley-Gödel Machine) (HGM)考虑智能体及其后代在决定下一步搜索位置时的表现。它调整用于评估候选方案的随机抽样任务数量。
主要挑战在于测试智能体执行框架(agent harness)修改项的成本。根据论文中的成本分解,提出一个补丁约花费12美分;一次成对评判(pairwise judge)调用约花费4.4美分,而SIFT每个候选方案最多使用10次此类调用,即最高约44美分;在50个Polyglot任务上评估一个智能体则需约6美元及2.6个CPU小时。
仅在少数几个任务上测试候选更改成本低廉,但其得分可能具有误导性:它可能恰好抽中异常简单或异常困难的问题。使用更大的测试集可为团队提供更可靠的依据,以决定下一步应改进哪个版本;但运行这些额外任务需耗费时间和金钱。
正如作者所言,瓶颈在于“现有评估方法不良的信噪比—成本权衡(signal-to-cost trade-off)”。
SIFT的工作原理
SIFT基于DGM的智能体执行框架构建,但在搜索过程中引入了一种成本更低的反馈来源。其核心假设是:语言模型可在新候选方案完成大规模基准测试运行之前,对其两个版本进行比较,并判断哪一个更可能表现更优。
SIFT生成一个经修改的智能体后,会在四个编程任务上运行该新版本。这一快速检查可在系统投入更多资源进行比较与测试前,识别出导致智能体崩溃或无法解决基础问题的更改。
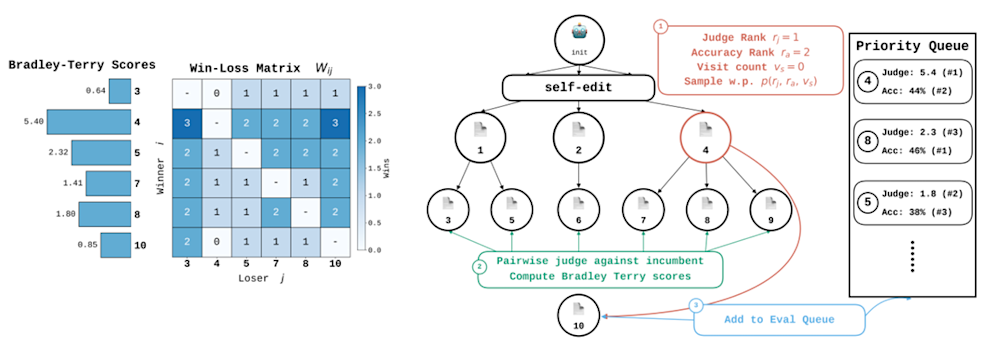
SIFT框架(来源:arXiv)
随后,SIFT向一个 作为评判员的语言模型(LLM-as-a-judge) 发起请求,使其在新智能体与档案库中已有的最多10个高排名智能体之间进行成对比较。比较两个实现方案,更类似于请招聘经理在终选候选人之间做出选择,而非要求其给出一个满分100分的绝对评分。该评判员仅能看到智能体的代码,而看不到基准测试任务本身或其结果。
SIFT利用 布拉德利–特里模型(Bradley–Terry model)将这些成对选择整合为一个排序结果——这是一种通过胜/负记录估算相对强度的统计方法。该排序结果并不取代实际测试,而是帮助决策:在何处投入测试与进一步开发的时间才更有价值。
随后,新候选方案被置入一个优先队列,接受更大规模、更耗时的评估。其优先级由评判员的排序结果与基准测试准确率排序结果共同决定。
该工作流程避免了每个补丁均须等待前一个补丁完成全部评估。补丁生成、评判与基准测试评估可并行进行。这类似于持续集成(CI)流水线:在后台运行长期测试的同时,其他工作持续推进。有前景的候选方案可在其昂贵评估完成前,即成为新补丁的父代。
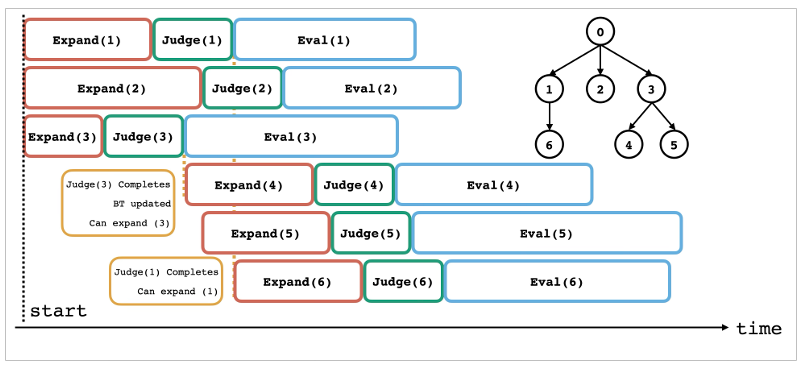
SIFT并行处理不同分支(来源:arXiv)
当SIFT选择一个父代进行改进时,它会综合考量评判员的排序、该智能体在搜索任务集上的准确率排序,以及该智能体此前已被选中的次数。若该候选方案尚在等待评估,则暂时继承其父代的准确率。统计过往被选中次数可防止搜索反复聚焦于同一分支,从而为探索其他可能经更多更改后表现更优的替代路径留出空间。
在Polyglot编程基准测试的一项测试中,一个名为“节点9”(Node 9)的候选方案添加了一条简短指令,要求在编辑后运行测试,并加入了一个返回结构化失败信息的“test_runner”工具。其后一个后代又增加了更多机制。这两个智能体在较小规模的搜索测试中均解决了44%的任务,因此该测试无法判断二者在更广泛基准测试中的相对表现。当在完整Polyglot基准上评估时,较简单的版本得分为35.6%,而在此基础上构建的更复杂版本得分为33.8%。评判员此前已将较简单的节点9排在更高位。
当评判员超越搜索得分时
研究人员在Polyglot、TerminalBench 2.1以及一个包含60个任务的SWE-bench Verified子集上测试了SIFT。其实验涵盖了多种编码模型与语言模型评判员。他们将SIFT与DGM和HGM进行对比,以各智能体未经修改的初始版本为基准衡量改进程度,并在不启用语言模型评判员的情况下运行SIFT,以观察该评判员是否带来差异。
在Polyglot上,SIFT使用开源权重模型Qwen3-Coder-30B与闭源模型o3-mini均实现了更高准确率与更低计算量。使用Qwen3-Coder-30B时,SIFT略优于HGM,同时CPU小时数减少约三分之一;使用o3-mini时,SIFT达到35.1%的准确率,高于DGM的30.7%。未启用语言模型评判员的SIFT运行得分为29.8%,表明该评判员有助于推动性能提升。
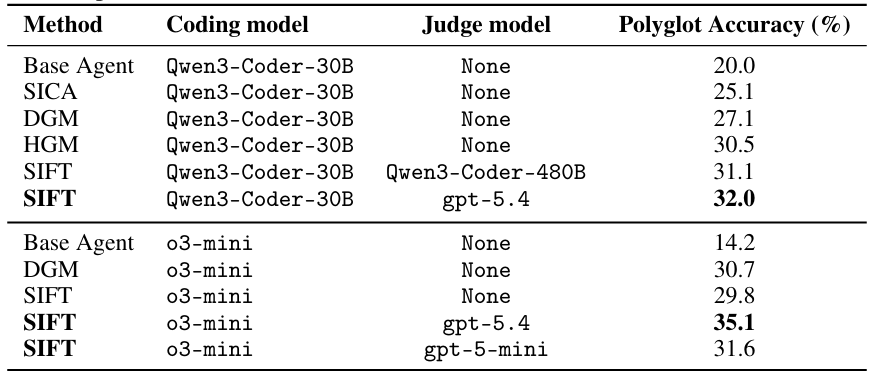
SIFT性能(来源:arXiv)
TerminalBench 展示了当小型测试给出误导性信号时,评判员(judge)能够发现什么问题。评判员选出的最优方案在搜索过程中解决的 50 项任务中完成了 18 项,而同一轮搜索中得分最高的智能体则解决了 19 项。但在完整基准测试的多次重复运行中,评判员所选方案的平均得分为 36.7%,而该轮中得分为 19/50 的智能体平均得分为 28.1%。评判员仅凭代码就发现了问题:该智能体的新验证器(verifier)默认处于禁用状态,且其重写的 shell 工具存在运行时风险。
在 SWE-bench 子集上的结果同样更倾向于由评判员引导的选择,尽管优势不如前述案例清晰。两名由评判员选出的智能体在四次评估中的平均得分分别为 50.4% 和 53.8%;而在无评判员参与的运行中,排名前两位的智能体平均得分分别为 44.6% 和 50.4%。初始智能体得分为 40.0%。
团队可从 SIFT 中获得的启示
该论文未提供独立的 SIFT 实现链接,但开发者未必需要重新构建整个自我改进堆栈。SIFT 建立在 DGM(Dynamic Generation and Modification)框架之上,因此已采用 DGM 实现的团队实际上已具备底层循环的大部分组件:生成对智能体的修改、维护候选版本档案库,以及评估其性能。SIFT 新增了成对评判员(pairwise judge)与 Bradley–Terry 排序机制,并使搜索过程异步化,从而允许在其他候选方案仍在评估时即展开新候选方案的探索。
SIFT 仅在编码智能体上进行了测试,但相同的基本方法亦可适用于其他类型的自我改进智能体——只要存在一种明确方式来衡量某项变更是否有效。第一步是定义一个规模小、成本低的评估流程,以便快速排除明显无效的修改。对于企业级智能体,这可以是一组具有代表性的内部任务,用于检测工具失效、性能退化或违反基本要求的变更。
第二部分是一个大语言模型(LLM)评判员,用于成对比较候选实现方案。该评判员无需预测精确的基准测试得分,而只需提供一种有用的排序,以判断哪个版本更具潜力。
最后,整个流水线需支持异步运行。候选方案生成、评判及更耗时的评估应并行执行,从而使有前景的分支可在先前候选方案仍在测试时继续扩展。SIFT 的大部分加速效果正源于此:搜索树持续生长,而非等待每一项评估全部完成。
评判员的选择本身也留有优化空间。研究人员发现,在 TerminalBench 上,一个成本更低的评判员仍能保留大部分全局排序信号,尽管更强的模型在顶尖候选方案之间更为可靠。他们指出,可采用分层设置:对大多数比较使用成本较低的评判员,仅在排序顶端附近启用更强的评判员。
SIFT 展示了如何通过将低成本评估信号与异步搜索相结合,使自我改进循环本身变得更高效。这使得团队能在不按相同比例扩大评估成本的前提下,探索更多候选改进方案。但下游基准测试仍必不可少,以确认某项变更确实提升了智能体性能;研究人员也不得不屏蔽那些放宽评估框架(evaluation harness)限制的补丁。
JOTO 企业落地观察
- 对企业部署而言,SIFT提示可复用现有DGM架构快速集成——无需重写整个自我改进循环,仅需增加LLM成对评判与异步优先队列模块,显著降低高成本评估的调用频次,适合预算受限但需持续迭代编码智能体的中型企业。
- 对智能体工程而言,SIFT验证了‘代码即信号’的可行性:LLM仅凭补丁代码(不看任务或结果)即可识别出shell工具运行时风险、验证器默认禁用等隐性缺陷,说明工程侧应建立轻量级静态分析+LLM代码感知双校验机制。
- 对AI安全治理而言,SIFT明确要求屏蔽‘放宽评估框架限制’的补丁,表明自动改进系统必须内置评估完整性约束;该设计可迁移至金融、医疗等高合规场景,防止智能体为提升分数而绕过安全沙箱或审计日志机制。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们