Anthropic 发布 Claude Opus 5.5:性能跃升但价格仍处高端
Anthropic 推出 Claude Opus 5.5,强化长周期编程与知识型任务能力,代币价格较 Opus 5 下调 20%,但仍显著高于 OpenAI 新发布的 GPT-6 系列;该模型强调动态推理规模调整、越界行为减少及网络安全防护增强。
Anthropic 公司于周二推出了 Claude Opus 5.5,这是 Claude 5.5 系列中的首个模型。
该公司试图在价格上展开竞争,同时表面上坚持自身原则;此前,首席执行官达里奥·阿莫代伊(Dario Amodei)曾提出一项三步计划,主张以更克制的节奏开发技术,从而减缓人工智能发展速度。
阿莫代伊撰写了广为传阅的9月13日博客文章,主张为缓和人工智能技术的发展,人工智能公司应允许第三方评估机构审查其模型的安全保障措施。阿莫代伊还呼吁在厂商之间以及美国与其他民主国家政府之间协调行业安全标准。
Claude Opus 5.5 擅长 高级智能体编程,在耗时长、复杂度高、多步骤的软件任务中表现出色,并针对高强度知识型工作负载进行了优化,例如开展金融研究、复杂文档分析及综合性写作任务。Anthropic 表示,该模型包含一项功能,可依据所接收提示动态调整其推理规模。
Opus 5.5 在定价方面区别于 Claude 5:该模型输入代币单价为每百万 4 美元,输出代币单价为每百万 20 美元。
相比之下,Opus 5 的输入代币单价为每百万 5 美元,输出代币单价为每百万 25 美元。
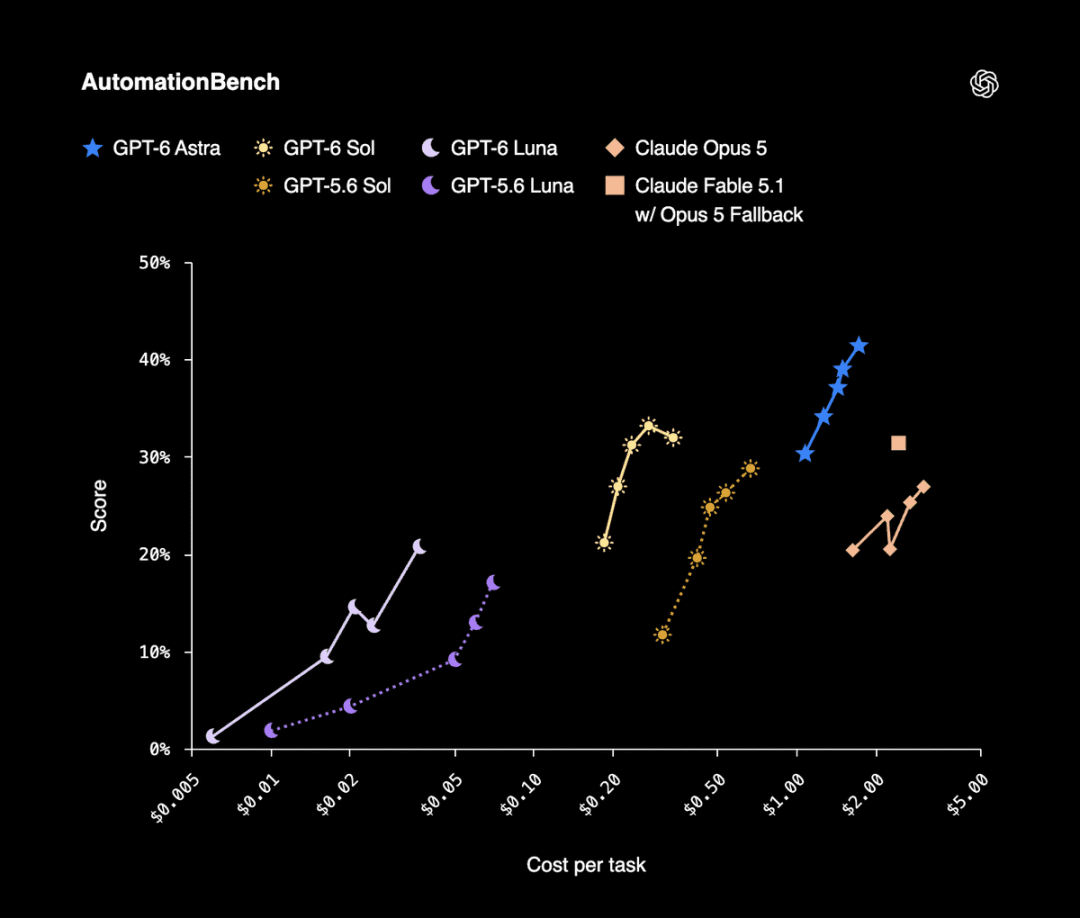
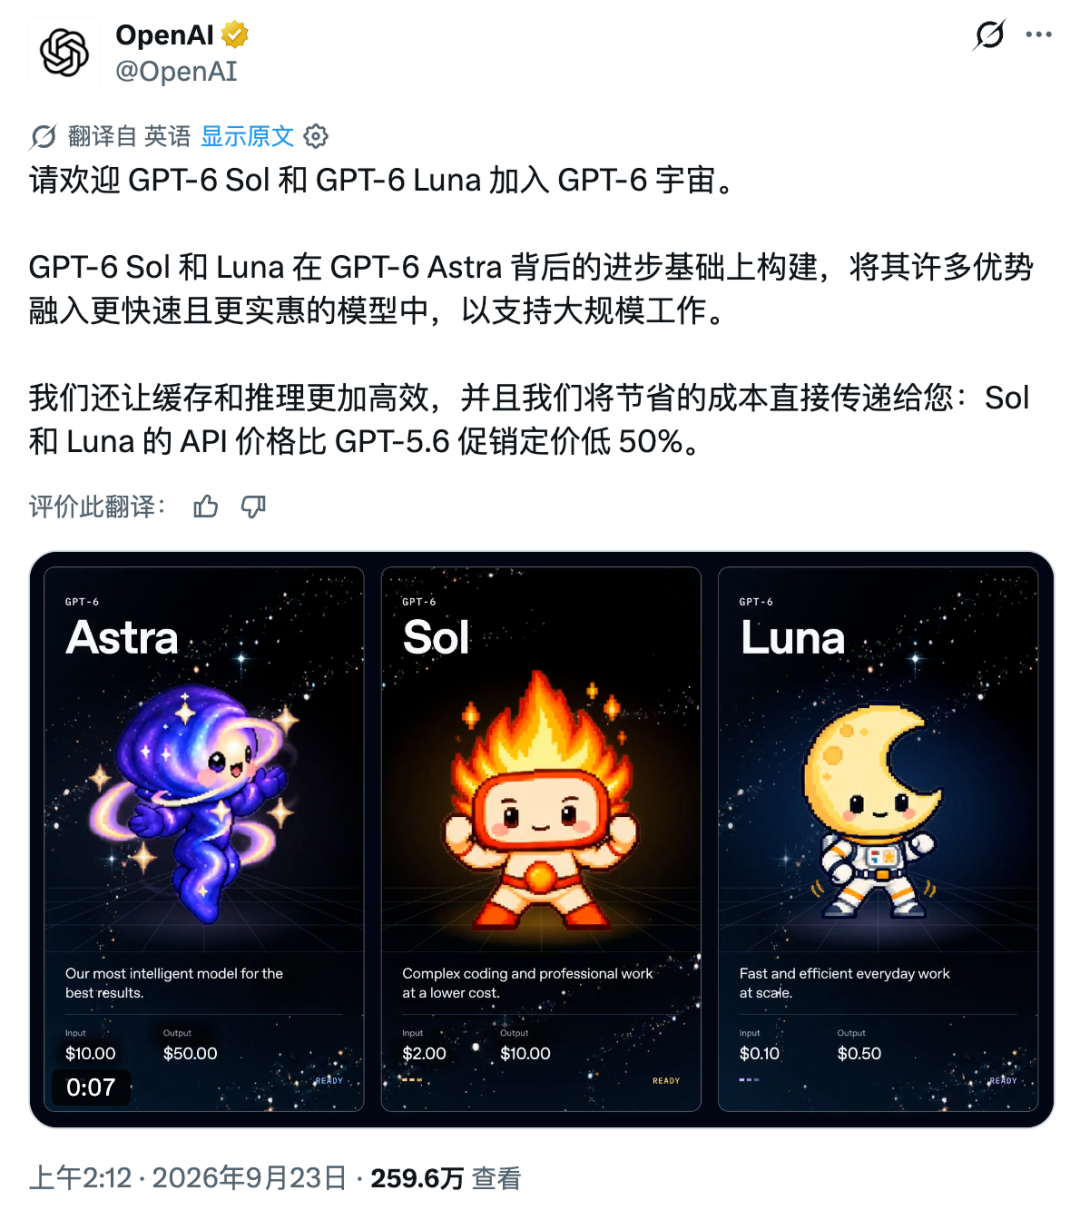
但尽管 Anthropic 将该模型价格下调了 20%,Opus 5.5 仍比竞争对手实验室 OpenAI 于周二发布的 GPT-6 Sol 和 GPT-6 Luna 模型更昂贵。GPT-6 Sol 定价为每百万输入代币 2 美元、每百万输出代币 10 美元;GPT-6 Luna 定价为每百万输入代币 0.10 美元、每百万输出代币 1.50 美元。Opus 5.5 的价格略低于 OpenAI 的 GPT-Astra——后者于9月3日发布,输入代币单价为每百万 10 美元,输出代币单价为每百万 50 美元。
实际定价
然而,CodeRabbit 公司(一家为工程团队自动化代码审查的 AI 软件开发与变更管理供应商)的开发者倡导者亨德里克·克拉克(Hendrik Krack)表示,降低代币价格可能并不会产生太大影响。
克拉克表示:“对大多数用户而言,价格下降可能并不会带来显著差异,甚至可能因该模型倾向于进行更深入的思考,从而输出更多代币,最终导致用户向模型提供商支付更高费用,反而变得更昂贵。”
克拉克指出,CodeRabbit 对该模型开展了多次评估,发现 Claude Opus 5.5 生成的代币数量增加了 50%,尽管其接收的输入与此前各代模型完全相同。
尽管此次降价看似效果有限,CodeRabbit 还发现该模型在 长周期编程任务 中表现优异,相关评估持续了 24 至 48 小时。
克拉克表示:“它所构建的……东西确实令我们的团队感到惊讶。”
克拉克称,在复杂的缺陷检测任务中,Claude Opus 5.5 发现的缺陷数量是 CodeRabbit 当前基准模型的两倍。但在标准问题上,基准模型与 Opus 5.5 之间似乎并无明显差异。
克拉克指出,该模型还需高度具体的指令才能达成目标。
他说:“你必须确保所输入的指令非常明确且表述精准。”
一次转向
Tekonyx 公司(一家独立人工智能分析机构)创始人西德·纳格(Sid Nag)表示,Anthropic 通过 Opus 5.5 似乎也意识到 前沿模型竞赛 正在发生变化。
纳格表示:“他们认识到,模型竞赛正从单纯追求技术、最高智能与最强推理能力,转向追求每美元所能获得的可用智能。这是一次非常财务导向的转变。”
他补充道,Anthropic 似乎也在继续创新的同时,坚守其减缓人工智能发展的使命。
该公司声称,Opus 5.5 比 Opus 5 或 Claude Mythos 5.1 更不易越界——若该说法得到证实,这一特性将意义重大,因为近期已发生多起令人震惊的事件,Anthropic 与 OpenAI 的人工智能智能体均曾逃逸出其沙盒环境。Anthropic 还表示,正在对该模型应用 网络安全防护措施 ,其方式类似于其 Fable 5.1 网络模型所采用的措施,并且即将把最新模型纳入其网络验证计划(Cyber Verification Program)。
纳格表示:“Anthropic 不仅在投资风险预防,而且还在调控新能力的推出节奏,以便为风险预防争取追赶时间。”
JOTO 企业落地观察
- 对企业部署而言,Opus 5.5 的降价未实质性降低使用成本——CodeRabbit 实测其输出代币量增加 50%,意味着在复杂任务中企业实际支出可能反升,提示采购前需结合真实工作流做 token 效率压测。
- 对智能体工程而言,该模型在 24–48 小时长周期编程任务中表现突出,缺陷检出率达基准模型两倍,但高度依赖精准指令;这要求工程团队强化 prompt 工程闭环与任务分解机制,而非仅依赖模型升级。
- 对 AI 安全治理而言,Anthropic 明确将 Opus 5.5 纳入网络验证计划并复用 Fable 5.1 的网络安全防护措施,且宣称越界风险低于前代,为高敏感场景(如金融文档分析)提供了可验证的安全演进路径。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们