本地版Jev 1G内存就能跑!四舍五入等于不要钱啊
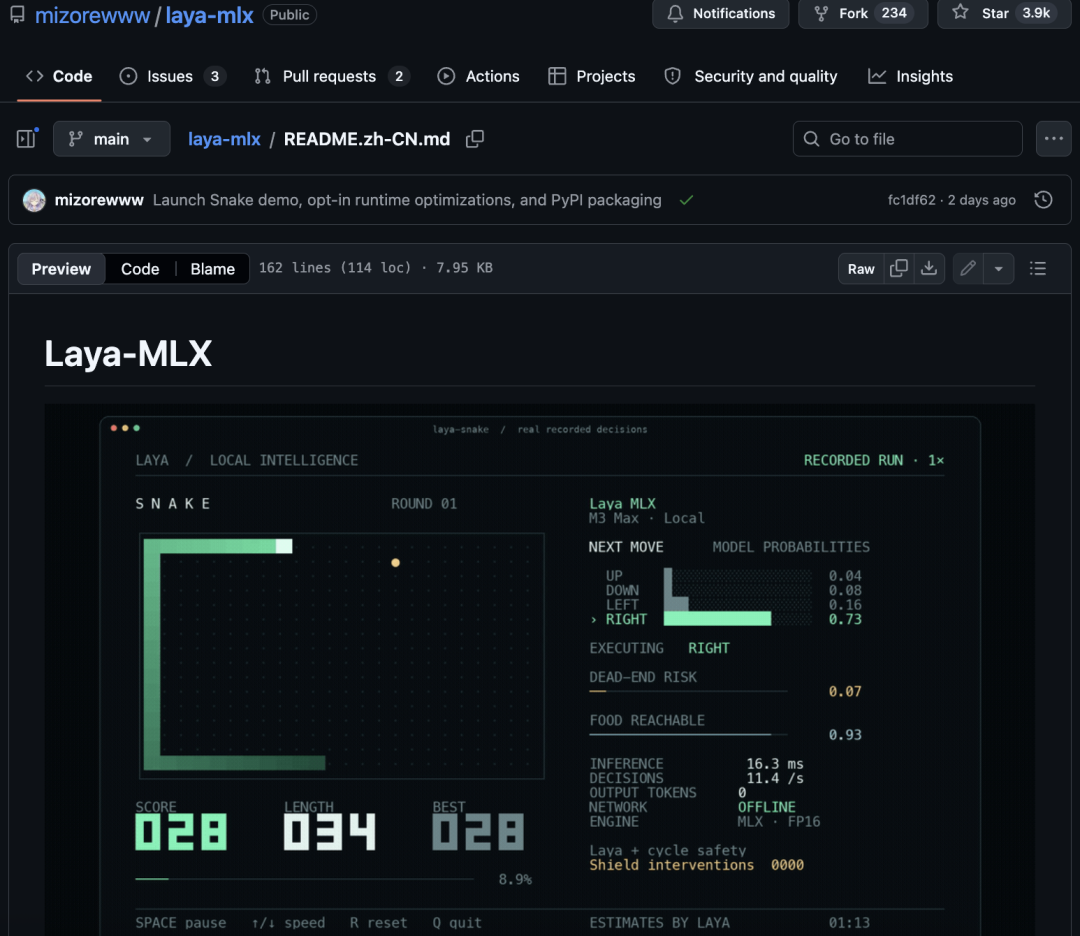
开发者基于开源模型Laya构建了Laya-MLX,可在Apple Silicon Mac本地运行,421M英文版峰值内存仅943.6MiB,322M多语言版低至687.6MiB;单问题P50延迟最快7.39ms,吞吐达395 questions/s。该实现无需PyTorch/Transformers,不依赖云端API,已通过378次全量推理结果一致性验证。
开源版Jev
Jev大家这两天应该已经眼熟了。
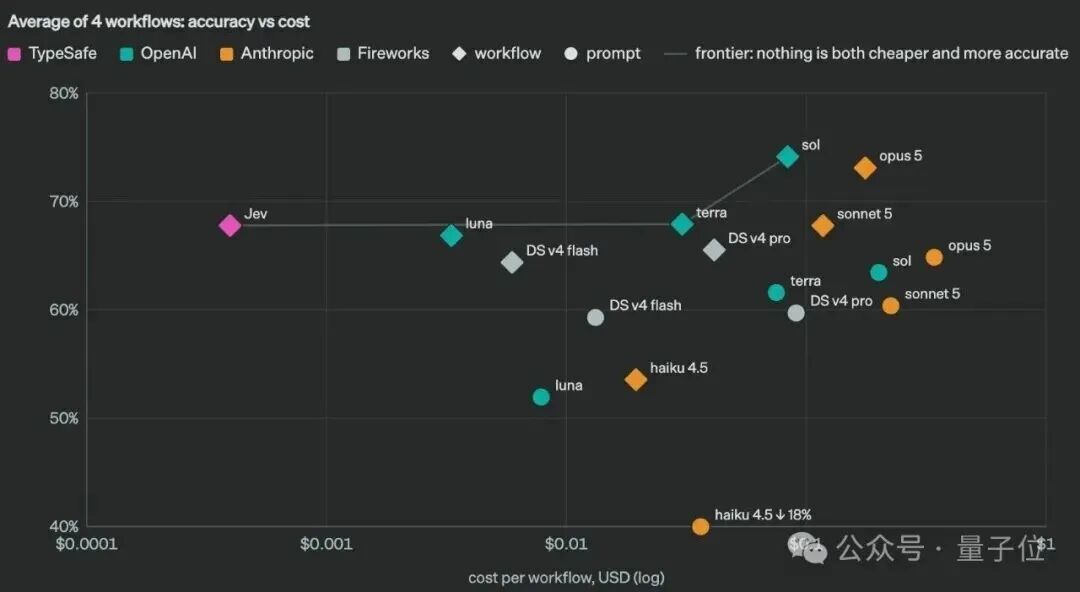
它和普通LLM最大的区别,就是直接把最耗时间的文本生成砍了,聊天不会,代码不写,文章也不碰……只专心干一件事,下判断。
(Bert:嗯?这个工作内容我好像在哪里听过?)
少了逐Token生成这一步,推理速度自然和传统LLM拉开了差距。
也就是靠着这种简单粗暴的玩法,Jev发布之后迅速出圈。
紧接着,开源平替就来了。
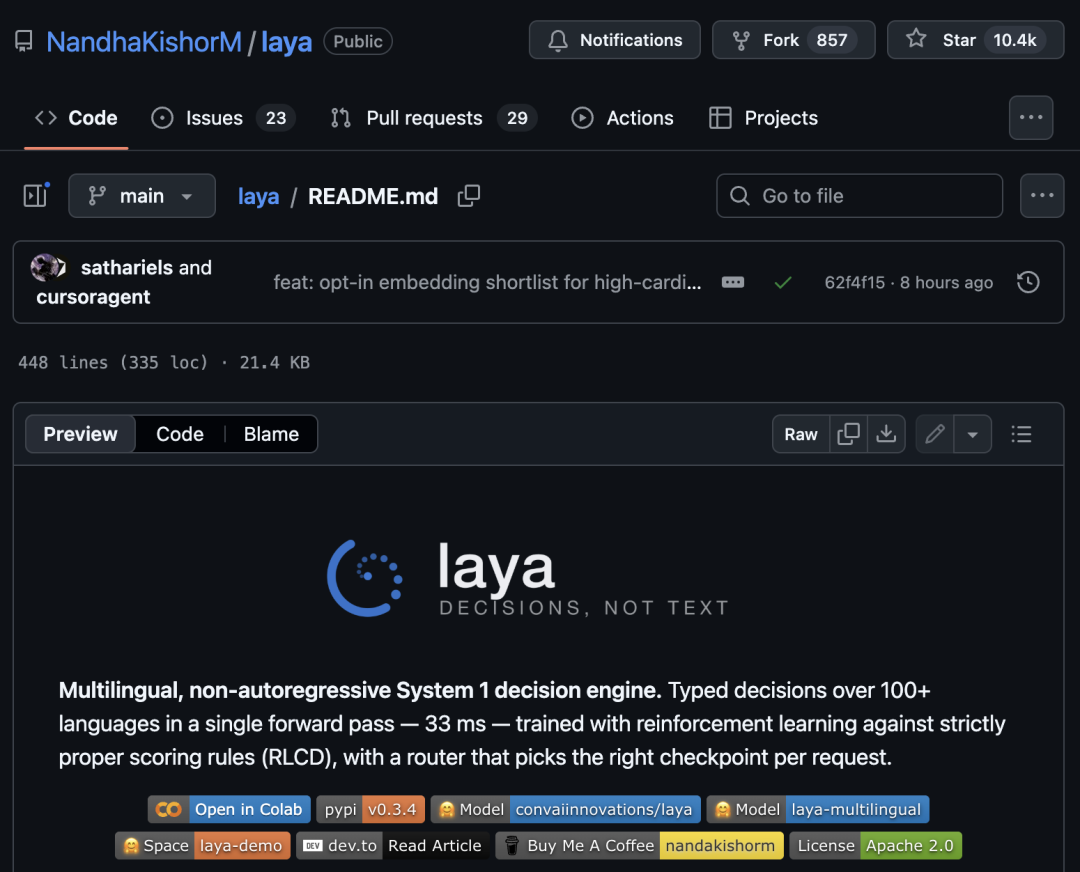
Laya,一个多语言、非自回归的System 1决策模型。
思路和Jev类似,同样不把算力花在生成文本上,直接针对结构化问题输出决策结果,在GitHub已经狂揽10.4k Star。
它目前主要就干三类活:
- choice,从几个选项里挑一个;
- score,按照给定标准打分;
- noul,判断一件事情为True的概率。
把一段state和需要判断的问题一起塞进去,一次forward直接能得到结果。
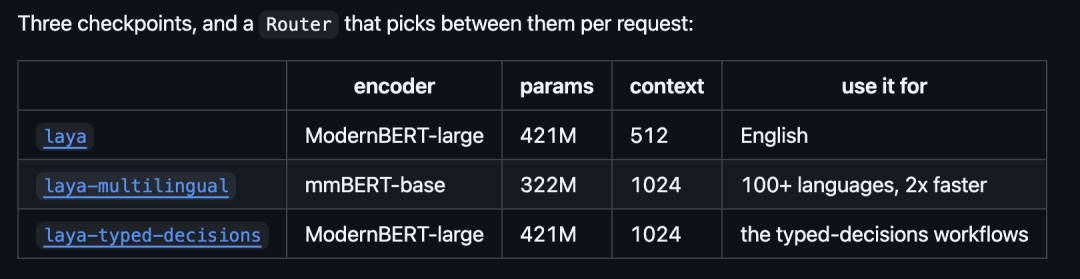
Laya目前主要有三个checkpoint。
英文版本基于ModernBERT-large,421M参数;
多语言版本基于mmBERT-base,只有322M参数,支持100多种语言;
另外还有一个针对typed-decisions工作流的421M版本。
模型本身就只有三四亿参数,速度也已经相当快。
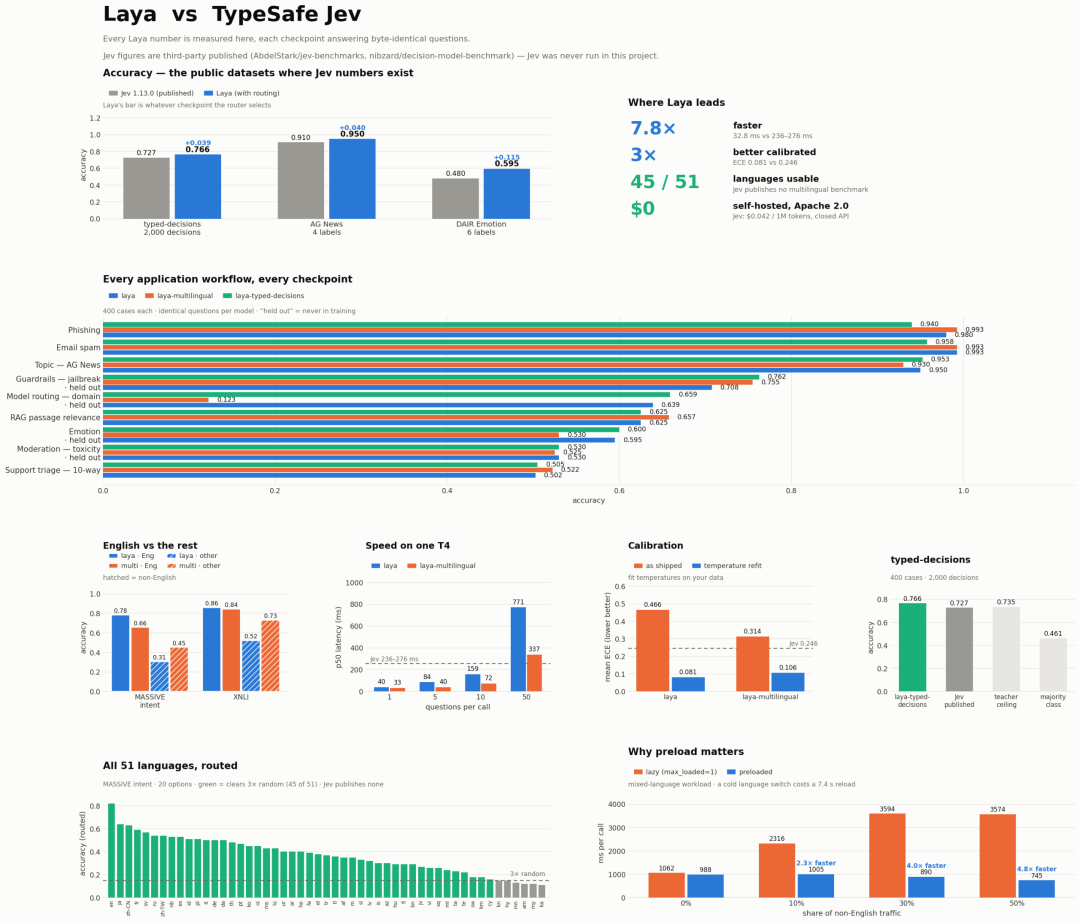
原版Laya在Tesla T4上,单个问题大约33ms;批量处理时平均可以做到7.2ms/question,单卡吞吐量最高达到数百个问题每秒。
项目引用的第三方Jev P50延迟在236~276ms,而Laya自己测得单问题为32.8ms,大约快7~8倍。
在yped-decisions的2000次决策测试中,专门微调过的Laya版本准确率为76.6%(之前Jev公开成绩是72.7%)。
本地1GB可跑
Laya-MLX动的是Laya的推理栈。
开发者已经能够自己部署原版Laya,但主要跑在PyTorch、Transformers这套环境里。
mizorewww则在Apple MLX框架上重新实现了Laya完整神经网络架构,让模型能够原生跑在Apple Silicon上。
PyTorch和Transformers runtime都可以拿掉,也不需要请求云端API。
而且换了推理栈之后,原来的结果也得对得上。
Laya-MLX把三个checkpoint分别用FP32和FP16进行了验证,在63个验证问题上,全部匹配原版Laya选择的答案。
三个模型、两种精度,一共378/378次对比通过,没有出现推理结果漂移。
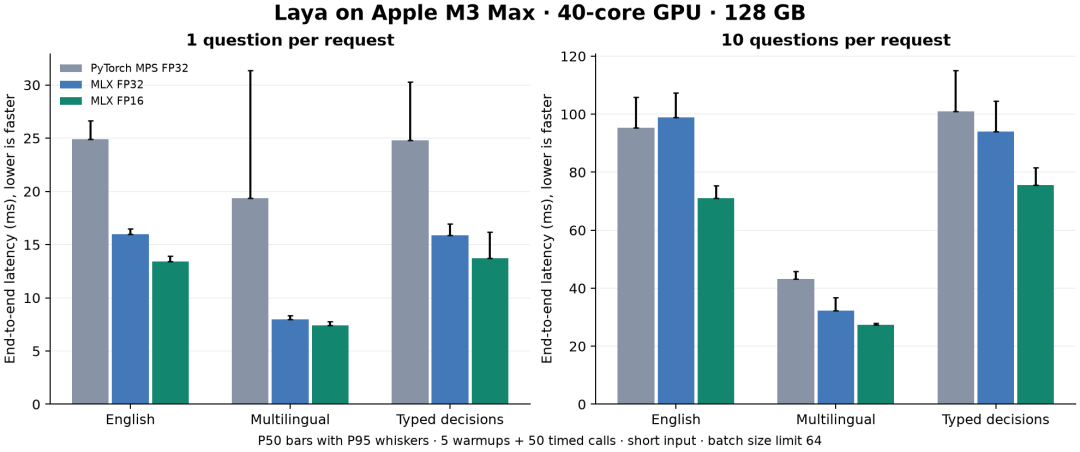
测试机器是一台M3 Max,40核GPU、128GB统一内存。
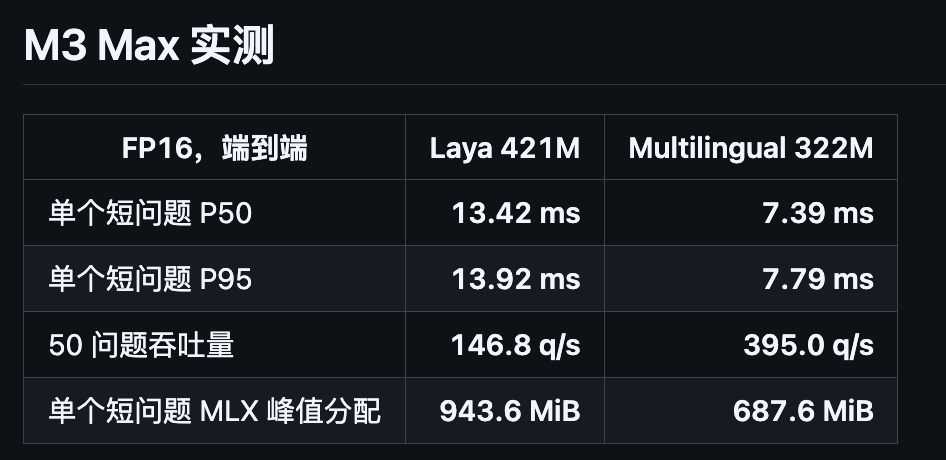
421M英文版本处理一个短问题时,峰值MLX allocation为943.6MiB;322M多语言版本进一步降到687.6MiB。
但速度没有跟着缩水。
同一台M3 Max上,421M版本处理一个短问题,P50延迟为13.42ms;322M多语言版本为7.39ms。
P95也分别只有13.92ms和7.79ms。
如果一次塞50个问题进去,多语言版本吞吐可以直接冲到395 questions/s。
而且这些时间还不是模型核心算子的裸延迟。
项目的计时范围包含了prompt准备、tokenization、tensor构建、同步推理、校准以及最终结果格式化,只把模型加载时间排除在外。
换句话说,7.39ms测的是一次短决策从进去到结果出来的端到端延迟。
Laya-MLX玩贪吃蛇游戏的决策速度可以达到每秒60次。
这里每走一步都会实际调用一次Laya,根据当前状态重新做决策,外面再由cycle safety layer对危险动作进行纠正。
打开项目测试过的编译和prefix reuse优化后,在同一台M3 Max上连续跑2400步——
75.40 moves/s,0次死亡。
整个过程中,安全层可见介入了2次,仅少量场景做了动作修正。
三行运行
感兴趣的朋友可以直接在Apple Silicon Mac上本地部署。
目前项目要求Python 3.11+、macOS 14+。
安装依赖后,可以直接导入库使用,加载已经转换好的checkpoint:
pip install laya-mlx
import laya_mlx as laya
agent = laya.load(“aac6fef/laya-mlx”)
接下来把state和问题交给agent.predict()就行。
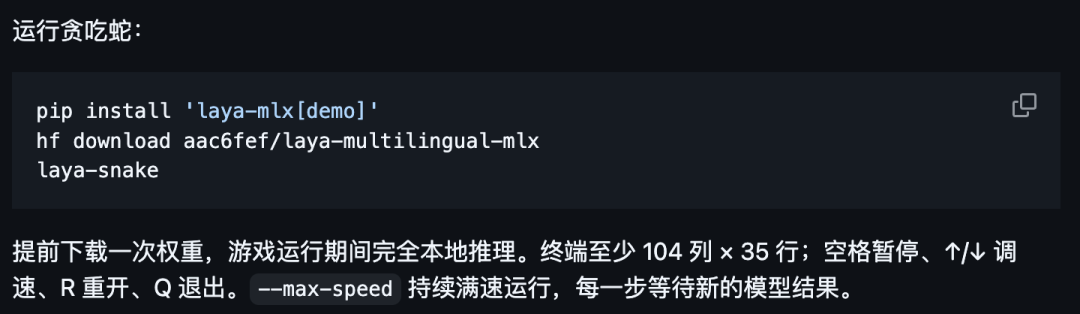
第一次运行会自动下载checkpoint,之后的推理就可以完全留在本地。
当然了,小也有小的代价。
421M英文版本上下文只有512 tokens;
322M多语言版和421M typed-decisions版本,也只有1024 tokens。
1k上下文还需要同时容纳state、instructions和options,所以它更适合短输入、高频调用、输出结构明确的决策任务。
短板客观存在,但挡不住开源大佬连夜跟进,没错咱已经在dream下一版了!
Jev:我才刚火了一周。。。
JOTO 企业落地观察
- 这类轻量级决策模型大幅降低了智能体工程中「实时决策模块」的部署门槛,企业可在边缘设备或笔记本级硬件上完成本地化闭环,规避云端调用延迟与数据外传风险。
- 其固定输入长度(512–1024 tokens)与结构化输出特性,天然适配RAG知识工程中的「检索后精排」「规则校验」「多源置信度融合」等确定性子任务,可作为现有RAG pipeline的低成本增强组件。
- 对FDE驻场共创团队而言,此类模型的快速验证能力(3行代码即可运行)显著缩短了POC周期,使业务方能直接参与决策逻辑调试,加速AI能力与业务规则对齐。
- 模型无文本生成能力,本质上规避了幻觉输出风险,但在企业安全治理中仍需关注其输入state构造环节的完整性与抗注入能力——决策正确性高度依赖上游数据质量与提示词工程鲁棒性。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们