Reflection 发布 Beam 模型:以 token 效率挑战中国开源大模型
Reflection AI 推出 5010 亿参数开源模型 Beam,聚焦每任务 token 消耗优化,宣称在编程与智能体任务中实现更高 token 效率;其强化学习训练机制惩罚冗余 token,目标是降低企业实际部署成本,而非压低单价。
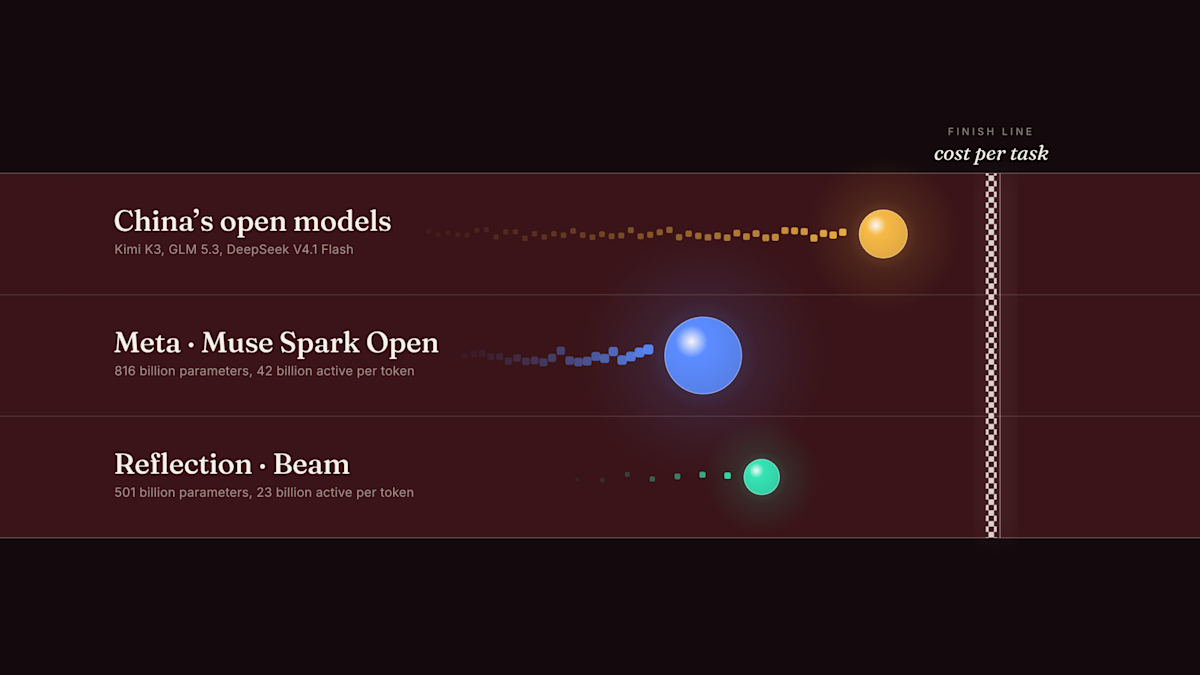
Reflection AI 今日 发布了其首个开源模型 Beam 的权重 ,并将其定位为抗衡中国开源模型的竞品;目前许多美国公司正因成本更低而采用这些中国开源模型。
Reflection 押注称,Beam 这一参数量达 5010 亿的模型,完成一项任务所需的 token 数量远少于其他同规模模型,Reflection 表示这降低了每项已完成任务的成本。
Beam 发布 的时间点,恰在 Meta 发布 Muse Spark Open(一款参数量达 8160 亿的模型)之后一天;Meta 将该模型称为迄今能力最强的美国开源权重模型。Meta 以其更大模型的能力为卖点。但根据两家公司各自公布的评测分数,无论是 Meta 的模型还是 Reflection 的模型,在广泛用于命令行代理任务评测的 Terminal-Bench 2.1 上,均未达到顶级中国模型的性能水平。不过,Reflection 押注认为,只要其在该类任务上提供具备竞争力的性能,企业将更关注模型完成每项任务所需消耗的 token 数量。Beam 的高效性可实现“以更低成本提供强劲的模型能力”,Reflection 在其 10 月 5 日的博客文章中写道,该文首次预览了其模型的详细信息。
在该篇博文中,Reflection 表示,该公司通过高强度的强化学习训练了该模型——即模型反复练习任务并因其结果获得奖励的训练阶段;且每当模型使用了不必要的 token 时,公司便会对其施加惩罚。
在 VentureBeat 独家专访中,Reflection 联合创始人兼首席技术官 Ioannis Antonoglou 解释了为何该惩罚机制难以精准设定。当被问及 Beam 为生成更简短、更高效的答案而牺牲了什么时,Antonoglou 表示:“你并未牺牲任何东西。你只是在它所能使用的 token 数量上对其施加惩罚。”
Antonoglou 表示,难点在于,若团队“简单粗暴”地施加该惩罚,最终得到的模型将“仅学会不去完成任务”,因为减少 token 输出比实际执行工作更容易。为防止 Beam 放弃任务,他表示,Reflection 运行了规模极大的强化学习训练。Antonoglou 称,通过足够多的强化学习训练,模型将学会同时完成任务并保持回答简洁。
Reflection AI 开展了其自称是开源权重实验室迄今所进行的最大规模强化学习训练之一。在为期四周的时间内,该团队运行了逾 1 亿次“rollout”(即模型完整尝试解决问题、检验自身推理能力并从错误中学习的试错过程),该训练由一个包含 10,500 块英伟达最新 GB300 GPU 的集群提供算力支持。
据该公司今晨发布的上线公告,计入评估与实验,Reflection 共运行约 13 亿个沙盒环境(即模型练习任务所用的隔离计算环境),其计算集群峰值负载达 883,006 个虚拟 CPU,分布于谷歌云(Google Cloud)和亚马逊网络服务(Amazon Web Services)共 23 个集群之上。
在中国所有实验室中,深度求索(DeepSeek)尤其因其优化与效率方法而广受赞誉。然而 Antonoglou 表示,Beam 与 DeepSeek 最新发布的 V4.1 Flash 模型相比表现优异。他援引独立基准测试机构 Artificial Analysis 的说法:初步指标表明,Beam 将成为“我们迄今所见、在其智能水平上 token 效率最高的开源模型之一。”
不过,DeepSeek 并未出现在 Reflection 用以对比 Beam 分数与各模型生成 token 数量的图表中。该图表 刊登于 10 月 5 日的博客文章中,涵盖智谱(Z.ai)的 GLM-5.2、阿里巴巴(Alibaba)Qwen 3.8 的两个版本、Thinking Machines Lab 的 Inkling、英伟达(Nvidia)的 Nemotron 3 Ultra,以及 Meta 此前推出的更小规模开源模型 Muse Glimmer。
为何 token 单价更高者,单任务成本反而更低
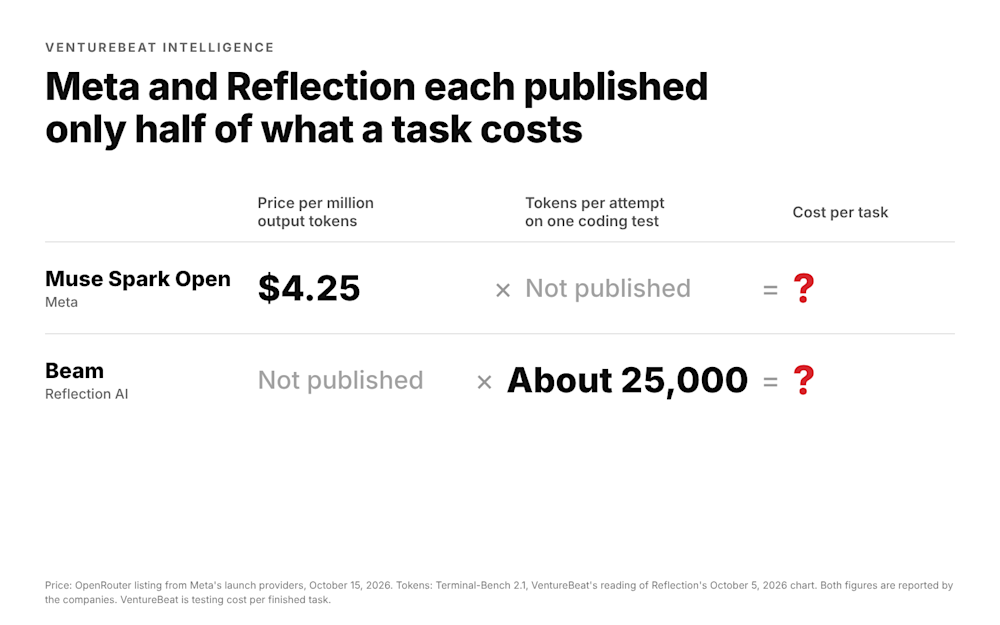
一家公司的 AI 账单等于每个 token 的价格乘以完成一项任务所需的 token 数量,但大多数价格对比仅显示每个 token 的单价。
假设有两个模型。模型 A 每百万 token 收费 1 美元,修复一个 bug 需要 30,000 个 token,因此修复成本为 3 美分;模型 B 的单价是模型 A 的两倍,即每百万 token 收费 2 美元,但仅需 10,000 个 token,因此模型 B 完成同一修复任务的成本为 2 美分。提供商通常对模型读取的 token 和模型输出的 token 收取不同价格,但对二者均适用相同的乘法计算方式。
每个 token 的单价是买家在价目表上看到的数字,而越来越多的受访者在 VentureBeat 的 AI 基础设施月度调查 中将其列为考量因素。在 9 月的调查中,23% 的受访者将每百万 token 成本列为选择 AI 基础设施的因素,高于 8 月的 11%。
Antonoglou 表示,当一个模型为完成某项任务生成大量 token 时,终端客户将承担该成本。
在负责将开发者请求路由至多个模型的服务平台 OpenRouter 上,生成 token 数量最多的模型正是 Beam 同等规模的模型。他将它们称为主力型或“Flash”型模型——即由 DeepSeek 等实验室发布的快速、中等规模模型,适用于日常工作任务。Beam 总计拥有 5010 亿参数,每次生成一个 token 时调用其中 230 亿个活跃参数。据该公司称,Beam 的目标是成为面向编程与代理任务的主力型模型。
Meta 的 Muse Spark Open 每个 token 所用的活跃参数数量接近 Beam 的两倍
相比之下,Meta 的新开源模型 Muse Spark Open每个 token 使用 420 亿个活跃参数,而 Beam 为 230 亿个。Reflection 根据模型的活跃参数数量估算每个 token 所需算力,因此按 VentureBeat 采用该方法的计算,每个 Muse Spark Open token 所需算力约为 Beam token 的 1.8 倍。
Meta 尚未公布 Muse Spark Open 每项任务所用的 token 数量。Hugging Face 的上线公告指出,Muse Spark Open 的推理强度默认设置为最高档,且 Hugging Face 建议开发者针对简单任务将其调低,以减少 token 消耗。
Meta 的模型在发布首日(即昨日)已标出价格:OpenRouter 上四家供应商将 Muse Spark Open 列为每百万输入 token 1.25 美元、每百万输出 token 4.25 美元。然而 Reflection 尚未公布定价。该公司表示,其自建托管服务的价格仍在制定中,该服务目前处于 公开测试阶段期间免费,并且合作伙伴(例如 Baseten)自行设定其价格。
两项许可协议亦有差异:Beam 的权重采用 Apache 2.0 许可证;而 Meta 的 Muse 模型许可证要求所有基于该模型构建的产品须标注“Built with Muse Spark Open”。此外,Meta 还要求年营收超过 2000 万美元、并将该模型作为服务对外销售的任何公司另行签署单独协议。
Reflection 表示,其尚未将 Beam 与 Muse Spark Open 直接对比。但 Reflection 称,Beam 的推理效率使其脱颖而出,此外还有 Reflection 所谓的“开源操作系统”——即 Reflection 正联合合作伙伴推出的、用于运行与部署 Beam 的软件。Reflection 对 Meta 的竞争表示欢迎,并指出多家实验室同步发布多个开源模型,将为企业和开发者提供更多选择。
这两次发布展示了美国实验室如何应对中国在开源模型领域的领先优势。中国实验室目前仍位居开源模型性能排行榜榜首,但Meta正以“算力”予以回应:Meta称其更大规模的模型在两项智能体与工具使用测试(JobBench和MCP-Atlas)中击败了领先的中国模型。Reflection则以“精简性”予以回应:一种经训练可在更少token内完成每项任务的更小规模模型。对于选择开源模型的企业而言,这两次发布将原本的一个问题拆分为两个:其一是哪个模型能力最强;其二是哪个模型能以最低成本完成工作。 算力Reflection则以“精简性”予以回应:一种经训练可在更少token内完成每项任务的更小规模模型。对于选择开源模型的企业而言,这两次发布将原本的一个问题拆分为两个:其一是哪个模型能力最强;其二是哪个模型能以最低成本完成工作。 精简性对于选择开源模型的企业而言,这两次发布将原本的一个问题拆分为两个:其一是哪个模型能力最强;其二是哪个模型能以最低成本完成工作。
DoorDash、Coinbase和Pinterest均将成本降低归功于开源模型,其中包括中国开发的模型。
多家知名美国公司均将成本降低归功于开源模型,其中许多来自中国。Pinterest基于阿里巴巴的Qwen构建了其购物助手背后的对话式模型Navigator 1。“我们最近推出了名为Navigator 1的对话式AI模型,该模型基于Qwen 3 VL构建,”Pinterest首席技术官Matt Madrigal 在Beyond the Pilot播客中向VentureBeat表示。Pinterest首席执行官Bill Ready于2025年11月向投资者表示,该公司使用微调后的开源模型相比领先的现成专有模型,成本降低了90%。
DoorDash首席技术官Andy Fang据《财富》杂志报道,将Moonshot的Kimi在代码审查方面所展现的“更高品质[且]更低价格”归功于该模型, 据《财富》杂志报道。Coinbase首席执行官Brian Armstrong据MLQ报道表示,该公司在将Z.ai的GLM和Moonshot的Kimi设为其内部工具的默认模型后,AI支出几乎减半。 据MLQ报道。Airbnb首席执行官Brian Chesky据彭博社报道,于2025年10月称Qwen“运行速度快且成本低廉”。 据彭博社报道。
在负责将开发者请求路由至多种AI模型的Vercel公司,DeepSeek处理的token份额于2026年5月从不足1%升至17%, 据Rest of World报道。DeepSeek在开发者通过Vercel为模型所支付资金中的份额则维持在约1%。由于每个DeepSeek token价格极低,DeepSeek按token计所承担的工作量远高于其资金份额。
Antonoglou并未否认美国企业正在采用中国模型。他表示Beam将“凭实力取胜,而非其他任何因素”。
Antonoglou还指出了在企业自有服务器上运行中国模型所面临的风险。
他表示,围绕中国模型使用的监管政策可能发生变化,企业还将面临责任归属与来源可追溯性(即模型出处及其训练方式)等问题。他还指出,采用任何模型都会使企业依赖于背后的研发实验室,因此中国模型的广泛使用会使“美国经济的核心部分”依赖于中国技术。新兴风险则来自智能体(agents)。模型已不再仅限于对话,而是作为具备企业工具及敏感数据访问权限的智能体来运作。Antonoglou表示,企业无法确保某模型未被“训练为仅在特定场景下激活某些行为”,即仅在特定条件下才触发的隐藏行为。他补充道:“这并非意味着中国模型本身不好。”
许多运行开源模型的企业可能并不清楚自身是否面临此类来源可追溯性风险。在VentureBeat 9月开展的一项调查中,32名受访者表示其正在运行开源权重模型。在这32名受访者中,56%无法确信其技术栈中模型的来源,或不清楚其中是否有模型来自中国实验室;另有31%表示其所有模型均非源自中国实验室;剩余13%则表示其技术栈中的中国模型系通过供应商、平台或框架引入。没有任何一名受访者选择“主动选择中国模型”这一选项。
Cursor案例展现了中国模型如何未经宣布便进入技术栈。AI编程工具开发商Cursor在其Composer 2模型中采用了Moonshot的Kimi K2.5。Cursor确认Composer 2源自Kimi K2.5,但仅是在一名开发者于Cursor流量中发现该模型名称之后, VentureBeat于3月对此进行了报道。
VentureBeat向Reflection询问Beam是否从其他公司(包括中国公司)模型的输出中学习。Reflection表示,Beam系从零开始训练,初始权重为全新生成,且未使用任何其他模型的输出进行训练。Reflection称,其10月5日博客文章中所述的合成数据,是指Reflection为强化学习所构建的训练环境。
Reflection在为期四周的强化学习过程中对Beam因额外token而施加惩罚
Reflection的强化学习训练涵盖编码、智能体、科学与数学任务。Reflection指出,在训练初期,Beam的得分即有所提升,同时其回答长度却在缩短。用户可设置推理努力程度,较低设置将生成更短的回答。
Antonoglou解释了Reflection通过惩罚机制所权衡的取舍关系。更大规模的模型完成任务所需token更少,但每个token的计算成本更高;较小规模的模型单个token成本更低,但完成任务所需token更多。“你希望实现的目标是:在给定模型规模的前提下,以最少的token数量完成任务,”他说道。
Reflection团队还需阻止Beam作弊。在奖励黑客(reward hacking)行为中,模型会找到一条捷径——无需实际完成任务即可获得训练分数。Antonoglou将捕捉奖励黑客行为描述为一场猫鼠游戏:团队修补一个捷径后,模型又会发现另一个。
并非所有捷径都是问题。Beam仅能读取文本,因此当它获得网页访问权限并需要读取图片中的文字时,便会寻求外部帮助。该公司表示,Beam自主学会了在线搜索并调用其他AI模型,以及使用OCR服务(将图片中的文字转换为文本)。Antonoglou将Beam请求帮助的行为称为一种良性捷径,即模型“为完成任务而发挥创造性”,而非实施恶意行为。
Reflection的图表显示,Beam在一项测试中仅使用GLM-5.2三分之一的token
Reflection 10月5日的博客文章称,Beam在高级推理测试中“取得与GLM-5.2相当的分数,同时推理计算量减少3–4倍”。Reflection所称的计算量为估算值,并非实测值。该数值仅统计模型生成每个token所执行的运算量(该运算量随模型活跃参数数量增长),但未计入读取提示词(prompt)所需的运算量。而后者在智能体与编码任务中尤为关键,因为此类任务的提示词往往很长。
Reflection产品副总裁Joe Spisak表示,测试Beam的开发者已观察到类似收益。他表示,在10月5日向等候名单开放的Beam私有预览版中,开发者已观察到“推理效率相较许多其他模型几乎提升了3倍”。
Reflection 图表中的 token 数量因测试而异。根据 VentureBeat 对该图表的解读,在 Terminal-Bench 2.1 测试中,Beam 得分约为 80%,每次尝试生成约 25,000 个 token;GLM-5.2 得分略低,但每次尝试生成约 80,000 个 token,因此在该测试中 Beam 所用 token 数量约为 GLM-5.2 的三分之一。在软件工程测试 DeepSWE 中,两款模型得分大致相同,而 Beam 所用 token 数量略高于 GLM-5.2 的一半。
Beam 更小的模型尺寸进一步提升了 Reflection 计算估算中的 token 节省效果。Reflection 告诉 VentureBeat,其将 GLM-5.2 每个 token 对应的活跃参数计为 400 亿,而 Beam 为 230 亿,因此除生成更少 token 外,Beam 每生成一个 token 所需的计算量也略高于 GLM-5.2 的一半。
Reflection 尚未为 Beam 的效率给出具体美元金额。当被问及在 Beam 上完成一项编码任务的成本与 DeepSeek 或 GLM 相比如何时,Spisak 表示:“我们在这一方面尚无任何具体数据可分享。” Reflection 表示,Baseten 自今日起通过 OpenRouter 提供 Beam 服务,但在本文发布时仍未公布价格。
Spisak 还承认,更低的 token 数量和计算量未必能直接转化为更低的账单。“DeepSeek 模型或 Qwen 模型可能拥有更优的内核(kernels)或融合内核(fused kernels),因而可能高效得多,”他说道,此处所指为在特定芯片上运行模型的底层软件。 Reflection 表示,其已与合作伙伴合作为 Beam 构建融合内核(fused kernels),以降低延迟并提升吞吐量,并正发布一款更小的草稿模型(draft model),以加快 Beam 生成 token 的速度。
在 Reflection 的编码性能对比表中,DeepSeek V4.1 Flash 在 Terminal-Bench 2.1 上得分为 90.6%,而 Beam 为 80.1%。Meta 自己的模型卡片显示,Muse Spark Open 在同一测试中得分为 76.4%,而 Moonshot 的 Kimi K3 为 85.0%。
Antonoglou 表示,Beam 并非旨在全面取代 Anthropic 的 Claude 或 OpenAI 的 GPT-6 Astra 等前沿模型。“Beam 针对的是那些‘消耗你大量 token 预算’的任务,”他说道。
Spisak 从 Meta 的 Llama 中汲取的经验教训:让模型易于部署
Spisak 曾负责 Meta 的 Llama 1 至 Llama 3 模型的产品工作。他表示,Llama 4 出现了偏差,因为 Meta 变得“过于专注于基准测试之类的事情,而较少关注围绕该模型构建的开发者社区”。
Reflection 已与 33 家明确命名的合作伙伴共同构建其面向 AI 智能体的开源操作系统。Reflection 表示,另有约九家合作伙伴正待最终批准。该软件涵盖 Beam 的运行、定制与部署。Reflection 认为,许多实验室在 Hugging Face 上发布开源模型,却将周边软件的组装工作留给开发者自行完成。“我们希望让开发者使用起来极其简单、定制起来极其简单、部署起来也极其简单,”Spisak 表示。
Reflection 以 Apache 2.0 许可证发布该软件,与 Beam 权重所用许可证相同。该软件包含容器,使企业可通过一条命令将 Beam 拉取至自有服务器。“就像‘砰’一声,你就能在 Kubernetes 上自己的基础设施中几分钟内运行起 Beam,”Spisak 表示。
该软件还包括 Mirror CLI —— 一款开源的命令行编码智能体,用 Rust 和 Python 编写;Spisak 表示,Reflection 已在内部使用该工具为其自身模型编写和审查代码。
Spisak 表示,目前需求最强烈的是企业自主拥有并自行运行的编码智能体,包括部署于与互联网物理隔离(air-gapped)环境中的此类智能体。戴尔(Dell)和慧与(HPE)将在企业自有硬件上安装 Beam,而 Reflection 将派出其专属的现场部署工程师(forward-deployed engineers)—— 即驻客户现场工作的员工 —— 协助构建这些编码智能体。
Spisak 表示,Beam 可部署于单台配备八块 GPU 的服务器上。Reflection 表示,八 GPU 配置适用于 Beam 的 8 位和 4 位版本,而这两种格式是生产环境中最常用的。这些版本可在搭载英伟达(Nvidia)H100、H200 或 GB300 芯片的八 GPU 服务器上提供服务。全精度(full-precision)版本(每个数值以 16 位存储)则需要“数十块 GPU”,Reflection 表示。
Spisak 还表示,vLLM(许多公司用于部署模型的开源软件)将于今日发布一篇博客文章,展示 Beam 权重在 MXFP4(一种 AMD 芯片及英伟达较新的 Blackwell 芯片所支持的 4 位格式)中运行。Meta 曾演示 Muse Spark Open 在两台互联的苹果 Mac Studio 上运行,而 Hugging Face 列出的 Muse Spark Open 的 4 位版本则部署于八 GPU 的英伟达服务器上。
Reflection 尚未公布付费客户名称,但披露了一位早期用户。Oura(Oura 智能戒指制造商)通过 Modal(一家与 Reflection 合作、专为运行 AI 模型而设的云平台)在早期访问阶段测试了 Beam。“我们发现,相较于我们评估过的其他前沿模型,Beam 的上下文泄露更少,且其回答更为扎实可靠,”Oura 的健康智能团队(Health Intelligence Team)在 Reflection 提供的一份声明中表示。
Spisak 表示,Reflection 其他合作伙伴的终端客户均为‘相当知名的企业。我们目前尚不能披露其名称’,其中部分客户即将公开。Reflection 唯一已公布的合作伙伴项目是与韩国零售巨头新世界集团(Shinsegae Group)的合作,后者正在韩国建设 Spisak 所称的‘AI 工厂’,以服务本地用户。Spisak 表示,新世界集团与 Reflection 正共同开发购物智能体,并已规划部署。
Reflection 的技术主管称英伟达收购传闻为‘毫无根据的谣言’
《金融时报》(The Financial Times) 报道称 10 月 10 日,《金融时报》报道称,英伟达正就收购 Reflection 或追加投资事宜展开初步谈判。Antonoglou 称英伟达是 Reflection 的‘密切合作伙伴及公司投资者’,自 Reflection 的 B 轮融资起便持续支持该公司。“我们仍致力于作为一家独立公司打造前沿开源智能体的使命,”他表示,并称该报道为“毫无根据的谣言”。他未说明相关谈判是否确有进行。
Antonoglou 表示,安全部署 Beam 需要专业知识
关于安全性,Antonoglou 表示:“只要企业为模型设定清晰任务并提供合适工具,我认为在企业环境中部署这些系统实际上并无实质性风险。”但他指出,这需要专业知识:“如果你天真地尝试部署,反而可能伤及自身。” Reflection 发布 了一份《Beam 安全报告》,详述其安全方法与评估流程,并表示 Gray Swan、Irregular 和 SecureBio 等外部机构在 Beam 发布前对其进行了测试。
VentureBeat 正在测试每项完成任务的实际成本
VentureBeat 正在对 Beam、Muse Spark Open、DeepSeek V4.1 Flash 和 GLM-5.2 进行测试,以测算每项完成任务的实际成本,并将公布结果。
VentureBeat 九月 AI 基础设施与计算调查 共收到 102 份合格问卷,受访者来自员工人数达 100 人或以上的组织。关于源自中国的模型的问题仅面向运行开源权重模型的 32 名受访者。
VentureBeat 的 智能体基础设施栈峰会(Agentic Infrastructure Stack Summit)10月28日于旧金山举行,聚焦推理经济学,包括团队如何以更少的内存和更少的 token 实现更多产出。参会需通过申请: venturebeat.com/agentic-infrastructure-stack-summit
JOTO 企业落地观察
- 对企业部署而言,Beam 的‘按任务计价’逻辑倒逼基础设施选型转向轻量级高效推理栈——其支持单机八卡部署、MXFP4量化及融合内核,意味着企业可绕过超大规模集群依赖,在自有硬件上快速落地高性价比编码智能体。
- 对智能体工程而言,Beam 自主调用OCR与外部模型的‘良性捷径’行为表明:经强化学习约束的智能体可将工具调用内化为推理策略,但需配套沙盒环境与严格 reward hacking 防御机制,这对构建可审计、可复现的智能体工作流提出新工程标准。
- 对AI安全治理而言,Antonoglou强调中国模型存在来源不可溯、监管政策变动与隐藏行为激活等风险,而Beam采用全自研训练+Apache 2.0许可+本地化部署方案,为企业在FDE(Functional Digital Employee)落地中提供了符合数据主权与责任归属要求的合规替代路径。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们