谷歌Dream-RSI:通过‘梦境回放’将发现智能体调用减少至1/162
谷歌联合多机构提出Dream-RSI,构建结构化‘历史发现树’,使智能体无需重复执行即可回放、评估与优化探索策略,在GPU核函数、数学优化等任务中显著降低调用次数与计算开销,同时保持或提升发现质量。
团队持续 消耗数以万计的token 以及智能体调用次数,以优化探索循环——而谷歌研究人员指出,其中大量支出流向了此前已失败的路径。他们的解决方案是让智能体通过“梦境”方式遍历这些循环,从早期尝试中学习,从而指导未来的搜索。 他们将其命名为Dream-RSI,并且 在他们的测试中 其所需的发现智能体调用次数最多比现有发现系统SimpleTES少162倍。
该系统构建于一个轻量级编排层之上,可在不更改底层编码智能体的前提下控制分支、并行探索及终止决策。探索过程是“显式且可编程的”,系统可在无需反复调用昂贵的在线重运行的情况下评估并优化策略。
在多个领域中,Dream-RSI在显著降低计算成本的同时,匹配或提升了发现质量。
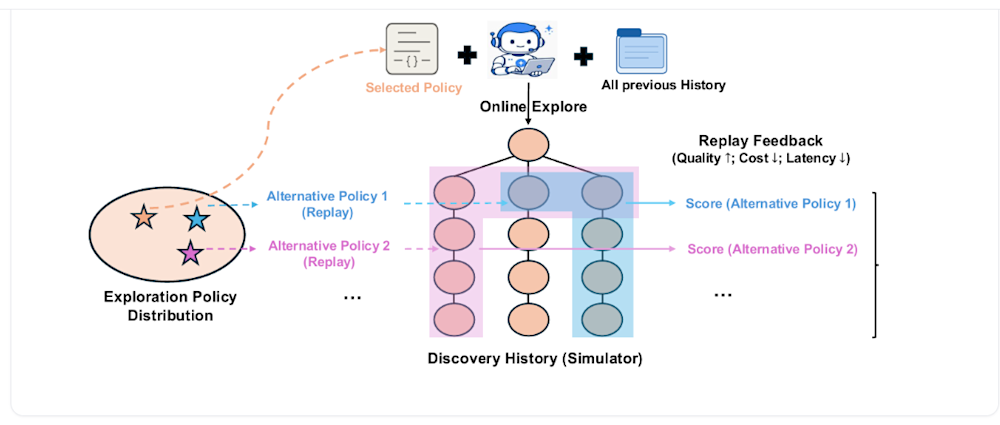
研究人员解释道:“由于所有执行结果均已保存在树结构中,评估一项新策略仅需读取过往记录,而无需重新运行底层发现智能体或评估器。”
这项研究发布于 达里奥·阿莫代伊(Dario Amodei)于9月12日发表题为《我们必须放慢前沿步伐》(“We Must Pace the Frontier”)的论文之后数日。 这家Anthropic联合创始人的文章将递归式自我改进(Recursive Self-Improvement, RSI)列为改变其关于是否应放缓AI发展立场的两项进展之一,因其可能导致AI变得过于强大而超出人类控制能力。
但这一基于基准测试结果的新实验,凸显了阿莫代伊等人所警示的生存性威胁与自我探索智能体循环更狭义、更务实的应用之间存在的差距。
构建“历史发现树”
RSI的核心在于高效探索——即在何处及何时进行分支、并行运行、截断某条路径——但随着发现循环扩展至数千次迭代,管理该过程可能变得棘手。研究人员在项目网站上写道,探索目前仍是“手工编写且冻结不变的”,而固定策略无法从累积经验中学习,因此开发者持续为此前已失败的路径付费。
他们写道:“低效的探索会浪费大量计算资源和时间,严重限制RSI的效率与可扩展性。”瓶颈在于“元层级反馈”,因其具有延迟性、高成本性,且最终实属不必要。开发者实际上是在重复生成自己早已付费获取过的反馈。
这支由谷歌、谷歌DeepMind、马里兰大学及弗吉尼亚大学共17名研究人员组成的团队主张,发现过程应被表征为一种结构化的“历史发现树”,其中包含每个智能体决策及其对应结果。这使模型得以选择下一步要探索的路径,而无需 重新运行任何内容。
研究人员写道:“它以不同顺序遍历同一份已记录的树,而它所请求的每项结果均已存于磁盘。”该系统可在无需额外执行的情况下筛选数千项过往发现,并为部署选出最优方案。这实质上创建了一个基于先前积累搜索历史的“回放模拟器”。
重要的是,由人类设定的探索策略决定了智能体的搜索位置、哪些尝试应并行运行,以及探索应在何时终止。
Dream-RSI分三个阶段运行:“在线探索”阶段,策略引导智能体构建发现树并记录历史轨迹;“构建回放模拟器”阶段,将该树及其轨迹添加至一个可复用的存储库;以及“基于梦境的策略优化”阶段,智能体本质上构想出替代性策略。
智能体进行探索,按需扩充其发现树,重写策略,对各版本评分,然后重新部署最优选项。每一圈“新增一个世界”:获胜策略回归线上,以构建新的发现树。
研究人员写道:“那段历史一直就在那里;先前的工作只是将其解读为别的东西——静态文本上下文用于提示,或训练数据用于微调权重。”
作者认为:“历史即是用于‘梦境’的世界。智能体已构建的发现树,正是其所抵达搜索空间的精确模拟器。”模型通过“梦境”实现改进,并通过“想象”而非反复亲历来测试新的探索策略。
他们写道:“模拟器即任何能在不运行真实世界的情况下回答‘倘若……将会发生什么?’之问的事物。”
Dream-RSI在关键基准测试中的表现
在一系列算法、GPU核函数及数学优化任务的连续发现轮次中,研究人员发现,Dream-RSI所习得的探索策略能自适应地调整计算资源使用,在减少智能体调用次数的同时,产出优于现有方法的结果。
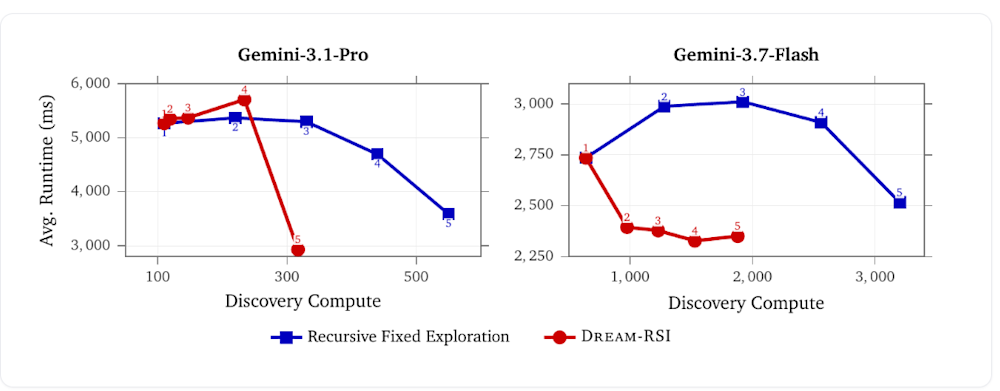
在Lasso发现测试中——此类测试向智能体提供编码与优化问题——Dream-RSI在质量与计算开销的权衡上优于递归式固定探索(Recursive Fixed Exploration, RFE)。RFE指AI智能体使用固定编排器探索搜索空间,而非随时间推移而自适应调整。
CleoPtolemy由Midjourney生成
使用Gemini-3.1-Pro时,Dream-RSI将六个数据集的平均运行时间从3587.1毫秒降至2931.0毫秒,并将发现智能体调用次数从550次减少至317次。使用Gemini-3.7-Flash时,其将平均运行时间从2516.7毫秒降至2350.6毫秒,并将调用次数从3200次减少至1879次。作为162倍数据对比基准的SimpleTES,运行的是另一种底层模型——gpt-oss-120b,共生成51200次。
研究人员在GPU核工程任务中评估了Dream-RSI,其中智能体需在不牺牲数值正确性的前提下,发现高性能核函数实现。这要求智能体同时围绕内存访问、并行化、算法及硬件特定优化进行推理。因此,该基准测试适用于判断Dream-RSI能否泛化至纯数学发现之外。
在ConvDiv GPU核任务中——该任务评估硬件级机器学习工作负载在显卡上运行的效率——Dream-RSI的表现持续提升,在再次投入计算前,其评估尝试次数从110次减至50次,随后在进展趋于平稳时回升至约90次。
在GPU编程任务VGG16与LayerNorm中,Dream-RSI分别以2.43倍与1.79倍更少的生成次数达到相当性能。在ConvDiv与ConvMax任务中,其在同等预算下实现了2.09倍与1.44倍更高的性能。
研究人员写道:“在由历史发现树构建的回放模拟器内进行‘梦境’,可即时、低成本地获得离策略反馈,用于评估与优化探索策略,而无需重复执行昂贵的在线评估。” 对于那些已大量消耗智能体调用的团队而言,收益来自他们此前已付费生成一次的记录——且 代码已公开。
JOTO 企业落地观察
- 对企业部署而言,Dream-RSI表明已有探索日志可直接转化为低成本策略优化资产,无需新增API调用或模型重训,大幅降低长周期智能体系统的运维成本,尤其利好已积累大量失败路径记录的AI工程团队。
- 对智能体工程而言,该方案将探索逻辑从硬编码策略解耦为可编程、可复用的‘树结构+回放模拟器’范式,开发者只需定义分支/并行/终止规则,即可在离线状态下完成千级策略筛选,显著提升智能体编排层的迭代效率与可维护性。
- 对AI安全治理而言,研究明确区分了阿莫代伊警示的广义RSI生存风险与Dream-RSI聚焦的狭义、可控、历史驱动的探索优化——后者不引入新能力,仅复用已有执行痕迹,为RSI类技术提供了具备审计性、可追溯性与资源边界的务实落地路径。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们