Google 开源 EnvHarness:让训练环境随 AI 智能体能力动态进化
Google 研发开源框架 EnvHarness,通过可编程层动态调整静态训练环境(如起始状态、可见内容、动作约束等),使环境能根据智能体弱点自适应演化。在五项基准测试中显著提升任务完成率与效率,为企业级智能体训练提供低成本、高保真替代路径。
针对编码或网页导航等特定任务训练智能体,需要为其提供可安全练习、失败并改进的环境。但构建此类环境成本高昂,且一旦建成,它们通常保持静态,即使智能体能力不断提升亦是如此。
来自 Google Cloud AI Research 及学术合作伙伴的研究人员开发出一个开源(Apache 2.0 许可)框架,可将这些静态环境转变为能根据使用该环境的智能体之弱点进行自适应调整的环境。
该框架名为 EnvHarness,它在现有环境外围添加了一个可编程层。该层可改变智能体的起始位置、其可见内容、可执行动作以及任务持续时间,同时保持底层环境及其验证器(verifier)不变。
在涵盖软件工程、网页导航、办公任务和具身任务(embodied tasks)的五项基准测试中,从 EnvHarness 环境中学习的智能体在保留任务(held-out tasks)上的表现最高提升了 9 分。在软件工程基准测试中,它们完成任务所需的步骤也少于从原始环境中学习的智能体。
对于企业级 AI 团队而言,该方法提供了一种替代方案,无需持续从零开始构建新模拟器和训练任务:可先采用一个可信环境,并围绕智能体当前的薄弱环节动态重塑该环境。
为何静态训练环境会成为瓶颈
智能体通过与环境交互来学习。对编码智能体而言,该环境可能包含代码仓库、命令行终端和测试套件;对浏览器智能体而言,其运行环境可能是一个网站;对企业自动化智能体而言,则可能是在内部应用的沙箱化版本中运行。
环境负责呈现任务、维护其状态、响应智能体的动作,并判定其是否成功。构建所有这些组件都需要大量工程工作,尤其是当环境需要一个可靠的验证器(verifier)以准确判断智能体是否正确完成任务时。
问题在于,大多数环境在构建完成后即保持固定,不会因所使用的智能体而发生变化。若智能体因未在编辑代码前检查测试而反复失败,该环境并不会自动创建迫使智能体练习该项技能的情境。而一旦智能体掌握了现有任务,模拟器便大幅降低效用,进一步提升智能体的可能性也随之减弱。
随着智能体能力提升,发现真正有价值的边缘案例(edge cases)也愈发困难。“随着智能体能力提升,真正具有挑战性的环境在该固定空间内会变得极为罕见,因此团队不得不呈指数级增加环境采样量,才能找到有意义的边缘案例,”Google 研究科学家、该论文共同作者王梓峰(Zifeng Wang)向 VentureBeat 表示。
解决此问题的一种方案是利用人工智能生成更多环境。
例如, GenEnv 是一个框架,它使用大语言模型(LLM)作为模拟器,生成状态转移、观测结果及成功信号,同时力求使任务难度始终贴近智能体能力极限。另一种技术是 Agent-World,它通过程序化方式合成可执行工具、数据库和任务,以构建新环境。
但生成环境本身也会带来新问题。这些流水线(pipelines)往往与特定领域强绑定,且生成的环境需经正确性校验。充当模拟器的 LLM 可能产生错误的状态转移或漂移的反馈信号;而从零开始合成的可执行环境则可能包含逻辑错误。
生成更多环境也未必能解决适应性问题。王梓峰指出,若这些环境仍源自固定分布,团队最终可能只是以一个静态资源池替代另一个。随着智能体能力提升,有用的训练样本再次变得难以寻获。
EnvHarness 如何使环境具备可编程性
EnvHarness 采取了不同路径:它不生成新环境,而是改变现有环境向智能体呈现的方式。
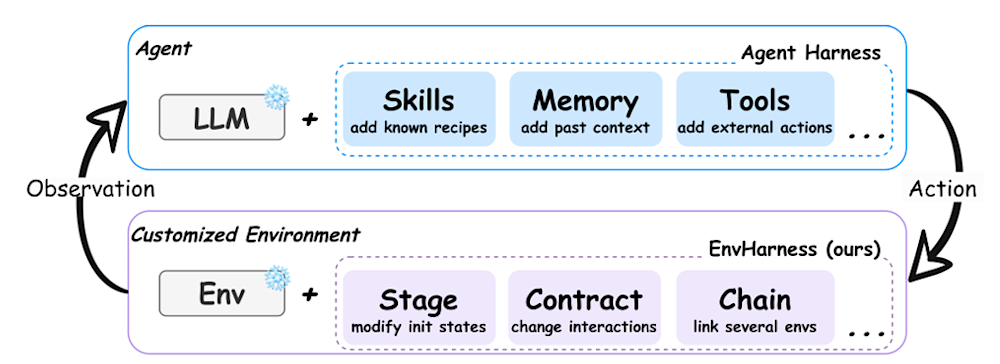
智能体封装器(agent harness)vs EnvHarness(来源:arXiv)
研究人员将 EnvHarness 类比为 智能体封装器(agent harness)——即围绕大语言模型(LLM)添加工具、记忆、上下文管理及执行循环的软件层。
简言之:
智能体 = 模型 + 智能体封装器(agent harness)
EnvHarness 将相同理念应用于交互的另一端:
定制化环境 = 静态环境 + EnvHarness
智能体继续通过原有接口进行交互。EnvHarness 位于智能体与环境之间,在不修改模拟器本身的前提下重塑训练体验。
该框架提供三个组件。
一个 阶段(Stage) 用于更改环境的初始状态。例如,ALFWorld 基准测试中的一项任务要求智能体将一只干净的马克杯放置于桌面上。该马克杯通常初始即处于视野范围内;而一个 Stage 可先将其置于关闭的抽屉内,从而迫使智能体必须搜索后方能完成任务。Stage 亦可反向操作,预先完成任务早期部分,使训练聚焦于后续步骤。
一个 契约(Contract) 用于更改交互本身。它可过滤动作、修改响应或控制智能体所见内容。在上述同一任务中,Contract 可更改房间描述并删减部分细节,迫使智能体需经多个步骤收集信息;或移除导航捷径,迫使其逐个房间搜索。
一个 链(Chain) 将多个任务串联起来。例如,在将马克杯放上桌面后,智能体可能被要求加热一个土豆并将其置于台面上。此时成功需完成两项任务,由此形成更长的任务轨迹,智能体须在此过程中维持目标并合理分配动作资源。
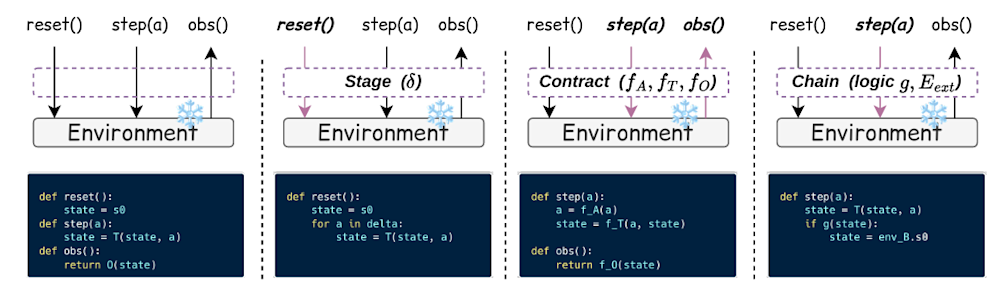
EnvHarness 各组件示意图(来源:arXiv)
该框架另一部分 EnvRigger 则自动化决策过程,依据智能体的薄弱环节确定 EnvHarness 应如何修改环境。
EnvRigger 遵循“观察 → 诊断 → 编写 → 验证”循环。首先,它多次运行智能体,并分析其成功与失败的轨迹,识别重复出现的失败模式;随后基于分析结果,编写旨在暴露或纠正这些失败的 EnvHarness 组件,并运行新的轨迹以检验所做修改是否生成了有用且可解的训练样本。
王梓峰以一个编码智能体为例:该智能体走捷径,在未运行测试的情况下直接提交补丁。“当系统发现智能体采取草率捷径(例如未运行任何测试即提交代码补丁)时,便会自动生成插件规则,拦截该过早提交行为并返回警告,强制智能体首先正确运行整个测试套件,”他解释道。
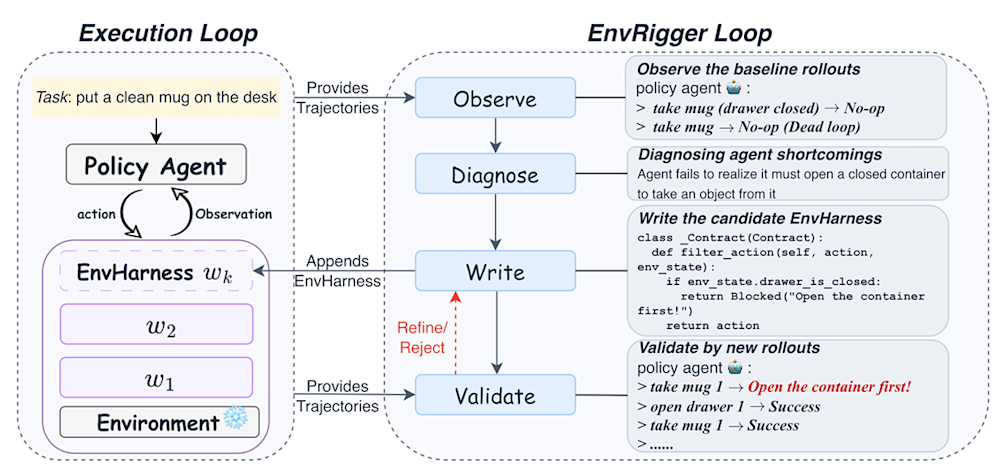
EnvRigger(来源:arXiv)
关键细节在于,该插件改变的是智能体运行所依赖的条件,而非底层任务本身或其评分器(grader)。
在此示例中,源代码仓库和人工编写的单元测试均保持不变。Contract 从外部阻止了过早提交,但原始测试仍决定补丁是否正确。此举在赋予智能体新行为以供练习的同时,保留了受信任的验证器。
EnvRigger 在保留其修改前也会验证这些修改。在论文的实验中,基础循环始于原始任务的五次 rollout 和候选修改的五次全新 rollout。若候选修改使任务变得不可解、过于简单,或以其他方式未能产生有用信号,EnvRigger 可修订该修改并运行更多轮验证,最多执行五轮“写入-验证”迭代。
EnvHarness 实际运行效果
研究人员在 ALFWorld、WebArena、SWE-bench Verified、OfficeQA 和 SpreadsheetBench 上测试了 EnvHarness。
在主要实验中,他们从环境中收集轨迹,并从中提取可复用的技能。从 EnvHarness 环境中习得的技能在全部五个基准测试中均优于从未经修改的环境中习得的技能。
在 SWE-bench Verified 上,除准确率提升外,使用 EnvHarness 进行训练还使平均轨迹长度从 55.01 步缩短至 49.61 步。
EnvHarness 与专为生成训练环境而构建的系统相比也表现更优。在 SWE-bench Verified 上,其性能比 SWE-smith 高出 2.46 个百分点,同时每集所需步数减少 5.11 步;在 ALFWorld 上,其平均性能比 GenEnv 高出 5.7 分。
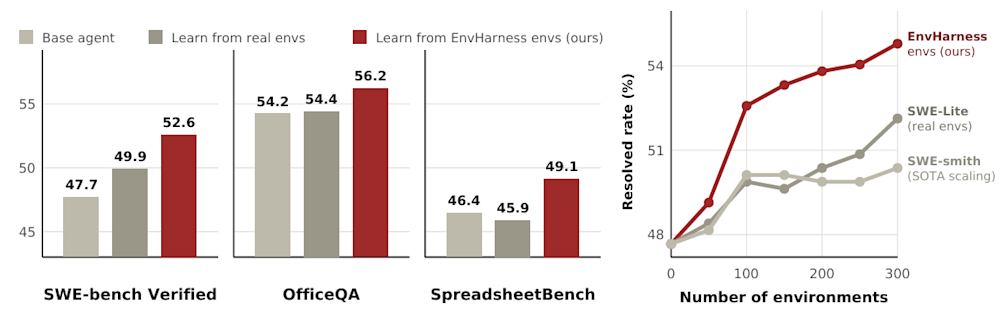
EnvHarness 在行业基准测试中的性能(来源:arXiv)
当研究人员反复运行适应循环时,一个更有趣的结果显现出来。每个新的 EnvHarness 批次均针对智能体在学习前一批次后所具备的能力进行设计。例如,在编程环境中,早期轮次暴露的是基本问题,如运行测试和编辑文件;后期轮次则暴露出不同弱点,包括测试运行器损坏、资源限制以及正确解析 Python 解释器等。
论文中的扩展性实验展示了这种适应的效果。在 SWE-bench Verified 上,基础智能体起始准确率为 47.67%,随着 EnvHarness 训练池扩大至 300 个环境,其准确率升至 54.79%。从相同数量的原始环境中学习达到 52.13%,而由 SWE-smith 生成的环境仅达 50.37%。原始环境与生成环境的性能曲线更早趋于平缓,而 EnvHarness 则持续围绕智能体最新能力创建训练环境。
该原理亦可迁移至编程之外的领域。在 WebArena 中,研究人员指定了一个弱点:智能体在未滚动页面的情况下即作答,从而遗漏了折叠区域下方的信息。EnvHarness 创建了一个 Contract,禁止检索操作,直至智能体完成滚动,由此生成的轨迹教会智能体在作答前检查整页内容。
企业采用 EnvHarness 所需条件
EnvHarness 本身并不训练智能体,而是生成另一种学习机制需消耗的经验。
在论文的主要实验中,研究人员使用一种 ReasoningBank风格的流水线,将轨迹转化为可复用的技能。企业部署同样需要将 EnvHarness 与技能或记忆提取、微调、强化学习或其他基于经验改变智能体的机制相结合。
这也使得 EnvHarness 与日益增多的自动修改智能体 harness 的框架形成互补,例如 Self-Harness, HarnessX, DarwinX。
这些技术通过改进智能体的规则、工作流、技能或其他支撑结构来改变交互的智能体一侧;而 EnvHarness 改变的是智能体学习所处的条件。“智能体侧的优化无法在真空中发生——智能体内部的规划、反思与决策均由其与外部世界的交互所塑造,”王博士表示,“动态环境约束可迫使经过改进的 harness 直面那些它原本可能回避的行为,或迫使它放弃脆弱的捷径式解决方案。”
尽管研究人员未将 EnvHarness 与自演化智能体框架联合测试,但这些方法作用于技术栈的不同部分,原则上可构成反馈回路:EnvHarness 揭示弱点,智能体侧系统改进 harness,随后 EnvHarness 围绕更新后的智能体生成新挑战。
存在两项主要实现成本。第一项是将现有环境与 EnvHarness 集成。团队需编写一个 Bridge,通过框架通用的 ActionableEnv 接口暴露该环境。论文已包含若干类型运行时的 Bridge,包括基于 Docker 的 SWE-bench、OfficeQA 和 SpreadsheetBench 环境。
对于容器化软件工作流,王博士表示集成可置于环境本身之外。“企业 CI/CD 流水线通常在隔离的 Docker 或 Kubernetes 容器内运行环境,而 EnvHarness 仅作为轻量级外层插件附加于现有测试运行器之上,”他指出,“对于已暴露所需重置与步进(reset-and-step)交互模式的环境,这意味着团队可保持容器镜像、代码库及内部单元测试不变,而 EnvHarness 仅在接口层拦截命令。”
第二项成本是算力。“EnvHarness 的权衡更多在于计算层面而非架构层面,”王博士表示,“运营开销源于 EnvRigger 循环,该循环需多次智能体 rollout 以诊断弱点、生成修改并验证其仍具可解性。”
重置要求也明确了EnvHarness适用的明确边界。它适用于数字沙盒环境,例如编码环境、工具使用模拟和网页自动化测试系统,这些环境中部署成本低廉且状态可快速恢复。应避免直接在具有不可逆副作用或重置成本高昂的系统上运行诊断循环,例如线上生产数据库、真实客户账户或物理机器人。在这些情况下,您需要一个安全的模拟器、测试租户或可恢复的生产环境副本。
Google Research 已在 GitHub 上以宽松的 Apache 2.0 许可证发布了 EnvHarness 代码、实验配置及强化学习(RL)实现。
随着驱动 EnvRigger 的模型不断进步,研究人员预计设计与验证环境修改的成本将下降,因为更强的设计者智能体所需的迭代次数更少。但目标并非淘汰人工构建的环境。王博士将 EnvHarness 定位为一种方式:从数量更少但质量更高的环境中获取更多训练价值,这些环境配备受信任的真值验证器。
‘EnvHarness 并不取代底层环境——它充当这些环境的放大器,’王博士表示,‘尽管人工设计的环境将继续作为基础真值基准,但 EnvHarness 等方法可能提供一条切实可行的路径,以降低开发开销,并从每个环境中获得更高覆盖率。’
JOTO 企业落地观察
- 对企业部署而言,EnvHarness 明确要求将现有环境封装为 ActionableEnv 接口,并依赖轻量级 Bridge 集成——这意味着企业无需重构 CI/CD 容器或单元测试,仅需在接口层拦截命令即可启用动态训练,大幅降低迁移成本。
- 对智能体工程而言,EnvHarness 将环境侧适应性与智能体侧 harness 优化(如 Self-Harness)解耦并互补:它不修改智能体内部结构,而是通过 Contract 等组件强制暴露脆弱行为(如跳过测试提交代码),从而倒逼智能体 harness 进化出更鲁棒的规划与验证逻辑。
- 对 AI 安全治理而言,EnvHarness 坚持‘不改动底层验证器’原则——所有环境改造均在可信真值基准(如人工编写的单元测试)外部施加约束,既保障评估可靠性,又避免 LLM 模拟器可能引入的漂移风险,为高保障场景提供可审计的训练增强路径。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们