AI改图,终于懂点「用户心理学」了
快手技术团队推出电商图像编辑基座模型KwaiMind,融合通用编辑与电商专项能力,在Ecom-Bench评测中视觉总分位居开源模型第一;线上A/B实验显示其带来商品主图点击率相对提升约2.44%。模型采用多智能体数据引擎构建180万对高质量训练样本,并通过专项优化与多教师蒸馏(DiffusionOPD)统一基座能力。
电商图像编辑的新基座
一张电商图片,既要准确展示商品,也要契合用户喜好,更承载着价值转化的商业期待。当图像编辑开始读懂用户偏好,模型能否将不同的创作意图转化为合心意、可使用的电商素材,进一步激发商业价值潜能?
快手技术团队推出 KwaiMind,一套面向真实电商内容生产的图像编辑基座模型。融合通用图像编辑与电商专项能力,在保留商品细节、准确呈现文字的同时,满足多样化创作需求,并配套构建电商任务评测体系,形成从数据生产、模型训练到效果评估与业务反馈的完整闭环。
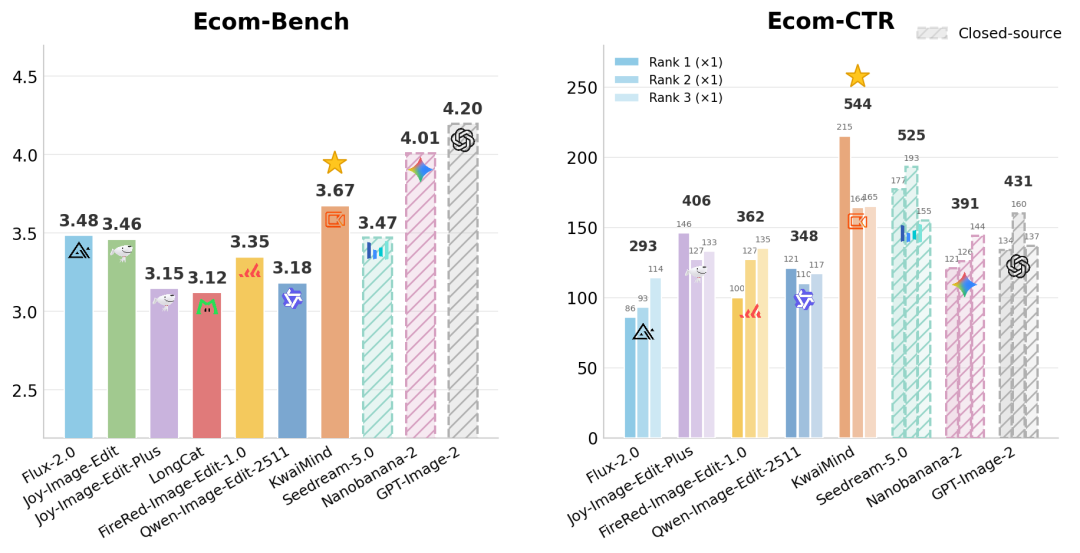
据技术报告披露,KwaiMind 在多项通用图像编辑基准上取得参评开源模型综合得分第一;在自建电商评测 Ecom-Bench 中,视觉总分位居参评开源模型第一。线上商品主图素材优选 A/B 实验中,KwaiMind 带来实际点击率相对提升约 2.44%,展现了电商图像编辑的商业应用潜力。
从通用编辑到定向修复
KwaiMind 将增删、替换、构图调整和局部问题修复纳入同一套指令式编辑能力,支持服装试穿、商品细节展示、配饰佩戴、背景替换、动作调整等任务。商家可以围绕已有素材提出展示需求,也可以针对文字、背景等局部问题进行定向修改。
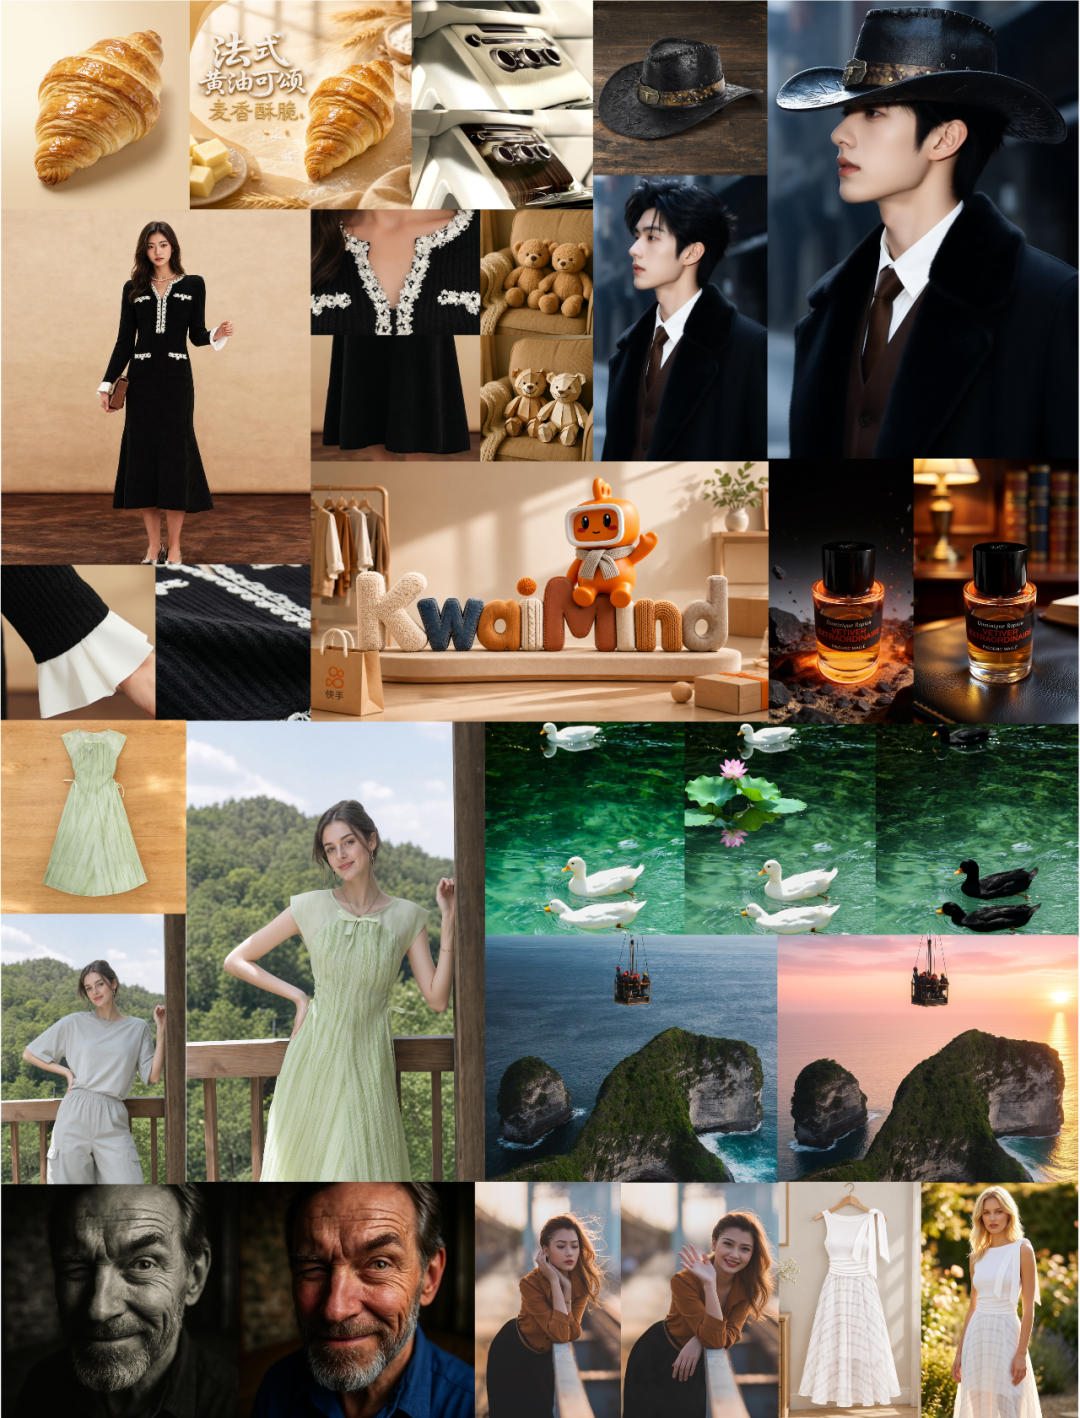
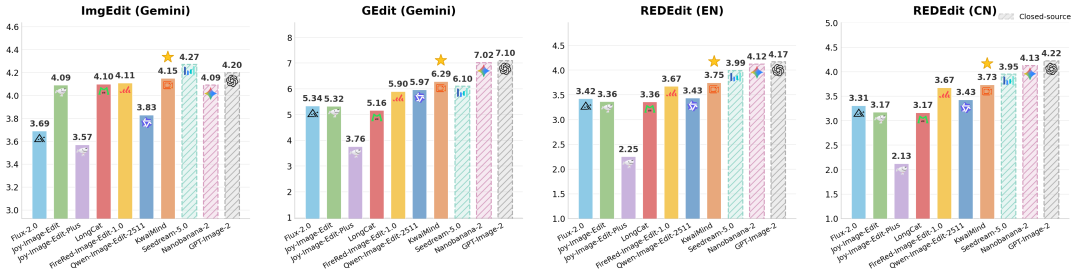
以电商卖点图为例,模型需要根据商品图与编辑指令调整背景和构图并进行文字的渲染,在突出商品视觉表现的同时,保持其外观、材质与关键细节的一致性。这些要求也考验模型的通用编辑能力。KwaiMind 在适配电商场景的同时,也展现出较强的通用编辑能力,在多个通用基准测试中均优于本报告中其他参评的开源模型。
四项智能体协作维护高质量训练数据
电商素材规模庞大、来源多样,既需保障质量,也需适配不同任务。传统流程依赖反复筛选、修改和复核,成本高、效率低,标准也难统一。为此,KwaiMind 构建了多智能体数据引擎,将质量过滤、样本修复、定向补充与指令标注整合为统一流程,实现任务自动流转、样本状态可追踪。四类智能体分工如下:
- Filter Agent:预筛输入图像,复筛编辑结果;
- Generation Agent:根据诊断修复可恢复样本,补充覆盖不足的任务数据;
- Caption Agent:生成不同粒度的编辑指令;
- Coordinator Agent:维护样本状态与分布,统筹任务调度、流程衔接及重试。
系统同时引入Human-in-the-Loop机制,将低置信、高分歧样本交由人工审核,审核结果回流数据生产流程,兼顾处理效率与数据质量。
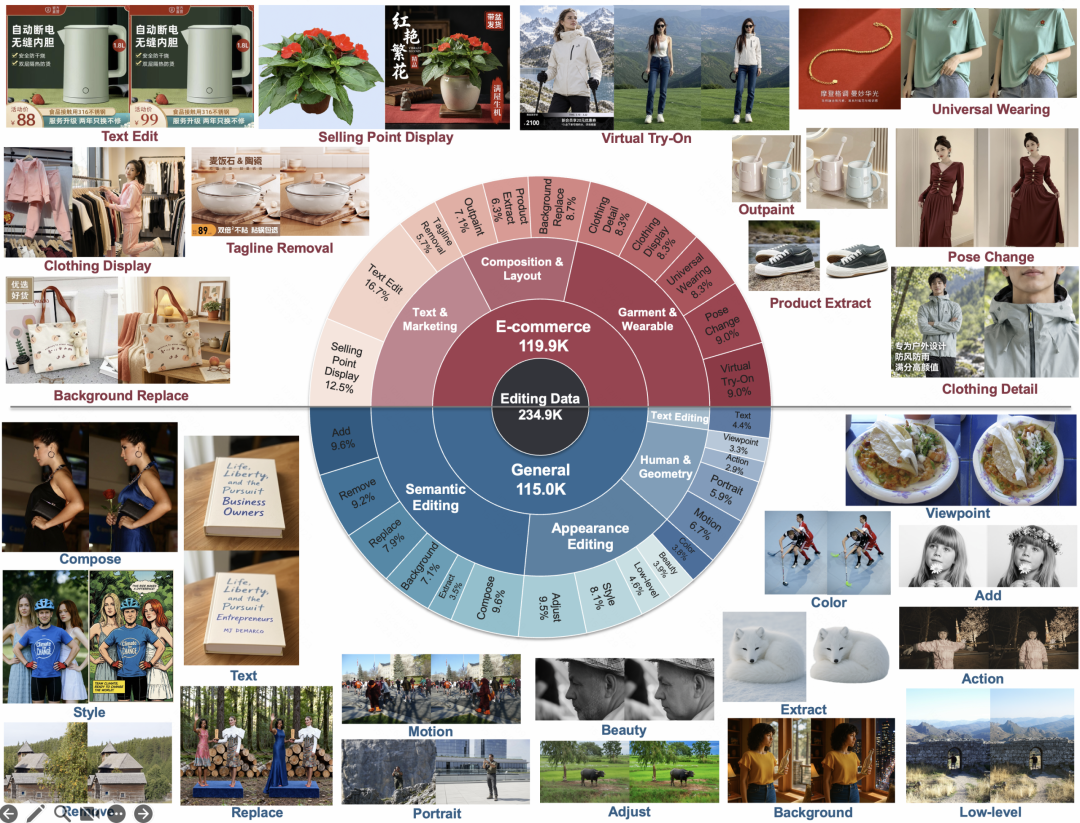
多智能体数据引擎从约 2,620 万对候选数据中构建并维护约 180 万对高质量训练样本,供 Continued Fine-tuning 阶段使用。进一步精选约 23.49 万对数据用于 SFT 阶段,包括 11.5 万对通用编辑样本和 11.99 万对电商样本。通用数据夯实模型的基础编辑能力,电商数据则围绕服装细节、商品展示和文字编辑等强化专项能力,共同提升模型的指令遵循度与图像美观度。
专项优化与多教师蒸馏整合为统一基座
真实电商任务往往要求模型同时做好多件事:执行编辑指令、保留商品细节、写对文字,并生成更能吸引用户关注的画面。这些目标的优化难度和收敛节奏并不相同,直接混合训练可能产生干扰,依次优化又可能遗忘已有能力。
KwaiMind 为此采用了一套结合专项能力优化与多教师蒸馏的训练方案:在通用编辑能力之上,模型进一步强化视觉质量、商品一致性、文字准确性以及商业点击吸引力。再通过 DiffusionOPD 将不同专家的能力汇聚到统一模型。
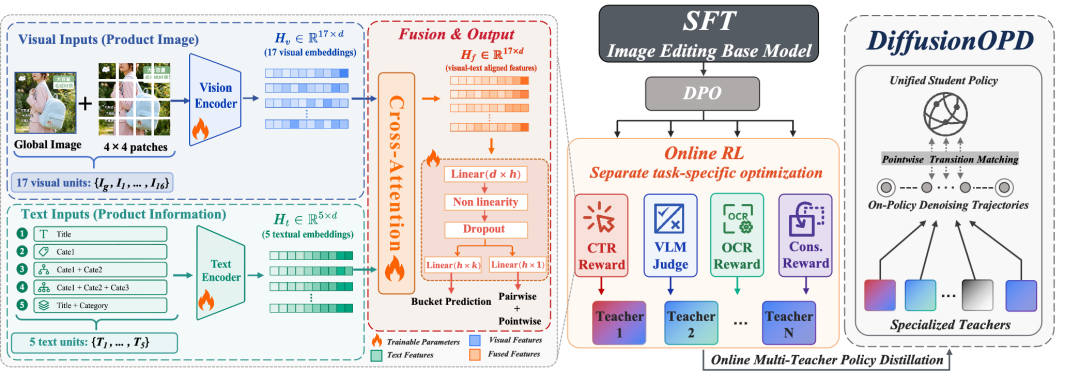
DiffusionOPD 是一种在线蒸馏策略,由教师沿学生的去噪轨迹逐步指导,使能力迁移更贴近学生实际的生成过程。KwaiMind 将通用编辑、文字处理、商品细节保留与用户偏好整合到同一模型中,让一次编辑兼顾多项要求,例如更换背景时保留包装细节与文字,同时生成更符合用户偏好的展示效果。
Ecom-Bench:系统定义电商任务与评测体系
电商图像编辑需要明确的任务边界,也需要一套能够判断素材是否可用的评价标准。
为此,团队构建Ecom-Bench,包含 11 项任务、1,100 个案例,每项任务 100 个案例。这些任务包含了虚拟试穿、服装细节、姿态调整等模特穿戴任务,背景替换、商品提取、卖点展示等海报相关任务,以及文字编辑、宣传语去除等文字任务。
围绕这些任务,Ecom-Bench 建立了由6 个通用维度和 8 个电商专项维度组成的综合评价体系:
- 通用维度关注指令遵循、融合自然度、物理与光照合理性、非编辑区域保留、图像质量及整体美感;
- 电商维度关注检查商品身份、文字准确性、面料纹理、模特与姿态、服装合身度、抠图边缘、卖点传达及商品展示完整性。
每项任务选取 2 个通用维度和 2 个电商维度,按任务需求确定评价重点。下表是具体的任务测评维度分配:
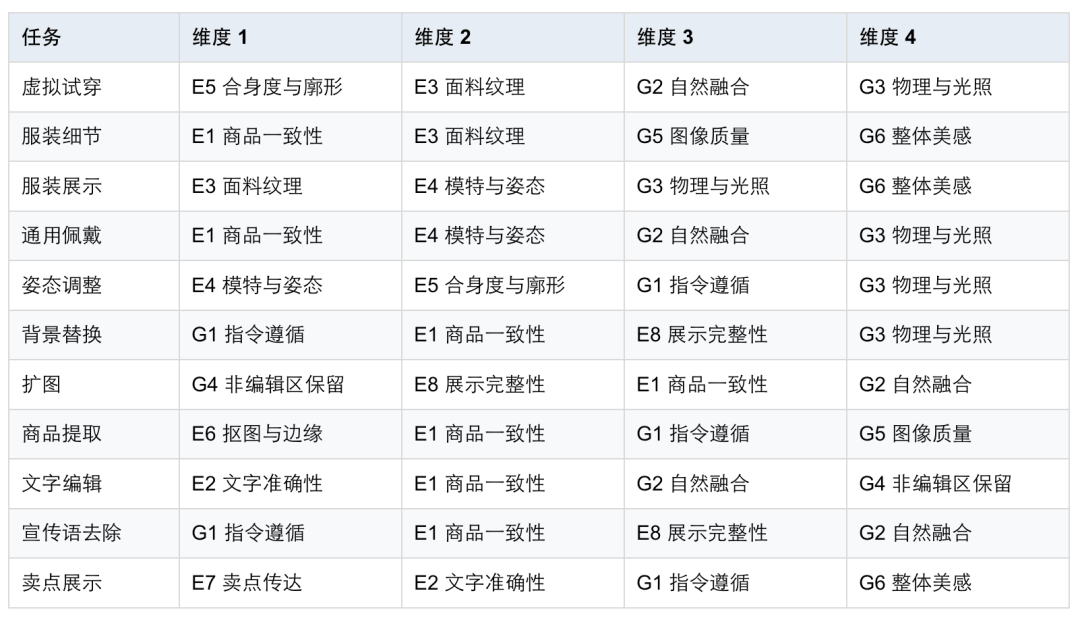
评分时,评审模型会结合参考图、编辑指令和生成结果,按照明确的评分标准,对四个维度分别给出 1-5 的整数分。
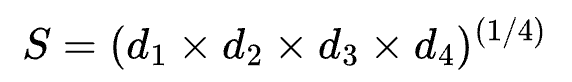
单个案例的综合分采用几何平均计算,使文字出错、商品身份偏移等关键缺陷更明显地影响综合得分,降低单项高分所掩盖的素材可用性问题。各任务得分为该任务 100 个案例综合分的平均值,总分再对 11 项任务等权平均。
如图 1 所示,在报告的评测设置及参评模型范围内,KwaiMind 的 Ecom-Bench 视觉总分位居开源模型第一。除了视觉质量,团队还通过 Ecom-CTR 评估生成素材的预测点击偏好。不同模型的输出进行排序,各模型进入前三名的次数累计为 CTR 分数,以衡量相对商业吸引力。KwaiMind 在这一指标上表现优越,体现了模型对素材可用性与用户偏好的兼顾。
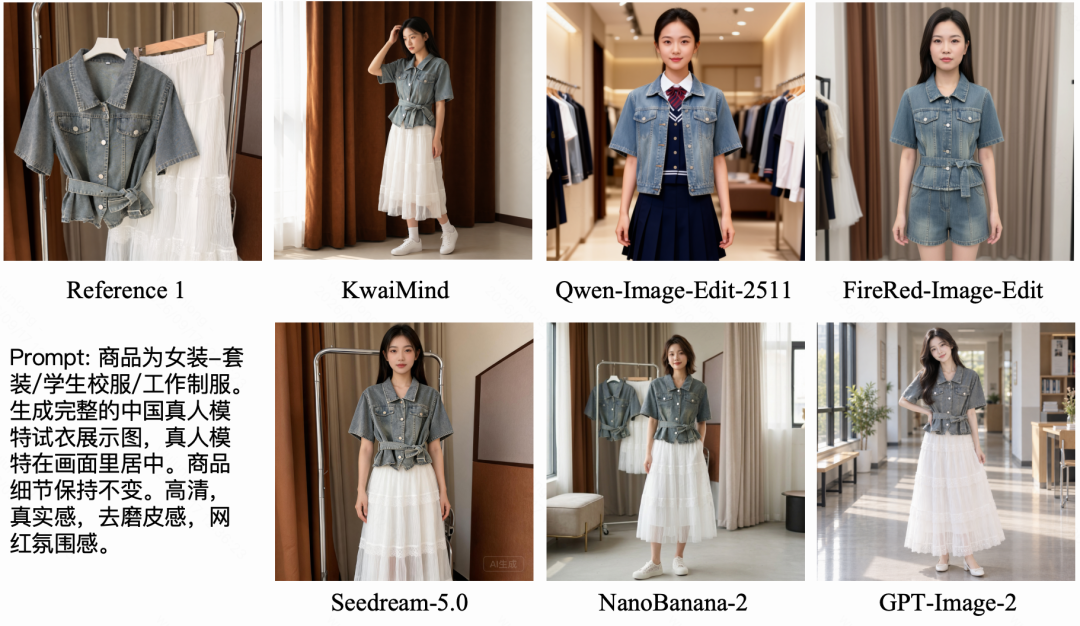
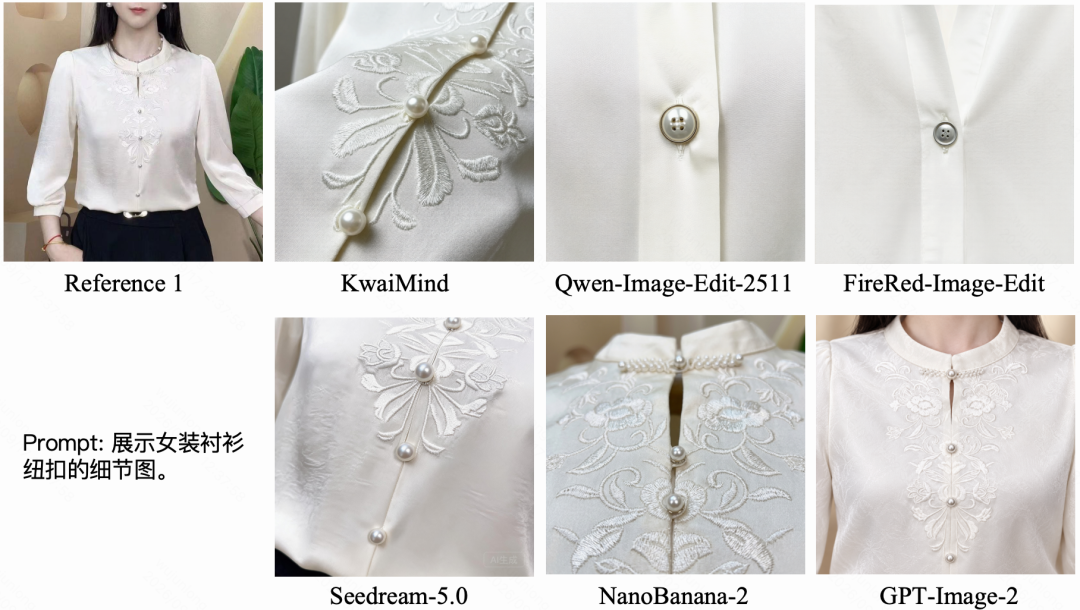
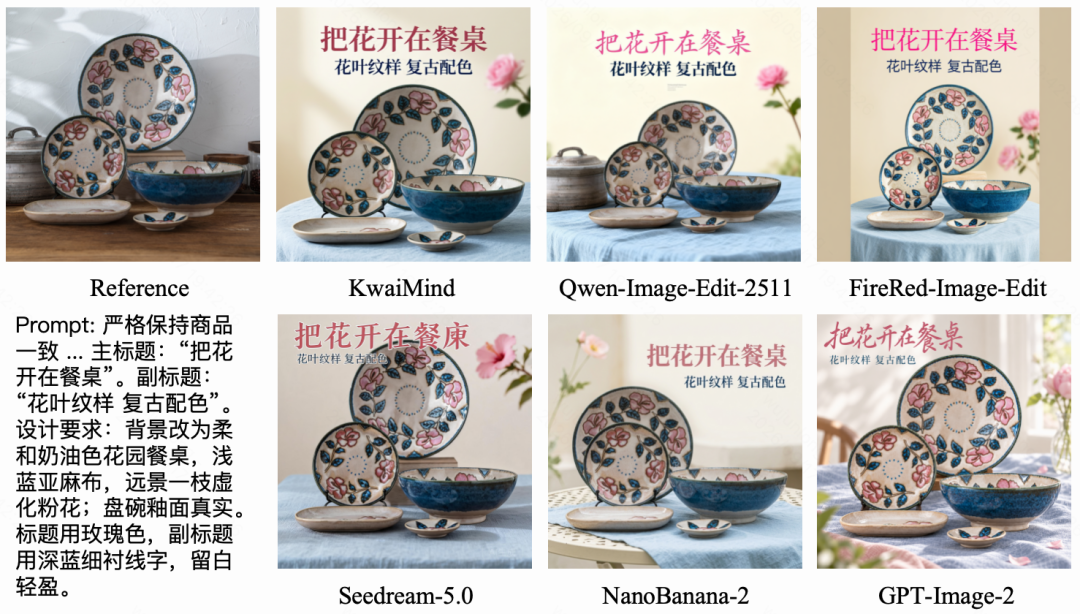
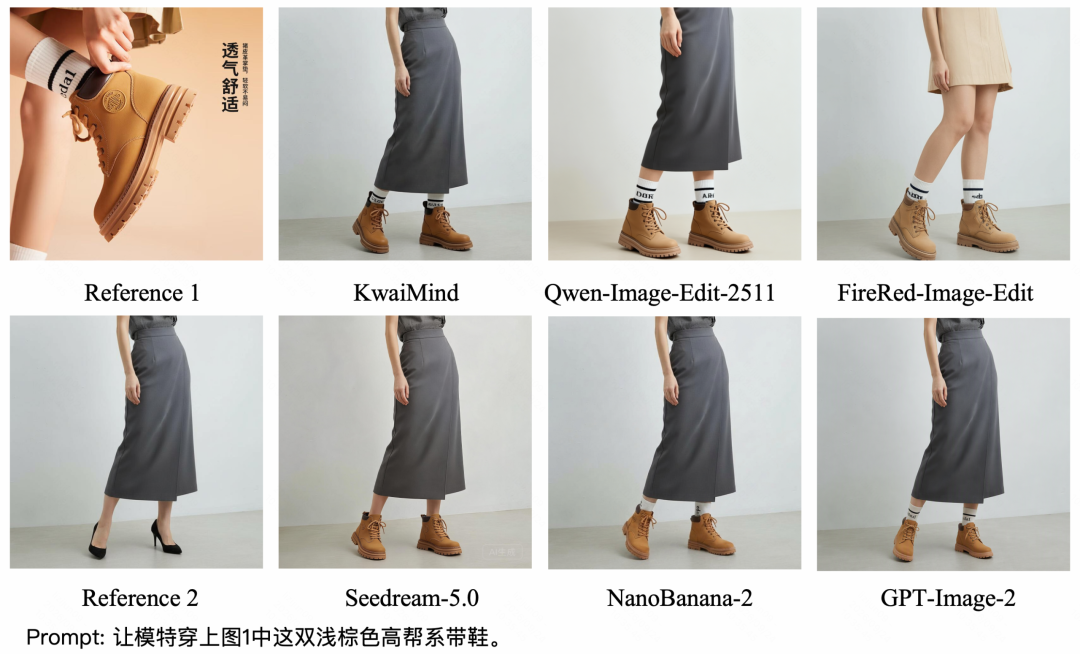
下面是一些可视化对比素材,覆盖卖点展示、服装细节、服装展示和虚拟试穿。结合参考图与编辑指令,可以直观看到不同模型在商品素材生成方面的差异。
业务验证:素材生成到真实点击提升
为了验证 KwaiMind 在实际业务里的应用价值,团队启动了商品主图素材优选线上 A/B 实验。在实验中, KwaiMind 带来了约 2.44% 的实际点击率的相对提升。
在离线评估中,对于随机质量采样的商品图,KwaiMind 生成图的预估 CTR 高于原始商品图的比例,由训练前的 12.16% 提升至 37.41%;相较于未经优化的基线生成图,其预估 CTR 胜率达到 91.89%。
JOTO 企业落地观察
- 电商图像编辑模型若要真正嵌入企业内容生产管线,必须解决“可用性”与“可控性”的双重门槛:Ecom-Bench 所定义的多维评价体系,为企业 AI 图像工程提供了可量化的验收标尺,而非仅依赖主观审美或模糊的“效果更好”表述。
- 多智能体数据引擎+Human-in-the-loop 的设计,揭示了高质量垂域数据生产的典型范式——它不追求纯自动化,而是将人工审核作为闭环中的关键校准节点。这对企业构建自有RAG知识库或微调数据集具有直接参考价值:人机协同的数据治理流程比全自动化更稳健。
- KwaiMind 将商品一致性、文字准确性、用户偏好等目标通过多教师蒸馏统一到单基座,意味着企业无需为不同子任务部署多个专用模型。这对降低智能体工程中的模型运维复杂度、减少GPU资源碎片化有实质性意义。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们