千问上线 Qwen3.8-Omni-Flash:1M 上下文,音频输入价格降幅超98%
9月18日,千问发布原生全模态模型Qwen3.8-Omni-Flash,支持文本、图像、音频与视频输入,上下文达1M。其音视频Agent能力显著提升,在30项评测中平均得分较上一代提升超26%;音频输入API价格降幅超98%,并开源Qwen-Live Harness以优化长程交互效率。
Qwen3.8-Omni-Flash正式上线
9月18日,千问上线新一代原生全模态模型 Qwen3.8-Omni-Flash。它支持文本、图像、音频与视频输入,上下文窗口达到1M,已在千问AI平台开放体验。
聚焦音视频的Agentic能力拓展
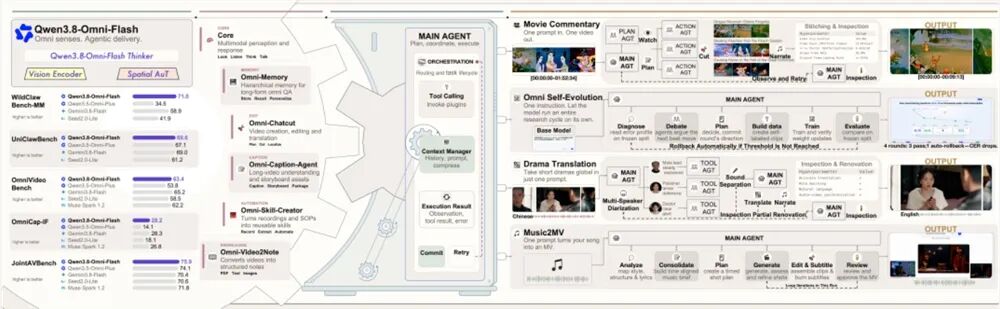
这一代模型在原有的编程、文本知识工作与GUI操作等通用Agentic能力之上,重点拓展了以音视频为核心的Agentic应用,覆盖视频剪辑、MV创作、影视制作与解说、音视频转图文摘要及音视频对话等需要综合处理多模态内容的工作流。
30项评测平均得分提升超26%
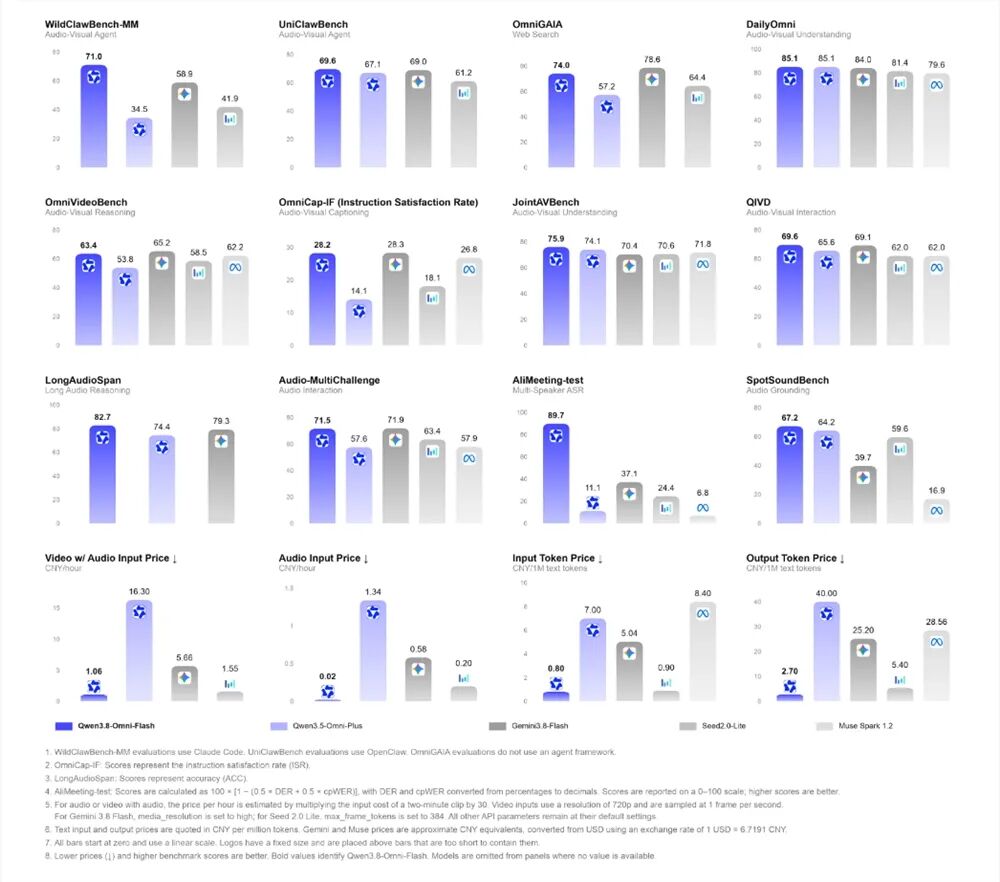
在累计30项评测中,平均得分较上一代 Qwen3.5-Omni-Plus 提升超26%。其中:
- 音视频 Agent、Coding 与长程任务方面,WildClawBench-MM 提升36.5分,AgenticVBench 提升22.3分,UniClawBench 取得69.6分;
- 基础能力上,LongAudioSpan 提升8.3分,OmniVideoBench 提升9.6分,OmniCap-IF 的 CSR/ISR 分别提升8.5/14.1分,AliMeeting 的 DER/cpWER 由88.11/89.61降至3.35/17.18。
音频输入价格降幅超98%,支持实时听声辨位
官方称其音视频能力接近 Gemini3.8Flash,音频能力整体超过后者。API 价格方面,音频输入价格降幅超98%,音视频输入价格降幅超93%。
为了支撑长程工作流与实时交互,千问扩展了 Qwen-MM-Plugins,并开源 Qwen-Live Harness。在 Agentic Understanding 模式下,OmniVideoBench 准确率从63.4升至67.8,Token 消耗从145736降至79117,降幅约45.7%。
团队还把模型用到了研发环节本身:12小时内自主完成评测集选择、数据构建与4轮迭代,累计构建3413条训练数据,将 Qwen2.5-Omni-3B 的四川话识别字符错误率从25.79%降至15.30%,相对下降约40.7%。
同步推出的 Realtime 版本,是首个支持"听声辨位"的全模态大模型。
JOTO 企业落地观察
- 企业部署多模态Agent时需权衡长上下文(1M)带来的工程复杂度与真实业务场景中对低延迟、高吞吐的刚性要求;纯文本Agent已趋成熟,但音视频端到端处理仍面临设备兼容性、实时性与隐私合规三重约束。
- Qwen-Live Harness开源意味着企业可复用其轻量级实时交互框架,但将其集成进现有AI安全治理体系(如输入过滤、输出审计、权限隔离)需额外适配,尤其在音视频流式输入场景下,传统基于文本token的治理策略不再适用。
- 模型自迭代优化四川话识别的案例表明,垂直领域语音能力提升高度依赖高质量方言标注数据;企业若计划构建本地化语音Agent,需优先评估方言数据采集、脱敏与标注的可行性,而非仅关注基座模型参数规模。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们