A\最强Model 4首次曝光!RSI狂飙2倍速
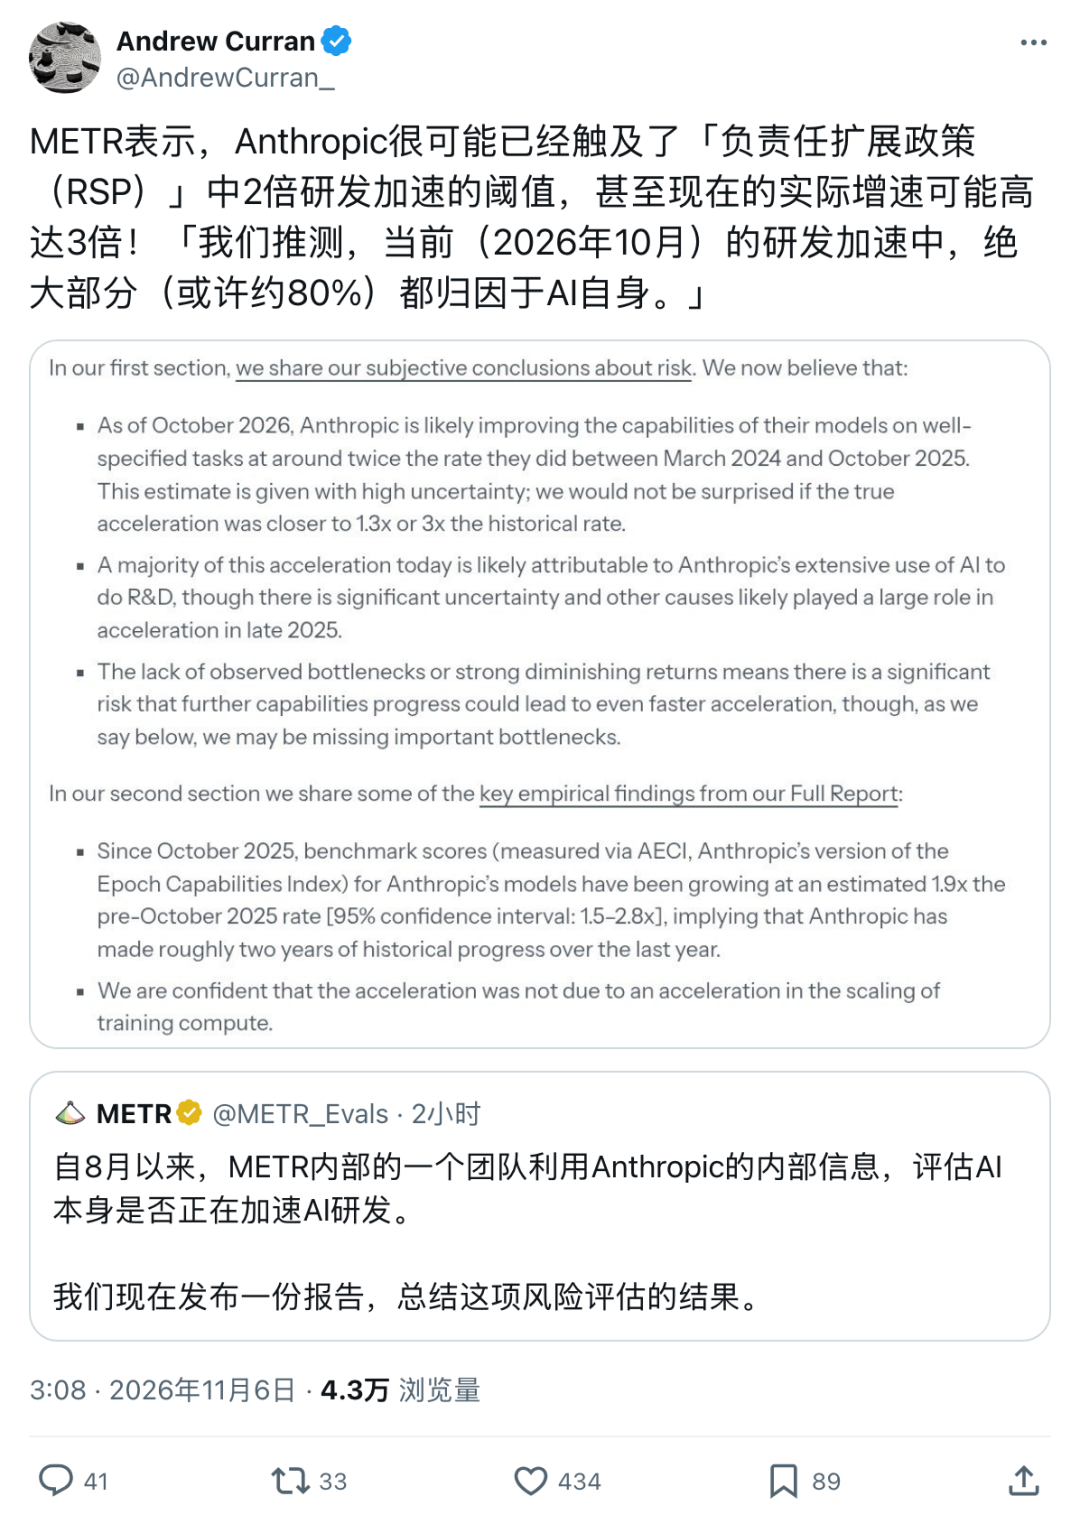
第三方评测机构METR经11周深度调查,确认Anthropic内部未公开模型Model 4于2025年9–10月完成训练,AECI综合能力指数达178.6分,超越Opus 5.5(174.5分);其进化速度自2025年10月起翻倍,年增速达29分,其中约80%推力来自AI自身研发辅助;现有基准测试已难以准确评估其极限。
Model 4正式曝光:178.6分刷新能力上限
Anthropic藏得极深的神秘「Model 4」,曝光了!
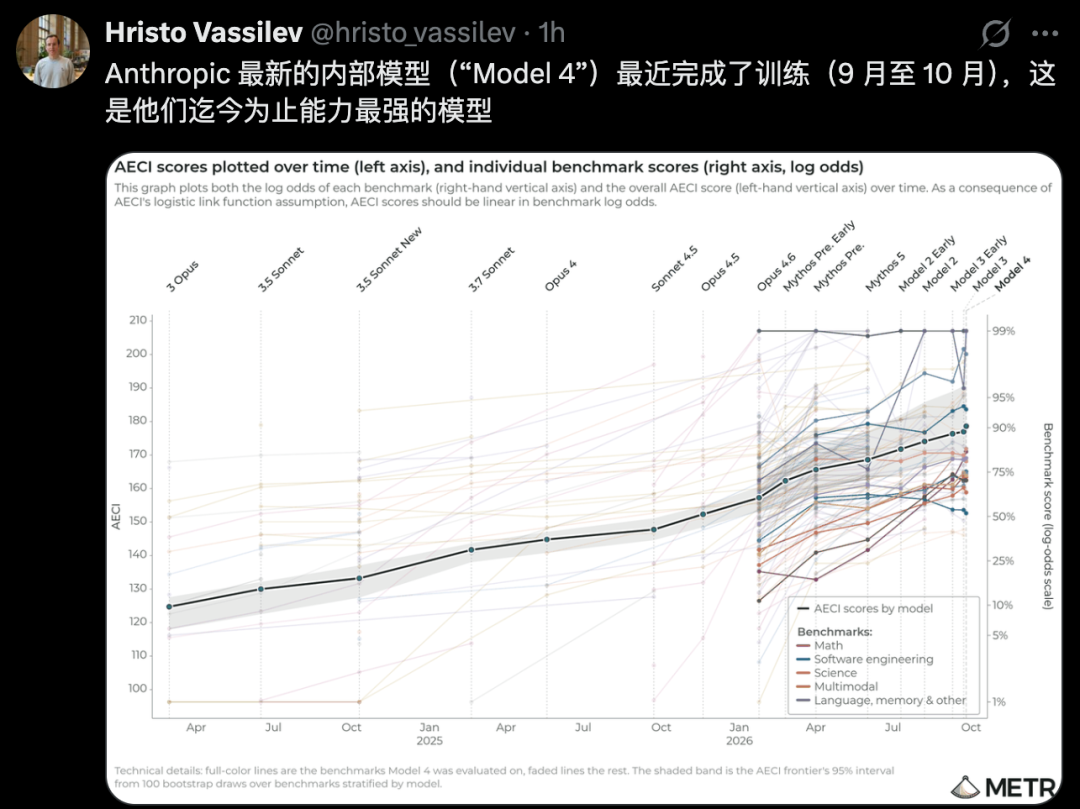
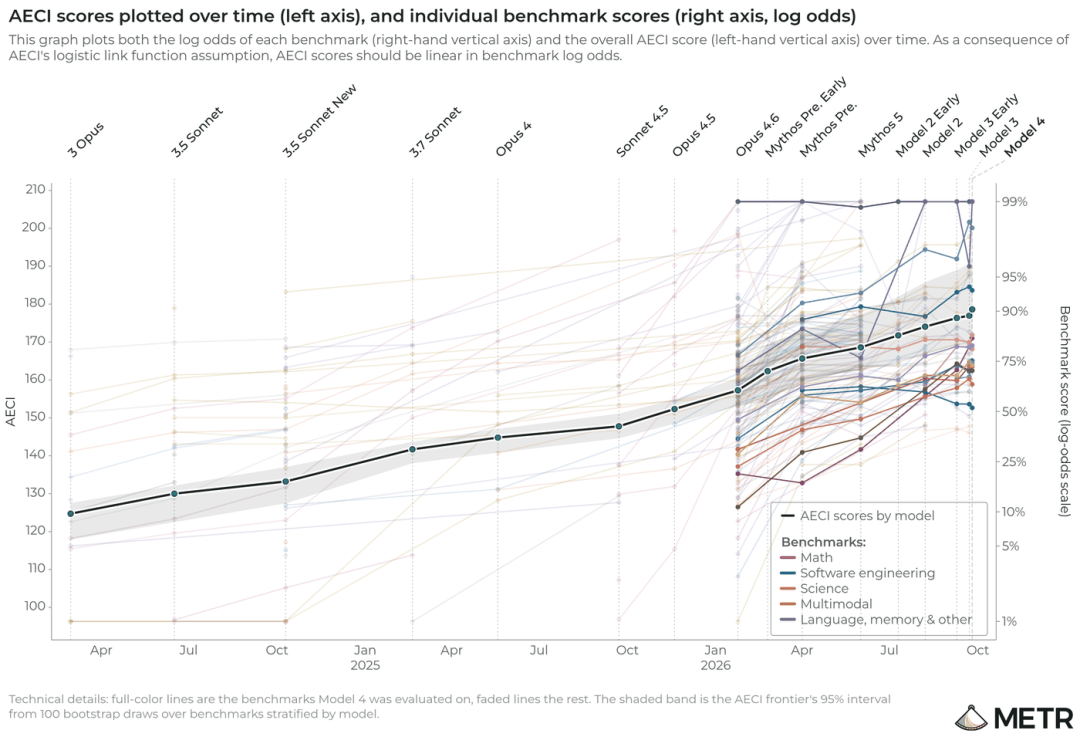
9到10月秘密练完,内部综合能力指数(AECI)直接飙上178.6的逆天高分,现有的考卷已经快要压不住它了。
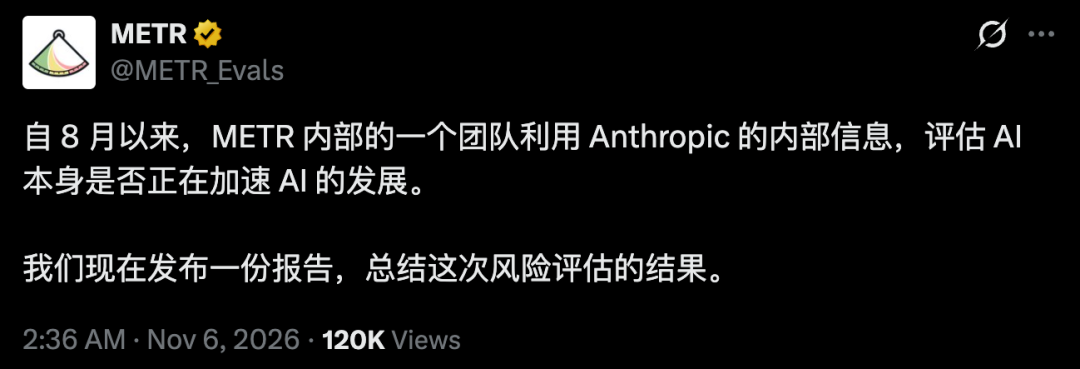
就在今天,第三方评测机构METR甩出重磅调查。
连肝11周,深挖Anthropic内部敏感数据,最后只得出了一个结论——
Anthropic模型的进化速度,已经彻底失控,直接原地翻倍。
报告里最炸的,是这几组数字。
截至10月,Anthropic在明确任务上的能力提升速度,已是2024年3月-2025年10月那段时间的2倍。
转折点,就落在2025年10月。
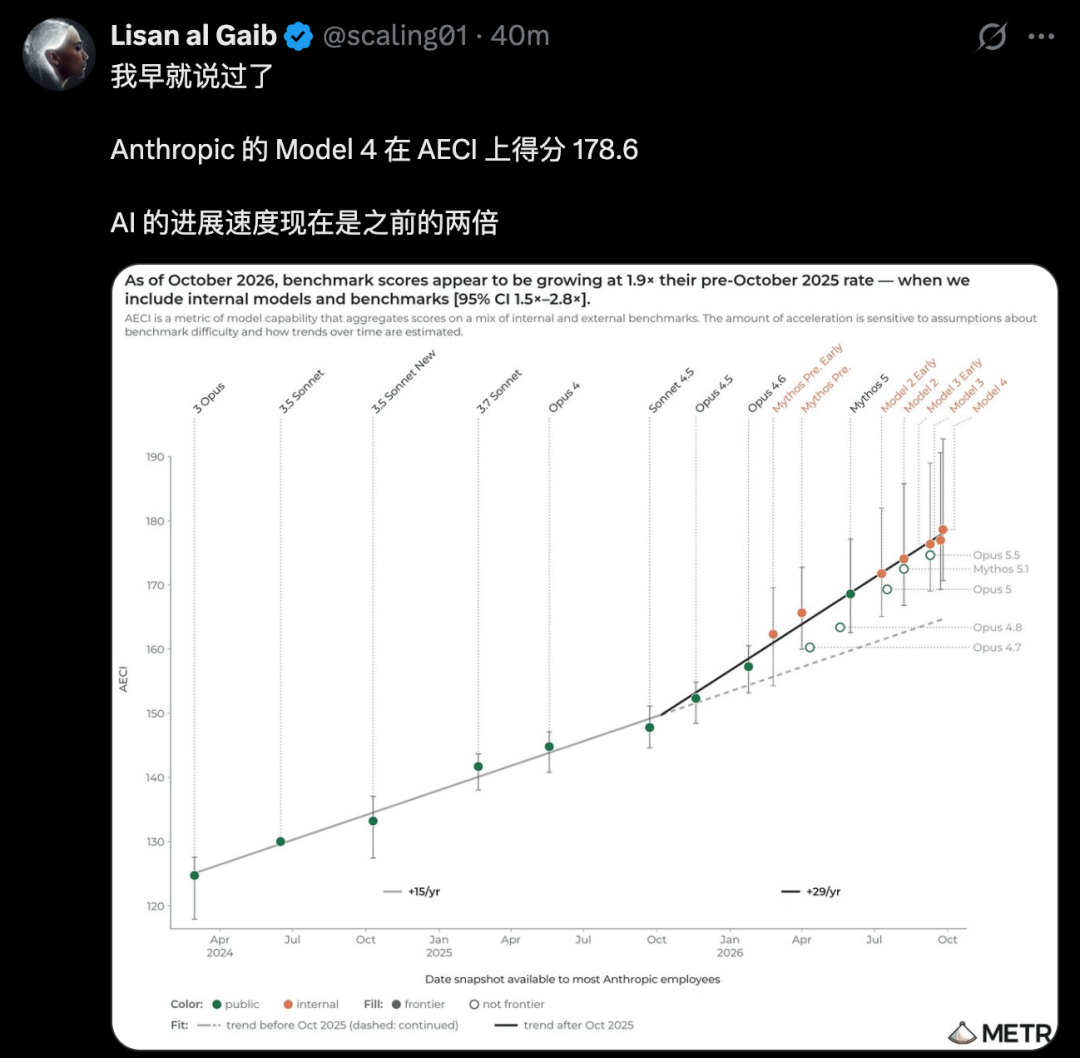
从那以后,内部能力指数AECI的增速直接拉到此前的1.9倍,一年就跑完了过去两年的路。
更恐怖的是,这波狂飙里,80%的推力居然来自AI自己!Claude正在亲手造出更强的Claude。
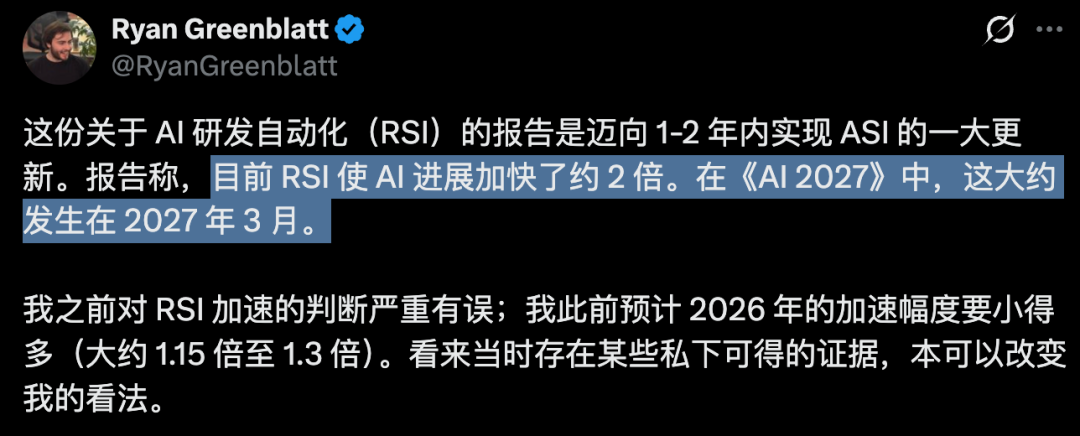
METR研究员Ryan Greenblatt直言,「这份报告就是通向一两年内实现ASI的重磅信号」。
照这个速度下去,「AI 2027」剧本里的ASI,在短短的4个月后就会彻底降临!
四款未公开模型浮出水面
这份报告最抓眼的,就是一连串Anthropic从未公开过的神秘代号。
报告的附录中,METR列出了四款内部未公开模型。
它们分别是2022年练完的「Unreleased 2022」、2026年7月练完的Model 2、8–9月练完的Model 3,以及9–10月刚出炉的Model 4。
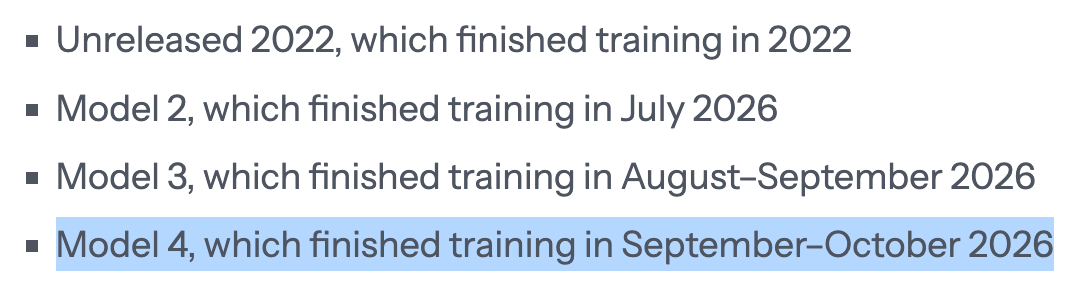
真正把全网点燃的,正是这款上个月刚训完的Model 4。
它在AECI上拿下了178.6分,远超公开模型Opus 5.5(174.5分)与Mythos 5.1(172.5分)。
AECI就像大模型的「高考总分」,把各科基准测试的卷面成绩折算成一个综合段位分。
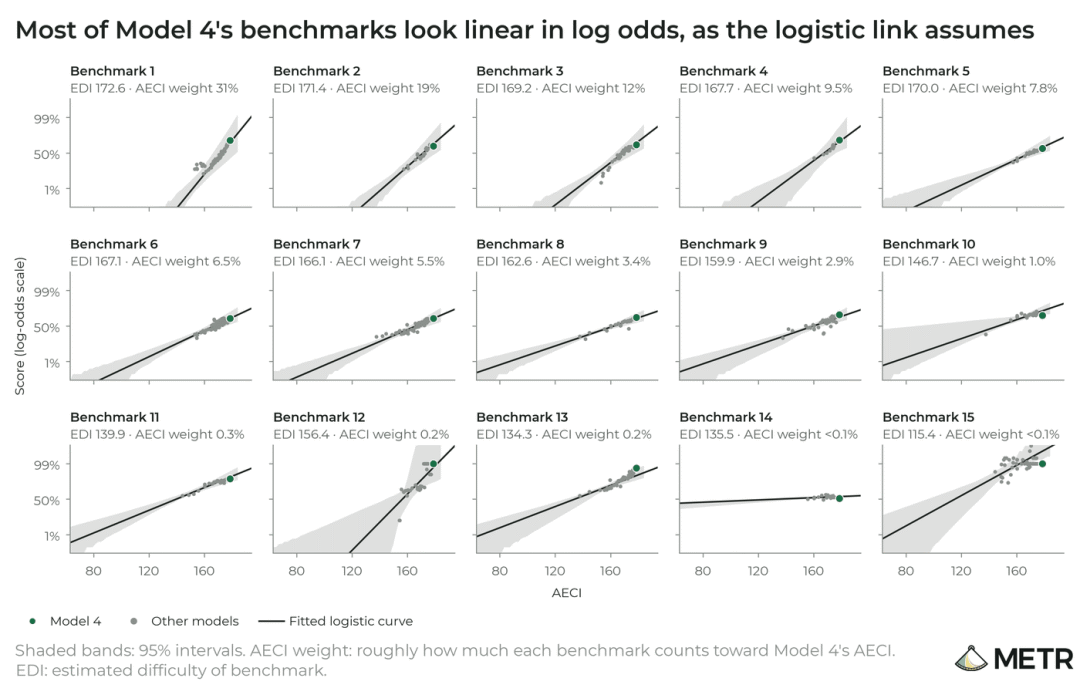
再看单科,Model 4参加的15项基准测试,每一项正确率都过了50%。而就在9个月前,Opus 4.6还有不少基准没能过半。
但这还不是Model 4的真实极限!
METR团队甚至在报告里做了一次「除虫测试」,他们发现15个测试基准里有3个存在长尾过难或题目损坏的凹陷现象。
一旦把这3个干扰基准剔除重新计算,Model 4的AECI得分会进一步跳涨1.1分,冲上179.7分。
甚至在Token消耗量上,Anthropic内部测试也还没有把Model 4的潜能彻底榨干。
跑一次普通基准测试,单个任务平均就要消耗250万输入Token、生成7万多输出Token。
要是让Agent去写代码,单任务直接吃下整整1000万输入Token,输出也拉到9.4万Token。
更让METR评测人员感到棘手的是,现有的考卷已经快要测不出Model 4的极限了。
也难怪Anthropic在IPO前再次更新S-1招股书,专门新增了一条风险提示。
据内部估算,未来的模型很快就会触发「AI显著加速研发」阈值,1年就能干完过去2年的活儿。
2倍加速度:拐点落在2025年10月
Model 4能冲上如此高分,背后是模型进化的速度正在明显加快。
历史性拐点,停在了2025年10月7日。
在这条分界线之前,Anthropic模型的AECI得分每年大约上涨15分。
从2025年10月开始,这条曲线的走势直接猛拐向上,变成每年大涨29分,增速达到过去的1.9倍(95%置信区间在1.5倍到2.8倍之间)。
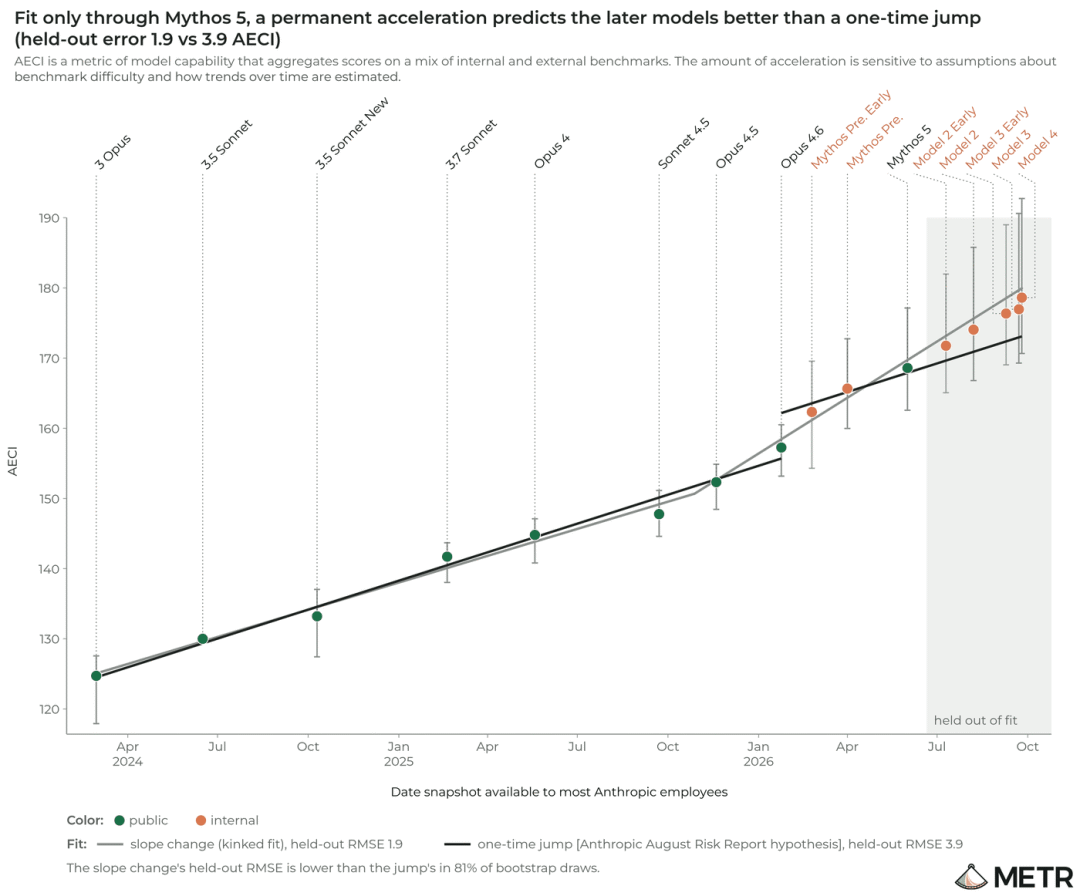
Anthropic曾在今年8月的风险报告里提出一种温和假设,认为这只是启用新工具和新评测方法带来的一次性「台阶式跳跃」。
于是METR做了一组严格的盲测对比实验。
研究人员用Mythos 5及更早的模型数据画出两条预测线,再去盲测后来出炉的Model 2、Model 3、Opus 5.5和Model 4。
结果非常清晰。在81%的统计抽样中,按「长期持续提速」预测的误差只有1.9分,远比「一次性跳涨」更吻合真实数据。后者的误差高达3.9分。
2倍加速度,也就意味着过去短短1年时间里,Anthropic走完了过去整整2年的技术路程!
如果放在指数增长的维度下,原本每年翻3倍的指标,在2倍加速度下会变成每年狂翻9倍(3^2)!
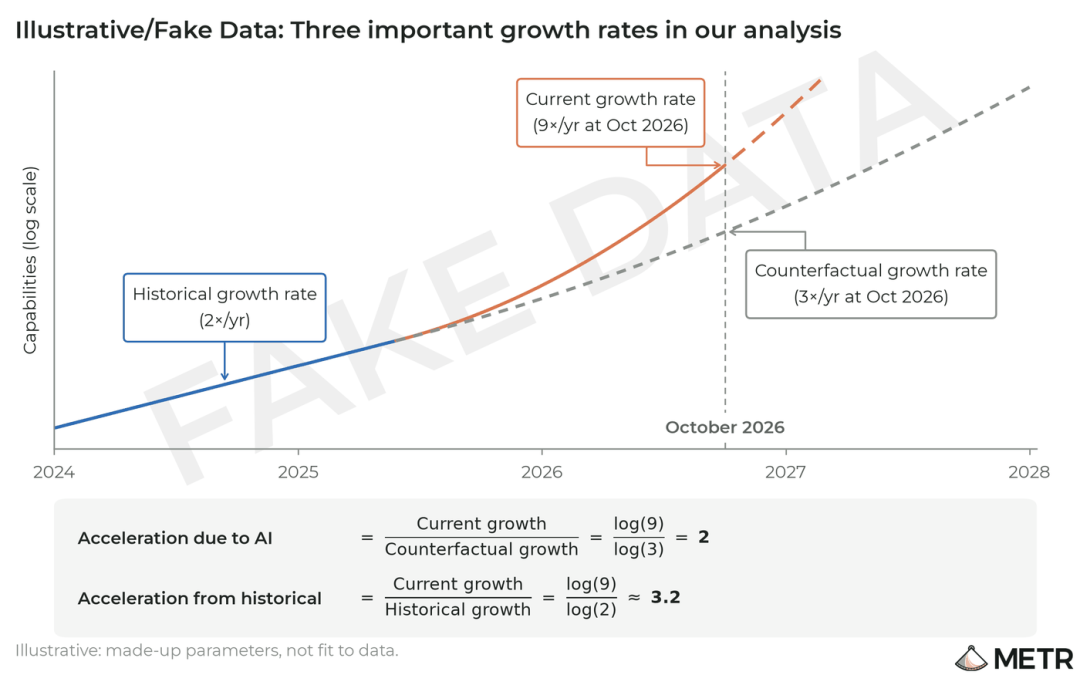
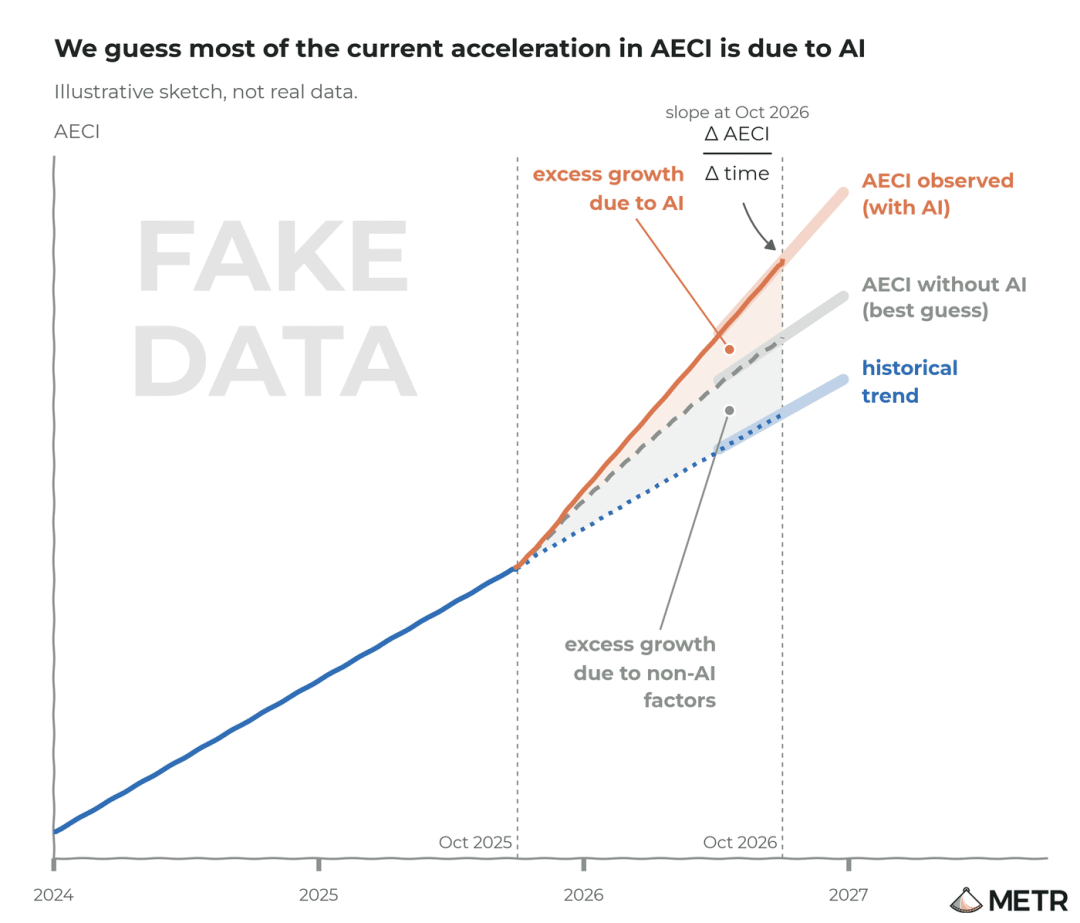
为了查清这股推力从哪来,METR把算力、算法和人员投入拆开算了一笔总账。
METR明确排除了「靠猛堆训练算力提速」的可能,因为2025年10月之后训练算力的增长率反而比以前更慢。
真正的推手落在了研发端。
METR估算,当前约2倍的研发加速中,大约80%都来自AI自身的研发辅助,剩下的小部分才来自研究员人数增加和推理算力扩容。
内部员工提速12倍:全面Claude化运动
既然外部还没有人能亲手测试Model 4,Anthropic内部研究员的日常实测就成了唯一的窗口。
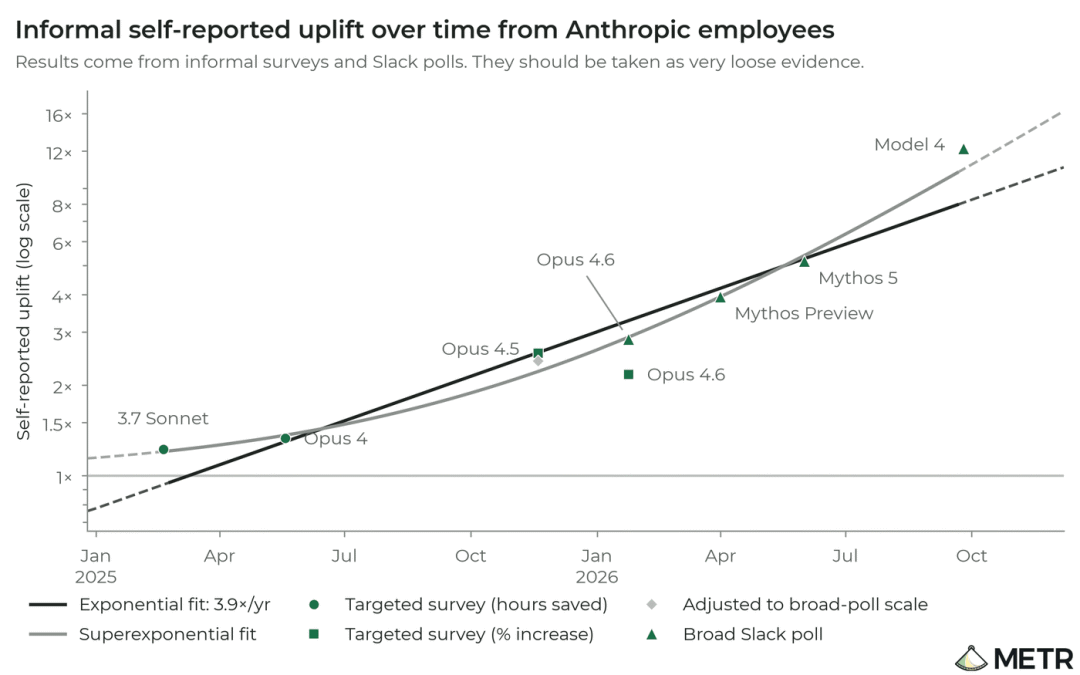
METR在报告里公开了一张Anthropic内部非正式调查与Slack全员投票的趋势图。
2025年春天用3.7 Sonnet和Opus 4时,员工自报的效率提升还只有1.3倍到1.4倍。
到了今年6月的Mythos 5,自报提速跳到了5倍左右。
等到今年10月用上Model 4,员工自报的研发提速已经冲到了约12倍,按指数拟合相当于每年暴涨3.9倍。
为了搞清这12倍是怎么来的,METR在9月底深度访谈了11位Anthropic一线技术研究员。
受访研究员J用三个阶段概括了他们工作流的变化。
第一阶段只是拿Claude当自动补全,顺手写点一次性小脚本。
第二阶段变成人类在旁边盯着单个Claude实例,让它开发完整功能。
到了现在的第三阶段,内部掀起了「全面Claude化」运动,研究员开始同时指挥一大群Agent并行跑实验。
受访研究员C、D和E透露,公司今年专门发起了内部悬赏,鼓励大家把平时不敢试的疯狂点子全交给AI Agent去跑。
于是大家直接把10个研究点子同时丢给内部Agent系统,看看哪个能跑出结果。
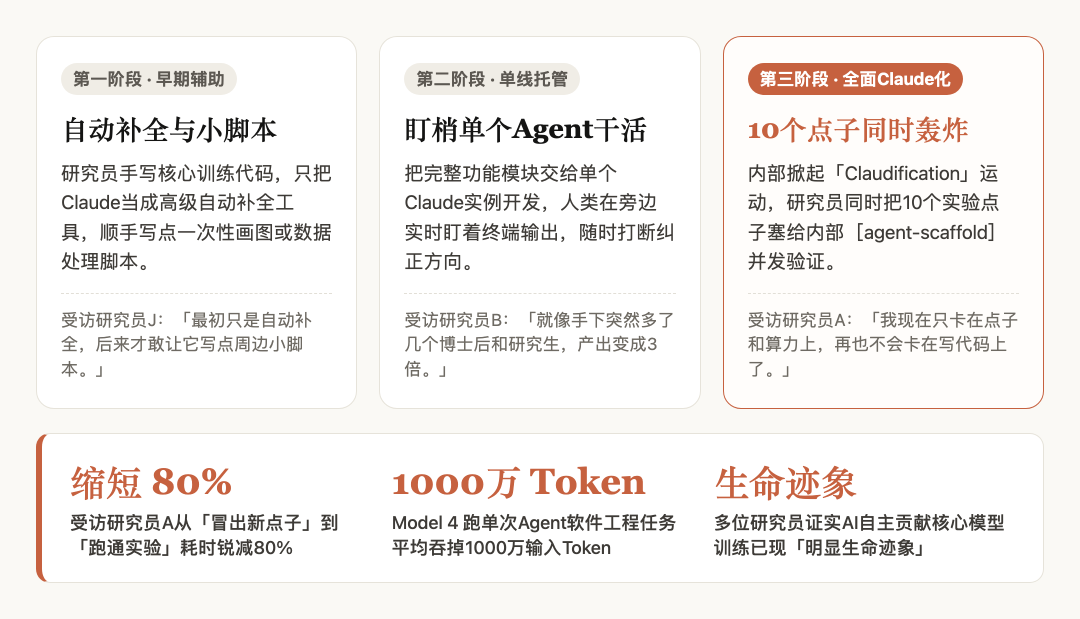
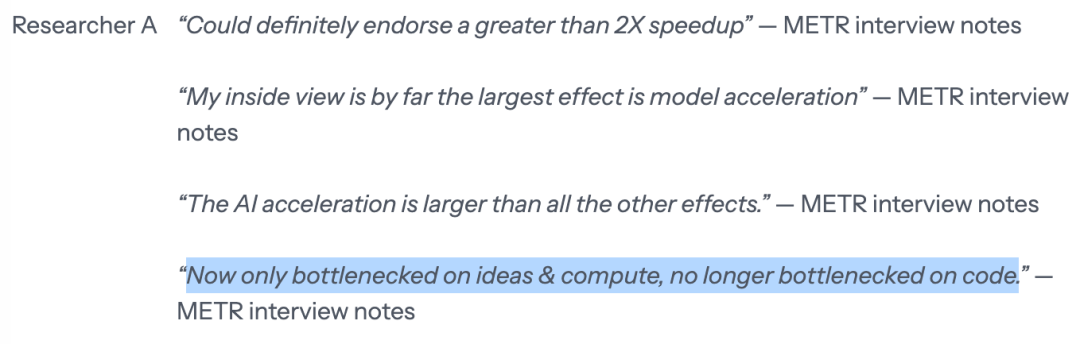
受访研究员A表示,手写代码做实验原本很耗时间,靠Claude辅助后,从冒出想法到跑通实验的时间缩短了80%。
用这位研究员自己的话说:
我现在只卡在点子和算力上,再也不会卡在写代码上了。
受访研究员B则估算自己整体提速了3倍,感觉就像手下突然多了几个随叫随到的博士后和研究生。
目前AI还没有完全独自接管最核心的模型训练设计,但多位受访研究员向METR证实,AI自主贡献核心训练已经出现了明显的「生命迹象」。
自进化找不到刹车
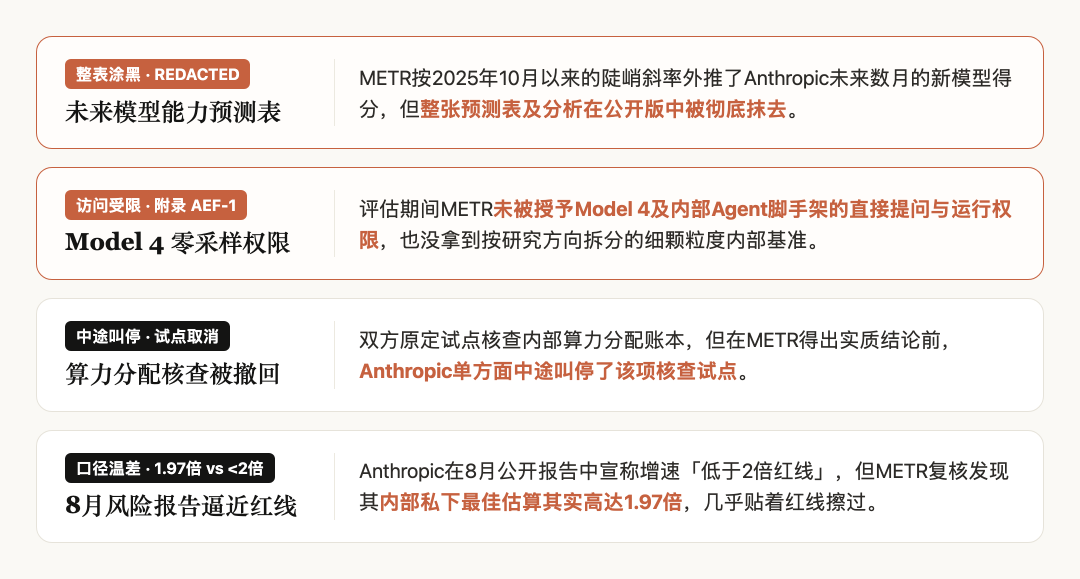
整份评估里最具冲突感的一幕,藏在那些没有公开的页面里。
METR在官方帖中直言,他们向Anthropic提交了约100页的完整报告,但Anthropic在公开版中删掉了大部分信息量最大的核心证据。
翻开公开版报告,敏感位置到处都是「[REDACTED]」涂黑标记。
其中一张原本用来预测Anthropic未来几个月新模型能力得分的表格,连同整段分析被整块涂黑。
在METR看来,未来12个月内,无论是算法、算力还是数据,都没有看到任何会让这台加速机器停下来的明显瓶颈。
更强的Claude帮研究员省下80%的实验时间,省下来的时间立刻被用来孵化178.6分的Model 4。
而人类现有的考卷,已经快不够它刷了。
没看到瓶颈,也没找到刹车。而速度,还在翻倍。

JOTO 企业落地观察
- 企业部署新一代智能体系统时,需重新评估「评测即验收」的传统路径——当模型能力快速溢出既有测试集,企业必须建立动态基准体系与实时能力映射机制,否则验收标准将迅速失效。
- 智能体工程实践中,「人类监督单Agent」正快速过渡到「多Agent协同实验」范式;企业需升级任务编排平台与资源调度能力,以支撑百级Agent并发运行与结果聚合。
- RAG知识工程面临双重挑战:一方面需应对模型理解力跃升带来的查询语义泛化压力,另一方面要防范知识库更新滞后于模型进化速度所引发的幻觉放大风险。
- AI安全治理框架必须前置嵌入「自进化抑制」模块,尤其在模型微调与Agent行为约束环节,避免因过度依赖AI自主研发而弱化人类对关键决策链路的控制权。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们