相关文章
553 篇高质量内容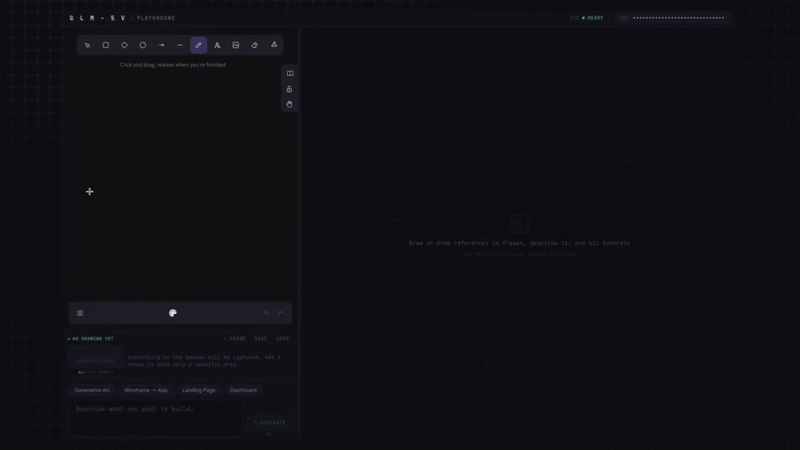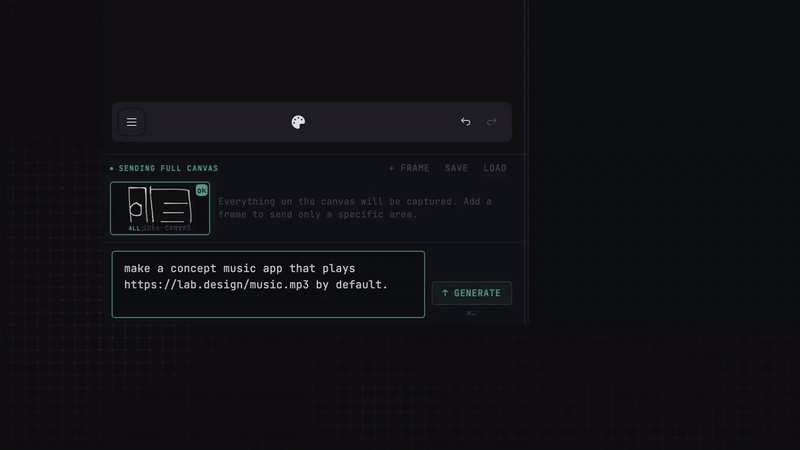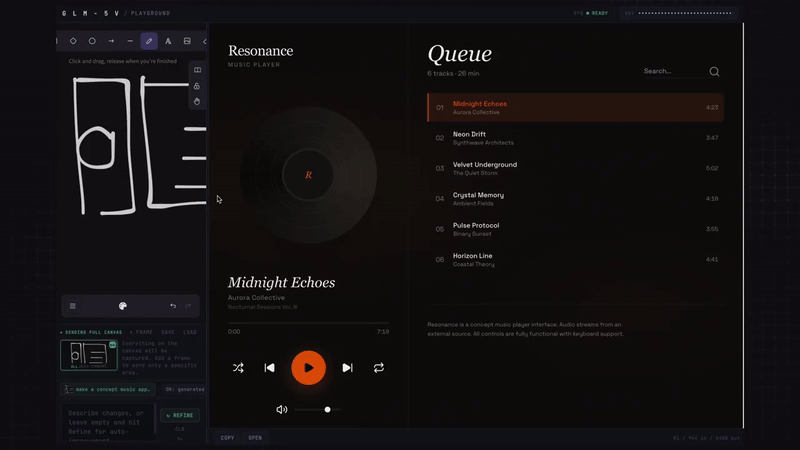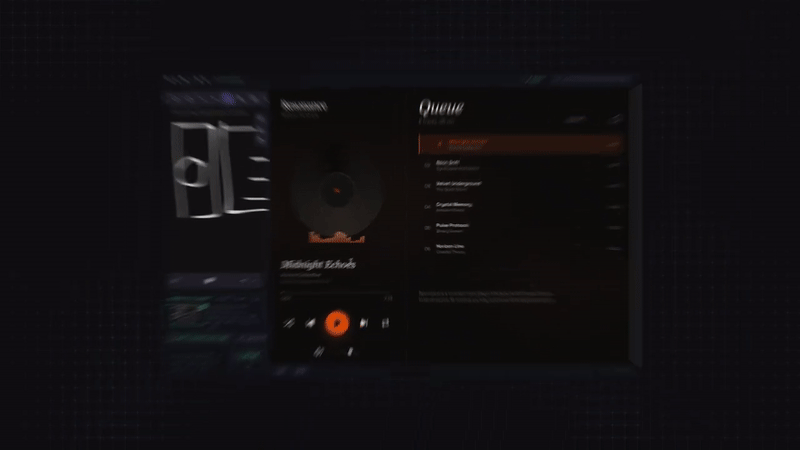
全解读|智谱 GLM-5V-Turbo 发布,多模态 Coding 基模
智谱 GLM-5V-Turbo 重磅升级,原生视觉能力让AI看懂设计稿直接生成代码,多模态编程新时代来临! 核心内容: 1. GLM-5V-Turbo 的核心升级:原生视觉理解与多模态编程能力 2. 在多项多模态基准测试中超越竞品,同时保持纯文本编程能力不退化 3. 典型应用场景:设计稿转代码、网页界面生成等开发效率革命
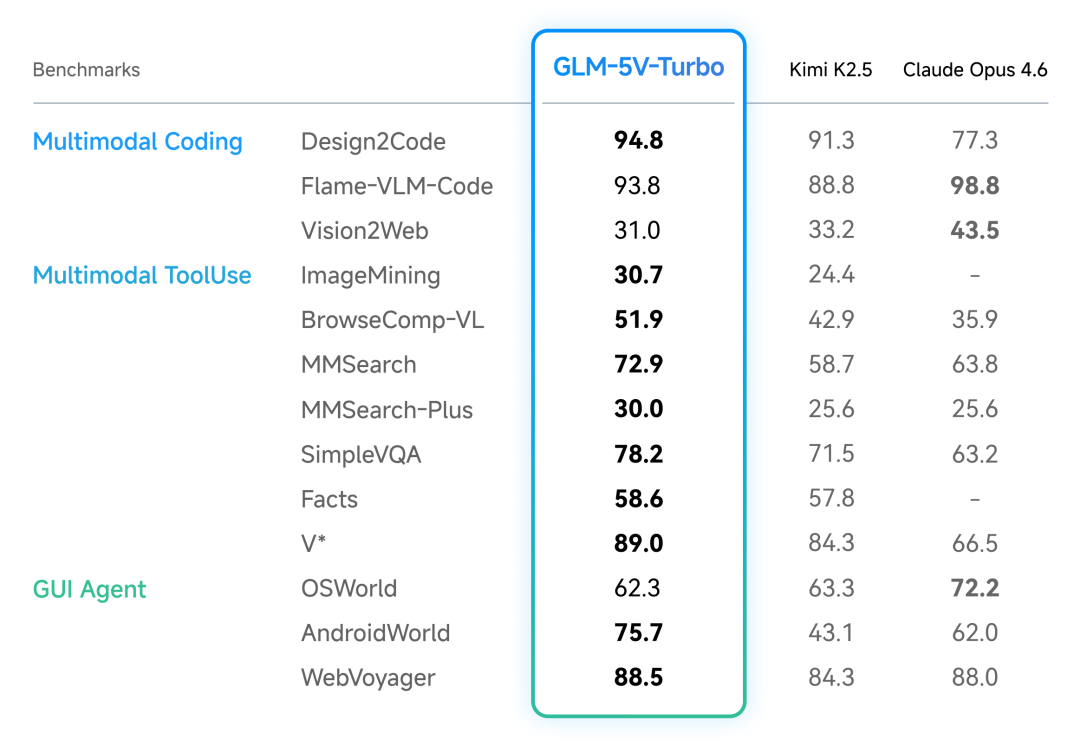
GLM-5V-Turbo:多模态Coding,图像即代码
GLM-5V-Turbo突破多模态编程边界,让AI真正看懂画面写出代码,开启视觉编程新时代。 核心内容: 1. 原生多模态Coding基座能力解析 2. 在视觉编程与纯文本场景的双重优势 3. 与行业Agent的深度协同应用案例
突破零样本TTS音色克隆上限:LongCat-AudioDiT 的声音克隆艺术
美团LongCat团队突破传统TTS技术瓶颈,推出直接生成波形的LongCat-AudioDiT模型,实现零样本音色克隆的SOTA性能。 核心内容: 1. 传统TTS系统的多阶段流程缺陷与误差累积问题 2. LongCat-AudioDiT在波形潜空间直接建模的创新架构 3. 关键技术创新:训练-推理匹配优化与自适应投影引导方法
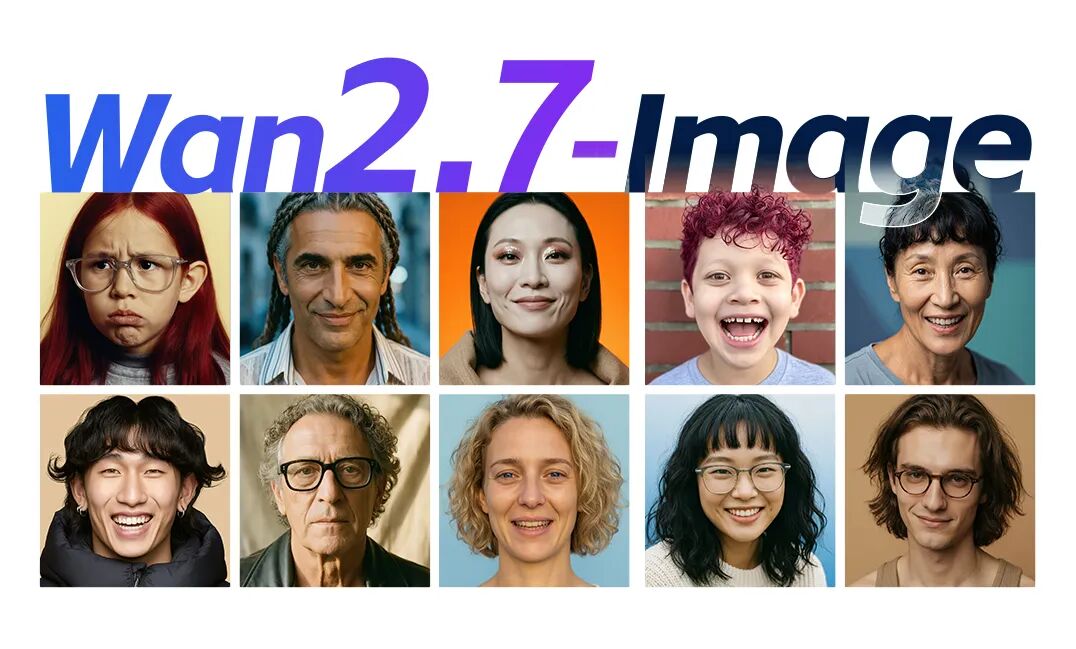
千人千面,精控调色,更懂你的Wan2.7-Image来了
告别千篇一律的AI脸,Wan2.7-Image带你玩转个性化虚拟形象与精准色彩控制! 核心内容: 1. 千人千面:全方位定制虚拟角色五官细节,告别标准AI脸 2. 调色盘功能:支持大师级配色方案提取与自定义色彩调控 3. 超强生产力:3K token长文本渲染、12张组图生成及交互式编辑
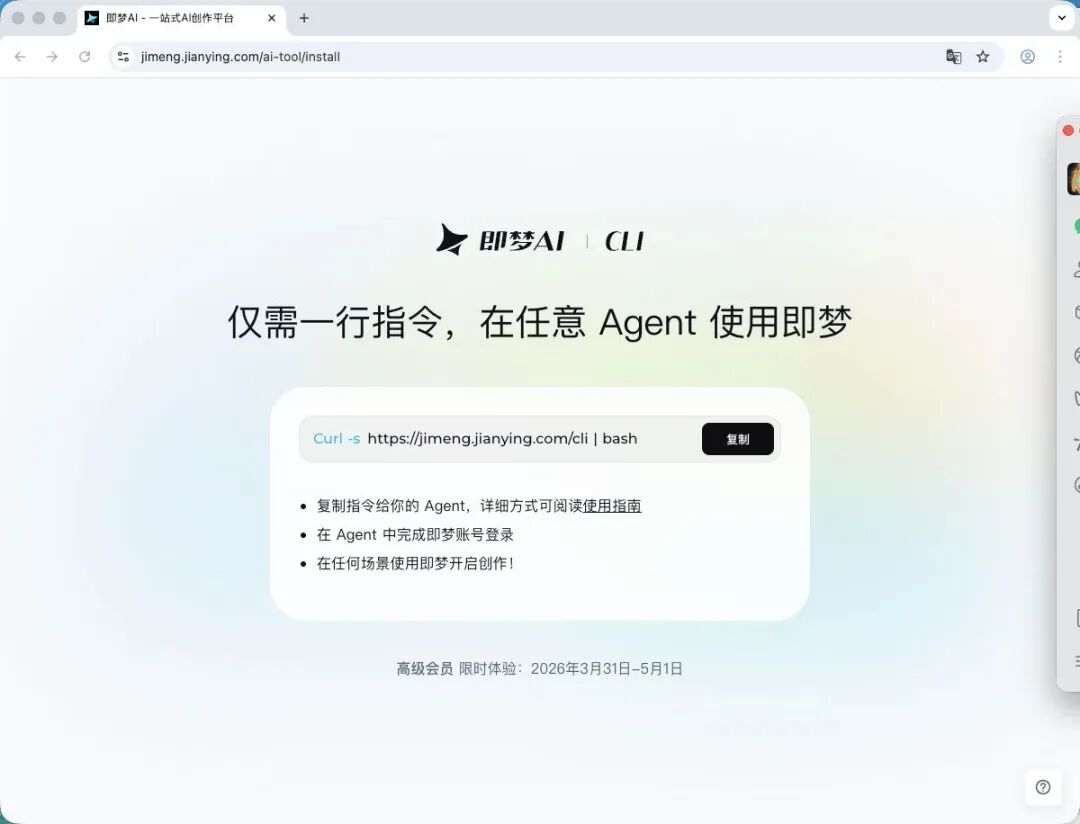
震惊!即梦推出 CLI,Agent 一行命令生成 Seedance 2.0 视频,AI 视频井喷
即梦CLI工具震撼发布,一行命令让Agent轻松调用Seedance 2.0视频生成能力,AI创作效率迎来革命性提升! 核心内容: 1. 即梦CLI工具的一键安装与八大生成命令详解 2. Seedance 2.0旗舰模式通过CLI实现Agent批量调用 3. 高级会员限时体验政策及实战应用案例分享
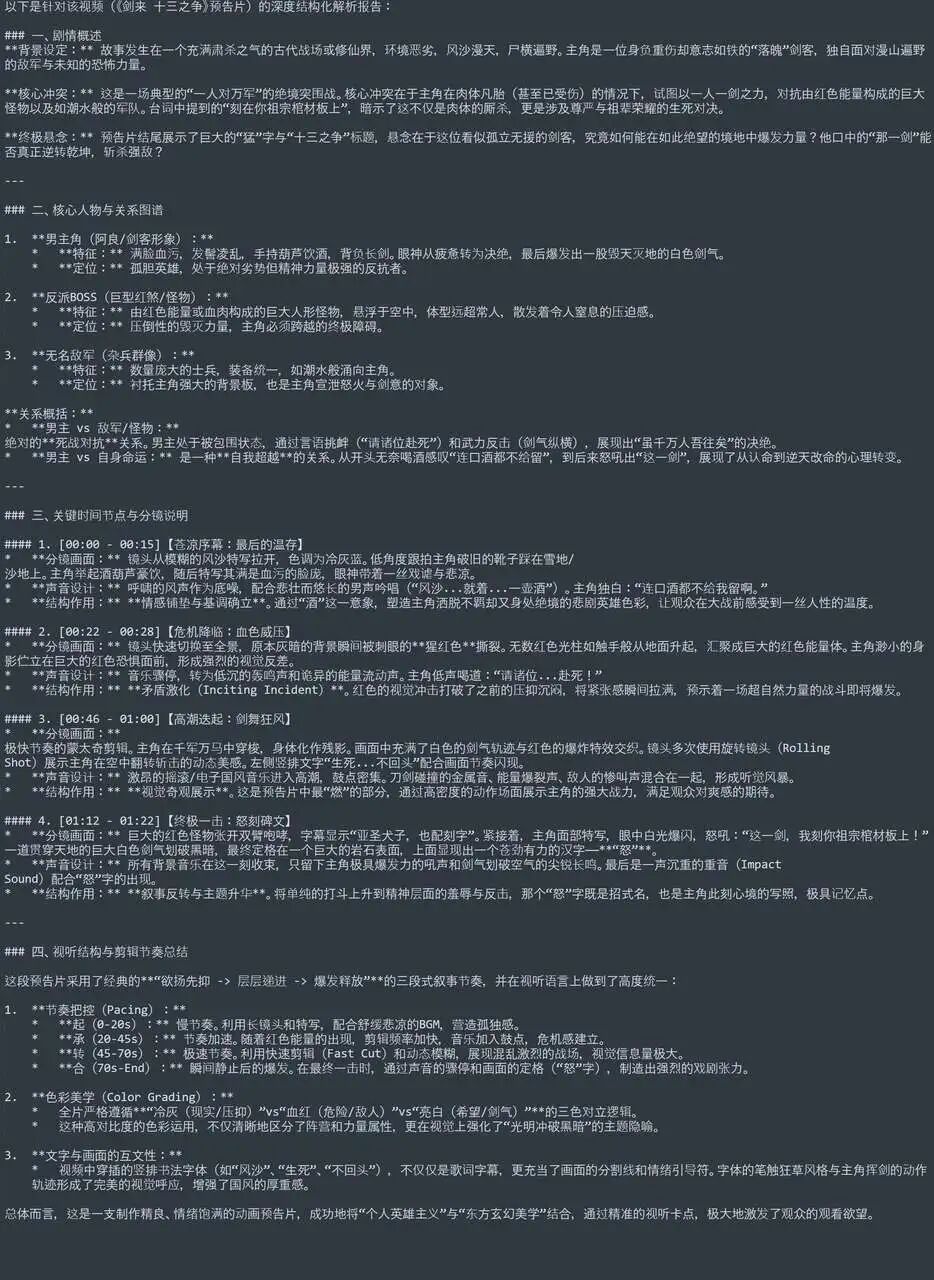
千问发布Qwen3.5-Omni全模态模型,超越Gemini3.1 Pro?附实测~
千问Qwen3.5-Omni全模态模型实测表现惊艳,在中文视频理解和长音频处理上超越Gemini3.1 Pro! 核心内容: 1. Qwen3.5-Omni在剑来PV解析中的细致表现 2. 超长播客内容快速解析的实用案例 3. 新增联网配置带来的效果提升
让“龙虾”帮你自动赚钱!OpenClaw Seedance 2.0 视频生成全攻略
用"龙虾"工具一键生成Seedance 2.0视频,轻松实现自动化创作,解放你的生产力! 核心内容: 1. OpenClaw工具实现Seedance 2.0视频自动生成的全流程 2. 从文生视频到图生视频的实战操作指南 3. 常见问题解决方案与性能优化技巧

通用语音识别模型VibeVoice ASR:长达60分钟音频一次性“直出”结构化转写
微软亚洲研究院发布VibeVoice ASR,突破传统语音识别局限,60分钟长音频一键转写,结构化输出更智能。 核心内容: 1. 传统语音识别痛点与VibeVoice ASR的创新突破 2. 模型五大核心能力:长音频处理/结构化输出/热词支持等 3. 开发者友好:Hugging Face集成与多平台部署方案
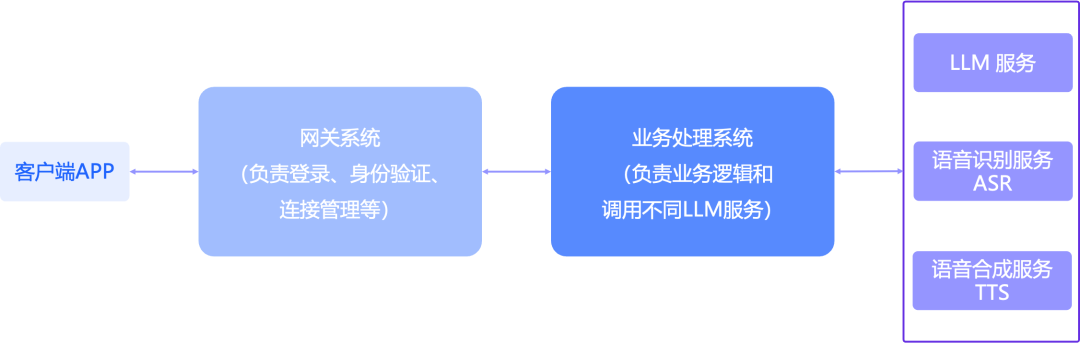
Agent 语音交互如何更稳、更快?一次高并发消息链路优化实践
AI Agent语音交互面临高并发挑战?揭秘阿里云RocketMQ如何打造稳定高效的实时消息链路。 核心内容: 1. 高并发语音交互场景的三大技术挑战:海量会话管理、高频小包传输和严苛时效性要求 2. 传统消息架构在实时语音场景中的核心瓶颈与解决方案 3. 基于阿里云RocketMQ LiteTopic的优化实践与架构设计
GLM-OCR技术细节全公开
GLM-OCR技术报告重磅发布,揭秘这款高效多模态模型如何以0.9B参数实现SOTA文档理解能力。 核心内容: 1. GLM-OCR的架构设计与核心创新点 2. 在复杂文档场景中的领先性能表现 3. 面向生产环境的部署优势与实践案例
Midjourney V8 正式上线:高清模式、文字无错、生成速度提升5倍
Midjourney V8震撼发布,AI绘画迎来2K高清时代,文字渲染与提示词理解全面升级! 核心内容: 1. 原生2K分辨率生成,细节表现力大幅提升 2. 文字渲染增强,海报Logo制作更精准 3. 自然语言理解优化,创作门槛显著降低
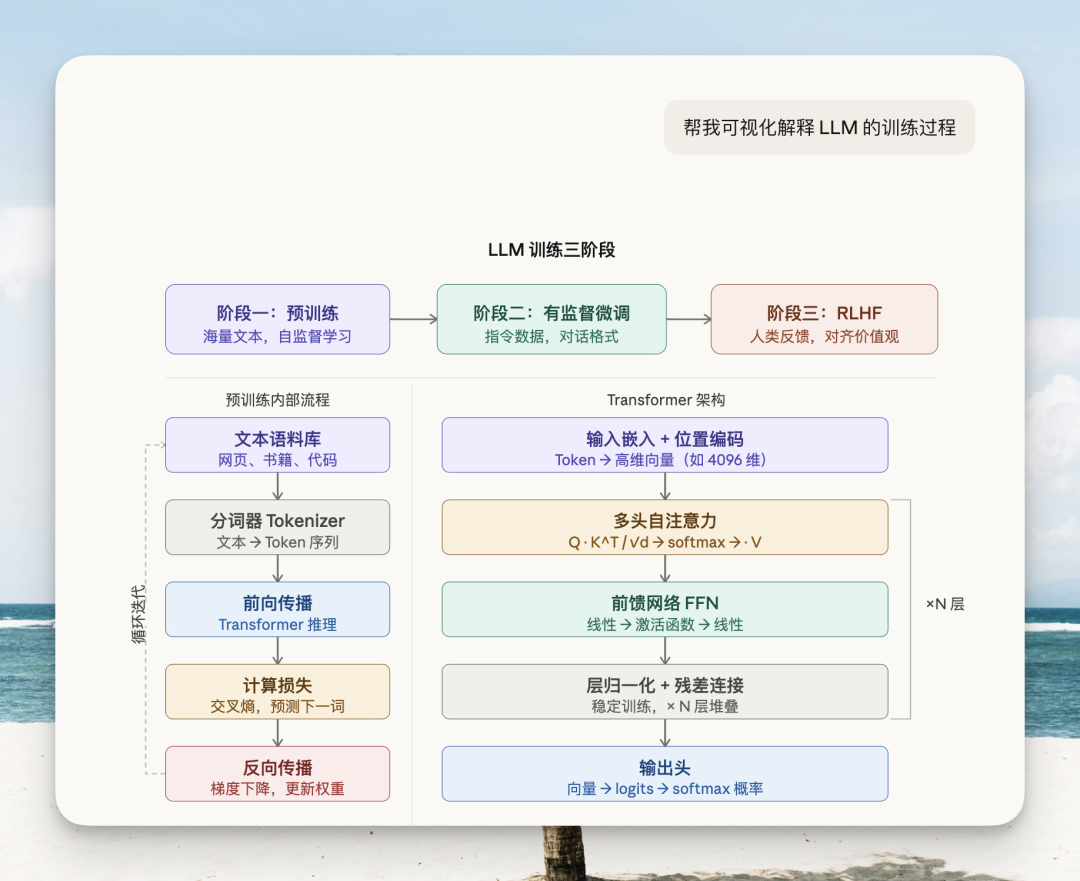
我复刻了 Claude 刚发布的生成式 UI 交互!
Claude最新生成式UI交互惊艳亮相,作者48小时极限复刻实现可视化聊天革命! 核心内容: 1. 生成式UI的核心突破:流式渲染SVG图表,边生成边交互 2. 四大应用场景:数据分析可视化、交互式小工具、技术架构图、项目数据分析 3. 多模型兼容实现:支持Kimi/Claude等主流模型,交互式深度追问功能
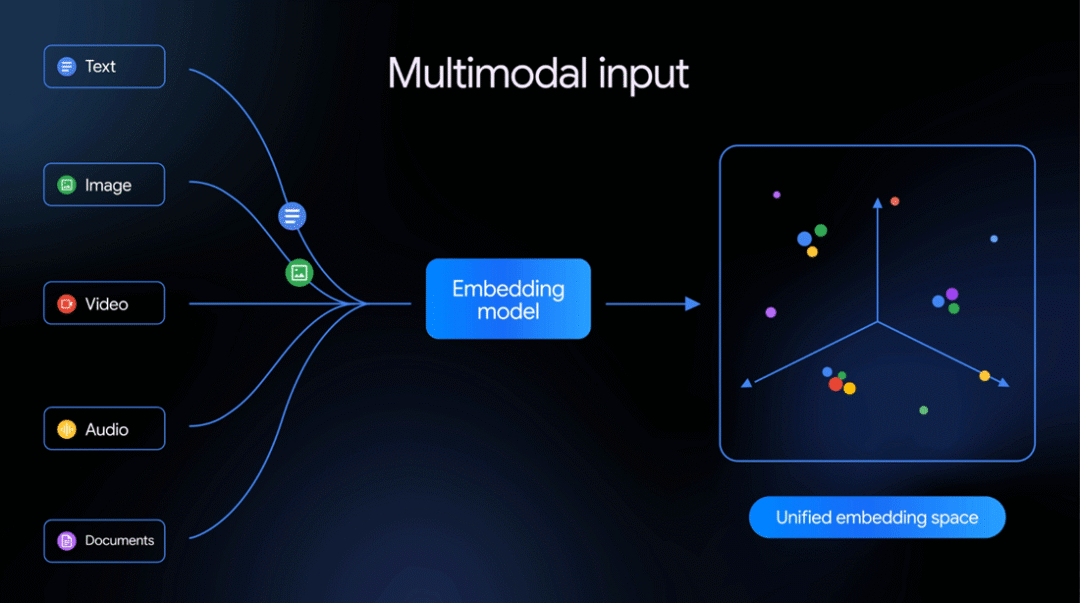
Gemini Embedding 2把多模态信息整合同一向量空间了,还需要多向量列吗?
Gemini Embedding 2实现多模态统一向量表示,但多向量检索技术仍有不可替代的价值。 核心内容: 1. Gemini Embedding 2的核心突破:全模态原生支持与灵活尺寸 2. 多向量检索技术的独特价值与适用场景 3. 统一表示与多向量检索的互补关系
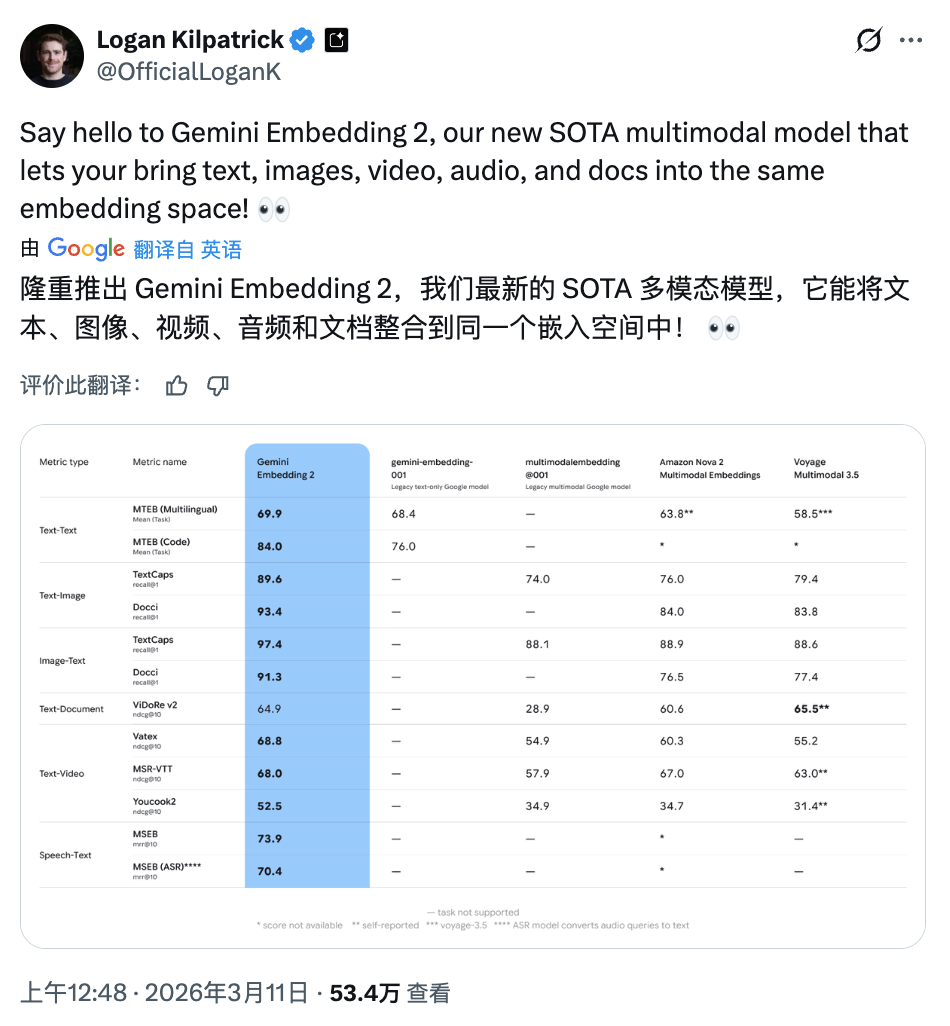
Gemini Embedding 2:首个原生五模态 embedding 模型
Google DeepMind推出首个原生五模态embedding模型,文本、图片、视频、音频、PDF首次统一编码,多模态搜索从此一键搞定! 核心内容: 1. 支持五种模态混合输入,一次API调用完成跨模态理解 2. 3072维向量支持无损降维,1536维性能反超2048维 3. 对比前代模型在多模态能力上的重大突破
Google 发布首个全模态 Embedding 2 模型,文本图片音视频 PDF 统一到一个向量空间
Google突破性发布Gemini Embedding 2,首次实现文本、图片、视频、音频和PDF五模态统一向量空间,彻底改变多模态数据处理方式。 核心内容: 1. 五种模态数据首次统一到一个向量空间的重大突破 2. 音频直接处理无需转录的创新工作流程 3. 在多项基准测试中全面领先的卓越性能表现
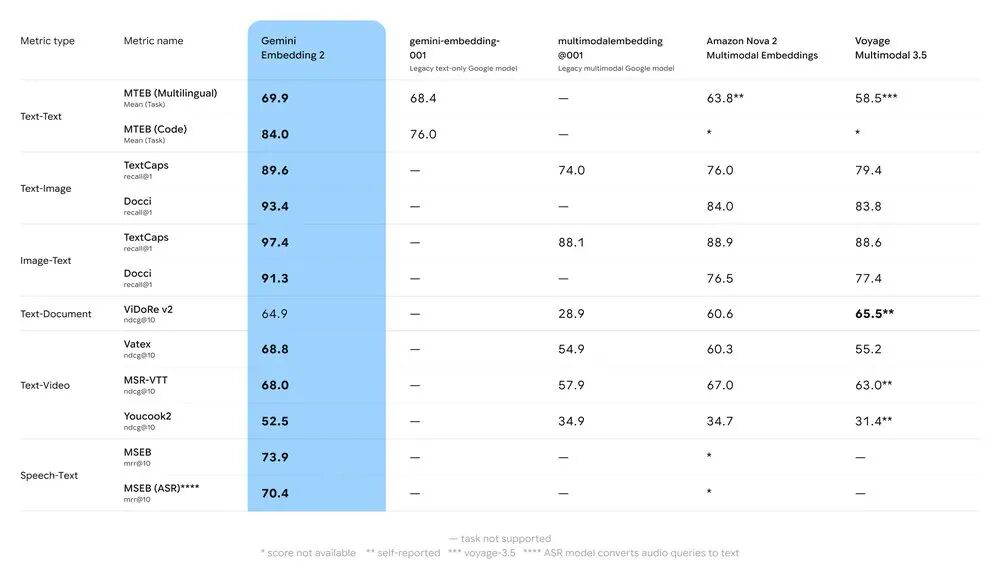
谷歌首个原生多模态向量模型发布:Agent 可以用文字搜图片、用图片搜视频了...
谷歌发布首个原生多模态向量模型Gemini Embedding 2,实现文字、图片、视频、音频和文档的统一向量空间映射,大幅提升多模态任务处理能力。 核心内容: 1. Gemini Embedding 2的核心突破与五大模态支持 2. 套娃表示学习技术带来的灵活输出维度调整 3. 模型在多模态任务中的性能表现与开发生态支持
零帧起手 Codex × Figma 双向工作流实操
CodeX与Figma双向工作流实操指南,手把手带你突破工具链整合瓶颈。 核心内容: 1. 软件安装与配置全流程详解 2. MCP服务器连接与多工具集成技巧 3. 从设计到代码生成的完整案例演示
AI真人数字人语音对话性能优化实践总结
AI数字人导购对话延迟从5.64秒优化到1.32秒的实战经验分享,大幅提升交互体验。 核心内容: 1. 分析AI数字人对话链路中的延迟瓶颈 2. 采用Qwen Omni一体化模型和流式传输方案 3. 客户端音频窗口缓冲机制实现嘴型同步
“思考”更深,生成更准|Seedream 5.0 Lite 发布
Seedream 5.0 Lite重磅升级,智能图像创作进入"深度思考"时代,让AI真正理解你的创意需求。 核心内容: 1. 模型在理解、推理和生成能力上的全面提升 2. 新增实时检索功能应对时效性创作需求 3. 支持多步视觉推理,让生成结果更符合逻辑规律
Seedance 2.0上线火山方舟体验中心,API即将开放
豆包视频生成模型Seedance 2.0震撼上线,支持多模态输入,让创作更简单高效! 核心内容: 1. Seedance 2.0的多模态音视频联合生成架构 2. 相比1.5版本在质量、物理准确度和可控性上的提升 3. 即将开放的API服务及工业级创作应用场景