相关文章
2080 篇高质量内容
别再傻傻分块了:这个开源引擎让RAG准确率飙升260%
别再在RAG分块上浪费时间了,这个开源引擎从数据源头重构知识单元,让准确率实现质的飞跃。 核心内容: 1. 传统RAG分块策略的根本缺陷与问题根源 2. Blockify引擎如何用IdeaBlock重构知识表示 3. 从数据预处理层解决检索准确性的核心思路
万字长文!千万级文档 RAG 知识库系统落地实践
如何从“玩具级Demo”跨越到真正的企业级RAG知识库?本文结合千万级文档实战经验,为你拆解核心架构与解决方案。 核心内容: 1. 千万级文档RAG系统面临的五大核心挑战 2. 生产可用RAG系统的七层架构设计参考 3. 系统设计的三大原则:模块化、自动化与可观测性
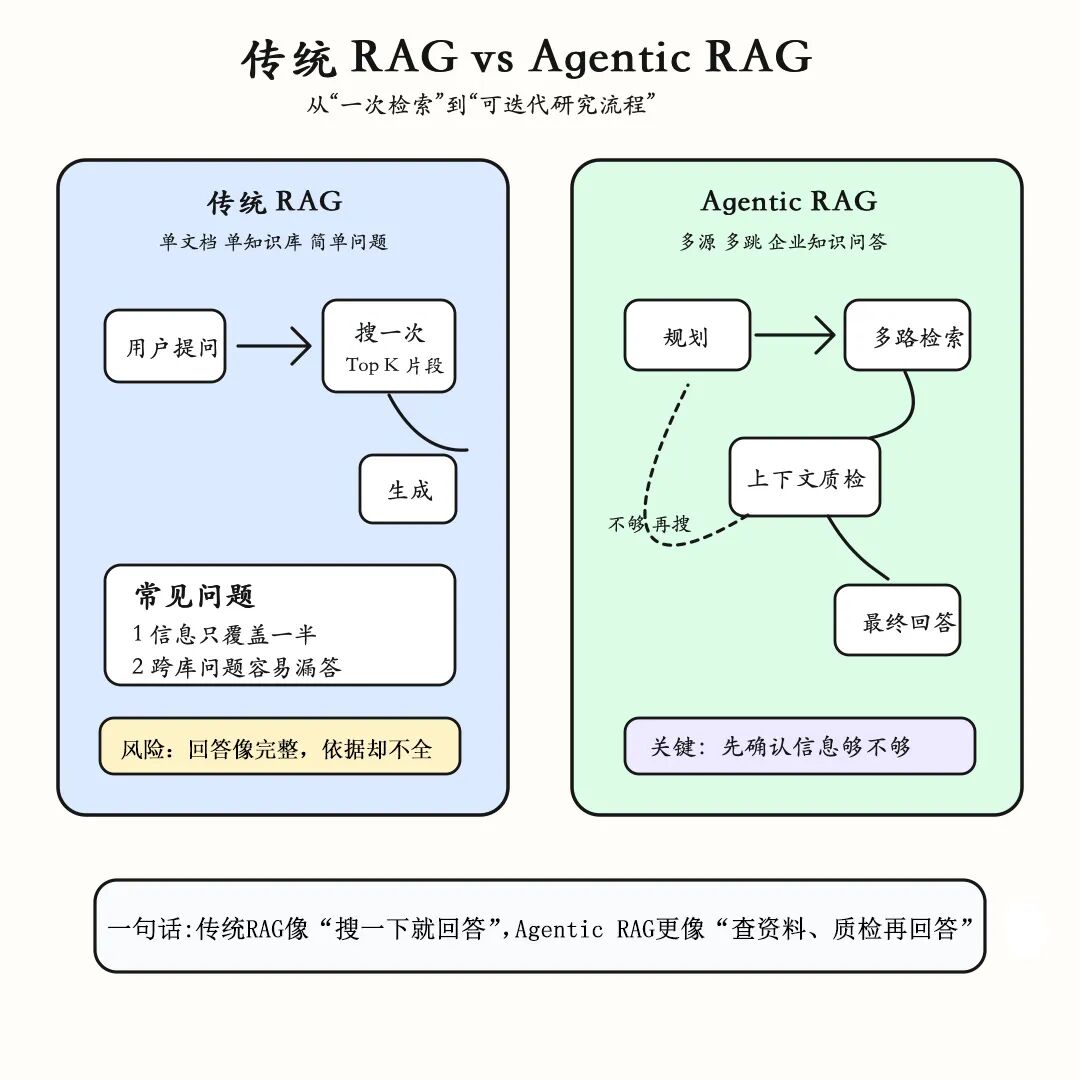
RAG不够用了?谷歌推出全新Agentic RAG框架
Agentic RAG让AI学会“打破砂锅问到底”,通过多智能体协作,彻底解决复杂检索难题。 核心内容: 1. 传统RAG的单次检索瓶颈与业务痛点 2. Agentic RAG的多智能体分工与协同工作流 3. 核心组件“充分上下文智能体”的创新机制
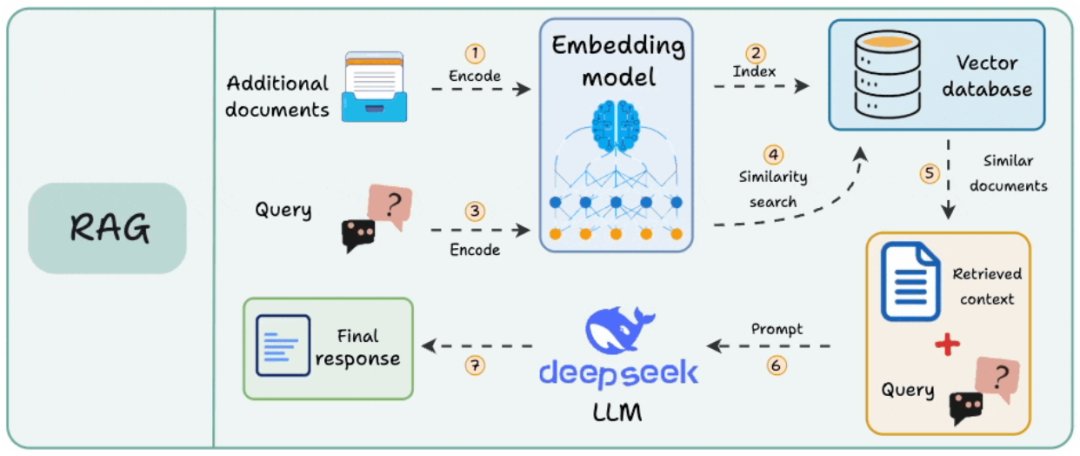
RAG检索:注定下沉为检索基础设施
RAG正从应用内部流程演变为可复用的基础设施,为AI系统提供持续、动态的检索能力。 核心内容: 1. Native RAG的局限性及独立检索层的优势 2. Agentic RAG中检索作为动态工具的工作机制 3. RAG演变为共享基础设施的核心趋势与价值
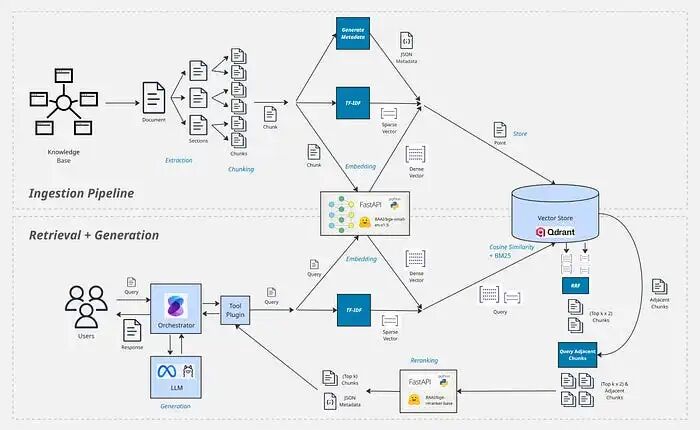
设计生产级 RAG 架构
RAG技术如何让LLM摆脱“幻觉”?本文带你用开源工具搭建生产级架构,从数据摄取到检索生成,一步步实现可靠的知识支撑。 核心内容: 1. 数据摄取管道的核心作用与设计挑战 2. 检索与生成流程的关键技术决策 3. 基于自身数据特性设计架构的最佳实践
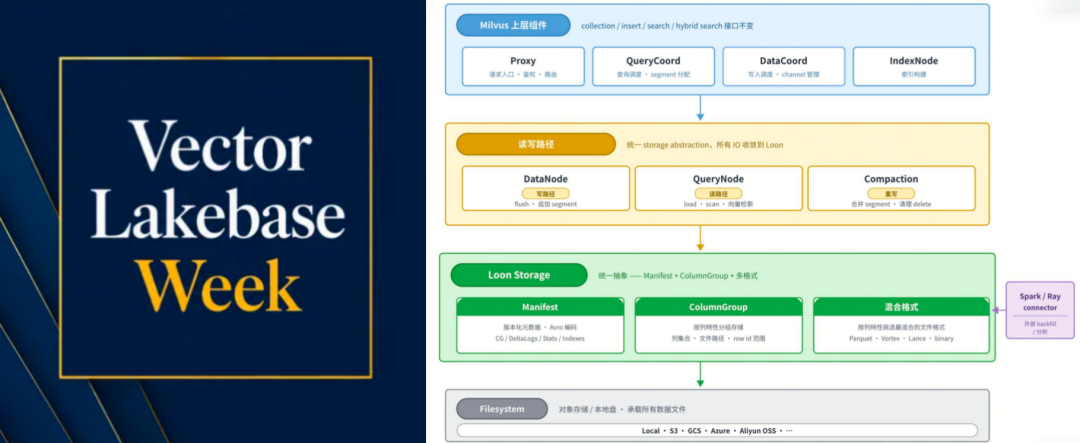
万字深度|做了8年向量数据库后,我们决定为Milvus重构AI时代的存储引擎
我们为什么决定重构Milvus的存储引擎?因为AI时代的数据形态,已远超传统数据库的承载能力。 核心内容: 1. 传统存储模型在AI时代面临的三大典型问题 2. 全新Loon引擎如何通过混合格式等方案解决这些问题 3. 以多模态训练为例的AI数据生产场景剖析
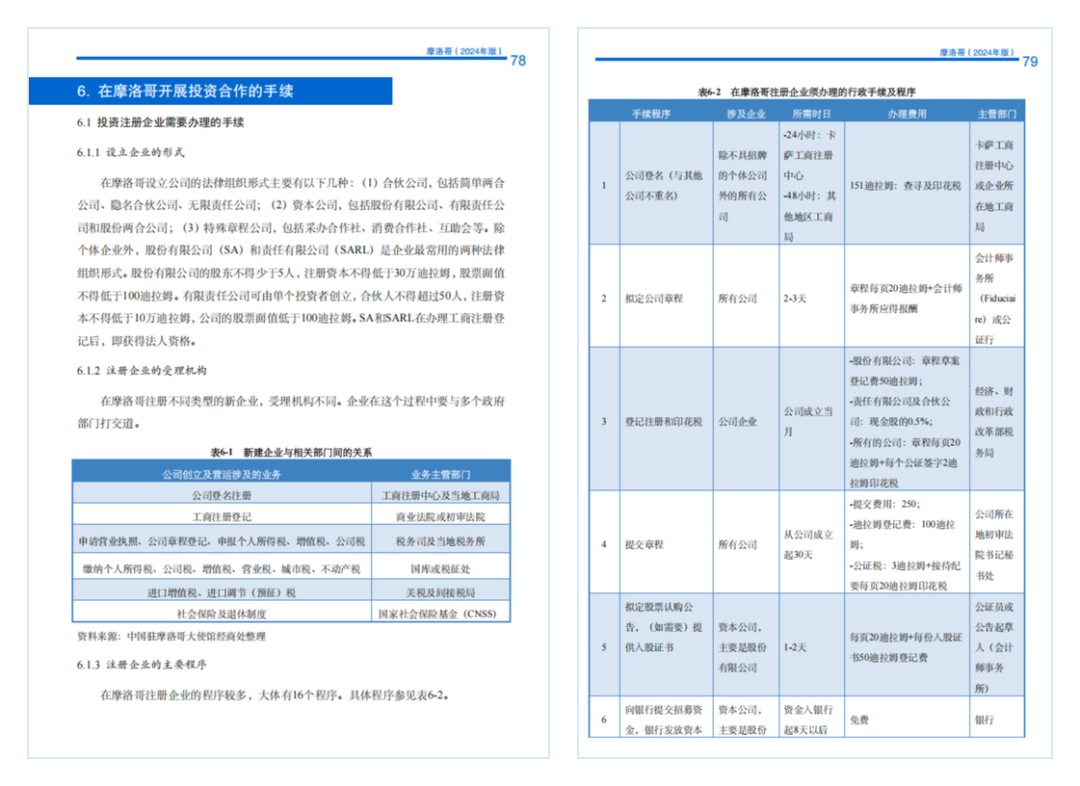
PDF2X:教材等高知识密度文档的解析与抽取实战
PDF2X帮你轻松解析教材、讲义等复杂PDF,让高知识密度文档秒变结构化知识库,为后续AI应用铺平道路。 核心内容: 1. 高知识密度文档(如教材、报告)的解析难点与价值 2. PDF2X如何通过JSON结构化解决解析难题 3. 以互动课件生成器为例的实战应用场景
ragflow v0.25.6 发布:Browser 自主浏览、RAPTOR 升级、Agent 体验增强与大量稳定性修复全解析
ragflow v0.25.6 带来多项关键升级,特别是AI自主浏览网页与RAG检索能力的显著增强,为开发者提供了更强大的工具集。 核心内容: 1. Agent新增Browser组件,赋予AI自主网页交互能力 2. RAPTOR构建升级至AHC模式,检索性能与精度全面提升 3. 包含安全性、API、国际化等大量稳定性修复与体验优化
从文档到智能问答:知识库构建的九步流程
知识库如何从文档堆变成智能问答系统?九步流程帮你打造可查询、可复用的企业知识服务。 核心内容: 1. 从数据分块到向量化的核心预处理步骤 2. 构建知识库与实现RAG检索的关键技术环节 3. 持续评测与优化,确保知识服务的可靠与可用
四种索引,一个系统,重新定义 AI 如何理解知识
这篇文章深入剖析了传统RAG系统的核心痛点,并提出了用图结构重构企业知识库的革命性思路。 核心内容: 1. 传统RAG系统在复杂业务场景下的三大根本缺陷 2. 企业知识的本质是复杂的网状关系结构 3. 引入图索引以保留和利用知识关联的新范式
腾讯云Agent Memory节省61% Token提升52%成功率的诀窍:Mermaid无限画布×上下文卸载
腾讯云Agent Memory通过上下文卸载与Mermaid无限画布,将长任务压缩为结构化记忆,最高节省61% Token,任务通过率提升52%。 核心内容: 1. 基于上下文卸载与结构化图表示的短期记忆压缩方案 2. 在超长Session中显著节省Token并提升任务成功率 3. 方案在长任务、多任务场景的应用与产品化发布
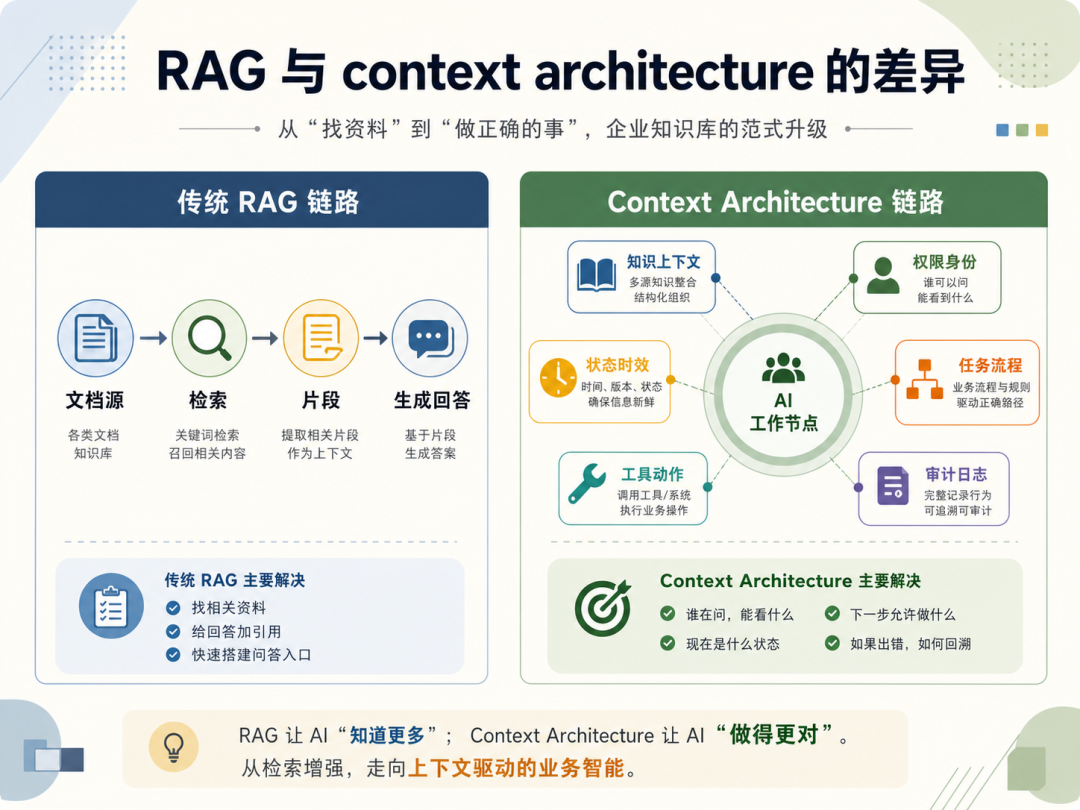
企业知识库下半场:从 RAG 到 context architecture
企业知识库进入新阶段,不再仅靠文档检索,而是让AI在真实工作场景中思考与行动。 核心内容: 1. 传统RAG的局限:无法处理权限、状态、流程等关键业务需求 2. context architecture 架构:为模型构建包含五层上下文的“工作现场” 3. 企业知识库的演进方向:从静态问答转向支持动态决策与行动
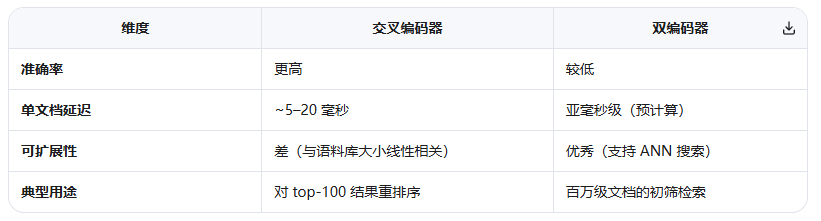
每个RAG工程师都应该了解的Ranking技术
RAG系统的成败,往往取决于重排序技术。掌握核心排序算法,才能让AI应用真正精准高效。 核心内容: 1. Ranking技术为何是RAG成功的关键 2. Pointwise、Pairwise、Listwise三大排序范式 3. LambdaMART等核心算法的工作原理与应用价值
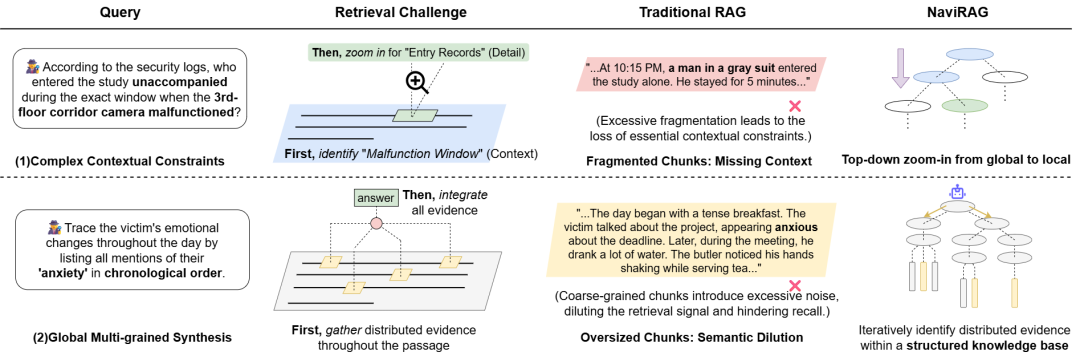
清华提出NaviRAG:让RAG学会"主动导航",长文问答F1涨4.8分
清华团队提出NaviRAG,让RAG系统像人类一样“先定位、再觅食”,在长文档问答中实现更精准、高效的检索。 核心内容: 1. 传统RAG在长文档问答中的三大痛点 2. NaviRAG“先定位、再觅食”的两阶段检索范式 3. 在五大基准测试上的显著性能提升与效率优势
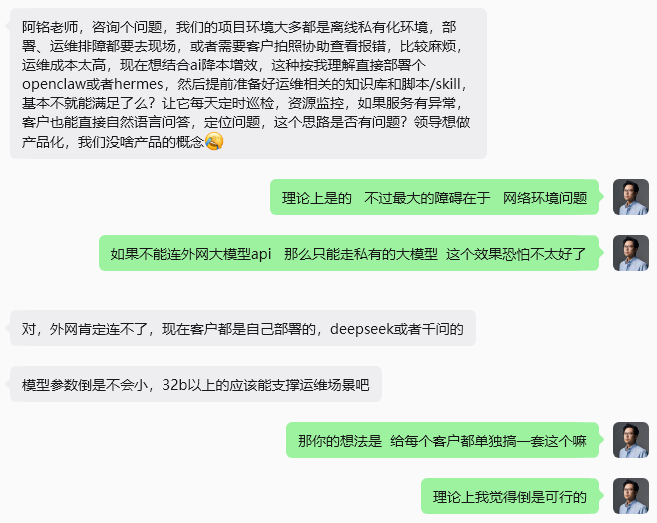
AIOps探索:给不能联网的客户做一个AI运维助手到底有多难?
离线环境下的AIOps,如何突破部署限制,真正实现智能运维?本文为你揭示核心挑战与解决方案。 核心内容: 1. 离线运维的三大核心痛点与AI解决思路 2. 本地模型与RAG结合在垂直场景的可行性 3. 客户安全顾虑与Agent部署的实际挑战
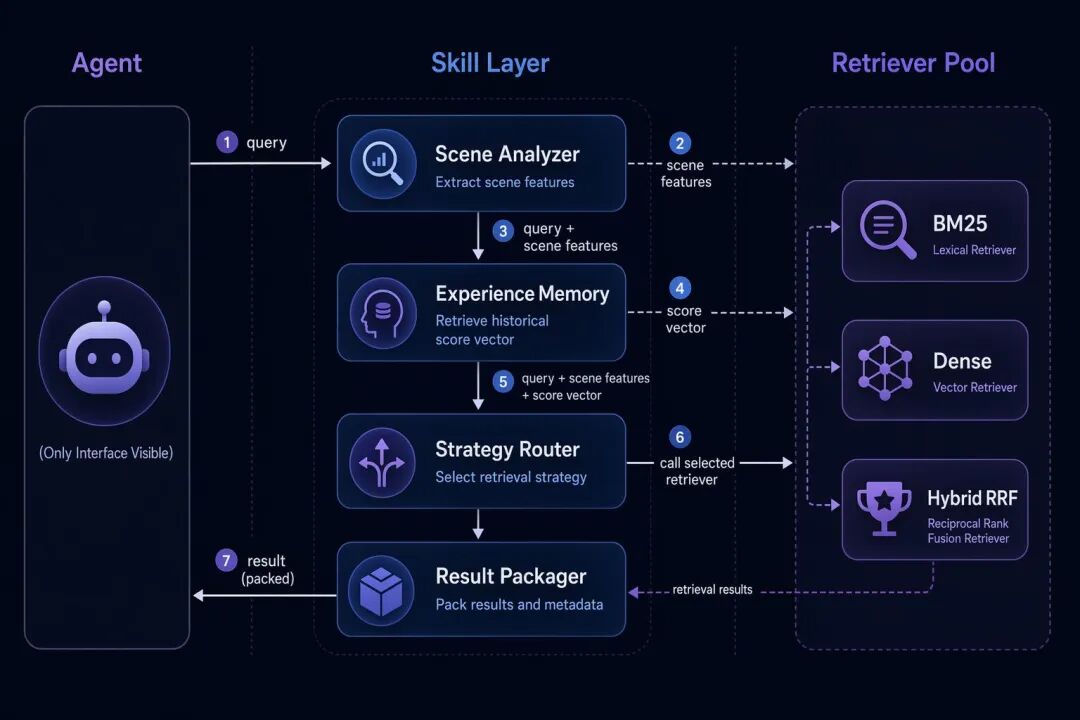
有多少人把Agent与RAG的检索策略,简化成了 if-else?
别再让 if-else 限制你的智能体!澳门理工大学新研究将检索策略封装为可复用的“技能”,解决了复杂任务下的检索难题。 核心内容: 1. 当前固定检索策略在复杂任务中的三大工程瓶颈 2. 检索策略选择与普通工具调用的本质区别 3. “检索技能”封装的核心思路与生产实践启发
RAG 全链路技术详解
RAG技术实战指南,聚焦知识库构建、检索优化与量化评测三大核心挑战,助你打造低幻觉、高确定性的Agent应用。 核心内容: 1. 从文档加载到索引构建的全链路技术详解 2. 检索优化与生成调优的核心策略与方法 3. Graph RAG进阶应用与Ragas自动化评估体系
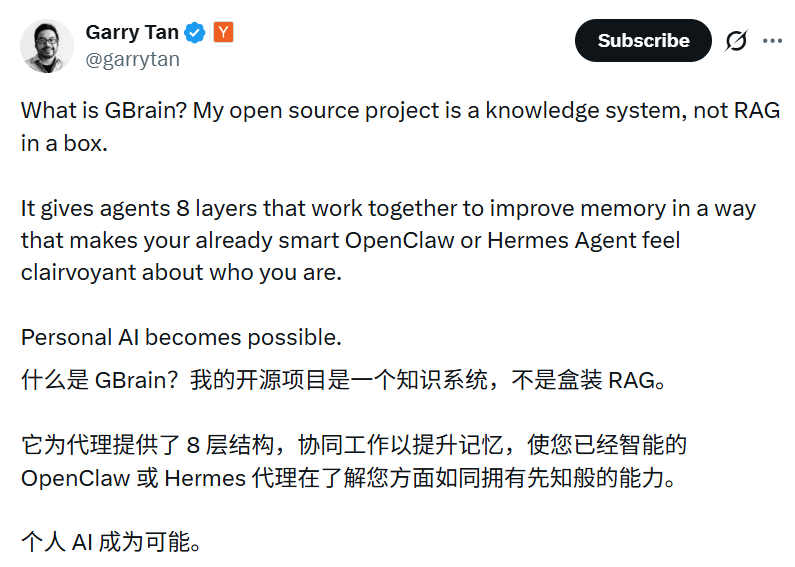
捅破个人AI天花板!YC总裁开源GBrain:8层架构打造AI第二大脑,解决记忆难题,狂揽 1.6w Star!网友:第六层才是护城河!
GBrain以8层架构革新AI记忆系统,实现AI的第二大脑,解决传统RAG的记忆缺陷,引爆社区并获1.6万Star。 核心内容: 1. GBrain对比传统RAG的4层架构,升级为8层架构,实现从“找得到”到“记住并进化” 2. 工作模式如同“数字分身”,能自发处理多源数据并进行夜间“梦境整合” 3. 前4层基础检索强化的具体技术细节与性能优势
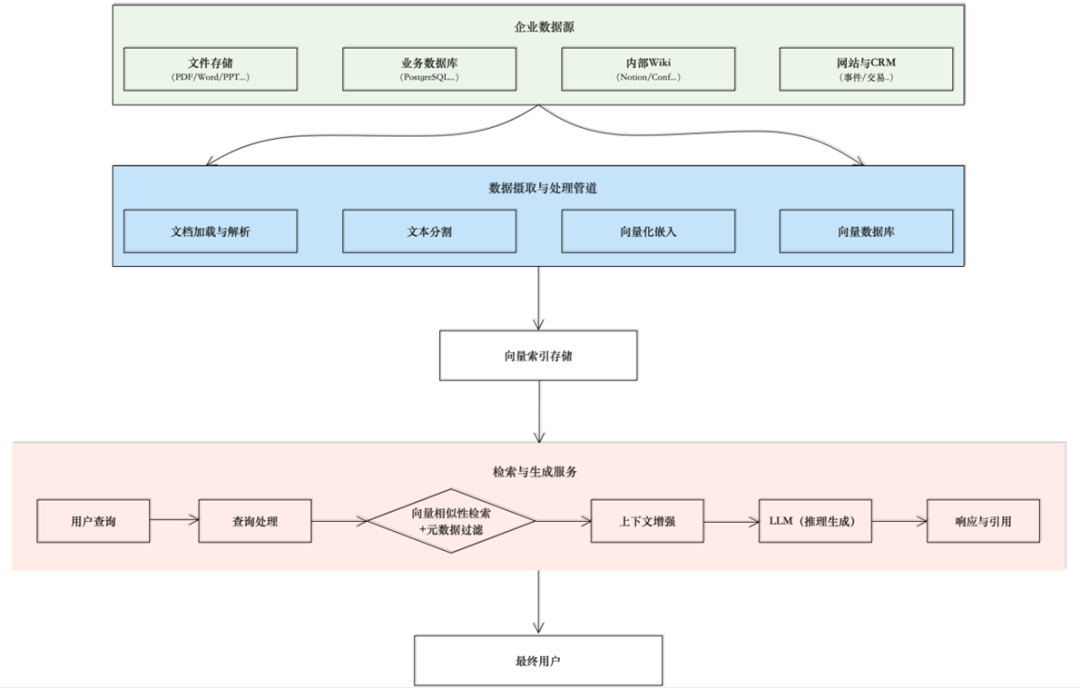
RAG 在企业的落地,从来不是一个“大模型问题”
RAG在企业落地为何频频受阻?本文揭示了从概念到生产的关键挑战,指出其核心是系统架构而非单纯模型问题。 核心内容: 1. 剖析RAG落地过程中的常见误区与现实挑战 2. 阐述构建生产级RAG系统的三大核心架构理念 3. 详解从数据到生成的全链路技术关键环节
到底是谁会相信RAG已死啊?
RAG真的能被替代吗?本文带你直面RAG的固有局限与升级路径。 核心内容: 1. 剖析传统RAG在复杂场景下的失效原因 2. 引入混合检索以弥补语义检索短板 3. 探讨RAG从一次性检索到交互式智能的进化方向