相关文章
2080 篇高质量内容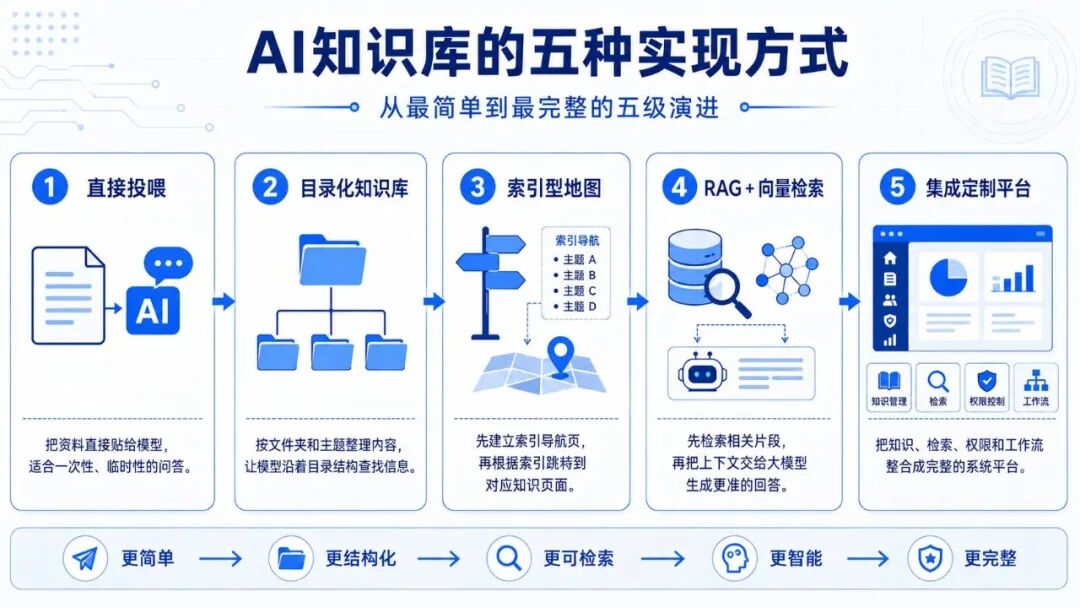
AI知识库从零到一:个人wiki+企业RAG方案
高效构建专属AI知识库,解决通用AI不了解你业务的痛点,让信息真正为你所用。 核心内容: 1. 五种AI知识库实现方式,从简单投喂到企业级RAG方案 2. 三种高价值应用模式:内容量产、新人培训、客户应答 3. 实践落地原则与关键步骤,从整理资料到持续优化反馈
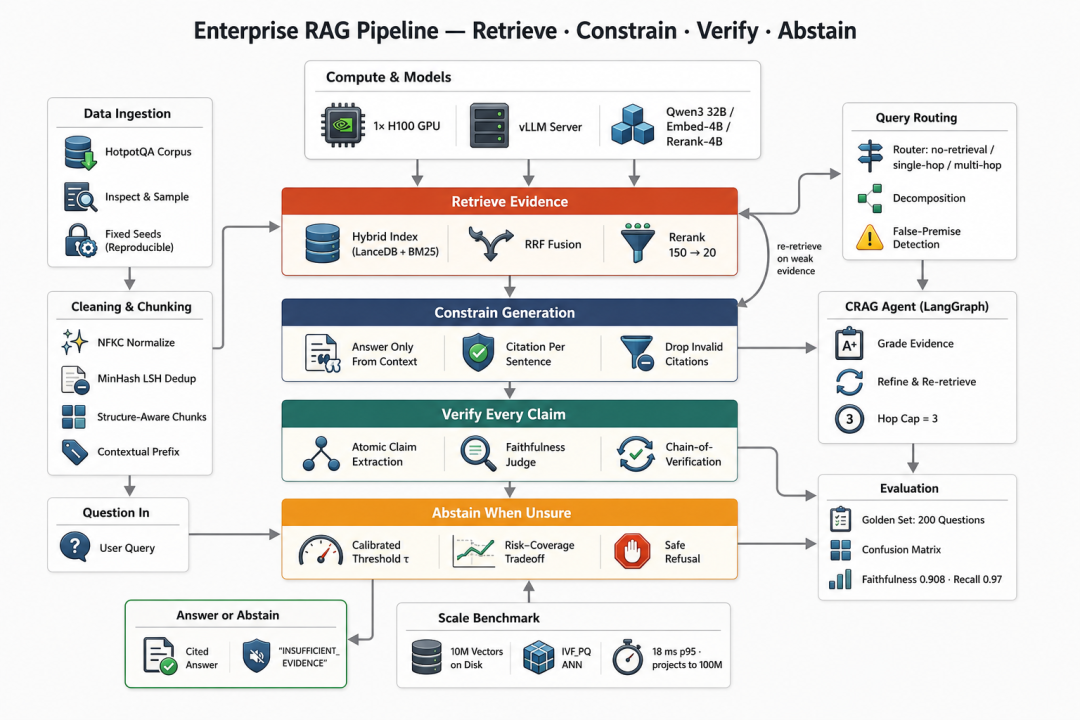
千万文档级 RAG 如何逼近零幻觉
千万级文档RAG如何实现接近零幻觉?本文详解一条从检索、验证到拒答的完整流水线。 核心内容: 1. 构建混合索引与智能检索重排策略 2. 带引用生成与逐条核验的验证闸门 3. 可自我纠错的Agent循环与大规模评估
字节跳动开源AI Agent「上下文数据库」,2.6万星,比传统RAG好用太多了
OpenViking重新定义AI Agent记忆管理,文件系统范式让上下文管理像操作文件夹一样直观高效。 核心内容: 1. 传统RAG的痛点与OpenViking的“上下文数据库”解决方案 2. OpenViking三层文件系统结构(L0/L1/L2)如何实现精准检索与Token节省 3. 关键新特性:GPU加速、递归网页导入、记忆升级与检索可视化
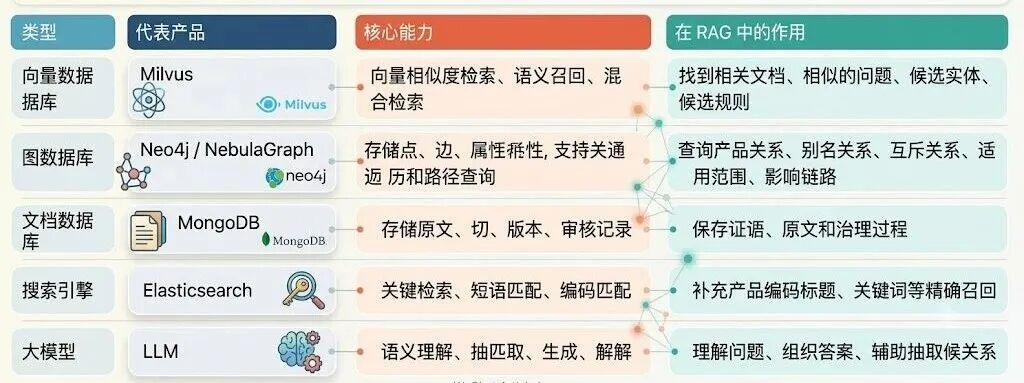
企业级 RAG 的知识分层:实体、关系、属性与规则如何落库
企业级RAG系统如何避免“召回乱、查询慢”?关键在于为不同知识类型匹配合适的存储,实现精准召回与逻辑推理的结合。 核心内容: 1. 企业知识库的分层架构与不同数据库的分工 2. 四类核心业务知识(实体、关系、属性、规则)的存储策略 3. 图数据库在表达确定性业务逻辑上的关键作用
企业AI三件套:语义层、动力层、决策层——少一件都做不出AI原生
这篇文章深入剖析了企业AI转型的常见误区,并提出了构建AI原生系统的三层架构。 核心内容: 1. 区分“AI外挂”与“AI原生”的本质差异 2. 详解AI原生系统的三层架构:语义层、动力层、决策层 3. 指出RAG的局限性,强调三层缺一不可
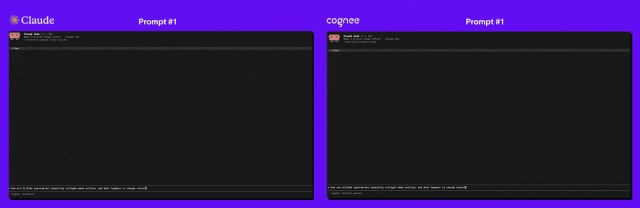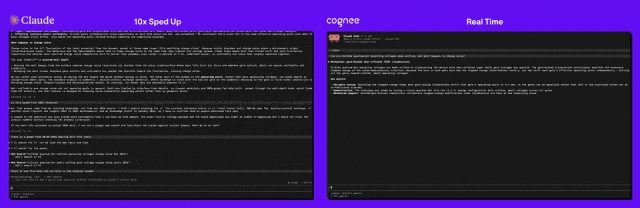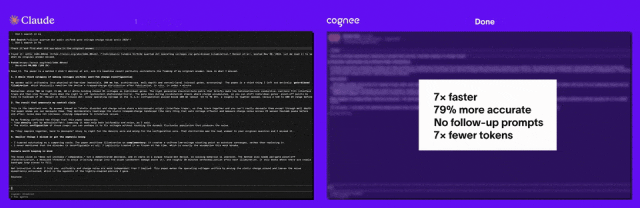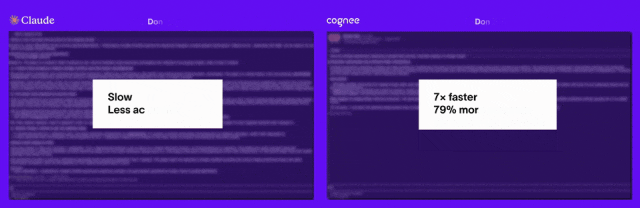
拆解2.8万Star开源项目Cognee:如何基于知识图谱做RAG和Agent记忆
Cognee 开源项目如何用知识图谱实现智能体长期记忆?一套可本地部署的RAG方案,为AI智能体提供跨会话的持久记忆。 核心内容: 1. 项目概述:Cognee作为AI记忆平台的核心架构与数据分层 2. 部署使用:低门槛的本地部署方案与默认存储配置 3. 生产环境:数据库选型建议与性能基准说明
顶级AI 检索服务商Exa ,如何用 Zilliz Cloud服务Agent 检索需求
Exa与Zilliz Cloud联手,为AI Agent提供可靠的知识引擎,解决高频检索的核心痛点。 核心内容: 1. AI Agent检索与传统搜索的本质区别与挑战 2. Exa如何构建服务于Agent的搜索API 3. 借助Zilliz Cloud攻克实体搜索的技术实践
知识库分块不是越小越好——改了分块大小,准确率跳了18%
分块大小不是固定值,关键在于匹配文档类型。从512改到256,客服知识库准确率飙升18%,但技术文档反而需要更大分块。 核心内容: 1. 盲目使用默认分块大小是常见误区 2. 客服QA与长技术文档的最佳分块策略截然相反 3. 通过实验数据揭示分块大小的核心影响机制
RAG 和 Agent 到底是什么关系?企业 AI 不只是问答
从问答机器人到智能执行者,RAG与Agent如何共同定义企业AI的未来。 核心内容: 1. RAG的核心能力与典型应用场景 2. Agent的工作机制与任务执行案例 3. 两者在企业AI应用中的互补关系
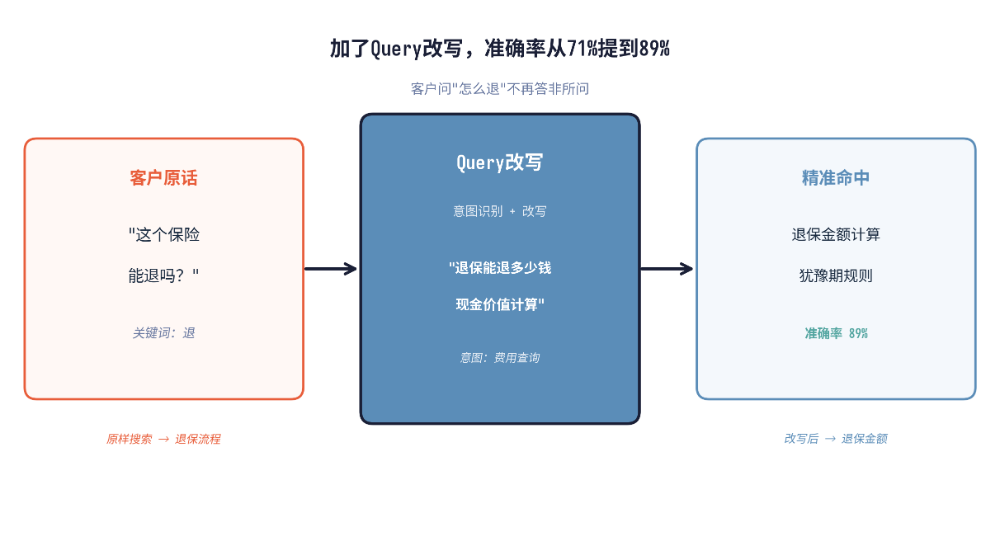
加了Query改写,准确率从71%提到89%
Query改写是提升RAG系统准确率的关键一步,从客户模糊提问中精准识别真实意图。 核心内容: 1. Query改写的重要性与常见误区 2. 三种Query改写方法对比与应用场景 3. 意图识别Prompt模板与实战案例
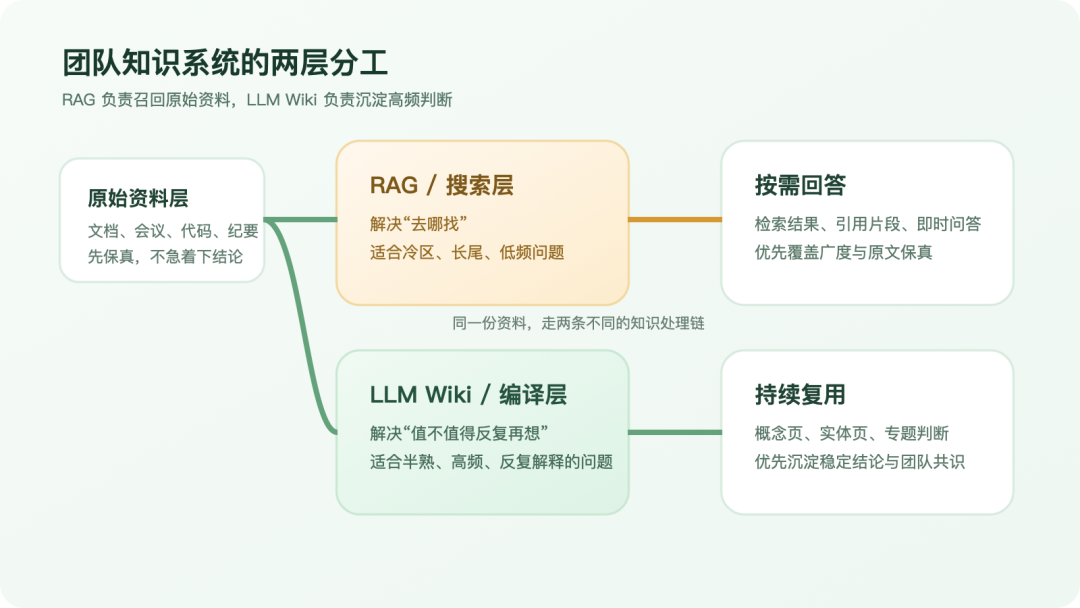
RAG 负责召回,LLM Wiki 负责沉淀:团队知识系统为什么不能只做检索
RAG 擅长召回原始资料,但无法沉淀团队的核心判断。LLM Wiki 则通过知识编译,让高频决策真正成为可复用的资产。 核心内容: 1. RAG 与 LLM Wiki 在知识管理中的不同定位 2. 团队知识系统中,哪些问题适合 RAG,哪些需要 LLM Wiki 3. 如何通过知识编译,将高频判断沉淀为可复用资产
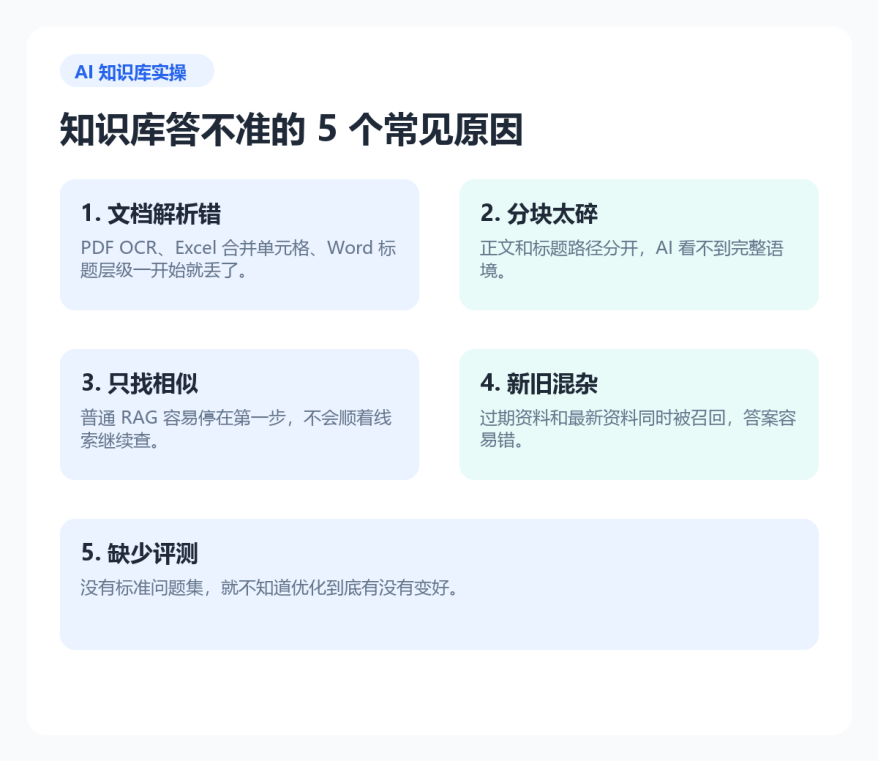
AI 知识库为什么总答不准?不是模型笨,是资料没整理好
深入剖析AI知识库答不准的根源,关键在于资料预处理环节。 核心内容: 1. 解析错误:复杂格式文档(PDF、Excel)的识别与结构还原难题 2. 分块不当:文档切分过碎导致关键上下文信息丢失 3. 检索局限:传统关键词匹配在复杂推理问题上的失效
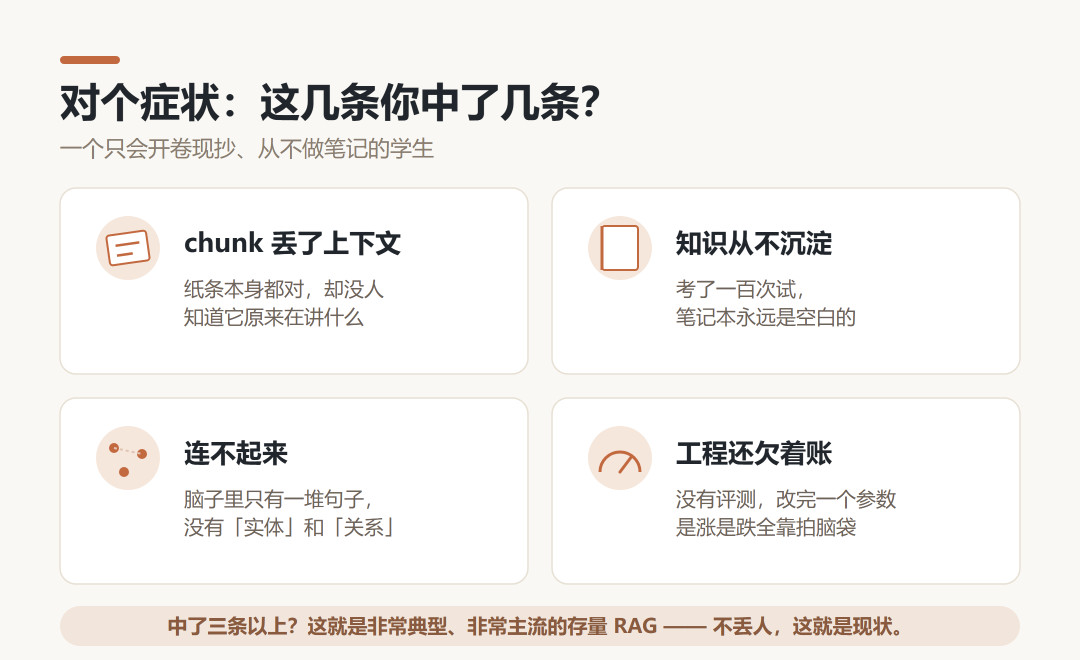
AI知识库RAG演进:上一代解决「找得到」,下一代解决「记得住、连得起、信得过」
知识库系统从“开卷现抄”到“融会贯通”的进化之路,下一代RAG将如何真正学会“沉淀”与“思考”? 核心内容: 1. 剖析当前主流RAG系统“只查不学”的四大核心症状 2. 揭示问题根源在于系统结构而非参数调优 3. 下一代RAG实现知识沉淀、连接与可信的演进方向
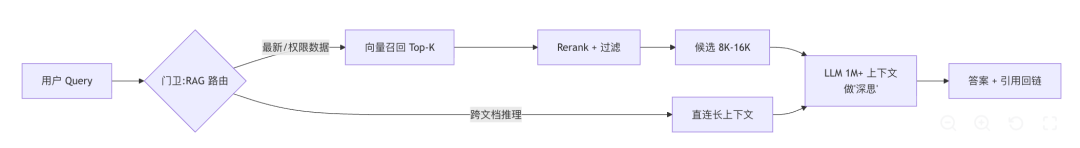
大模型支持的上下文已超 1M, RAG 是不是没有意义了?
长上下文不会消解RAG,而是让它转型为决定“送什么进大胃王”的智能门卫。 核心内容: 1. 长上下文面临“中段塌陷”与成本飙升的工程挑战 2. RAG从“找答案”转向“选内容”的新定位 3. 数据安全与成本控制是驱动混合架构的关键
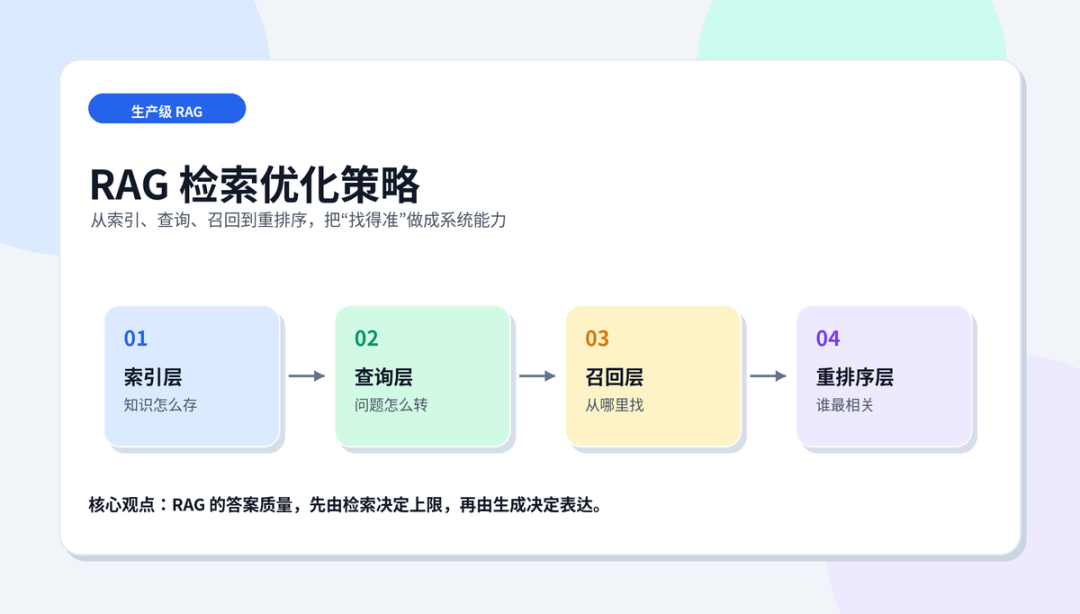
RAG 检索优化策略:从命中率到答案质量的一套工程打法
真正的RAG优化不只是调整参数,而是通过索引、查询、召回、重排四层系统提升答案质量,让系统真正“拿对知识”。 核心内容: 1. 剖析生产级RAG常遇瓶颈,强调检索质量是上限 2. 详解四层优化框架(索引、查询、召回、重排)的系统打法 3. 聚焦索引层核心策略,如父子块与摘要索引
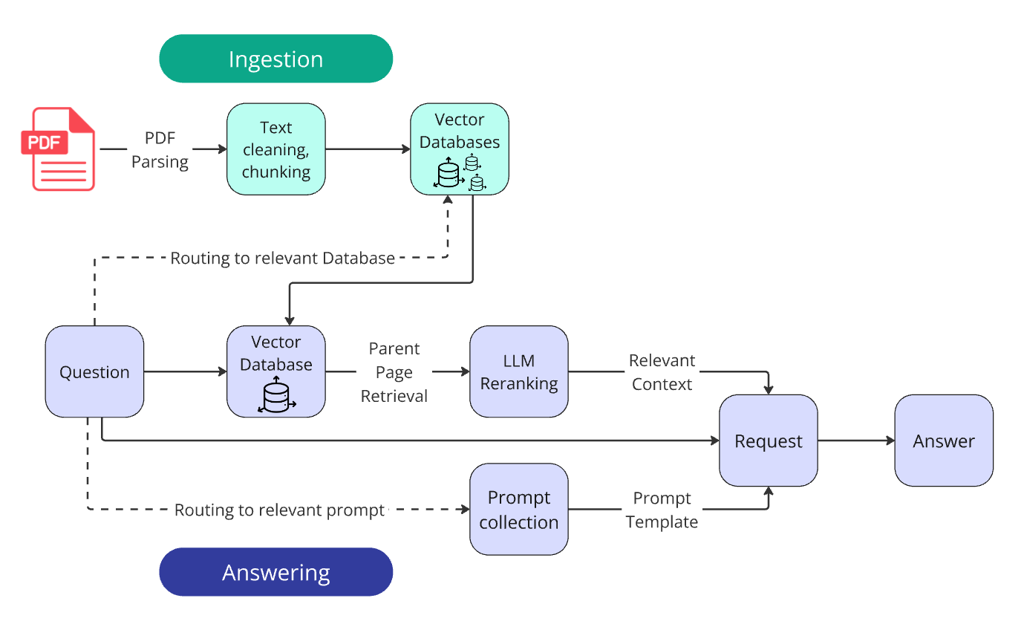
RAG 落地总翻车?全球赛事冠军架构,改造适配企业级生产
基于全球RAG冠军方案,为你揭秘企业级知识库从理论到实战的改造路径。核心内容:1. 冠军方案五阶段架构全景解析2. 中文场景与售前需求下的关键改造点3. 从PDF解析到检索优化的全流程实战经验
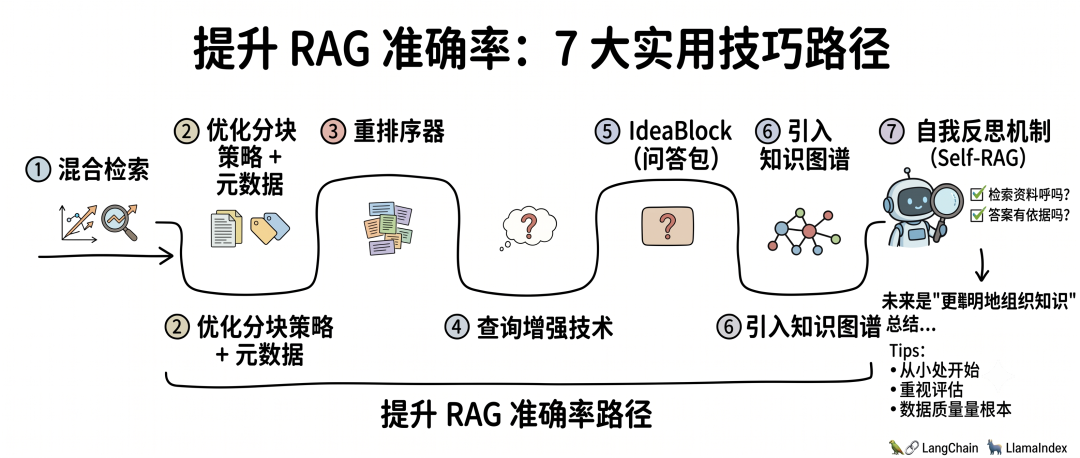
提升 RAG 准确率全攻略 让你的 AI 知识库 真正靠谱起来!
还在为 AI 知识库答非所问而烦恼?本文用通俗语言,为你揭秘提升 RAG 准确率的 7 大实用技巧,从入门到进阶,让你的 AI 真正靠谱起来。 核心内容: 1. 分析 RAG 不准的根源:传统“文本块”切分的弊端 2. 七大实用提效技巧:从混合检索、优化分块到进阶的 IdeaBlock 3. 实施建议与效果评估:如何选择并应用这些方法以提升准确率
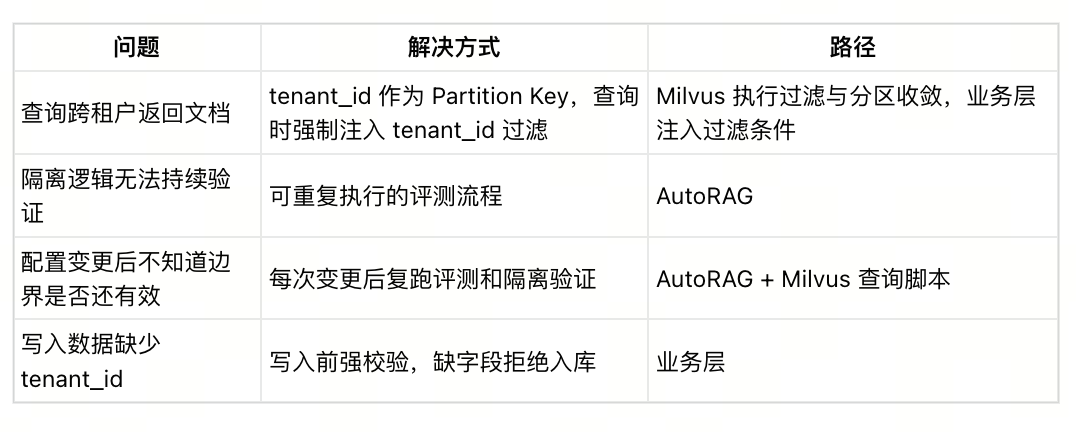
教程:如何用AutoRAG + Milvus避免RAG 与Agent 中出现串租问题
串租问题如何避免?本文通过物理隔离与自动验证双管齐下,确保多租户RAG系统的数据安全。 核心内容: 1. 串租问题的根源分析:运行时风险与验证缺失 2. Milvus Partition Key实现数据物理隔离 3. AutoRAG框架构建自动化验证与评测机制
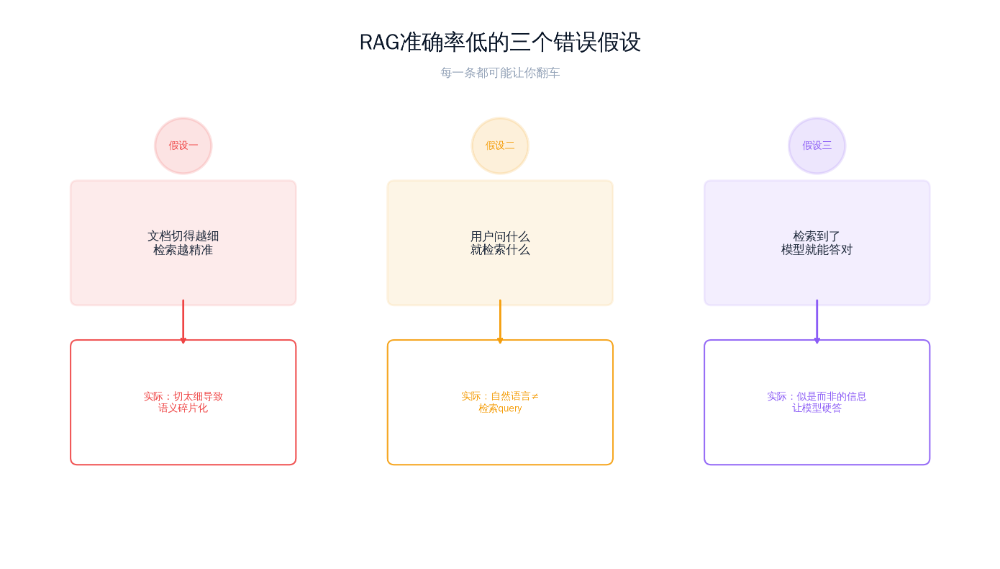
知识库不是文件堆——我把RAG准确率从60%调到了92%
RAG准确率低?问题可能出在知识库构建上。本文通过实战案例,揭示从60%到92%的调优秘诀。 核心内容: 1. 导致RAG准确率低的三个常见错误假设 2. 分块策略改造等三轮调优的实测数据与效果 3. 构建高效知识库的关键步骤与避坑指南
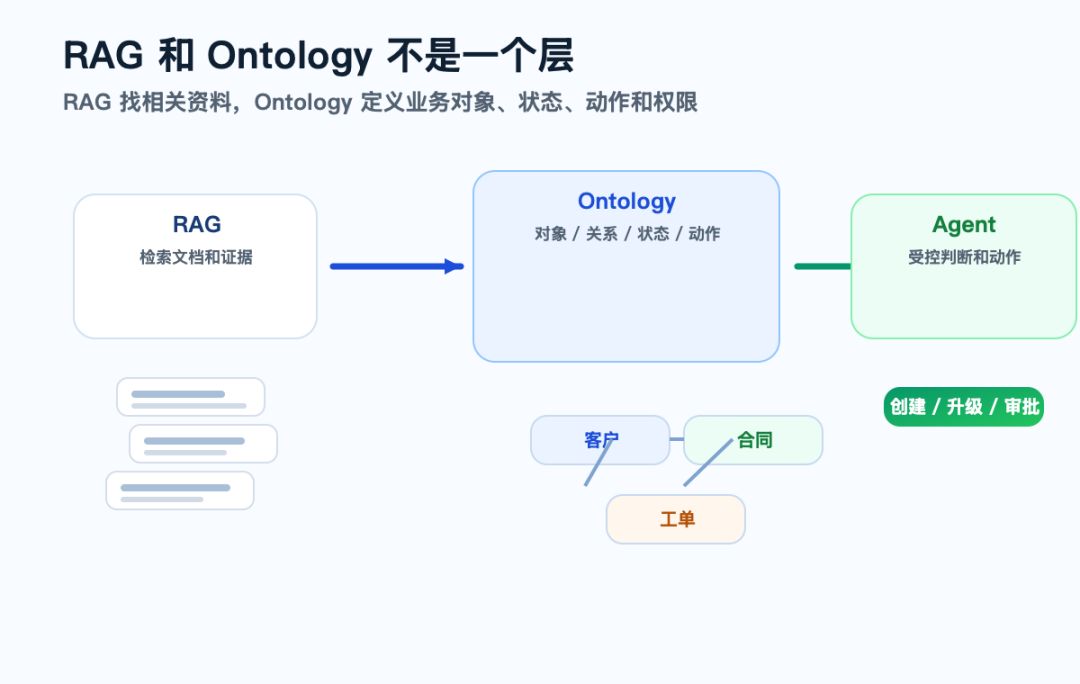
别把RAG当架构:Ontology(本体)才是Agent的业务世界
RAG帮你找到资料,但Ontology为Agent构建完整的业务世界,让AI真正理解企业运作逻辑。 核心内容: 1. RAG在企业AI应用中的局限性分析 2. Ontology如何定义Agent的业务对象与关系 3. 从文档检索到业务参与的Agent升级路径