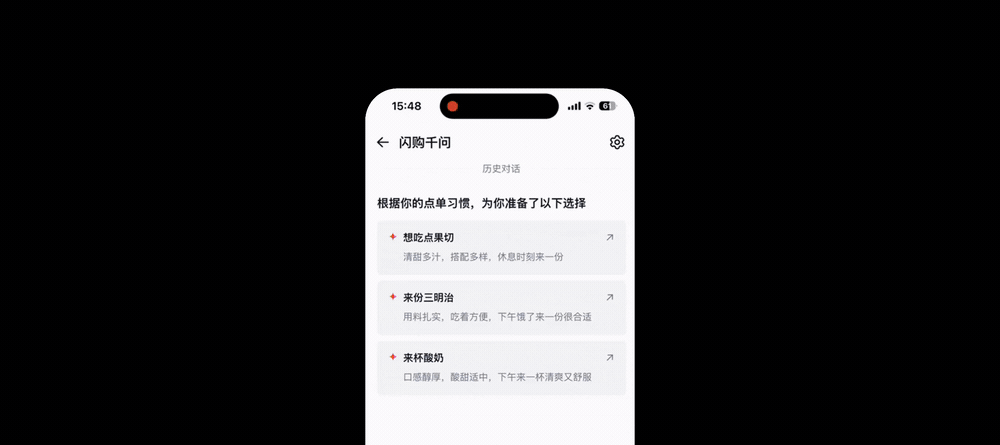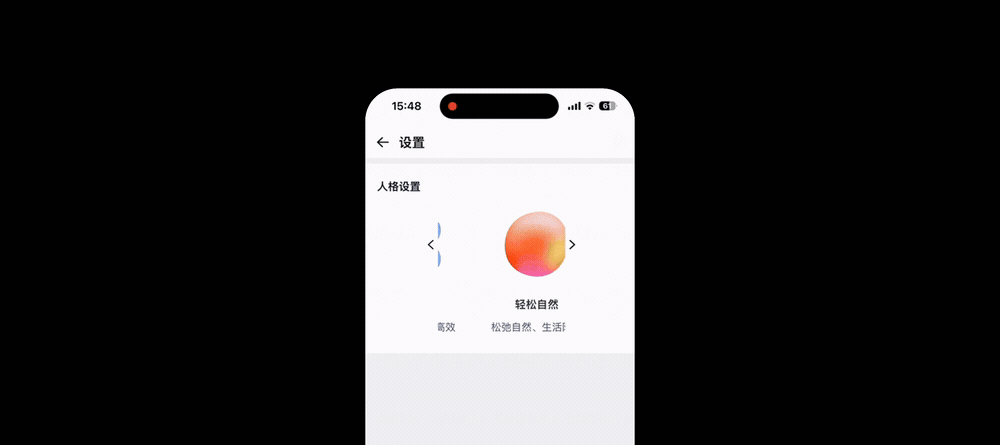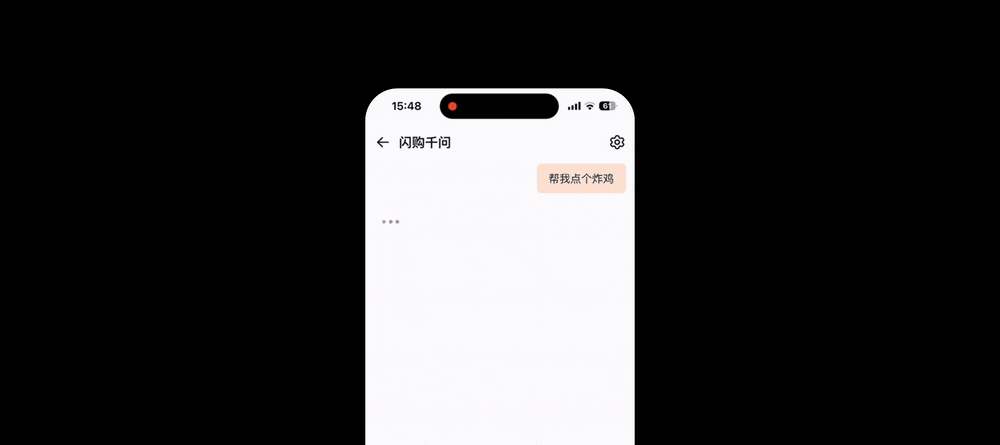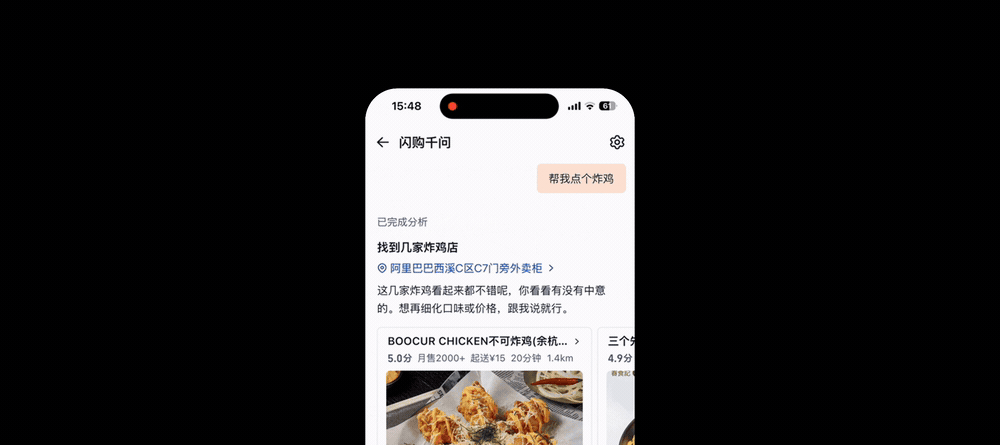
【技术分享】面向 Agent 场景的千问端侧推理优化实践
深度拆解千问面向Agent场景的端侧推理优化实践,技术干货满满。 核心内容: 1. 面向Agent的端侧推理场景定位、分工逻辑与核心价值梳理 2. 端侧推理面临的容量、算力、带宽等多重系统瓶颈拆解 3. 适配Agent场景的低比特量化、模型卸载等系列优化方案介绍
让模型装得下,只是第一步。真正的难点,是让它在 Agent 的多轮任务里稳定、快速地跑起来。
一台普通终端要承接 Agent 任务,面对的通常不是单点性能问题。模型权重可能超出显存,长输入会拉高首次响应时延;即便能够稳定生成,工具调用后的下一轮推理,又可能把相同的上下文重算一遍。
千问事业部 Infra 团队将端侧推理视为模型、存储与任务流程共同参与的系统工程。围绕 Qwen3.6-35B-A3B,我们先用低比特量化降低容量与访存需求,再用专家预测和异步预取控制卸载代价,最后通过前缀缓存与投机解码减少 Agent 多轮执行的等待。
目标不是"能跑就行",而是在效果、容量、时延三者之间找到一个够用的平衡点。
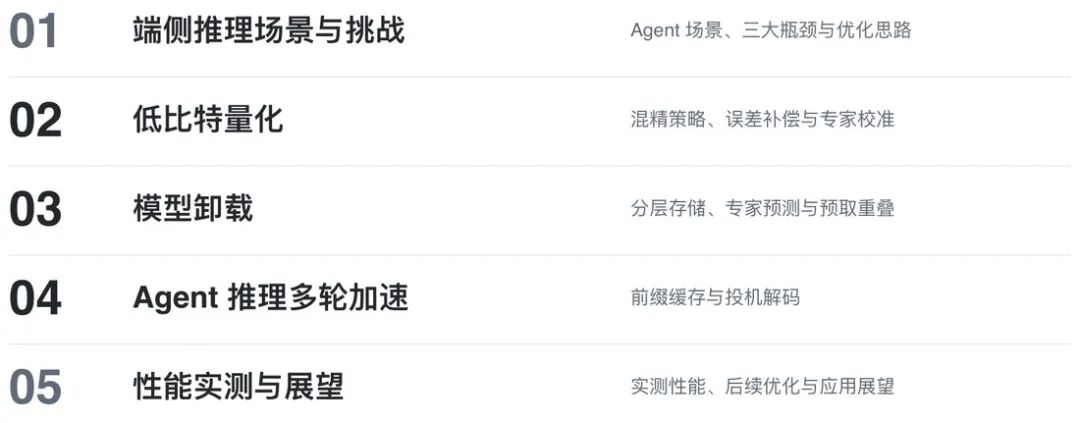
这条技术路线覆盖场景与挑战、低比特量化、模型卸载、Agent 多轮加速和实测结果。终端不必包办所有任务,但应当承接适合留在用户身边的那一部分。
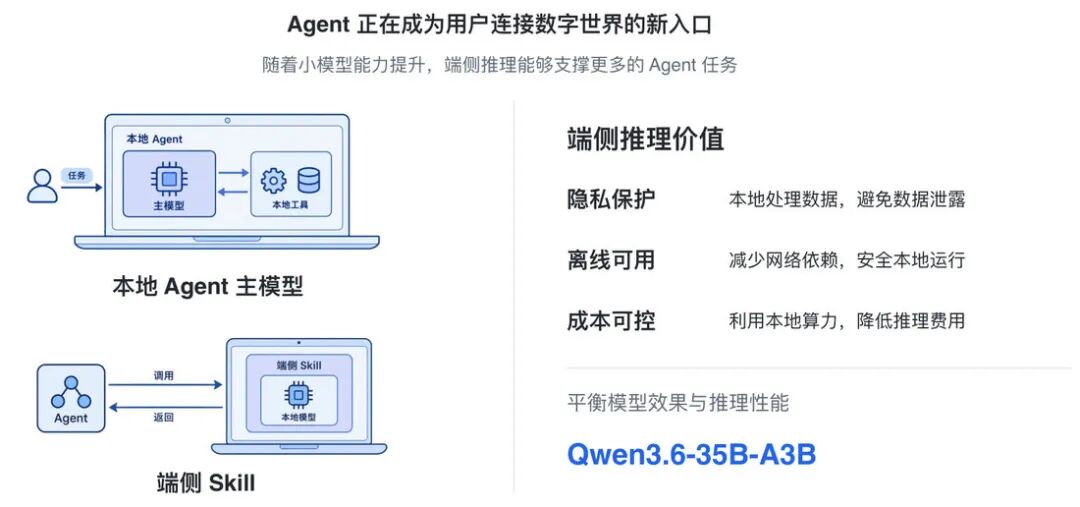
一是做本地 Agent 的主模型——直接配合本地工具处理文档、做 PPT、改 Excel,推理和操作都在用户设备上闭环。
二是当云端 Agent 的端侧 Skill——高频任务丢给本地跑,敏感数据先在本地脱敏再上云。不是"端还是云"的二选一,而是在任务链路里划清各自该干什么。
两种角色对应三个产品价值:隐私保护、离线可用、省云端 Token。但要澄清一点:本地部署 ≠ 全链路离线,也不意味着数据完全不上传。边界取决于工具是否联网、端云之间传了什么。
所以,评估端侧推理的价值别只盯参数量。模型能在本地搞定敏感处理、能稳定接住高频操作,就已经在 Agent 链路里发挥了作用。剩下的问题就是:怎么让它在消费级硬件上跑得够快。
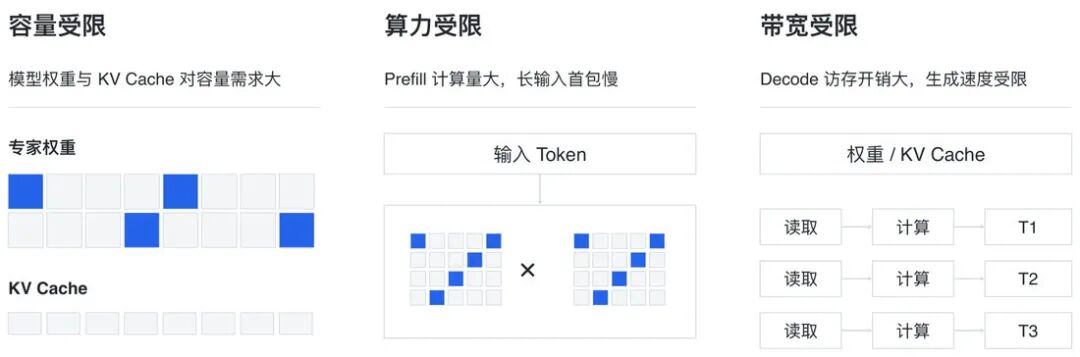
容量限制决定模型能不能装下,算力与带宽限制决定用户要等多久。
模型权重和 KV Cache 都需要空间;而设备上可用于推理的显存、内存,通常远小于云端服务器。
在 Prefill 阶段,模型需要处理输入上下文。长输入带来的计算量,会直接影响首次响应。到了 Decode 阶段,模型逐步生成 Token,权重读取和 KV Cache 访问又会限制生成速度。如果引入模型卸载,跨存储层级的数据搬运还还会成为额外瓶颈。
这就是为什么"压缩模型"不是万能药:量化能缩体积、减读取,但消不掉长输入的计算量,也替 Agent 省不了多轮重复处理。
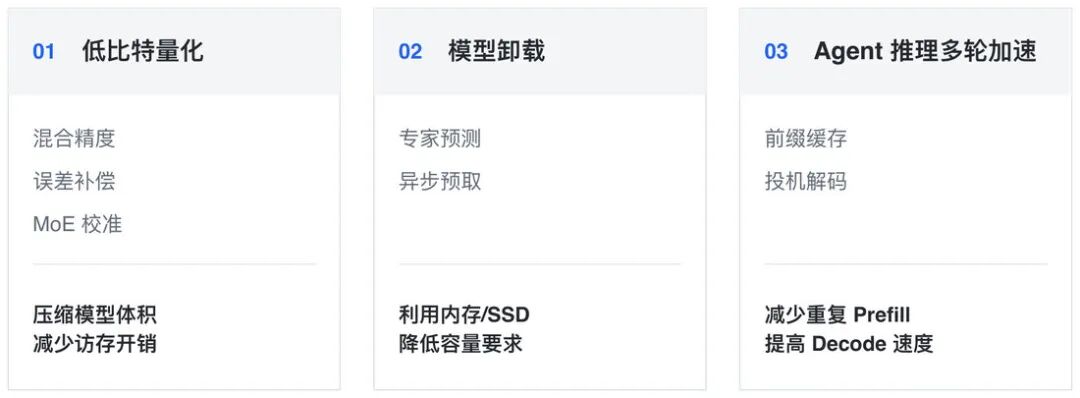
我们选择了三项相互衔接的优化:低比特量化先减少必须存储和搬运的数据;模型卸载利用显存、系统内存与 SSD 扩大可部署范围;Agent 多轮加速则减少重复 Prefill,并降低 Decode 的实际成本。
每解一层约束就会引入新代价:量化要保效果,卸载要控搬运延迟,投机解码不能让草稿成本反噬收益。
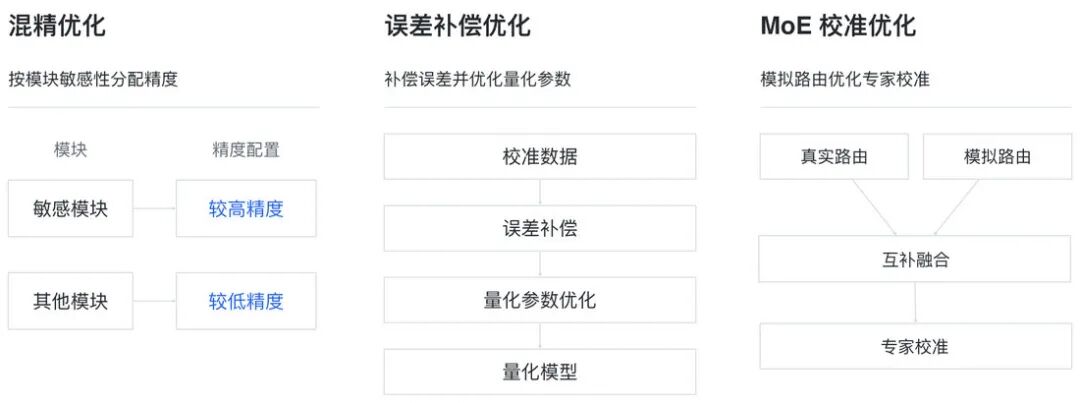
量化最直观的好处就是模型变小。但比特越低,误差预算越紧。我们没有一刀切地把所有权重压到同一精度,而是把精度分配、误差补偿、MoE 专家校准三件事一起解决。
不同层、不同模块对量化误差的敏感度差异很大。我们的做法:前后敏感层保留高精度,MoE Router 也用高精度;中间层和其他不太敏感的权重,往更低比特压。
Router 尤其不能动。它决定 Token 分给哪些专家,量化误差一旦影响 Router,不光专家计算结果会变,连专家选择都会跑偏。保住 Router 精度,就是为了把路由偏移压到最小。平均比特数相近,不代表精度配置相同,更不代表最终效果相同。
混合精度解决"哪些地方值得多给比特",误差补偿解决"压完之后怎么补救",两者互补而非替代。我们在混合精度基础上引入 GPTQ 类误差补偿,进一步压低权重压缩对输出的影响。
需要补偿的不只是当前层的局部误差——上游量化会改变后续层的输入分布,逐层顺序量化还会累积残差。为此我们引入 BF16 原始模型的二阶统计信息,在端侧格式下同时处理这两类误差。
联合编码把多个权重绑在同一组约束里——共享一套编码、scale 和 offset。这意味着针对单个权重的 GPTQ 式优化,未必能让整组权重的量化结果变好,编码和解码过程本身也得纳入优化。
我们让编码与 scale、offset 交替优化,把权重更新约束在联合编码格式内。目标不是把某个权重调得更准,而是在共享表示的约束下让整组权重的量化质量更高。
MoE 还有个容易踩的坑:校准数据不会均匀地访问所有专家。高频专家校准充分,低频专家可能因为样本不够,量化误差偏大。
我们引入模拟路由等手段提高校准覆盖率——真实路由和模拟路由互补融合。这一步关注的不是平均激活率,而是确保没有专家在压缩过程中被"遗忘"。
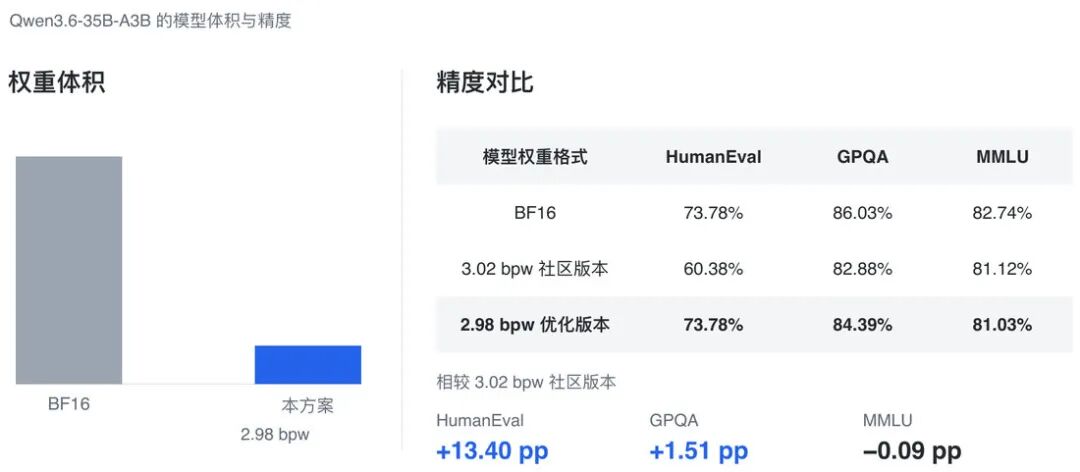
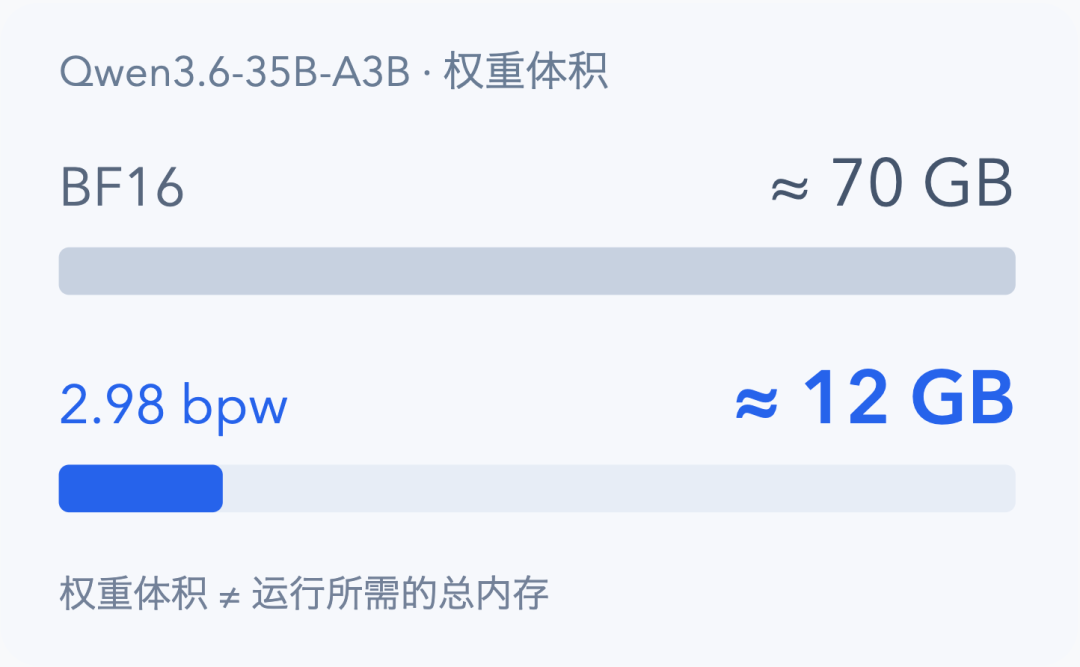
Qwen3.6-35B-A3B 这组实验中,权重从约 70 GB 压到约 12 GB。我们的优化版本 2.98 bpw,对比的社区版本 3.02 bpw(bpw = 平均每个权重的比特数,不代表所有模块精度一致)。
相比所对比的社区版本,优化版本的 HumanEval 提升 13.40 个百分点,GPQA 提升 1.51 个百分点,MMLU 则下降 0.09 个百分点。提升并不均匀,但能说明了一点:低比特量化的效果,取决于具体配置与校准,而不只取决于比特数。
对比 BF16 原始模型:HumanEval 持平,GPQA 和 MMLU 分别下降 1.64、1.71 个百分点。团队总结的"平均精度下降小于 1%"有其特定的评测范围和计算方式,不能从表中三项简单平均推出。更准确的理解是:在体积大幅缩小的前提下,尽可能保留模型能力——这不是"无损量化"。
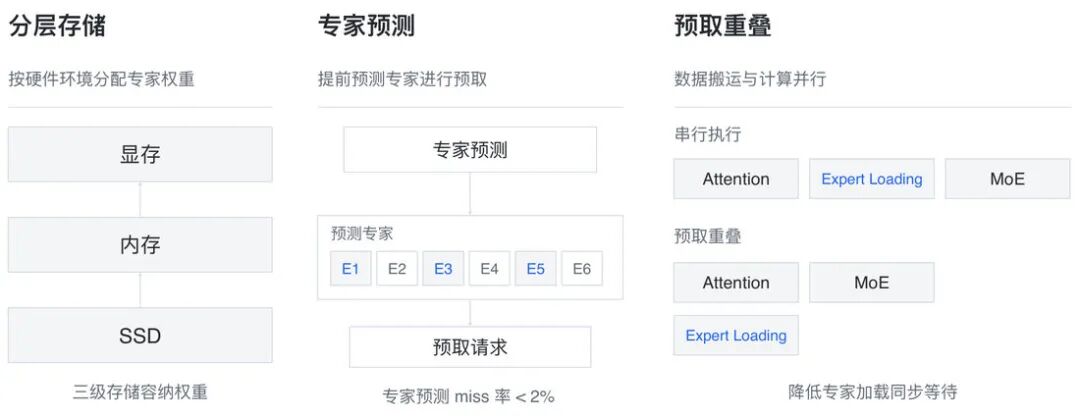
压缩到约 12 GB 之后,模型仍可能超出部分设备的显存容量。我们因此采用分层存储:有独立显卡时,让 GPU 显存与系统内存协同;没有独立显卡时,可以让系统内存与 SSD 协同;必要时,三个层级共同容纳权重。
不过 MoE 的稀疏激活不等于权重不占空间——把部分专家放到更慢的存储层,只是把"装不下"变成了"什么时候搬、搬哪些"的调度问题。
如果等到某个专家真正被需要时才加载,计算就可能停下来等权重。我们利用当前层的 Hidden State,预测后续若干层可能使用的专家,并提前发起预取。在 GPU 推理场景中,相关权重会提前加载进显存。
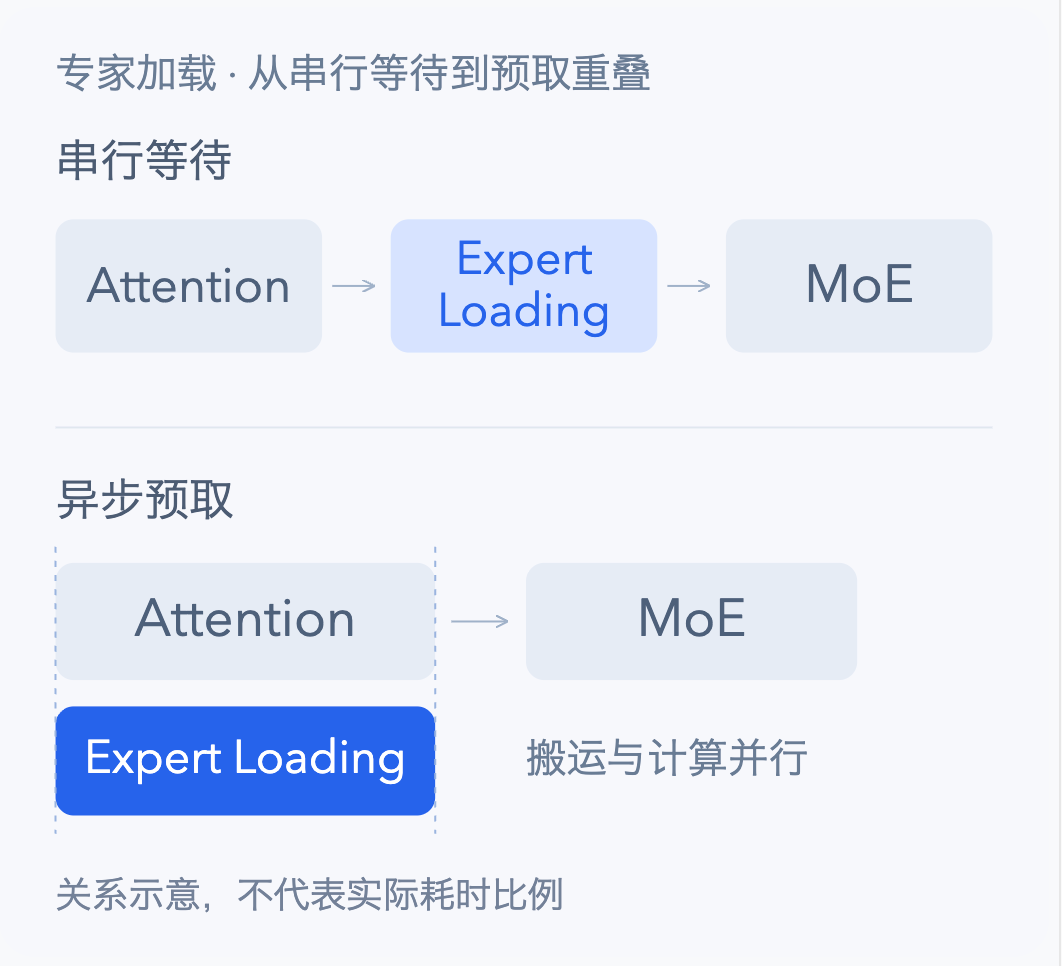
同时让数据传输和计算重叠:当前层还在算,后台已经在搬下一批数据。原本串行的"Attention → Expert Loading → MoE"变成专家加载与计算并行,减少同步等待。
这里有两个前提缺一不可:预测得准,搬运还得够快。预测错了要补载;预测对了但数据没及时到位,等待照样卡在关键路径上。
8 GB 显存 + 16 GB 系统内存
在 RTX 5060 Laptop(8 GB 显存)与 16 GB 系统内存的测试配置下,专家 Miss 率低于 2%,推理性能达到不卸载时的 95%。
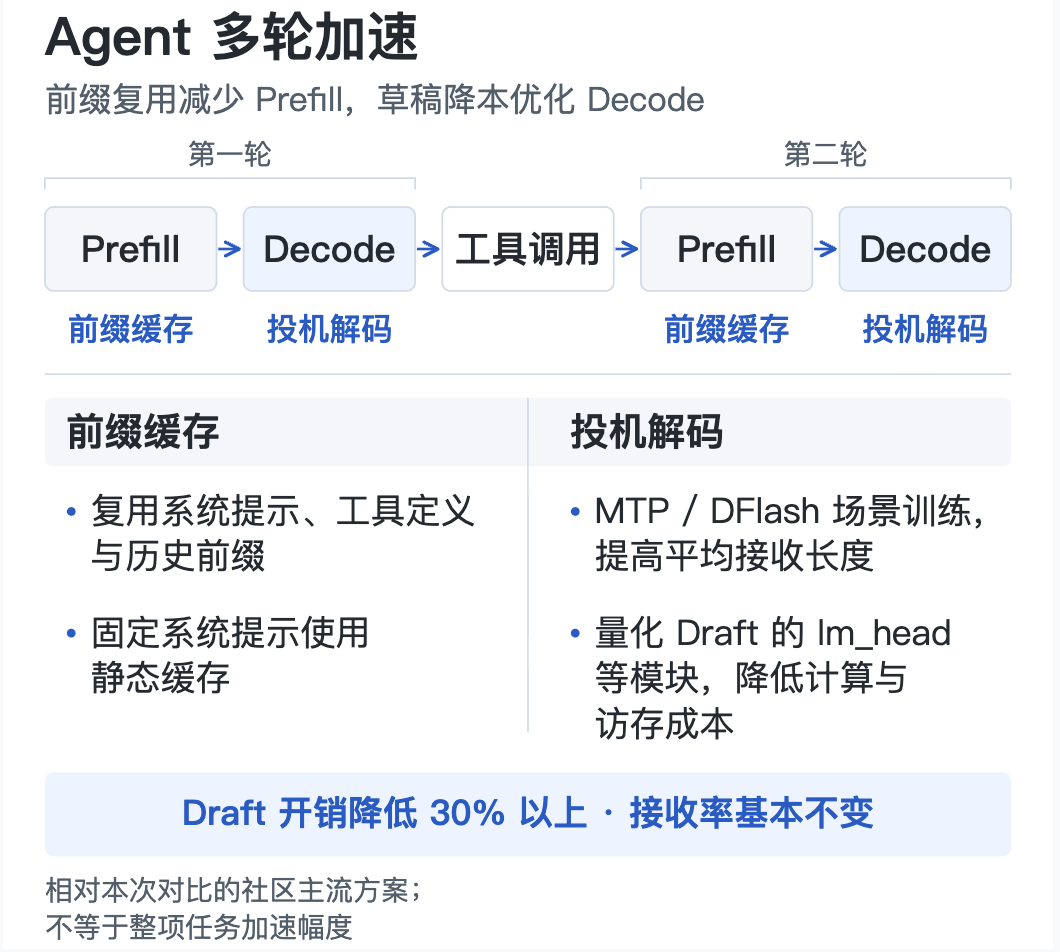
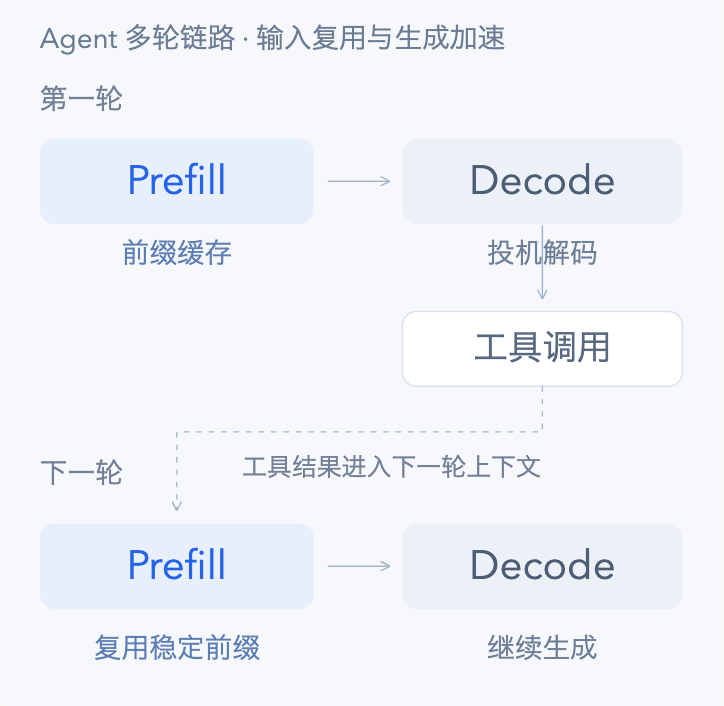
Agent 的任务耗时是多轮推理和工具执行一层层叠出来的。模型处理上下文、生成内容或工具调用,工具返回结果后进入下一轮。单轮速度再快,重复的输入处理和草稿开销也会拖慢整体。
系统提示、工具定义、部分历史上下文在多轮请求中反复出现。前缀缓存复用这些稳定内容的计算结果,命中就不用重算。固定系统提示我们还加了静态缓存,进一步压缩首响等待。
这里的关键是「稳定前缀」和「缓存命中」。注意:前缀缓存跳过的只是已经算过的那段,新工具结果和新输入仍然要正常处理。
在生成阶段,我们按设备情况采用 MTP、DFlash 等投机解码方案,并针对场景数据集训练 Draft 模型,提高候选 Token 的平均接收长度。
投机解码先产生候选,再由目标模型验证。它有机会用一轮验证推进多个 Token,但 Draft 本身也要计算。因此,即便候选接收情况很好,只要草稿生成成本过高,仍会抵消一部分收益。
我们进一步对 Draft 模型的 lm_head 等模块进行量化压缩,降低草稿生成的计算与访存成本。工程目标不是只追求更高的接收率,而是让被接收的候选 Token,以更低的成本生成。
对比社区主流方案,优化后 Draft 开销降低 30% 以上,接收率基本不变。注意这里降的是草稿阶段的开销,不能直接等同于整模型或整任务的同比例加速。
投机解码要比较的是:每轮实际接受了多少 Token,以及为这批 Token 支付了多少草稿、验证与调度成本。只看接收率,会漏掉另一半账。
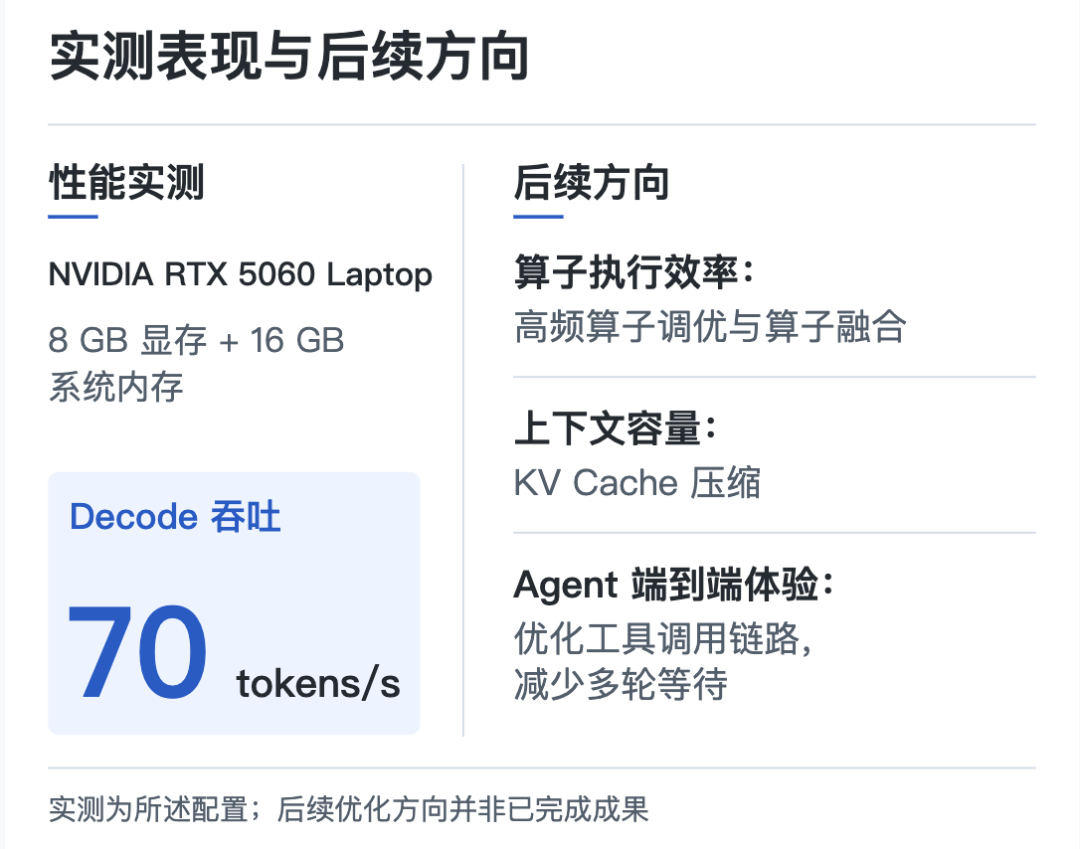
完成上述优化后,我们在 NVIDIA RTX 5060 Laptop(8 GB 显存)与 16 GB 系统内存的测试配置下,Decode 吞吐达到 70 tokens/s,基本满足目标场景的使用需求。这为端侧日常使用提供了可行性证据。
但 70 tokens/s 描述的是 Decode 吞吐,不等于首响时延,也不等于 Agent 任务端到端耗时。长输入 Prefill、工具执行、多轮往返仍然会占掉用户等待时间。
所以下一步不会只盯单项吞吐:一是联合硬件厂商调优高频算子、推进算子融合,降低计算和访存开销;二是继续压缩 KV Cache,让有限资源撑更长上下文;三是优化工具调用链路,减少推理、执行、交互之间的等待。
三个方向分别对应计算效率、上下文容量和任务链路——还是那个系统视角,只是接下来要啃的硬骨头。
回到端侧推理的目标:隐私数据可以更多地留在本地,具备离线条件的任务可以本地执行,端云协同也可以减少云端调用。但这些价值要成立,前提是模型能在终端资源约束下,稳定地完成真实工作。
这次实践最大的收获,是把模型压缩、专家搬运、多轮加速放在同一条任务链路里统一衡量。量化让部署更轻,卸载让容量更宽,缓存和投机解码让等待更短。最终要交付的不是一串漂亮的单项指标,而是用户真正用得起来的端侧智能。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们