个性化视频技术:历时七年的算法演进
本文系统梳理了短视频平台个性化视频技术七年演进路径,聚焦服务端与客户端协同优化:服务端通过VLP模型预测视频价值指导转码与CDN调度,UIAE实现用户-视频粒度的动态档位组合决策,CDNPilot与TACO分别推进CDN预热和带宽峰值调控;客户端则从固定预加载发展为Demand统一IO决策及Vision实时播放选档,整体以QoE与成本平衡为目标,强调算法、运筹与音视频工程的深度耦合。
个性化视频技术:历时七年的算法演进
首度揭示!个性化视频技术——短视频体验的秘密!
(https://juejin.cn/post/7439556806602752051)Personalized Playback Technology: How Short Video Services Create Excellent User Experience(https://arxiv.org/abs/2410.17073)
与相对“传统”的音视频工作相比,个性化视频技术同时追求算法的实际价值、创新度与复杂度,因此在常规的优化武库之外,会将视野投向包括大型推荐模型、强化学习、控制论、因果推断、运筹优化、认知科学等在内所有具备潜在可能的技术,令其与音视频技术结合,交融并汇,才有希望达成“具备跨代、量级差距”的效果。
服务端:从单点规则到系统运筹
2.1 视频价值预测:VLP
VLP(Video Lifecycle Prediction)是大型短视频服务需要回答的一个基础问题:每个视频(预期)到底值多少钱?这个值将决定转码资源的分配优先级、CDN 缓存策略和分发权重,甚至影响前处理流程、内容理解的推理预算。每天抖音有几千万到上亿条视频上传,传播与消费价值差异巨大,需要模型对每条视频的未来价值(vv、播放时长)做出预测,才能更精确地决定在后续链路上如何处理与干预。
抖音或其他短视频 App 的生产-消费模式,均处于一种基尼系数极高的情况,极少的视频投稿就可以覆盖多半以上的视频播放,而由于大量对视频的处理——例如转码、前处理、内容理解——十分昂贵,在满足基础服务及内容安全要求的前提下,提高大规模视频处理系统的整体效率成其为必然。
本质上,虽与 Ranking 或 CTR 问题有别,VLP 面对的仍是一种高精度的预测问题,适合用与推荐、商业化等领域相近的解法,因此有参考许多字节内外推荐团队的工作,未来的思路也会尽力与推荐、计算广告等领域的前沿工作对齐,吸纳其在建模、模型结构、特征运用、样本分析等方面的进展,并针对音视频领域调整。
VLP v1(2021)让视频价值第一次在音视频链路中高精度地被计算出来,此前业务只能按粉丝数、历史播放vv做规则排序——也是业界的习惯做法,一些视频服务曾构建过预测服务但精度甚低,VLP v1 搭建了完整类推荐的召回、排序链路,引入数十个作者、视频特征,用排序模型把价值预估变为监督学习,将输出归一化到 0~1 的热度分供转码排序使用。VLP v3(2023)第一次使用超大规模稀疏 DNN 并支持天级更新,稀疏特征经 Embedding 拼接后送入多层前馈网络,用 LHUC 方式依据作者/类目表征生成取值 [0, 2] 的逐层缩放向量做个性化调制,以 BIAS 让关键特征直连输出层(wide & deep 思想),同时从「单一价值分」升级为多任务,一个模型同时预测未来 1d/3h 的 vv、完播、播放时长等目标,并用 GradNorm 自适应平衡各任务损失:
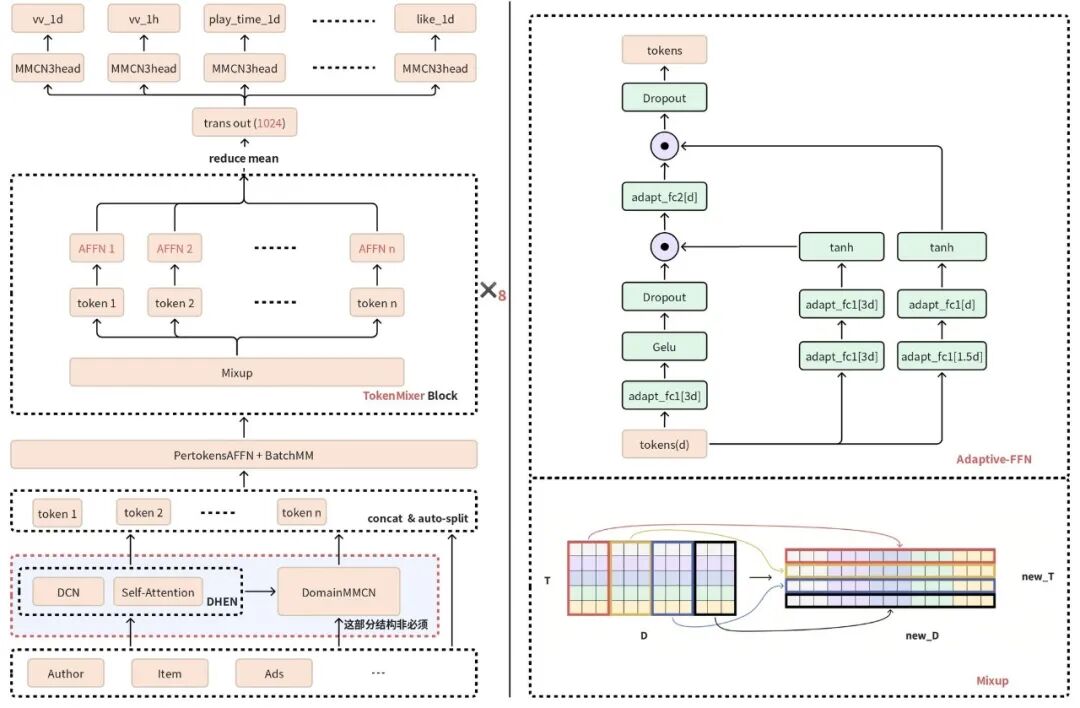
配合模型复杂度提升,v8 在特征侧同步做了大幅度扩展,新增了数十个 LLM 挖掘特征(视频互动水平、投稿信息、作者生态等),基于视频内容理解大模型生产的 124 个高阶语义特征(音视频画质、美学、结构、热度分析、...),接入多模态 Embedding 和投稿侧序列特征等。此外,拆分了 CAPP(Content and Creator Profile-Aware Popularity Prediction)模型作为 0vv 冷启动场景的补充,专门解决新视频在无历史数据时的流行度预测问题。
2.2 档位组合决策:UIAE
档位组合解决「给每个视频转几个版本、每个版本什么规格」的问题,由于视频压缩基本不可瞬时完成的特性,对同一源片提前准备多个码率/档位视频给不同用户(或同用户的不同访问时段)消费,以求取更高的用户体验,是行业惯例。
与 Content Aware Encoding 内容感知编码受到「传统」音视频算法工程师的关注不同,由我司参考 Brightcove 公司Context Aware Encoding 概念所开创的档位组合(UIAE 及其前序技术)方案视野更投向链路乃至业务的整体最优,首次令服务端与客户端的音视频链路得以形式化的方式串联到一起,将优化目标与终极目标重新塑造一致并统筹优化,是个性化视频领域的基石技术之一。个性化视频技术追求全链路精确可计算、全链路最优化,UIAE 的发展将视频处理与用户未来动态的选择进行链接,支持精确预测与在线运筹,指向全链路的理论上限。
UIAE(User-Item Aware Encoding)前序使用的方案主要采用离线预计算出的固定档位组合,在不同国家和地区均曾取得良好收益,而 UIAE 的思路是,根据用户播放行为和视频编码特性,实时地动态输出可变组合,同时把决策粒度从「群体统计」推进到「用户×视频」,在转码成本约束下最大化个体期望体验:
c* = arg maxc E[QoE(u,i,c)], s.t. Cost(c) ≤ B(u,i)
其中 QoE 可视为画质、卡顿、首帧三项 QoS 的组合,当视频价值上升触发「加转」时会触发重新计算:
Q* = max{Ri} ∑i=1n pi[α1 Quality(Ri) + α2 Rebuffer(Ri) + α3 FFdur(Ri)]
s.t. Bmin ≤ B(Ri) ≤ Bmax, |B(Ri+1)−B(Ri)| ≤ Bgap, Nmin ≤ n ≤ Nmax
参考:A User-Item Aware Encoding Framework for Short Video
UIAE v1(2024)把前序方案的固定组合改为模型预测的可变组合,将问题建模为带约束的最优化,以各档位的播放概率 p(R) 对体验加权求期望,在码率区间、相邻档位码率差、档位数量与 CRF 等约束下选出期望 QoE 最高的一组档位,简化来看,QoE 可视为画质、卡顿、首帧三项 QoS 的组合,当视频价值上升触发「加转」时会触发重新计算:
S = ConvexHullRD({R}) ⟹ {c1,...,cM}
c* = arg maxc∈S QoE(c), QoE(c)=∑kαk(scene)QoSk(c), QoSk ∈ {mVMAF, Bitrate, Rebuffer}
指数项是编码耗时对收益的折损(价值按未来 24/3 小时计,编码过程不计收益),并将原本独立的两条编码器队列合并为混合调度,按拥堵程度动态分配普通档位与档位组合的资源比例。
Reward v3(2025)转向解决高价值档位的重复转码,用小时级时序价值分二次推断能否达到阈值(阈值取 0.8 时准确率超 90%),新增 0vv 价值分,同时把 UIAE 触发门槛降低下来,优化了长视频与转码耗时的 trade-off。但 v3 仍有部分瓶颈,决策范围窄、粒度粗、容量调节被动滞后(仅凭回传队列长度后验调整,恢复慢)。
Reward v4(2026)针对以上瓶颈升级,调度范围扩到所有线上档位(包含 UIAE 档位),而目标函数精细到视频粒度:
Reward = Income(QoE) − Cost
= max ∑i∈V,j∈ladders video_value[i] ⋅ ℱ(encode_time[i][j]) ⋅ { a ⋅ Δ BW[i][j] + b ⋅ mVMAF[i][j] } ⋅ γ
s.t. ∑i,j cost(i,j) ≤ TotalAvailableCost
其中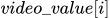 由 VLP 预测,
 与
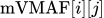 由多目标模型预估,
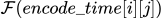 为耗时折损函数(对预期高峰 vv 却需较长转码的任务加大惩罚,因档位转出前无播放收益),𝓇 为仅作用于 UIAE 的经验权重,用于提升提交 UIAE 档位倾向的超参数。
容量侧用 G/G/1 排队论建模转码队列,以 Kingman 公式估计平均队列长度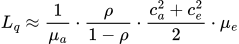 (
 ,
 为入/出队变异系数,
 为利用率,EWMA/EWMV 滚动更新均值方差),锚定目标L₀反推提交速率
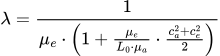 ,再按
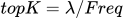 映射为每次提交上限,未来还可以视频内容与档位为 State、提交为 Action、带宽/体验为 Reward,用在线小流量 RL 学习更优策略。
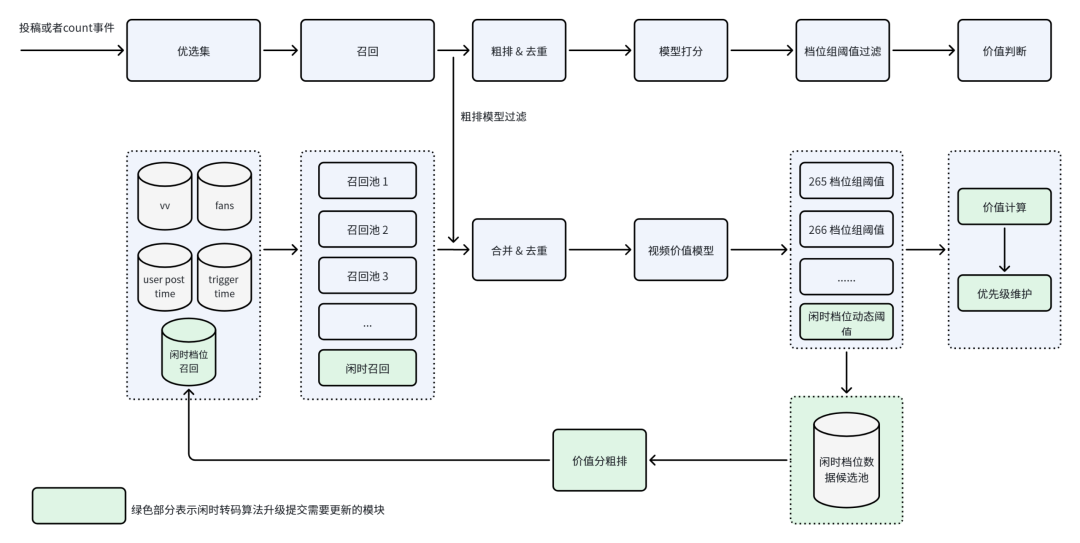
IdleTrans(2025)是 Reward 算法的闲时调度补充模块,把夜间等闲时的闲置算力转为增量转码资源,由于闲时允许任务堆积、提交侧不感知实时资源,故建模为无资源约束的最优化问题,只在「视频×档位」粒度最大化净收益:
Profit(L) = Δ LTV(QoP|L) + Δ BW(L) − Δ Calc(L) − Δ Store(L)
其中为质量库给出的用户—域名体验预估,为带宽节省,、为计算与存储开销,各项按渗透率折算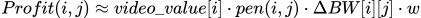 (𝓌为折算系数),真实渗透
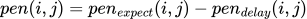 ,即期望渗透减去转码延迟渗透(档位转出前不产生收益)。召回与提交上,忙时与线上共享数据池、优先高价值视频,闲时启用独立数据池纳入低价值视频,以实时净收益作为「视频×档位」提交优先级——未提交按收益排序提交、已提交未转出持续刷新、已转出幂等去重,并对短剧链路加权,从而在堆积时让高收益档位尽早产出。
2.4 CDN调度:CDNPilot
CDN 调度的问题已经存在很多年,主要回答「内容该放在哪个节点、何时搬运」以及「这次请求给谁」,但其中前者在短视频时代的重要性比传统视频业务要更高。此外,传统 CDN 被动回源、就近接入,热点来临时才消耗跨网与回源带宽,CDNPilot更倾向于借助 VLP 的预测能力与质量评估把调度从「事后兜底」变为「事前布局」,可以沿冷热分层、闲时预热、实时择优三条线递进展开。
通过CDN预热带动业务收益,行业中 Netflix 因其具备OpenConnect这样的CDN模式而自然推动,堪称先驱,但短视频的预热问题需要处理高 3-4 个数量级的视频,同时应对不同 CDN 供应商,较之远为复杂。CDN 调度相似,主要的挑战来源于规模、供应商状态以及与实际用户请求的配合,需要遵从第一性原理进行实际数据的分析、推导与建模。
冷热调度(2020)解决「全量铺太贵、集中怕回源」的矛盾,成本关系为 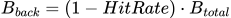 ,而视频热度近似服从 Zipf 分布,设全网视频量为𝓃、边缘容量覆盖比例为𝓮,边缘只需覆盖头部少量文件,回源比例即随𝓮快速下降:
b(e)=∫enn c/ks dk / ∫1n c/ks dk=(n1−s−(en)1−s)/(n1−s−1)
其中为文件热度概率,线上由 XGBoost 产出以控制计算复杂度,KEPC-Push 方法进一步用知识图谱刻画相似作者、内容与时长视频间的热度关联,缓解新视频无历史的冷启动,并以分层算法适配异构边缘节点,在仿真中降低峰值 CDN 成本 20%、提升平均下载速度 7%。
质量调度新算法(2025)在服务端消费客户端实时上报的性能数据,在国家—省份—运营商粒度构建域名质量偏序库,以令牌桶承载各厂商动态分量作为硬约束,仅对热流视频逐请求分配最优子域名,本质是带容量约束的实时 0-1 指派问题:
max{at(i,j)} ∑i,j QoEt(ui,dj)⋅at(i,j), s.t. ∑iat(i,j) ≤ Cjt, ∑jat(i,j)=1, at(i,j) ∈ {0,1}
2.5 CDN流量调控:TACO
流量调控主要源于中国区的一个特定问题:带宽成本是按 95 峰计费、由计费周期内少数高峰采样点决定,而抖音等应用存在相对固定的消费高峰(午间、晚间与节假日),若能综合运用不同时段提供用户消费的技术策略,当能保证体验与成本的综合最优。抖音给出的解法是用算法来进行预测和控制,调控目标是在体验约束下压降超出目标水位的峰值。
TimeValue(2022)是 TACO 的前序方案,针对商业CDN 的月 95 计费规则,账单由计费周期内 p95 的采样点决定,且不同 CDN 资源、不同供应商分别统计 95 峰,因此策略分为两类——在计费点附近降级减流量的「削峰」,与在低谷时段、不抬升 95 峰的前提下提升质量的「填谷」,记BWₜ为时刻𝓉的带宽、𝒯为目标水位、,调控目标是在体验下限约束下压降超水位峰值:
min ∑t[BWt−τ]+, s.t. QoEt ≥ QoEmin
TimeValue 以「预测+模拟+统计」的融合方法圈定固定调控时段,初期仅晚高峰档位降级 80 分钟即可带来 CDN 成本 -2.14%,系列策略累计取得 -7% 成本优化与 LT、时长等体验收益,但月 95 峰预测存在固有难点,节假日、特殊事件等因素稀疏难学(不确定性),且策略干预改变波形、波形又反过来决定预测结果(反身性),固定时段策略很容易在多年迭代中失效。
TACO(2026)从「观察干预后波形」转向反事实的自然流量建模,通过纯净域名反转实验还原无干预波形,用 Transformer 深度时序模型预测未来 24 小时自然带宽:
ŴBWnatt+1:t+H=fθ(BW1:t)
再以混合整数规划把全天划分为削峰、填谷、免费、idle 各类时段,逐时刻求解干预幅度aₜ,削峰段压低超水位流量、填谷段释放体验空间,并以相邻时刻幅度差约束抑制波形突变:
max{at} ∑t([ŴBWnatt−at−τ]+ + λ⋅at⋅𝟙[t∈Zfill]), s.t. QoEt(at)≥QoEmin, |at−at−1|≤Δmax
其中为文件热度概率,线上由 XGBoost 产出以控制计算复杂度,KEPC-Push 方法进一步用知识图谱刻画相似作者、内容与时长视频间的热度关联,缓解新视频无历史的冷启动,并以分层算法适配异构边缘节点,在仿真中降低峰值 CDN 成本 20%、提升平均下载速度 7%。
客户端:从静态规则到实时决策
3.1 统一下载决策:Demand
下载算法所希望回答的问题是,在用户还没划到下一个视频之前,应该提前下载哪些数据、下载多少?下载得少,滑到即卡顿,下载得多,用户划走后未播放的数据即成为纯粹的带宽浪费——在巨大的流量规模下,任何一点冗余都会被放大,其难点在于,决策必须在观看行为发生之前做出,因而本质是一个「以观看概率为权重、在体验收益与带宽成本之间取平衡」的预测与调度问题。
音视频链路算法化的难点始终在建模上。作为前AI时代与互联网伴生发展的若干最复杂的技术领域之一,它很早就被「古法」程序员们使用各种抽象组合式、控制论式、复杂系统式的方法搭建了似简实繁的工程技术栈(播放器、流媒体服务),同时其实际工作时又依托于复杂、极具噪声的网络环境背景,此外,由于决策的频次极重,对性能损耗的容忍与一般的端智能模型相比有数量级的差异。因此每次建模和决策方式的提升尝试,背后的主要工作是如何克制地运用算力、引入先验知识并克服偏置,「驯服」基本变量,推动对应的工程改造,使其在复杂系统之中并不带来额外损失,且得到所需的计算性质。
短视频最早策略化的部分是预加载,常用的是固定策略,于当前视频下载完成后预加载后续 N 个视频、每个视频提前加载数百 KB,在抖音这些参数均由海量实验筛选得出,它在短视频为主的阶段十分有效,打败了大量看似精巧的算法方案,但稍长的视频引入后,还是会带来命中率低、数据浪费、卡顿上涨等问题。
早期抖音还采用过一种名为水位阀的技术,引入安全水位 S 与危险水位 D 双阈值闸门,当前缓冲水位高于 S 时开闸,将后续视频预加载任务串行插入当前视频 Range 请求间隙,低于 D 时关闸保播放,同期还结合了端智能快慢滑预测的能力来调整预加载大小。
Dynamic v1(2022)在水位阀基础上引入动态水位机制与预加载Ladder设计,从有限个固定大小任务变为多任务配置组合,基于网速、卡顿、播放进度、快慢滑标签等多维信号动态调整阈值、预加载个数与大小,对抖音的用户活跃度有明显正向影响,带宽成本也有较大下降。Dynamic v2(2023)有三项演进:一是引入Weibull 观播时长建模,用形状k、尺度λ、位置μ三参数描述CDF,支持服务端离线多维画像(片源/用户/视频)与端云联合在线预测,带宽成本-3%以上;二是可信播控,按观播时长调整目标缓存水位,短视频下压省成本、长视频上调减卡顿;三是按秒预加载,基于 MP4 封装特点将按时长决策预加载大小与按Size混合,提升中长视频起播速度。全链路缓存(2023)改进进一步用条件期望 替代固定配置值。
在 Dynamic 等预加载算法的基础上,Demand(2024)以「统一 IO 决策」视角将抖音的预加载与播放下载在工程和策略上均收敛为一套逻辑,提出「下载需求」概念,从单视频决策扩展为播放列表级决策,最优下载拆为两阶段,一阶段按选出列表中需求最高的视频,二阶段对候选视频 𝓲 判断是否下载Range 𝓇:。整体优化目标 ,统一决策何时下载、下载哪个视频及档位、下载哪部分数据及下载方式。
Demand 算法的 RL 版DeLoad(2025)用强化学习自适应地调整Range大小,策略读取播放列表状态特征 s,输出 Range 决策 a,目标最大化期望累积回报,更适配网络动态变化,但迁移成本较高。论文参考:
DeLoad: Demand-Driven Short-Video Preloading with ScalableWatch-Time Estimation(https://dl.acm.org/doi/10.1145/3746027.3754849)
Range-Level Preloading with Scalable Watch-Time Estimation for Billion-User Streaming Systems(https://ieeexplore.ieee.org/document/11538175)
3.2 播放实时选择:Vision
播放选择(档位选择)算法回答的是,在多码率环境下,当前该播哪个档位,进一步而言,所选择的不仅是某一视频档位,还包括针对该视频起始播放时,采取的一系列与所选档位配合策略,例如是否做超分和后处理,更改播放器运行的配置等。
音视频行业自 2008 年左右明确步入了多码率时代——之前 90 年代虽有先兆但并不普及,在复杂策略(规则)技术主导的几年之后,ABR 即(根据网络状态的)多码率自适应选档算法在 2014、2015 年左右逐步在各大公司成为了显学。短视频领域的消费中,预加载命中率可达 90% 以上,而在一次视频观看(vv)中,被观看的视频存在多个可消费档位的概率,则几乎在 100%。
这条路径的关键是逐步建立对最终上屏体验的精准理解,以规则负责兜底,通过性能模型预测动作后果,运用个性化信号刻画收益,联合决策框架统筹,最终达到画质、流畅性、负载与成本的综合最优。
选档曲线(2019)抖音早期曾使用了名为选档曲线的技术,在线统计不同网速段下播放各码率视频的卡顿时长分布,例如将「单vv卡顿时长低于阈值(例如15ms)」定义为基本流畅,筛选有效「网速-码率」点后用多项式拟合映射曲线,输入当前网速即可输出推荐码率。该方法逻辑简单、可解释、易回滚,但所有用户、视频和设备共享同一条曲线,其映射可写为:
r̂=f(b)=∑i=0nci bi
分群自适应(2020)针对全局曲线无法区分用户差异的问题,按画质敏感用户、画质敏感视频等群体标签对曲线参数做差异化调整,端上超分的考量也在此阶段加入,按设备 CPU/GPU/内存能力圈选适用范围并结合实时负载设置运行条件,证明了个性化的必要性——同样档位对不同用户和设备的收益成本比不同。分群后的映射为:
r̂g=min(capg, slopeg⋅f(b))
Vision 还引入了用户维度的个性化,基于历史卡顿事件构建了用户卡顿退出率画像,对退出率高的用户提高流畅性权重,对耐受度高的用户保留更多画质空间。实验显示卡顿退出率 -2% 以上,起播稳定性和播放流畅度显著优化,在播放时长增长的同时,码率降低还带来了较大幅度成本收益。
3.3 客户端选路:ParaFlow与PRIME
ParaFlow 与 PRIME 回答的问题主要是「数据走哪条路径、用哪个网络资源」,移动设备常在 Wi-Fi 与蜂窝多路径间切换,路径质量时刻波动,客户端选路需要在多路径、多资源间做实时择优,其中 ParaFlow 是多路径选路的框架名,下文的 CROSS 与 Amphi 分别是它的两代实现,PRIME 则把决策对象从路径指向网络资源。
多路选择在业内不算很新的概念,但其他公司、团队或者上线者寥寥,或者并未达到足以令人满意的效果,学术界或者其他公司在这一领域的尝试,弊病有时在于对于算法化「不够相信」或者「理解不深」,有时在于缺乏对基建的充分理解,假设失配或者先验误设。
可以例证的是,在形如 PRIME 的工作中,通过将优化目标直接与业务收益(包括用户指标、营收指标和成本)挂钩,就带来了巨大的价值,过程中较难的部分并非算法设计或者调参,而是在于长周期内,对底层工程链路的拆解重写,令其对齐建模时的相关基础假设。
CROSS同时优化的是数据路径与 ACK 路径,数据侧发起两个并行下载任务,每次下载绑定一条路径,从源头减少跨路径乱序,buffer 告急时动态回退 minRTT 调度补带宽,ACK 侧对带宽、单向时延、丢包率归一化后加权打分,并针对 LTE 的上行瓶颈与 Wi-Fi 双向竞争做了差异化修正,按综合得分择优:
p* = arg maxp score(p), score(p) = wb⋅ŴBWp − wd⋅ŴOWDp − wl⋅ŴLossp
Amphi针对「用户随时滑走」与「移动网络波动」并存的短视频场景做跨层协同,应用层的多流调度器同时为多个候选视频分配带宽,减少卡顿与无效下载,传输层的多路径调度器将每路流分发至多条网络路径,增强对 Wi-Fi/蜂窝波动的鲁棒性,两层之间通过 ACK 反馈联动,这样多流 × 多路径的联合带宽分配可形式化为:
max{xs,p} ∑s Us(∑p xs,p), s.t. ∑s xs,p ≤ Cp (∀ p), xs,p ≥ 0
其中为流𝒮在路径𝒫上分配的速率,Cₚ为由ACK反馈实时估计的路径容量,Uₛ(·)为流𝒮的边际效用函数,应用层多流调度与传输层多路径调度共享同一分配结果,并随 ACK 反馈滚动更新。该版本 QoE+18.6%~75.2%,带宽浪费 -6.3%~13.4%。
PRIME(2026)的思路是,把决策对象从「路径」指向「网络资源」,综合各资源的实时性能、带宽单价、用户播放状态与个性化观播时长估计体验收益,在候选资源集合中做「体验收益-带宽成本」的统一权衡并灵活切换,在抖音上线过程中已累计取得约 -8.5% 的带宽收益,其决策可写为:
r* = arg maxr∈ℛ (UQoE(r ∣ state) − α ⋅ C(r))
3.4 网络测速:单队列 vs SHEF
网络测速面向的是这样一个问题:「当前有多少网络资源可用」,它本身不做播放决策,但会作为 Demand、Vision 和其他算法策略的共同输入,测速偏低会直接压低码率,因此它的鲁棒性还决定了其他下载策略能否顺利上线。
网络测速算法的输出是客户端音视频算法的基础输入,本身存在多年,原始版本行业通用,十分简单有效,并且经过多种对比评估,证明其他许多精巧的设计并不能带来增益;但另一方面,抖音在经过仔细观察后,仍然可以做出形如SHEF的改进并带来直接效果,这个事实再次、明确地提醒我们:一切价值均可结合环境重估,基础环节仍可改进。
单队列测速(2019)即常见的被动式单队列架构,播放下载组件的 Range 下载完成回调产生一个采样点,送入定长 FIFO 队列统一给出估计,默认算法为加权中位数,以每次下载的数据量Sᵢ为权重,取累计权重首次过半的采样点,避免异常采样拉偏结果:
bi=si/Δti, ŵB= b(k) s.t. ∑i=(1)(k)-1si ≤ ½∑i=1Nsi
不同采样共享同一数据结构,仅以事件类型区分语义,让测速值在连续下载中持续变化,配合突变弱网检测影响下载决策,替换后带来 LT 上升、画质提升、卡顿率下降、成本下降等收益。
论文参考:PIRA: Pan-CDN Intra-video Resource Adaptation for Short Video Streaming
小结
在团队过往的总结中,曾经定义了 L1-L5 级别的个性化能力标准,虽然当前抖音仍在 L4 的层次上前行——
对齐最先进的个性化技术
建立千级别的干预点
支持半自动化挖掘新干预点和自动化评估
支持高阶信号如长序列、多模态等
支持业务影响视角进行特征构建,支持通过数据挖掘驱动特征构建
视频和用户全类型覆盖
达到十万分之一的业务优化精度
......
但随着 AI 浪潮近几年的推动,L5 等级所描述的全系统、全链路精准感知与计算,自动化拓展状态空间,策略统筹、模型精度方面达成理论最优等目标,也并非天方夜谭、遥不可及,期待后续抖音可以将技术理想实践落地,为用户带来极限的音视频体验。
个性化视频技术:历时七年的算法演进
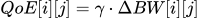
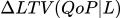


JOTO 企业落地观察
- 企业部署需重新评估转码资源分配逻辑——VLP模型将视频价值预测纳入基础设施层,使转码不再依赖粉丝数等粗放指标,而是基于多任务学习输出的vv、完播、时长等目标分,驱动档位组合、CDN缓存、前处理推理预算等环节的联动决策,要求团队建立跨链路的价值对齐机制。
- 智能体工程面临音视频场景特有的实时性与确定性挑战——Demand与Vision类算法需在毫秒级响应约束下完成播放列表级下载决策与档位选择,其建模必须融合网络状态、用户行为、视频内容特征及端侧性能反馈,且不能引入显著推理开销,这对轻量化模型设计、特征在线更新与策略灰度验证提出更高要求。
- RAG知识工程在此类系统中体现为结构化语义特征的规模化生产与复用——VLP v3引入124个由视频内容理解大模型生成的高阶语义特征(如美学、结构、热度分析),并结合LLM挖掘的互动与生态特征,说明企业需构建可版本化、可溯源、可组合的多模态特征知识库,支撑不同阶段模型对视频深层语义的一致性理解。
- AI安全治理需覆盖算法决策链路中的隐性偏见传导风险——UIAE与CDNPilot等系统依赖作者/类目表征、相似视频热度关联等信号进行冷启动预测,若知识图谱或Embedding生成过程未对创作者多样性、地域分布、内容类型偏差做显式约束,可能导致长尾视频持续低曝光,这类系统需在特征工程与模型训练阶段嵌入公平性校验机制。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们